80%代码由Claude合并,Anthropic内部人员点破Agent真相:「Close the Loop」
最近,Anthropic 团队研究产品经理 Theodora(Theo)Chu 的一段演讲视频,引起了大家的注意。
最近,Anthropic 团队研究产品经理 Theodora(Theo)Chu 的一段演讲视频,引起了大家的注意。
Theo 表示,当前越来越多的开发者已经不再只是「听说过 Claude」,而是在日常工作中真正感受到效率提升。有人认为 Claude 让自己效率翻倍,也有人认为提升了 10 倍。更重要的是,Claude 已经开始深入 Anthropic 自身的工程流程,「Anthropic 内部超过 80% 的代码由 Claude 合并。」
这意味着,模型的角色正在发生变化。
模型不再只是停留在回答问题阶段,而是在一个可以反馈、验证、修正的环境里持续完成任务。「Close the Loop(闭合循环),给模型一种验证自身输出结果的方式。」
而在这场分享中,Theo 想要告诉开发者的是,「你应该如何适应这个新世界,又应该如何面向未来构建产品,而不是只为过去构建产品。」
为此,Theo 详细拆解了如何构建能够自我改进的 Agent,「真正的配置,是让 Claude 在循环、计划模式和动态工作流中持续运行。」
网友 rari@0xwhrrari 认为,「这要比大多数 300 美元的 Agent 课程都要好。」
那么,接下来,我们就来详细了解一下这场演讲到底讲了什么。
一年之内,模型失败率被大幅压低
Theo 用编程评估基准 SWE-bench Verified 举了一个例子,它由一系列 GitHub issue 组成,模型需要理解问题、修改代码,并通过测试来证明自己真正解决了任务,这是 Anthropic 内部用来观察 Claude 编程能力提升的重要评测:
一年前的 Sonnet 3.7 得分仅为 60% 左右,而到了 Opus 4.8,得分已经达到了 88%。
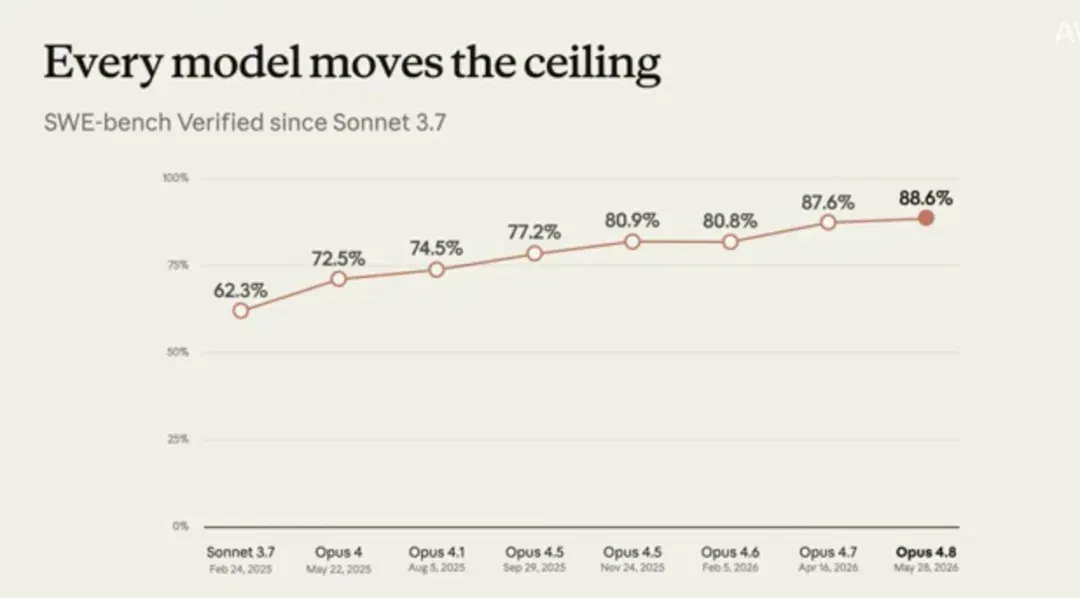
这意味着,一年前的模型在这些任务上的失败次数,大约是现在的 3 倍。
这也是演讲中最值得注意的地方:模型能力提升,并不只是「多做对几道题」,而是失败率正在快速下降。失败率下降之后,模型才有可能承担更长、更复杂、更接近真实工作的任务。
此外,更不可思议的是,在最新的 Mythos 和 Fable 系列模型中,该基准测试实际上已经出现接近饱和的迹象。换句话说,一些过去足够难的测试,今天可能已经不再能有效区分模型能力。
这对开发者来说是一个重要信号:如果你还在用 12 个月前的任务测试今天的模型,就很容易低估模型真正的能力边界。
而新模型这种智能的增长,具体落在了以下三个核心领域:
一是先规划,再行动
Theo 展示了同一个任务在两个不同模型上的表现:让模型一次性重建 Claude.ai 网站。
结果表明,旧模型的典型做法是,上来就开始写大量代码、调用大量工具,几乎没有充分规划。结果是,界面看起来似乎合理,但实际运行并不完整,功能也不能真正闭环。
「有点像我装宜家家具时的样子:一上来就动手,根本不看说明书,先开始拼,拼着拼着发现做错了,然后才意识到自己应该回去看说明书。」
而以 Opus 4.8 为代表的新模型则表现出了自适应思考(Adaptive thinking)的能力。它们会先在内部深思熟虑具体的规范,在预先规划的过程中及时捕捉错误(你甚至会在逻辑推理中看到它们输出「实际上……」或「算了,还是……」这样的自我修正词)。
这种先规划后行动的方式,让模型在第一次实际执行时就能高效落地,大幅减少了不必要的工具调用与代码行数。
因此,Theo 给开发者的建议是:要允许模型先思考。
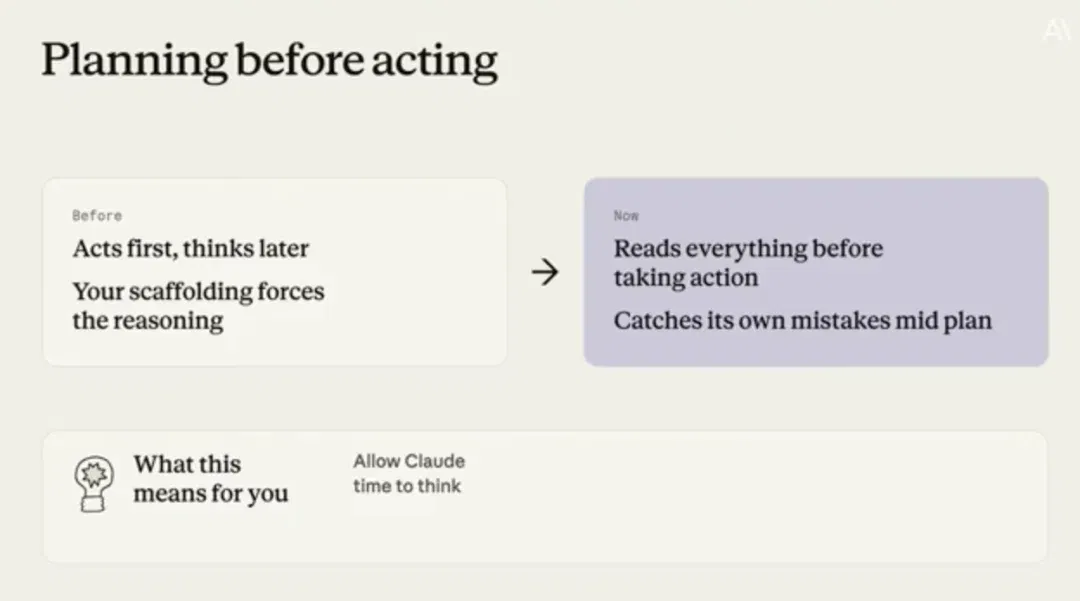
产品体验也应该为这种思考留下空间:比如使用自适应思考,让模型自己判断什么时候需要思考、需要思考多久。简单问题不必让模型大动干戈,但复杂任务应该给它足够的规划空间。
二是错误恢复和自我纠正
过去很多人做 Agent,重点放在「让模型能调用更多工具」。但 Theo 强调:工具调用本身还不够,模型必须知道自己什么时候做错了。
旧模型有一个常见问题是 doom looping:模型接到任务之后,如果失败了,你告诉它:「嘿,我觉得你应该换一种方式做」。或者,环境给了它某种反馈,提示它应该做另一件事。它会说:「好的,我再试一次。」
但当它再次尝试时,往往又会回到之前同样的解法,并不会真正改变做法。
新模型在这方面进步明显。它能够读取反馈、理解失败原因,然后尝试不同路径。这样一来,模型不再只是被动执行命令,而是开始具备某种错误恢复能力。
这对 Agent 产品尤其关键。因为只要任务足够长,模型就一定会遇到错误:代码跑不通、页面点击失败、测试没有通过、用户反馈不满意、环境返回异常结果。真正有价值的 Agent,不是永远不犯错,而是犯错之后能不能恢复。
因此,Theo 认为,开发者需要重新设计模型所处的环境。环境要能给模型反馈,让模型知道自己哪里做错了。
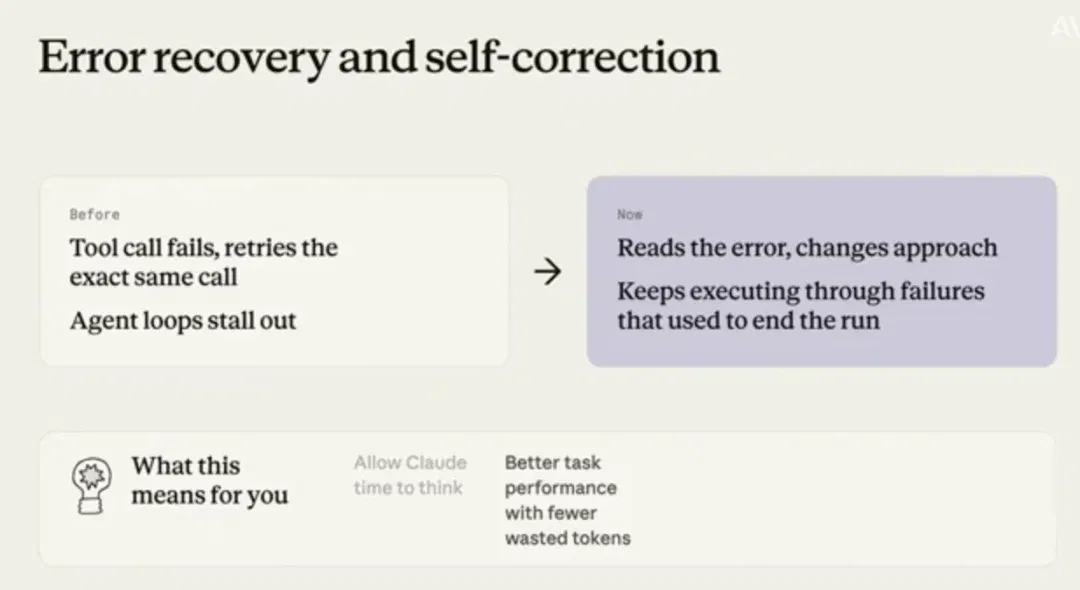
「这也意味着,模型不会因为 doom looping 而浪费 token,而是可以用更少的 token 完成任务。」
比如,如果你正在做一个应用生成 Agent,就应该给它访问前端界面的能力,让它可以自己点击、自己测试、自己判断按钮是否可用、页面是否正常。
模型只有拿到这些验证信号,才有可能形成:执行 → 验证 → 修正 → 再执行。
而这一点,也正是前面网友 rari@0xwhrrari 认为很重要的一点:close the agent loop(闭环智能体循环),「Loop 设计,让模型能够验证自身的输出结果。」
三是模型越来越擅长在更长任务周期上运行
旧模型在长任务中经常会陷入「跟丢主线」(Losing the plots)的窘境,用户给它一个长任务,它做着做着就忘了最初目标,或在执行到一半时遗忘最初的上下文或核心指令。
而现在,模型在长程任务的上下文连贯性上有了显著突破,能够稳定地将注意力维持在 100 万个 Token 甚至更高的级别。这意味着开发者不再需要把上下文窗口切得那么碎,而是可以直接将整个代码库递给模型。
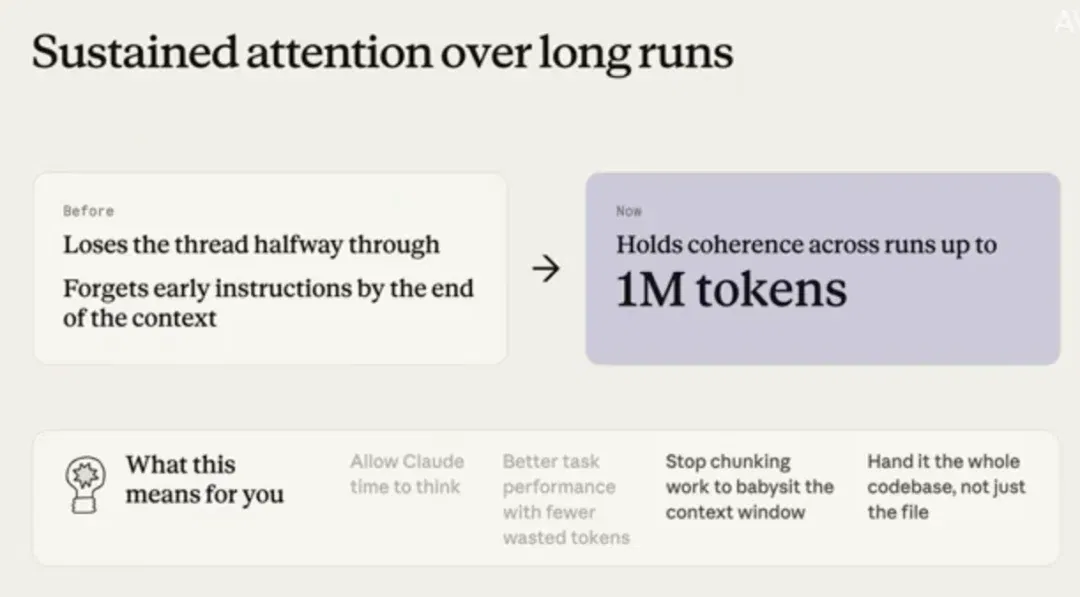
未来更合理的方式,是把更完整的任务交给模型。比如,给它整个代码库,而不是只给它某个文件;给它完整产品需求,而不是只给一个孤立函数;让它跑完整流程,而不是只完成一个局部步骤。
当规划能力、错误恢复能力和长上下文能力叠加到一起,Agent 的形态就会发生变化。
它可以先规划,再执行;执行之后,通过工具或人类反馈验证结果;如果发现问题,就调整计划,继续执行。这个循环持续进行,直到最终完成任务。
开发者该如何为未来进行构建?
因此,随着模型变得越来越智能,用户基本上可以让它运行更长时间,而它完成任务的效率和效果都会比过去更好。
那么,从战术上讲,用户现在到底应该如何为这个「未来」构建产品?也就是说,如何为正在变得越来越强的模型构建产品?
Theo 认为,开发者在产品与工程层面需要全面升级自己的研发战术:
一是主动保持野心,动态刷新评估基准(Evals)
首先,要更大胆地尝试、允许 Claude 处理更多事情,不要总是测试那些你觉得 Claude 12 个月前就能完成的任务,而应该开始思考那些 Claude 今天还做不到的任务,并持续关注这些任务。
另外,在模型快速进步之后,开发者最容易遇到的一个误判是:觉得新模型没有明显提升。其实,背后原因可能不在模型,而在 Evals。
Theo 提到,有些客户在新模型发布后会说:「我的 Evals 只提升了 1%,所以这个模型好像没强多少。」但真正用起来之后,他们又会发现,新模型在某些能力上提升非常明显,只是原来的 Evals 根本没有测到。
这说明,Evals 也会过时。
AI 时代,Evals 有点像单元测试,它可以帮助开发者判断模型是否真正具备某种能力,也可以帮助产品团队追踪模型变化对用户体验的影响。但一个好的 Eval,不能只测试今天模型已经会做的事情,还应该包含今天模型尚未完全解决、但未来用户体验真正需要的任务。
换句话说,Evals 要面向未来设计。不要只盯着眼前的客户体验,要将用户报告的最新失败模式,以及你希望应用未来发展的方向融入到测试用例中。如果某些遗留问题被证明不可解,请立刻更新更难的题目。
二是精简「脚手架」(Shrink the Scaffolding)
Theo 反复强调的另一个建议是:shrink your scaffolding,缩小模型周围的「脚手架」。
所谓「脚手架」,即在工程实践中,开发者为了修补旧模型的各种漏洞,在其周围套上的系统提示词、外部工具、代码 Harness,以及各种围绕模型搭建的约束和补丁。
比如,模型某次引用格式错了,就加一条规则;模型某次没遵守要求,就再写一段约束;模型某次调用工具失败,就在外层加更多逻辑…… 这些补丁在旧模型时代可能有用。但当新模型的指令遵循能力变强之后,旧补丁反而可能成为问题。
Theo 举了 Anthropic 自身的一个例子。团队曾一度以为新模型在 Claude.ai 的引用功能上出了 Bug,后来检查才发现,是因为新模型遵循指令的能力大幅提升,导致它极其听话地去执行了一行很久以前写在系统提示词里、但现在已经过时的引用格式指令。团队最终只需将那行过时的提示词彻底删掉,功能便恢复了正常。
这说明,开发者应当「针对意图」去编写简洁的提示词,明确最终想要的结果,而不是围绕着过去老模型的失败经验去过度包装。给模型松绑,精简「脚手架」,让它拥有更多的自主权,你才能看清它真正的天花板在哪里。
三是闭环设计,让模型验证自身的输出结果
模型要完成更复杂的任务,只会思考还不够,它还需要动作能力。
这是构建自改进 Agent 最核心的底层逻辑。既然模型已经具备了极强的错误恢复能力,就必须在工程上「闭环智能体循环」(Close the Agent Loop):
- 给模型留出思考与工作的空间:引入自适应思考机制。在产品设计上允许模型进行前端思考,甚至可以通过投入度拨盘(Effort Dial)让模型可以自由上调或下调在某个复杂问题上的钻研程度。
- 以受控的方式开放高权限:想要发挥 Agent 的自主性,就必须赋予它在环境里采取行动的权限。Anthropic 在 Claude Code 中推出了「自动模式」分类器,它能够在「开发者的控制欲」与「模型的自主权」之间找到完美平衡,自动甄别哪些行动是安全可取的,防止模型误删环境。
- 提供自我质检的工具:应该为 Agent 配备诸如 「Computer Use」这样的自动化验证工具,让智能体能够自己去前端到处点一点、做质检,通过环境的真实反馈发现自身的错误,从而实现代码的自我迭代与修正。
参考链接:
https://x.com/0xwhrrari/status/2069163624375976103
文章来自于"机器之心",作者 "机器之心编辑部"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Claude 推出表格与白板工具,更新数据分析和应用连接 (opens in a new tab)
Anthropic 公布 Claude Sheets、Whiteboards 及 Data 更新,覆盖表格编辑、团队构思和数据解读。部分能力分批推出,连接器及账号条件各有不同。
PSI 报告用 AI 研究系统证明 Aaronson–Ambainis 猜想 (opens in a new tab)
Physical Superintelligence 称,内部研究系统使用未公开的 Anthropic 模型,在运行第三天得出经 Lean 检查的证明。结果涉及随机输入下量子查询加速的边界。
Claude 在美国测试个人财务功能,可只读连接银行账户 (opens in a new tab)
Anthropic 通过 Plaid 接入用户授权的账户,用 Claude 查询余额、分类支出和跟踪账单。功能逐步向美国 Pro、Max 和 Ultra 用户开放测试,权限为只读。
Mollick on agent collaboration: why improving 3D worlds turned into lengthy approvals (opens in a new tab)
Ethan Mollick describes repeated themes, expanding rules and subsequent adjustments in Fable 5.2 multi-team creation. He argues long-running execution still needs human judgment about work quality, purpose and when to stop.
Claude Meetings brings collaborative documents into calls, with efficiency and recordkeeping tradeoffs (opens in a new tab)
APPSO describes visible participation, live notes and whiteboard collaboration in Claude Meetings, examining how notifications, external guests, retention and AI summaries affect teamwork, privacy and the room for open-ended discussion.