DeepSeek 要用蜜雪冰城的打法,做中国版 Claude Code
DeepSeek 之于大模型,就像蜜雪冰城之于奶茶。你不必纠结性价比,因为它的本事你挑不出毛病,你的钱包它也从不为难。
DeepSeek 之于大模型,就像蜜雪冰城之于奶茶。你不必纠结性价比,因为它的本事你挑不出毛病,你的钱包它也从不为难。
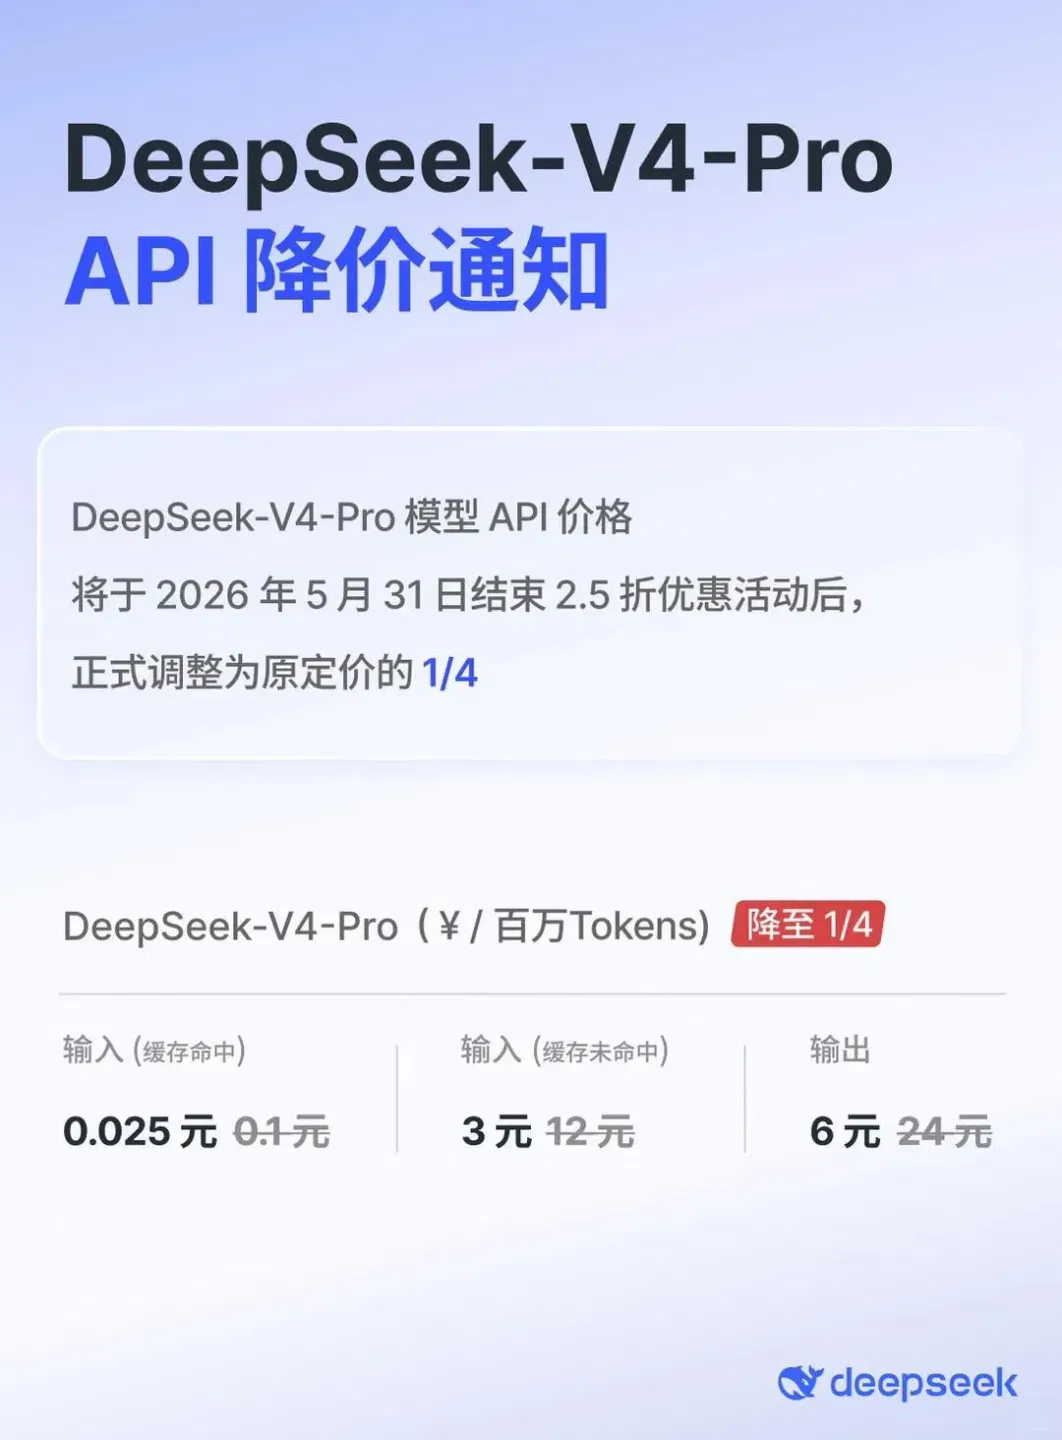
最近,DeepSeek 官方宣布,DeepSeek-V4-Pro 模型 API 将永久降价。同时,DeepSeek 表示,API 已完成输出提速与服务扩容,速度更快,服务更稳定,默认支持 500 并发,企业用户可以在线申请更高并发。
发布模型,再给出折扣,接着降低缓存命中价格,最后把临时优惠变成长期价格。大模型 API 的价格基准正在被重新改写,而低价模型背后的下一站,很可能是 Agent。
DeepSeek 永久降价,梁文锋把 Token 价格打骨折了
让我们先来简单梳理一下 DeepSeek 的降价时间线:
- 4 月 24 日,DeepSeek V4 预览版正式发布。
- 4 月 25 日,DeepSeek 宣布 V4-Pro 开启 2.5 折优惠。
- 4 月 26 日,DeepSeek 宣布缓存命中价格调整为首发价的十分之一。
- 4 月 28 日,DeepSeek 宣布 V4-Pro 的 2.5 折优惠延期至 5 月 31 日。
- 5 月 22 日,DeepSeek 宣布 V4-Pro 永久降价为原价的四分之一。
时间线的关键之处,在于临时折扣变成了永久降价。调整之后,DeepSeek-V4-Pro 输入缓存命中价格从 0.1 元每百万 Tokens 降至 0.025 元,输入缓存未命中价格从 12 元每百万 Tokens 降至 3 元;
输出价格从 24 元每百万 Tokens 降至 6 元。叠加默认 500 并发和服务提速后,官方 API 对开发者和企业的吸引力进一步提高。
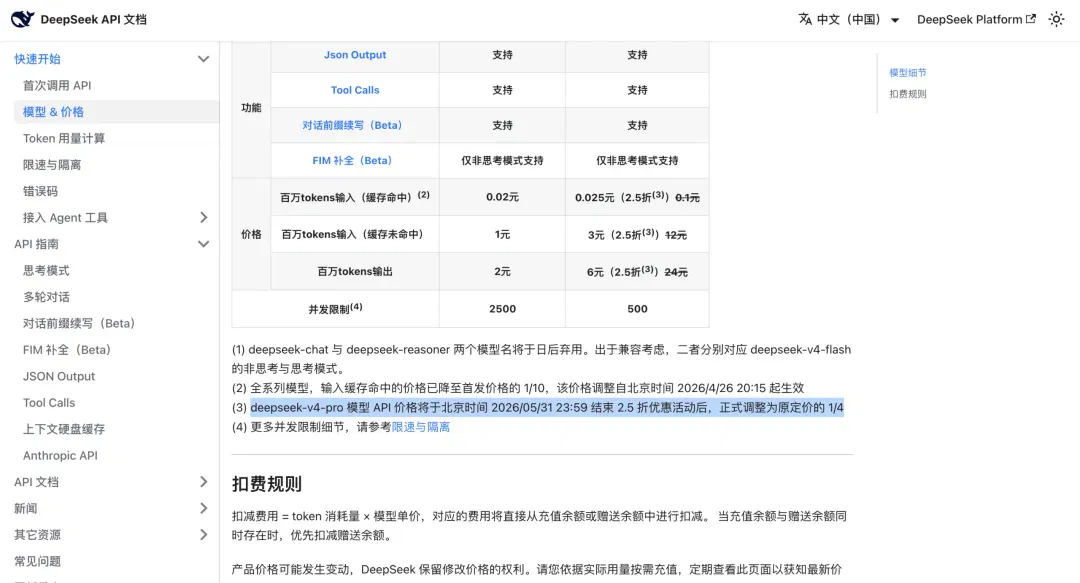
🔗 https://api-docs.deepseek.com/zh-cn/quick\_start/pricing
而价格下调最直接的影响,是把任务成本推到开发者决策的更前端。
在代码场景里,一次任务可能要读取项目文件、分析日志、多轮修改、反复运行测试,Tokens 消耗很容易放大。
长上下文、代码库分析、批量重构、自动测试、Agent 多轮执行这些高消耗场景,开始更接近个人开发者和小团队的预算范围。
过去,开发者选择 Claude、OpenAI 或 Gemini,主要看模型能力、稳定性、生态和使用习惯。DeepSeek 打骨折的永久降价,也意味着在绝对的性价比面前,开发者使用习惯也是可以轻易改变的。
顺着这条线,DeepSeek 一贯的市场角色也更清楚了:用低价、开源和强推理能力,持续建立大模型市场的价格优势。对国内模型厂商来说,V4-Pro 永久降价相当于重新划了一条 API 定价线。
智谱、MiniMax、月之暗面这类同样依赖 API 收费、又面向开发者和企业客户的模型,压力可想而知。反观 Claude、OpenAI、Gemini 等海外头部模型,由于市场、客户结构和生态位置不同,短期冲击则相对有限。
但如果 DeepSeek 后续推出类似 Claude Code 的编码工具,再用低 token 成本支撑高频调用,价格敏感的开发者群体会更容易被吸引过来。
梁文锋此前对 DeepSeek 定价哲学的解释,也能放到今天理解。
早在 2024 年 DeepSeek V2 降价时,梁文锋就提到,DeepSeek 只是按照自己的节奏做事,核算成本后定价,原则是不贴钱,也不赚取暴利。他还说,降价一部分来自下一代模型结构探索带来的成本下降,另一部分原因是 API 和 AI 都应该是普惠的、人人用得起的东西。
比起把 API 当成高毛利收费入口,DeepSeek 则更像是在用过硬的 Infra 实力压低推理成本,再用低价吸引开发者、应用和下游生态进入自己的轨道。
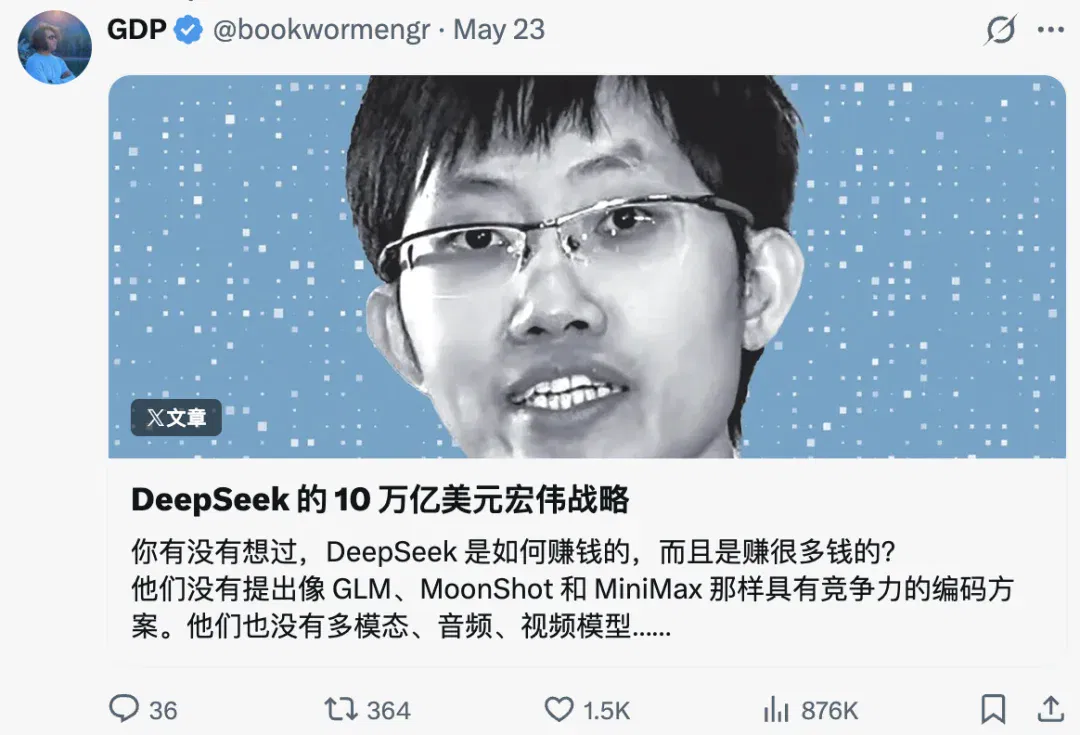
X 平台博主 @bookwormengr 最近在一篇题为《DeepSeek's 10 trillion USD grand strategy(DeepSeek 的十万亿美元棋局)》的长文中,给出了一个更激进的解释。
他认为,DeepSeek 的真正目标未必是和智谱、月之暗面、MiniMax 竞争,也不是急着补齐多模态、语音、视频这些产品线,而是通过持续降低训练和推理的资源需求,推动一套更便宜、更分散的 AI 硬件生态成形。
在他看来,DeepSeek 的长期价值不只在模型本身,而在于让更多国产存储、GPU、ASIC、网络芯片和异构硬件进入大模型训练与推理体系。
这个判断未必能完全兑现,但它解释了 DeepSeek 一系列选择背后的方向:
MoE、MLA、DSA、GRPO、RLVR、KV Cache 压缩、Dual Path、TileLang,表面上看是模型架构和推理工程优化,往深处看,都是在降低对高端 HBM、顶级 GPU 和 CUDA 生态的依赖。
一系列降价公告里,最值得关注的不只是输出价格下降,还有缓存命中价格下降。
在大模型推理过程中,KV Cache 是一个关键成本项。模型处理长上下文时,需要把历史 tokens 对应的 Key 和 Value 存起来,后续生成时反复使用。上下文越长,需要保存和读取的缓存越多,对显存、带宽和存储系统的压力也越大。
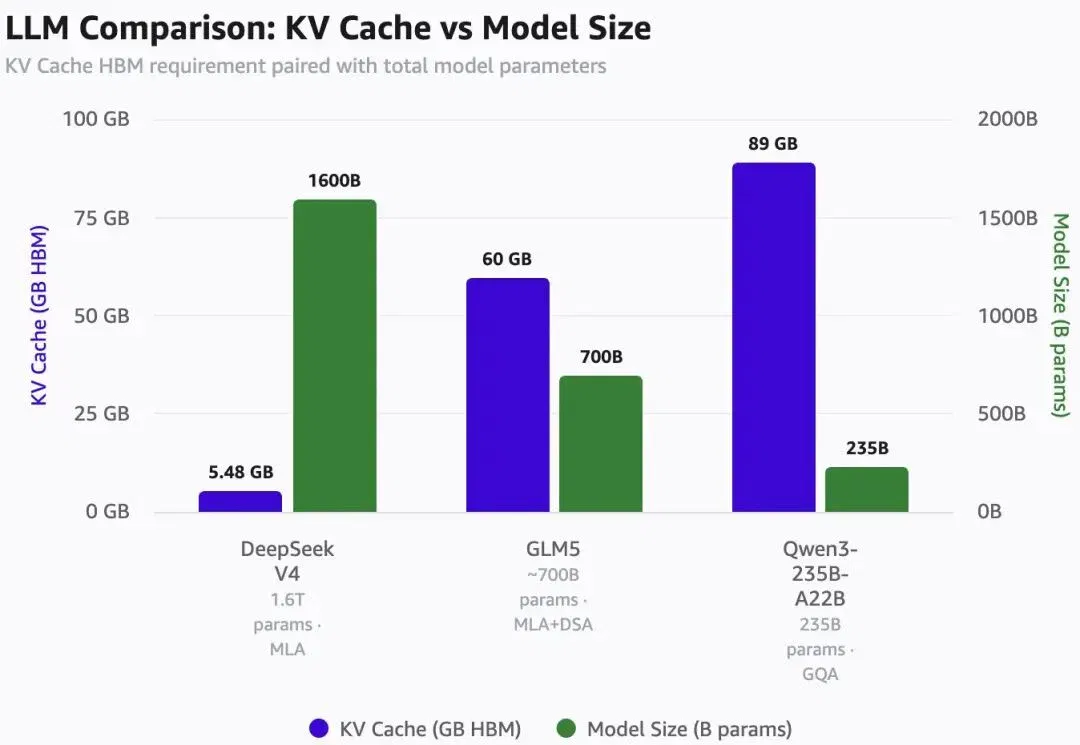
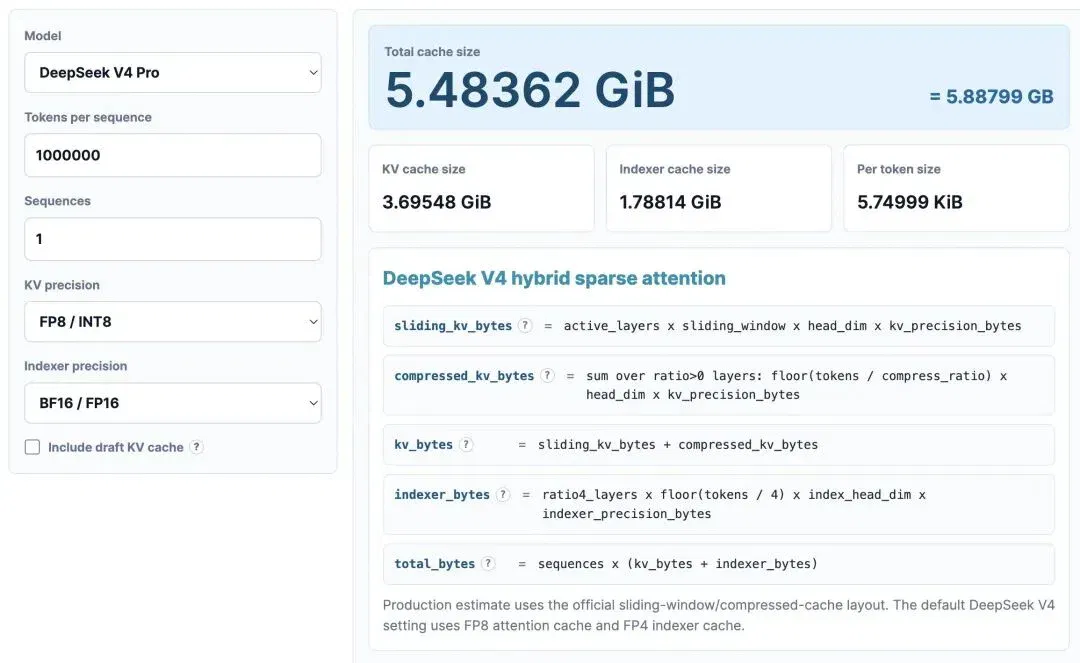
普通聊天里,缓存压力不一定明显,但在进入代码、长文档和 Agent 任务后,成本结构会迅速变化。@bookwormengr 在长文里专门算了一笔 KV Cache 账。
他以 100 万 tokens 上下文、8 bit KV 精度和 16 bit 索引精度为前提,估算 DeepSeek V4 只需要约 5.48GB HBM,而 GLM5 约为 60GB,Qwen3-235B-A22B 约为 89GB。
长上下文和 Agent 任务真正贵的地方,不只是模型生成本身,还有缓存、显存、带宽和重复上下文搬运。
一个 Code Agent 处理项目时,可能要反复读取同一个代码库结构、同一批文件、同一段任务历史、同一套系统提示词和同一批测试日志。若每一轮都按完整上下文重新计费,长任务很快会变贵。缓存命中价格下降后,重复上下文的成本会明显变低。
DeepSeek 近年来在 MoE 架构、长上下文、KV Cache 压缩和推理效率上持续投入的表现有目共睹。降价是技术迭代后的必然结果,也将彻底搅动 AI 编程市场格局。
为什么必须做中国版「Claude Code」?
最先被牵动的,是 AI 编程工具的订阅模式。
市面主流 AI 编程工具均推出 Coding Plan 月付订阅,为用户提供代码补全、模型调用、Agent 执行等权益。在轻量化补全时代,单次调用消耗极低。
但 AI 编程已从单次补全迭代为全流程 Agent 自动化编码,模型可独立完成代码修改、测试运行、报错修复,单次任务 Token 消耗大幅提升。
当底层 API 又同时大幅降价,Coding Plan 也必须找到新的支撑点。这个支撑点,更可能落在工程能力上——比如能不能更好地读懂项目结构,能不能精准选择上下文,能不能控制 tokens 消耗,能不能稳定修改代码,能不能处理 Git、终端、CI/CD,能不能在企业环境里管理权限和审计记录?
同样要重新定位的,还有 API 中转站。对个人开发者来说,便宜和好用仍然重要。但对企业来说,稳定、可审计、可控、可迁移更重要。
沿着这个逻辑继续看,Coding Plan 和中转站的改变只是表层。低价之后更值得追问的,是开发者入口究竟掌握在谁手里。
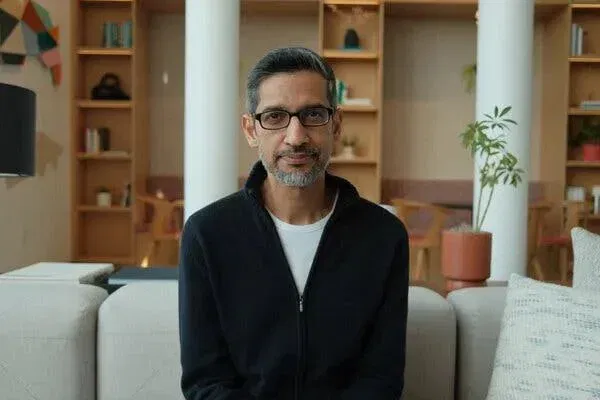
Google CEO Sundar Pichai 最近接受了《Hard Fork》采访,他首次公开承认,Google 在文本、多模态、语音、推理和整体智能上都很有竞争力,但在 agentic coding 这一类能力上,尤其是工具调用、指令跟随和长周期任务,目前还有差距。
他还提到,更关键的是把模型放到真实世界里使用,让数据回流,继续迭代。Pichai 特别说到,coding 是一个需要接触 data flows(数据流)的领域。
终端工具能看到开发者如何提出任务,如何追问,什么时候接受建议,什么时候放弃,什么时候要求模型继续修复。它还可以通过测试结果、终端日志、文件变更和 Git 提交,判断一次 Agent 执行是否完成任务。这类数据,对 coding model 和 Agent 产品都非常有价值。
从公开招聘动作看,DeepSeek 近期围绕 Agent 的动作也变得密集。
我们也可以看到岗位里出现了 Agent 深度学习算法研究员、Agent 数据策略工程师、产品经理、研发工程师等角色。更关键的是,DeepSeek 资深研究员陈德里直接发出招聘信息,提到要从零开始构建 Code Harness。
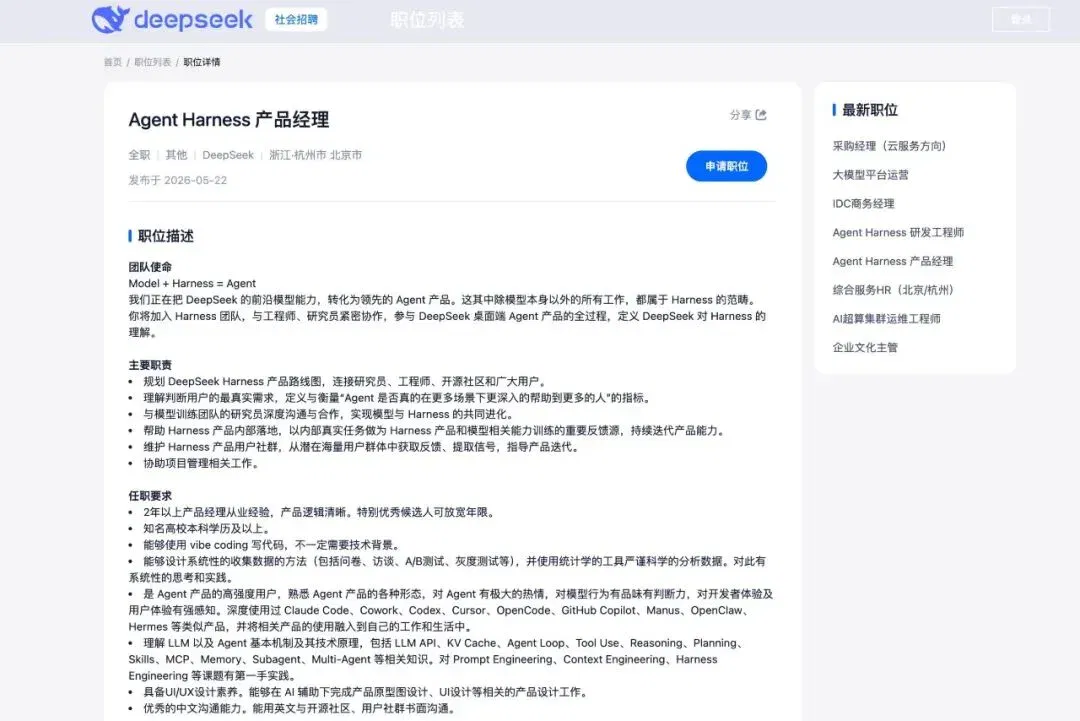
如其所说,Model + Harness = Agent,在 Agent 产品中,模型负责理解和生成,Harness 负责把模型能力带入真实工程环境,相当于模型外面那套「执行系统」。
DeepSeek 版 Claude Code 不能只给开发者一个对话框,而要给开发者一个能持续执行任务的工程系统。
崔添翼加入 DeepSeek 后受到关注,也和 Code Agent 的工程属性有关。
公开信息显示,崔添翼本科毕业于浙江大学计算机系,曾因信息学竞赛保送浙大,6 次获得 ACM 亚洲区域赛金牌,之后在 Jane Street 工作 9 年,并联合创立 TSY Capital。
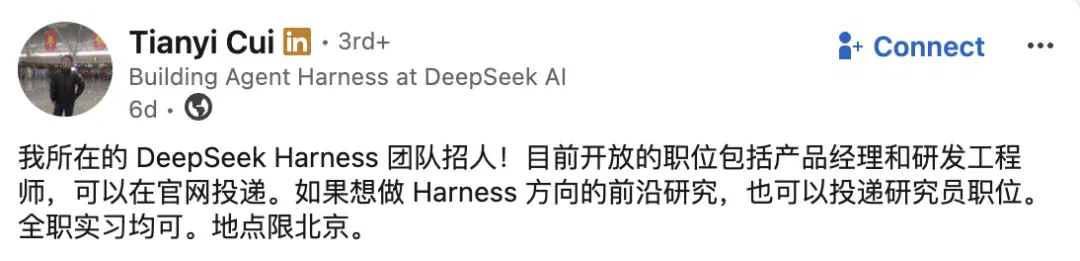
Code Agent 的难点不只是生成代码,还要在真实项目里持续执行任务。量化交易系统长期强调低延迟、稳定性、自动化执行和风险控制,这些经验放到 Agent Harness 上,至少在工程范式上是相通的。
而 Agent 工具的产品能力,不只包括写代码,也包括权限、审计、数据隔离和安全策略。
这反过来给 DeepSeek 这样的国产模型提供了机会。如果 DeepSeek 能把低成本模型、Code Harness、本地部署、企业级权限控制结合起来,它在政企、金融、制造、能源等对数据敏感的行业里,会有更强的替代价值。
DeepSeek 做中国版 Claude Code 的逻辑也正在于此:低价 tokens 把更多开发者吸引进来。低缓存价格让 Agent 任务运行成本下降。Code Harness 让模型进入开发环境。真实工作流又会反过来帮助 DeepSeek 改进模型和产品。
就像滚下坡的雪球,越滚越大,滚得越快。降价只是推下山的第一把力,往后它会自己越滚越沉,谁也拦不住。
文章来自于"APPSO",作者 "APPSO"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Some DeepSeek users encounter long-chat limits; the ecosystem's direction remains unclear (opens in a new tab)
Users report long-conversation limit notices in DeepSeek's app as its community expands through APIs and DSH plugins. The article discusses product and ecosystem roles, but no official explanation links the limits to research priorities or resource allocation.
DeepSeek Expands Its Application APIs With Search, File Parsing and Voice Services (opens in a new tab)
The new interfaces expose web search, webpage reading, document and voice services to developers, alongside an open-source chat demo. Model tokens and tool calls incur separate charges.
作者用 AIRI 与 Live2D 制作可语音互动的「大肥鱼」 (opens in a new tab)
教程记录立绘拆层、绑定、接入对话与语音合成,以及让角色根据屏幕画面点评的做法。积分、模型和配置为作者示例。
DeepSeek Harness 推出预发布更新,扩展代码审查与任务管理 (opens in a new tab)
v0.2.2-alpha.3预发布版本加入实验性变更请求与工作树入口,扩展宿主级任务管理、SDK和插件能力,并改善手机浏览器体验。报道时尚无对应桌面安装包;服务中断与软件更新同时发生,不证明存在因果关联或新模型将发布。
DeepSeek Harness 发布创造模式指南,公开7组插件示例提示词 (opens in a new tab)
DeepSeek Harness 公开创造模式的7组示例提示词,涵盖3D展示、Transformer可视化、视频剪辑、海报、论文阅读、界面主题与会话统计。官方提示,部分演示经过多轮修改,单条提示词未必能复现全部效果;生成插件仍需检查结果和安装权限。