刚刚,DeepSeek开始频繁更新:Tile Kernels、DeepEP V2
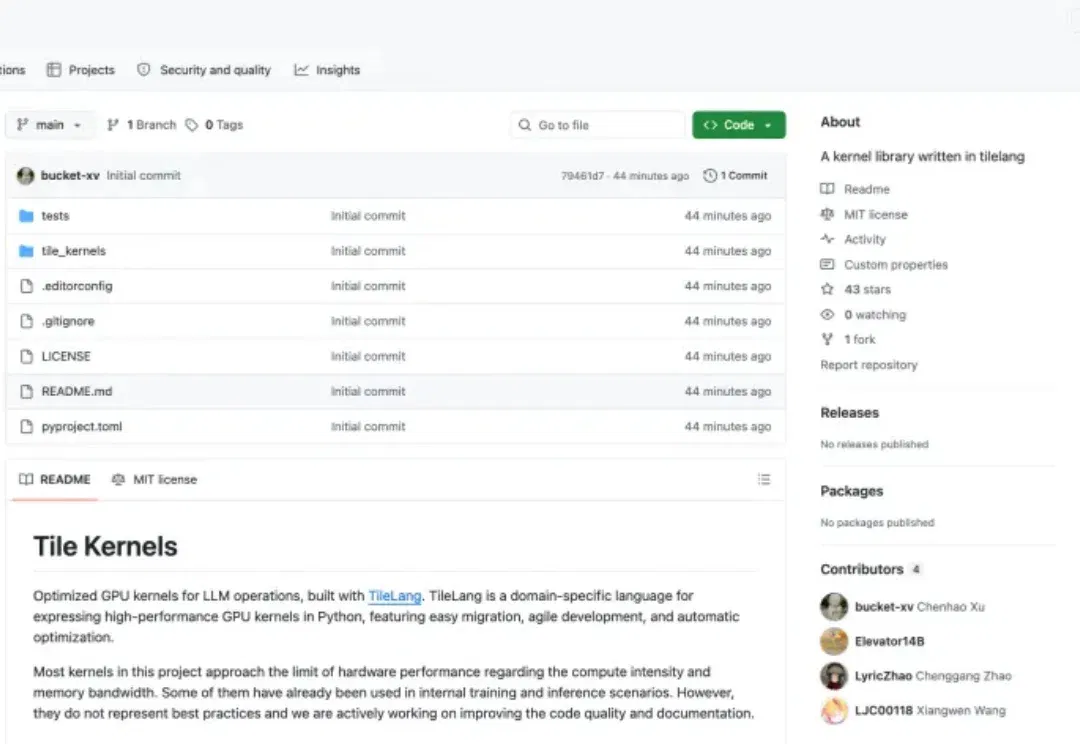
就在刚刚,DeepSeek 的 GitHub 开始了频繁更新,上线开源了一个新的代码库 Tile Kernels,同时并对 DeepEP 代码库进行了更新,上线了 DeepEP V2。距离上次 DeepSeek 悄悄更新 Mega MoE、FP4 Indexer 还不到一周。
就在刚刚,DeepSeek 的 GitHub 开始了频繁更新,上线开源了一个新的代码库Tile Kernels,同时并对 DeepEP 代码库进行了更新,上线了DeepEP V2。距离上次DeepSeek 悄悄更新 Mega MoE、FP4 Indexer(在新窗口打开)还不到一周。
Tile Kernels
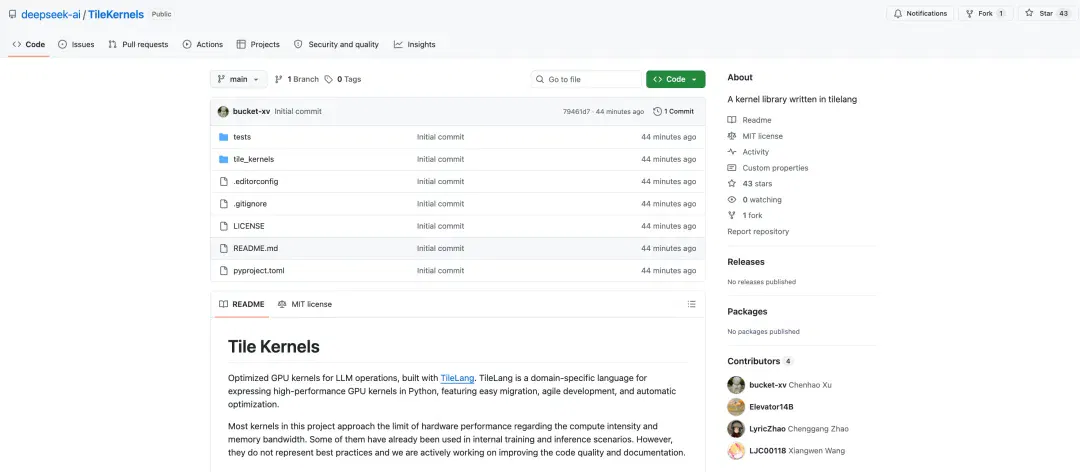
链接:https://github.com/deepseek-ai/TileKernels
据介绍,Tile Kernels 是为 LLM 操作优化的 GPU kernels,是用 TileLang 构建的。而 TileLang 是一种用于在 Python 中表达高性能 GPU kernels 的领域特定语言,具备易迁移、敏捷开发和自动优化等特性。
Tile Kernels 的性能非常强悍,正如 DeepSeek 写的那样:「本项目中的大多数 kernels 在计算强度和内存带宽方面都已接近硬件性能上限。其中部分已经在内部训练和推理场景中投入使用。不过,它们尚不代表最佳实践,我们也在持续改进代码质量和文档。」
代码库的介绍信息不多,然而字里行间「剧透」了 DeepSeek 下一代模型底层的架构创新路线。
下面是 Tile Kernels 的一些具体特性:
- 门控机制:用于 MoE 路由的 Top-k 专家选择与打分
- MoE 路由:Token 到专家的映射,融合的扩展 / 归约以及权重归一化
- 量化(Quantization):支持 per-token、per-block、per-channel 的 FP8/FP4/E5M6 转换,并融合 SwiGLU + quantization 操作
- 转置:批量转置操作
- Engram:Engram gating kernels,融合 RMSNorm、前向 / 反向传播以及权重梯度归约
- Manifold HyperConnection:超连接 kernels,包含 Sinkhorn 归一化以及 mix 的拆分与应用
- Modeling:高层 torch.autograd.Function 封装,将底层 kernels 组合为可训练层(engram gate、mHC pipeline)
EPv2:更快的 EP、并支持 Engram/PP/CP
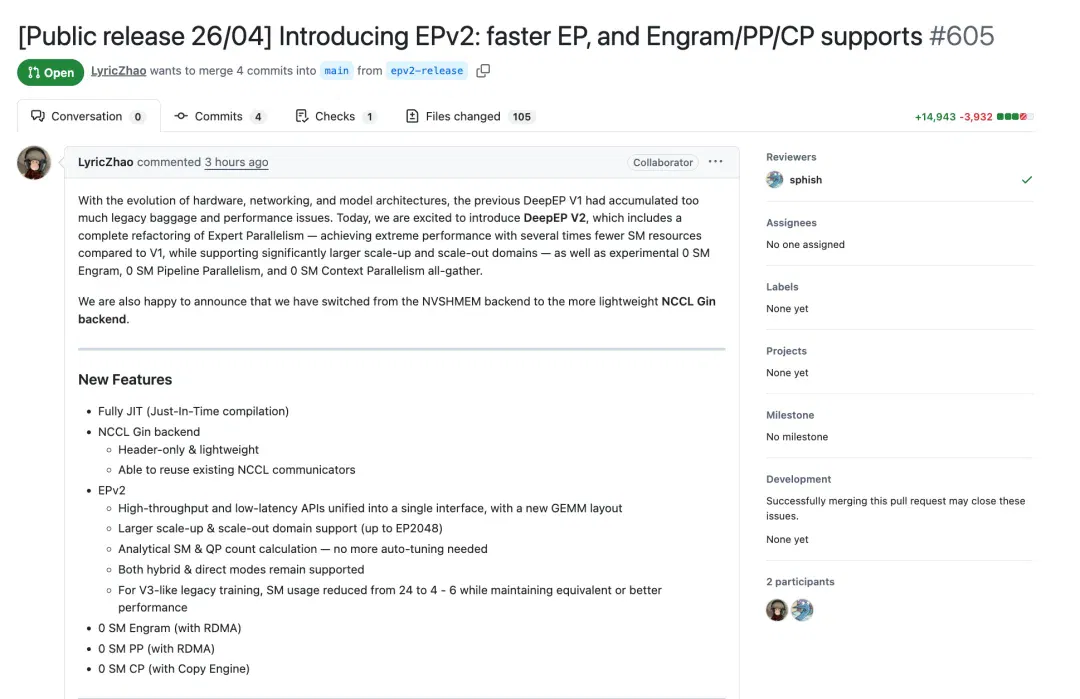
EPv2 地址:https://github.com/deepseek-ai/DeepEP/pull/605
在今天更早的时候,DeepSeek 还发布了最新版本的EPv2,实现了更快的专家并行(EP),并支持 Engram / 流水线并行(PP)、上下文并行(CP)。
随着硬件、网络和模型架构的演进,DeepSeek 此前的 DeepEP V1 积累了过多的历史包袱和性能问题。
本次更新对专家并行(Expert Parallelism)进行了彻底重构 —— 与 V1 相比,仅需几分之一的 SM 资源即可实现极致性能,同时支持更大规模的 Scale-up(单机扩展)和 Scale-out(跨机扩展)。
此外,DeepSeek 还在本次更新中推出了实验性的 0 SM 系列方案,包括 0 SM Engram、0 SM 流水线并行(PP)以及 0 SM 上下文并行(CP)的 All-gather 算子。此外,后端已从 NVSHMEM 切换为更加轻量化的 NCCL Gin 后端。
下面是 DeepEP V2 版本的一些新特性:
- 全时即时编译 (Fully JIT)
- NCCL Gin 后端:
- 仅包含头文件(Header-only),极致轻量。
- 能够复用现有的 NCCL 通信器。
- EPv2:
- 将高吞吐与低延迟 API 统一为单一接口,并采用全新的 GEMM 布局。
- 支持更大规模的扩展领域(最高支持 EP2048)。
- 引入分析化的 SM 和 QP 计数计算 —— 无需再进行自动调优(Auto-tuning)。
- 持续支持混合模式(Hybrid)与直接模式(Direct)。
- 针对类 V3 的旧版训练任务,SM 占用从 24 个降至 4-6 个,同时保持同等甚至更优的性能。
- 0 SM Engram(配合 RDMA)
- 0 SM PP(配合 RDMA)
- 0 SM CP(配合 Copy Engine)
性能表现
遵循 DeepSeek-V3 的配置,在新版本下,在每批次 8K token、7168 隐层维度、Top-8 专家、FP8 分发以及 BF16 结合的设置下进行了测试,结果如下:
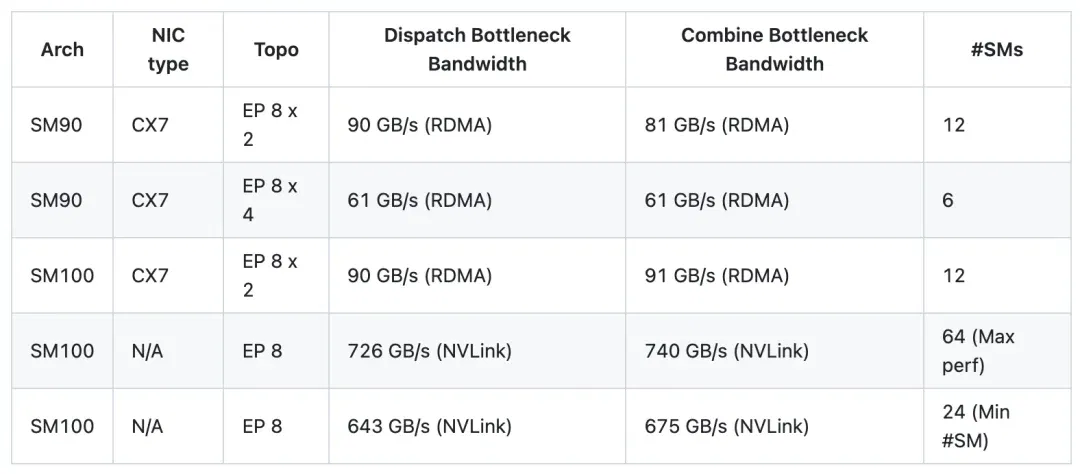
说明:结果显示的是逻辑带宽。例如在 EP 8 x 2 的情况下,90 GB/s 的带宽实际上包含了本地显卡(local rank)间的流量。
与 V1 相比,V2 实现了高达 1.3 倍的峰值性能,同时节省了多达 4 倍的 SM 资源占用。
最后,劝一下 DeepSeek,赶快发 V4 吧,都等急了。
文章来自于"机器之心",作者 "机器之心编辑部"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Some DeepSeek users encounter long-chat limits; the ecosystem's direction remains unclear (opens in a new tab)
Users report long-conversation limit notices in DeepSeek's app as its community expands through APIs and DSH plugins. The article discusses product and ecosystem roles, but no official explanation links the limits to research priorities or resource allocation.
DeepSeek Expands Its Application APIs With Search, File Parsing and Voice Services (opens in a new tab)
The new interfaces expose web search, webpage reading, document and voice services to developers, alongside an open-source chat demo. Model tokens and tool calls incur separate charges.
作者用 AIRI 与 Live2D 制作可语音互动的「大肥鱼」 (opens in a new tab)
教程记录立绘拆层、绑定、接入对话与语音合成,以及让角色根据屏幕画面点评的做法。积分、模型和配置为作者示例。
DeepSeek Harness 推出预发布更新,扩展代码审查与任务管理 (opens in a new tab)
v0.2.2-alpha.3预发布版本加入实验性变更请求与工作树入口,扩展宿主级任务管理、SDK和插件能力,并改善手机浏览器体验。报道时尚无对应桌面安装包;服务中断与软件更新同时发生,不证明存在因果关联或新模型将发布。
DeepSeek Harness 发布创造模式指南,公开7组插件示例提示词 (opens in a new tab)
DeepSeek Harness 公开创造模式的7组示例提示词,涵盖3D展示、Transformer可视化、视频剪辑、海报、论文阅读、界面主题与会话统计。官方提示,部分演示经过多轮修改,单条提示词未必能复现全部效果;生成插件仍需检查结果和安装权限。