刚刚,MiniMax新模型接管「音乐圈」!20秒出歌Cover全风格
4 月 10 日,MiniMax 又带来一次重磅更新,其中最核心的新功能,就是 Cover 翻唱。一首平平无奇的生日快乐歌,可以被 cover 成 EDM 风格:经典的《友谊地久天长》也能被 AI 改编成灵魂乐调调:
音乐圈,正被 AI 搅得天翻地覆。
这两年 AI 音乐的进化速度,比大多数人预想得都快。
过去想做出一首像样的作品,要经历词、曲、编、录、混五道环节,周期起码半个月起,成本少则几千,多则数万。AI 出现后,输入一句提示词就能直出完整作品,创作成本一压再压。
而现在,我们甚至连提示词都不用研究了,找首喜欢的歌丢给 AI,它直接翻唱成我们想要的风格,毫无音乐基础的普通人,也能在几分钟内拿到一首属于自己的歌。
AI 音乐,正加速迈进一个零成本创作时代。
4 月 10 日,MiniMax 又带来一次重磅更新,其中最核心的新功能,就是Cover 翻唱。
一首平平无奇的生日快乐歌,可以被 cover 成 EDM 风格:
经典的《友谊地久天长》也能被 AI 改编成灵魂乐调调:
与此同时,MiniMax 还正式上线Music 2.6 模型,并发布专属 Music Skills。
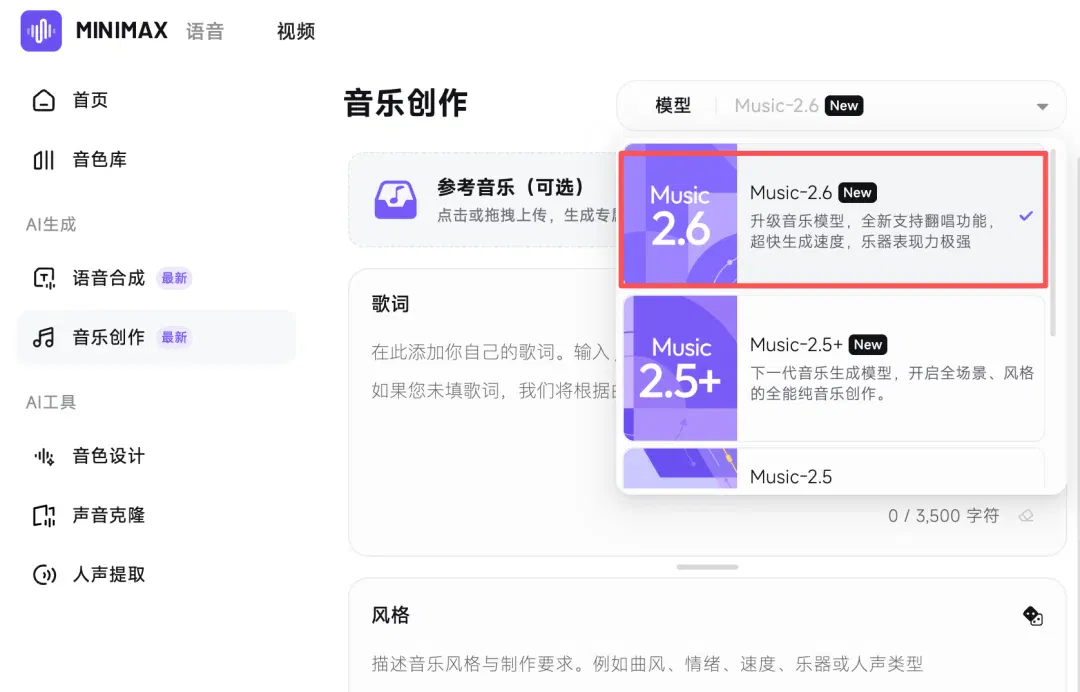
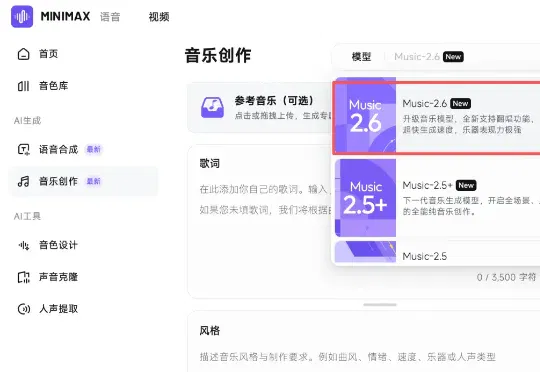
相比上一版本,Music 2.6 的改进集中在三条线上:速度、音乐性和音质。首包延迟预计压缩到 20 秒以内;乐器种类更丰富,人声也往随性、自由的真实演唱状态靠拢;音质上则重点优化了中低频,贝斯和鼓点的下潜质感改善明显。
比如这首烟熏感的前卫爵士与新灵魂乐融合曲:
目前,Music 2.6 已开放体验,C 端用户可免费畅玩 14 天,每日有 500 首免费生成额度,API 也对所有用户开放 Music 2.6 和 Cover 的调用。
体验链接:https://www.minimaxi.com/audio/music
接下来,我们就奉上一手实测。
Cover 翻唱能力:旋律留下,风格换掉
Cover 翻唱是 AI 音乐领域一直被反复尝试、却也反复翻车的难题。
难点在于旋律要留,但所有包裹它的编曲语言、演唱风格、律动质感,要能做到真正的风格置换。
MiniMax 这个新功能可以在保持参考歌曲旋律特征基础上,自由进行伴奏改编、歌词替换、风格迁移。
我们先测下歌词替换、旋律保留。这个需求在内容创作圈子很普遍,比如做鬼畜二创、品牌定制改编曲、节日特供版本等,核心诉求都是旋律不动换个歌词。
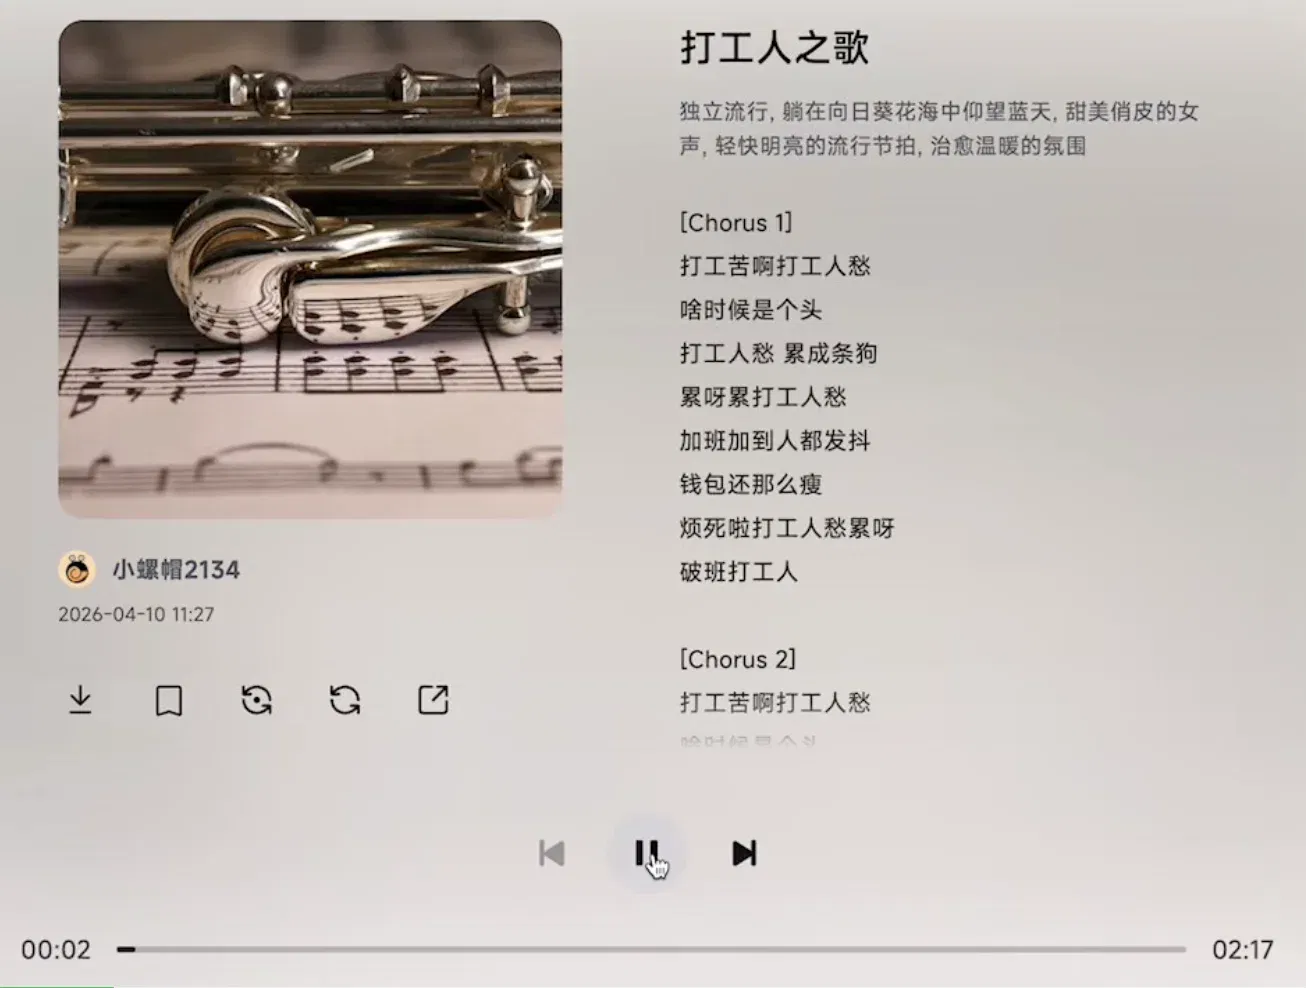
我们选了首网络神曲《哈基米》,把歌词换成职场打工人日常碎碎念。
新歌词的音节分布和字数密度与原旋律的吻合度相当高,不需要事后手动调整哪句词和旋律对不上的问题。对于没有乐理基础、但有改词需求的用户来说,这一步节省的时间和试错成本相当可观。
再听下昏暗的老式爵士酒吧里独饮、饱经沧桑沙哑男声的灵魂乐版。
我们又上传一首耳熟能详的江苏民歌《茉莉花》,要求改编成摇滚版本。
AI 翻唱中,编曲融入强烈的电吉他失真节奏与贝斯驱动,配合激烈的鼓组设计,前奏以现代摇滚元素切入,副歌人声高亢有力,爆发力与舞台氛围感均在线。
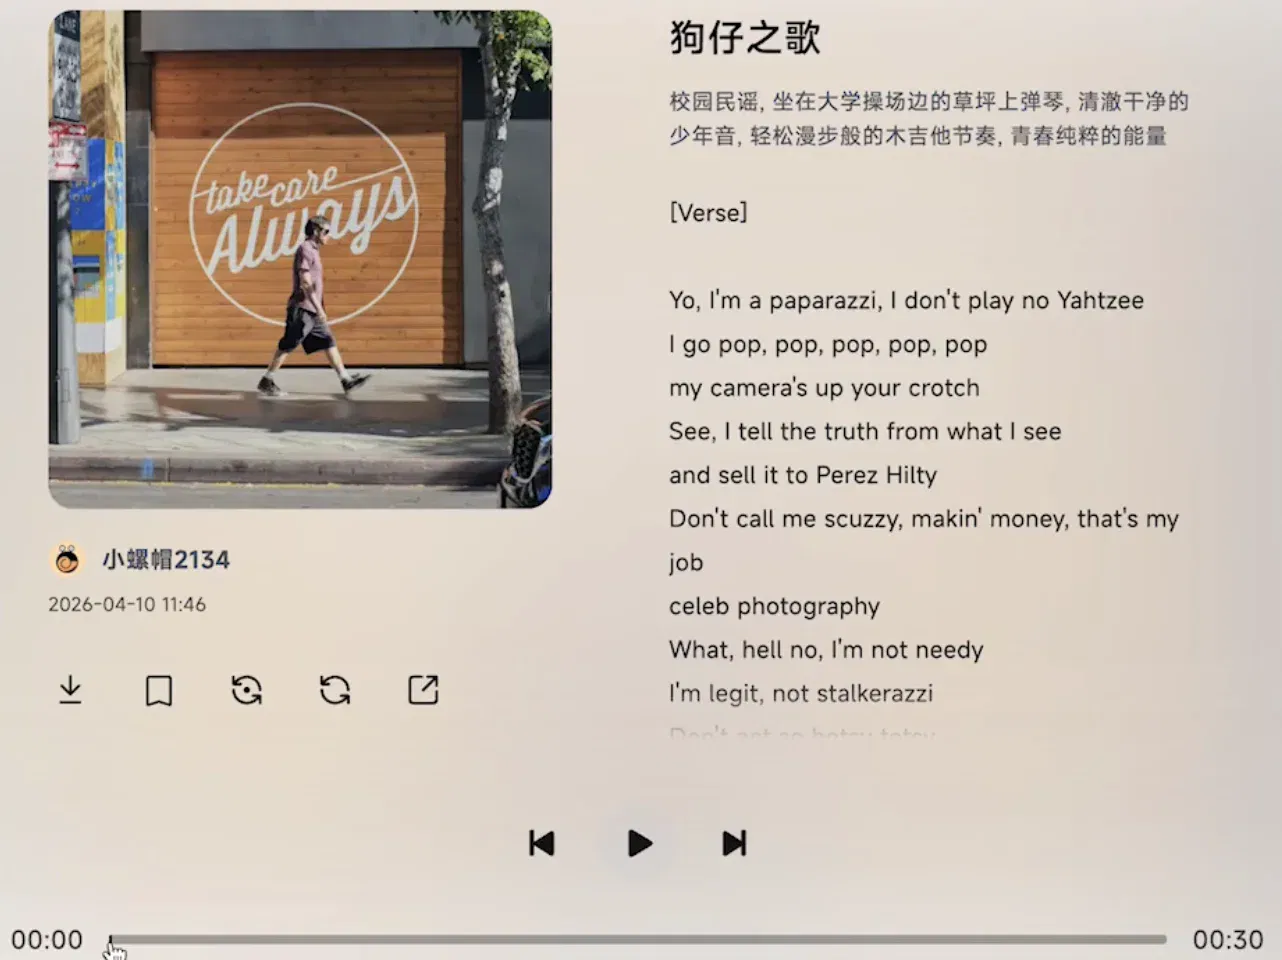
在一次节目上,安妮・海瑟薇即兴说唱 diss 狗仔。我们就让 MiniMax 把这首节奏密度很高的说唱改成校园民谣风格。
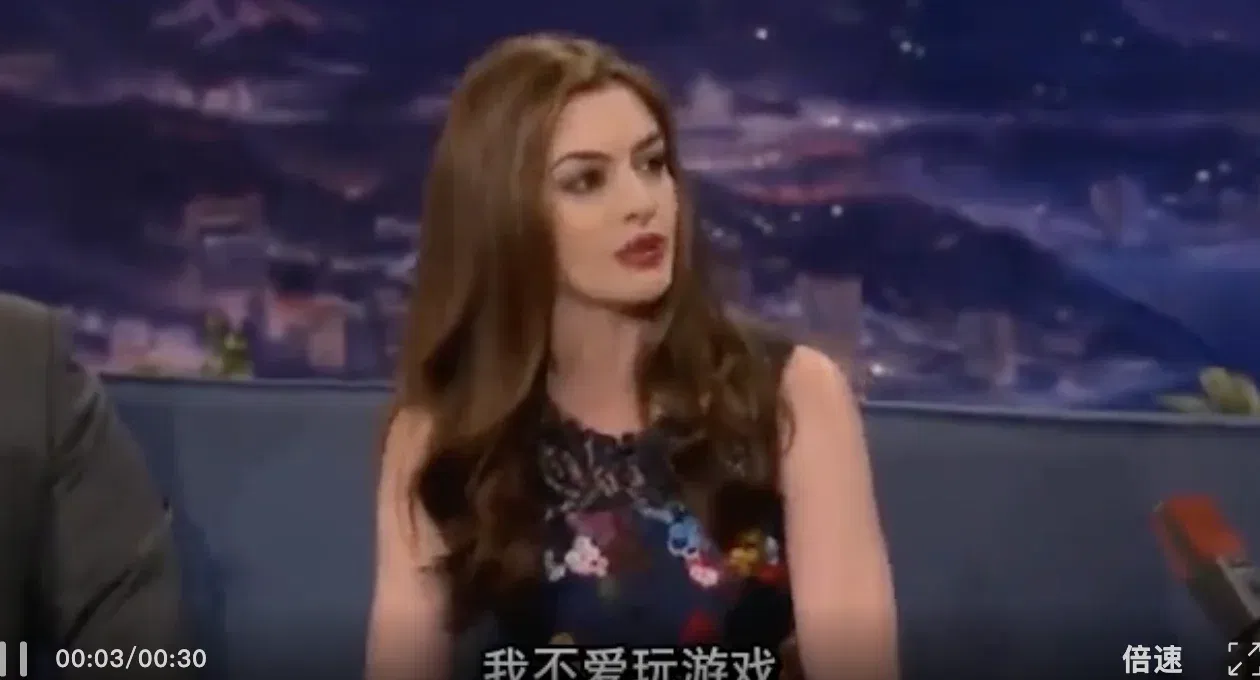
AI 模拟的人声蛮自然,吉他伴奏编排流畅,托得住人声,将充满侵略性的说唱词配上温柔的民谣曲调,有种一本正经唱怪词的幽默。
Music Skills:普通人随心「手搓」音乐
此次更新,MiniMax 还开放了三个 Music Skills 套件,托管在 GitHub 仓库,可通过 mmx-cli 丝滑调用。
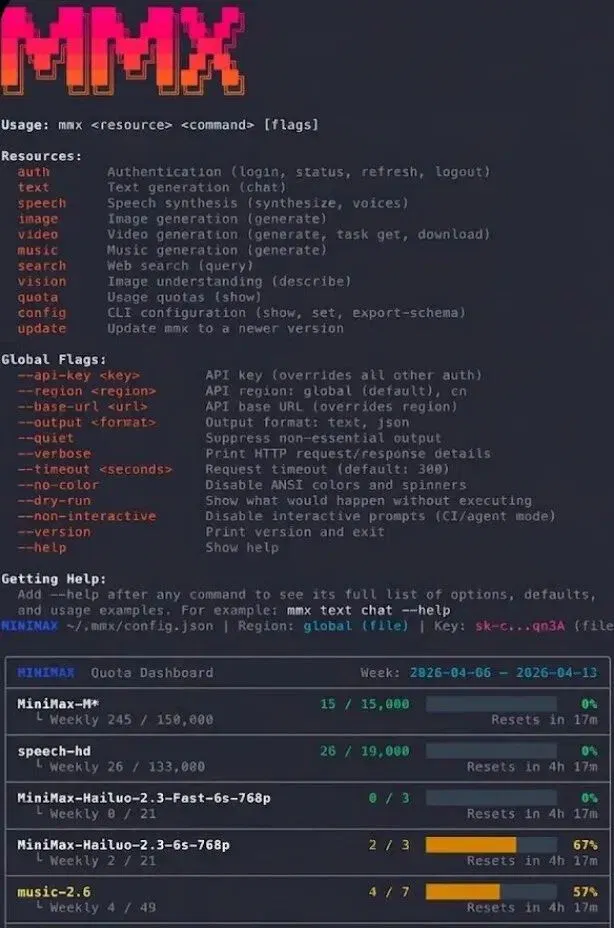
音乐生成也正在快速走向 Agent 化,AI 能主动理解我们的需求、处理多步操作,大大突破了交互和工作流的局限,以前想不到的玩法,现在都变得容易实现了。
其中minimax-music-gen作为核心生成引擎,封装了人声、纯音乐和翻唱三种模式。我们可以通过简单的 Prompt 或 API 调用实现精准的强控制创作。
GitHub 链接:https://github.com/MiniMax-AI/skills/tree/main/skills/minimax-music-gen
如果觉得单曲不过瘾,还可以试下minimax-music-playlist。这是个性化歌单生成器,能扫描本地音乐应用,如 Apple Music、QQ 音乐、Spotify 或网易云,构建我们的音乐品味画像,包括风格分布、语言偏好、情绪倾向等,并据此规划生成 3 到 7 首定制歌单。整个过程支持实时反馈评分,歌单越听越合心意。
比如说一句「帮我生成一个深夜放松的歌单」或「给我做个 3 首歌的通勤歌单」,Agent 便会自动扫描本地音源、规划歌单并播放。
GitHub 链接:https://github.com/MiniMax-AI/skills/tree/main/skills/minimax-music-playlist
buddy-sings则专为宠物爱好者打造。它会读取 Claude Code 宠物名字和个性,自动生成专属声音身份,以宠物第一人称视角创作并演唱歌曲,还能根据当前会话上下文来个即兴创作。
GitHub 链接:https://github.com/MiniMax-AI/skills/tree/main/skills/buddy-sings
只要在环境变量中配置好 API Key,通过简单的命令行切换中英双语,一个本地 AI 音乐工作室就搞定了。
Music 2.6 模型:听听它到底进步在哪
与上一版本相比,Music 2.6 已经进入「可控创作」阶段,不管是控制性、实时性,还是创作自由度上,都有全方位突破。
简单来说,就是更丰富自然、律动感更强、创作更便捷。
音乐性上最直观的变化,是乐器种类的扩充,支持超 100 种乐器,乐器与人声的配合也更紧密、和谐。
在音质上,Music 2.6 提升的不只是声音变清晰,中低频优化后带来的律动感更强,非常适合节奏感强的流行、电子或摇滚乐。
例如用「节奏感强的流行、摇滚乐」这几个字作为提示词,就能跑出一首完整的歌曲。
Music 2.6 对非专业创作者最友好的一点,是沟通成本大幅降低,即便不输入歌词,只给出风格提示词,最快 20s 内即可生成一首包含歌词的完整曲目。
纯器乐提示词:「爵士小酒馆,钢琴三重奏,有点慵懒。」
我们还尝试了「古词新唱」,将《水调歌头》的词直接作为歌词,分别搭配不用风格提示词,短时间内就得到风格迥异的 demo。
提示词:「古风,古典、琵琶、古琴。」
提示词:「民谣、原声吉他、忧郁。」
总而言之,Music 2.6 在情绪掌控、BPM(速度)与 Key(调性)锁定上,已经实现以用户意图为导向,不再像之前那样「开盲盒」随机输出。
现在只要给出明确的情感基调与节奏指令,它就能交出契合需求且富有感染力的作品。
结语
AI 音乐和真人音乐,最终的区别在哪里?
技术层面的差距在快速收窄,这是无法回避的事实。Music 2.6 在延迟、控制精度和音乐性上的进步,都是可感知的,不是「挤牙膏式」的小修小补。
Cover 能力的加入,更是把 AI 音乐推向「二次创作」的维度,这个维度历来是人类音乐人最活跃的领域之一。
创作的门槛在变低。有旋律想法但不会编曲、想做播客但请不起音乐人、想给自家宠物写一首搞笑歌…… 以前这些念头只能留在脑子里,现在不用了。
技术永远是工具,工具足够好用的时候,它真正解放的,是那些一直有想法、只是缺少出口的人。
文章来自于微信公众号 "机器之心",作者 "机器之心"
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
MiniMax Code lead on why review and task management matter as AI writes code (opens in a new tab)
MiniMax Code lead Ronny discusses internal adoption, context management and tool orchestration, then outlines personal-agent collaboration and task management. Figures such as 95% of code and 15% token-efficiency gains are team reports; future product forms are his views.
Alibaba’s HappyShrimp launches a mobile app; media trial explores songwriting and sharing (opens in a new tab)
Zhidongxi tried mood prompts, original lyrics and reference styles, recording generation times of about one to two minutes while noting limitations in vocal nuance and melody.
MiniMax 发布 H3-Image 并开放权重,支持 16 张参考图 (opens in a new tab)
H3-Image 支持文生图、参考图生成及编辑。MiniMax 公布了 4K 输出与最多 16 张参考图的能力,权重使用受其社区许可证约束。
MiniMax 闫俊杰谈推理成本、开放权重与多模态模型 (opens in a new tab)
闫俊杰在 Scottish Mortgage 播客解释低推理成本如何支持后训练,并讨论 H3 开放权重和 M3 Pro 的开发进度。访谈亦区分年化收入运行率与财报收入。
MiniMax H3 扩展开源生态:视频增强、蒸馏与商业授权 (opens in a new tab)
据报道,英伟达相关团队及Pika基于MiniMax H3探索高分辨率再生成和少步推理。文章同时分析其社区许可与单独商业授权路径;开放权重并不等于在所有地区、所有商业规模下均可免费使用。