CVPR 2026 | 1B模型也能当多镜头导演?大连理工&快手可灵开源力作MultiShotMaster
近期,大连理工与快手可灵团队推出了 MultiShotMaster—— 一个高度可控的多镜头视频生成框架,该论文向研究社区展示了即使在 1B 左右的小参数量级模型上,也可以实现导演级的镜头调度和连贯叙事,且支持多图参考、主体运动控制。
该论文由大连理工大学、快手可灵团队、香港中文大学联合完成,第一作者王清和是大连理工大学在读三年级博士,研究方向为视频生成,师从卢湖川、贾旭教授,目前在快手可灵团队实习。个人主页:https://qinghew.github.io/
近期,可灵 3.0、Seedance 2.0 等产品的多镜头叙事能力相继爆火,可支持一次生成多个导演级镜头,标志着视频生成领域已经从传统的单镜头生成迈入了多镜头视频生成的时代。然而,对于预算有限的开发者,10B 参数量以上的大模型开发成本较高,100B 以上的大模型更令人望而却步。
近期,大连理工与快手可灵团队推出了MultiShotMaster——一个高度可控的多镜头视频生成框架,该论文向研究社区展示了即使在 1B 左右的小参数量级模型上,也可以实现导演级的镜头调度和连贯叙事,且支持多图参考、主体运动控制。
目前,该论文已录用至CVPR 2026,基于 Wan 1.3B 和 14B 的多镜头模型的训练和推理代码已开源:
- 项目主页:https://qinghew.github.io/MultiShotMaster/
- 代码链接:https://github.com/KlingAIResearch/MultiShotMaster
- 论文链接:https://arxiv.org/abs/2512.03041
开源版 MultiShotMaster 能力展示
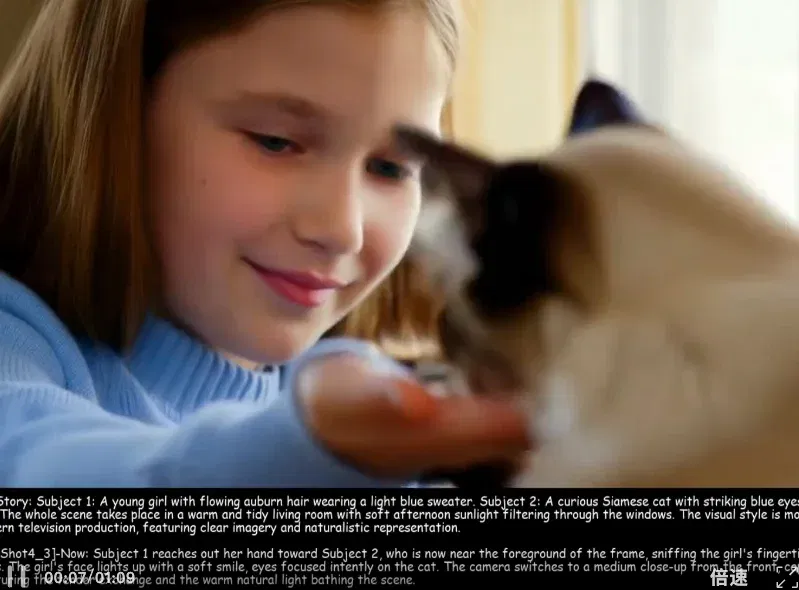
MultiShotMaster-14B 720p 效果
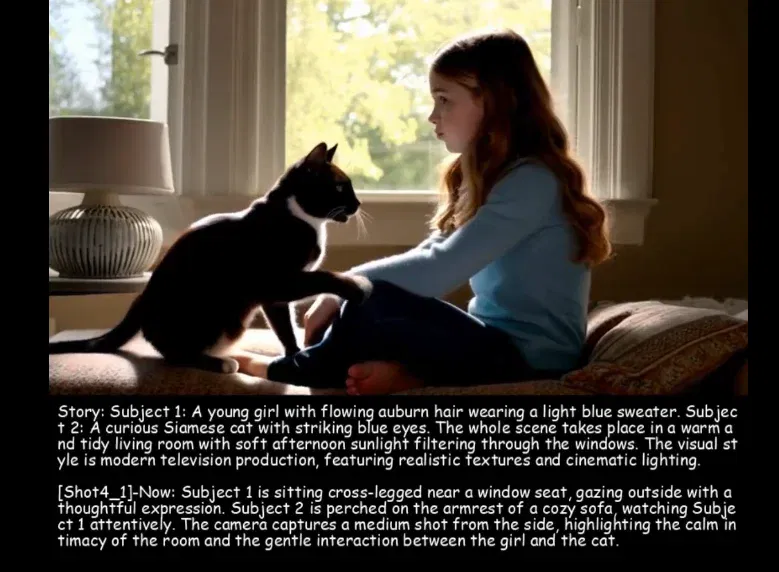
MultiShotMaster-1.3B 480p 效果
值得一提的是,开源版 MultiShotMaster 斩获了AAAI CVM Workshop 竞赛冠军。该竞赛由北大等高校举办、华为赞助,重点考核世界知识一致性、相机移动一致性、跨镜头 ID 一致性三个层面,充分印证了该模型在多镜头生成与连贯叙事方面的卓越性能。
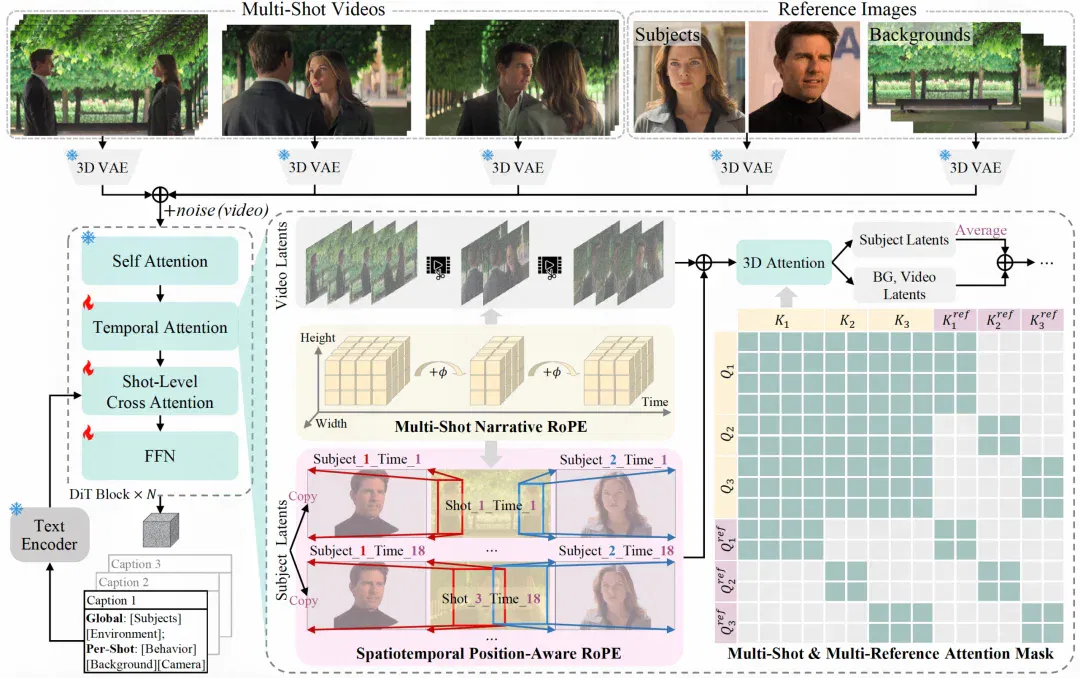
MultiShotMaster 框架
“单镜头” 到 “多镜头” 的进化
MultiShotMaster 首先调整了传统的单镜头文生视频模型架构,使之能够生成多镜头视频。
具体而言,考虑到镜头间的内容突变,每个镜头需单独通过 3DVAE 编码,然后在时序上级联起来,并在 Temporal Attention 处融合。由于镜头之间不仅存在内容突变,还需保证叙事的先后顺序,作者提出多镜头叙事 RoPE,即基于原始的 3D RoPE 在镜头切换处施加相位偏移:
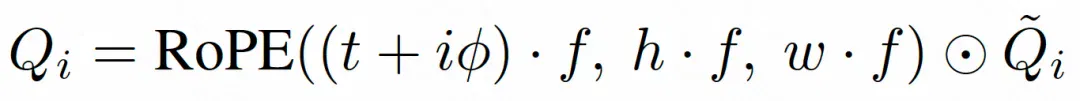
这显式地标记了镜头边界且维持了原镜头间的叙事顺序,让模型能够精准识别镜头边界,从而支持用户自由设定镜头的数量和时长。此外,构建了总分式提示词结构,全局提示词描述角色外观、环境及风格,镜头级提示词描述角色交互、场景布局、相机运镜。在镜头级 Cross Attention 中,每个镜头的视频只与全局提示词、对应镜头的提示词交互,从而防止跨镜头信息泄露。
时空位置感知的参考注入
用户通常期望视频生成模型具有更多的可控性,例如使用参考图、控制主体运动布局等能力。为此,作者用 VAE 编码参考图像,使之与视频 tokens 落入同一特征空间。
考虑到 3D-RoPE 会使时空距离更近的 tokens 在 Attention 中增强交互,作者设计了时空位置感知的 RoPE,将指定时空区域的 RoPE 重采样为更细粒度的 RoPE 分配给参考 tokens。
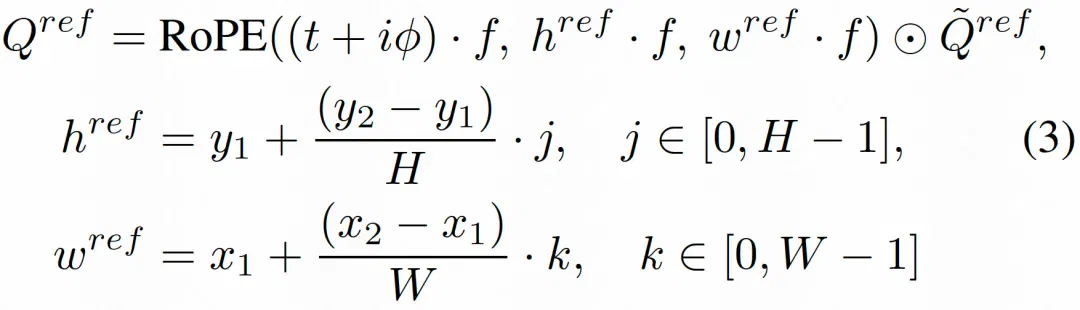
在时序注意力中,干净的参考 tokens 会将视觉信息传递给噪声视频 tokens 以实现参考图像(主体/背景)指定时空位置的注入。当用户期望控制同一主体的运动轨迹时,可以通过复制多次同一角色的 Token 并分配不同的时空 RoPE。
此外,为了管理上下文信息流,防止不必要的 token 交互,作者设计了多镜头-多主体 Attention Mask,允许跨镜头的视频 tokens 交互,限制每个镜头的视频 tokens 仅能与视频内的参考 tokens 交互。
值得注意的是,MultiShotMaster 没有引入外部参数,而是利用、改进视频生成模型原有的 3D-RoPE,从而实现了可控的多镜头视频生成,支持文本驱动的镜头间一致性、可灵活配置的镜头数量和时长、运动可控的主体定制化、背景可定制的场景一致性。这一多功能框架为多样化多镜头视频内容创作提供了新的可能性,使用户能够打造高度定制化的视频叙事。
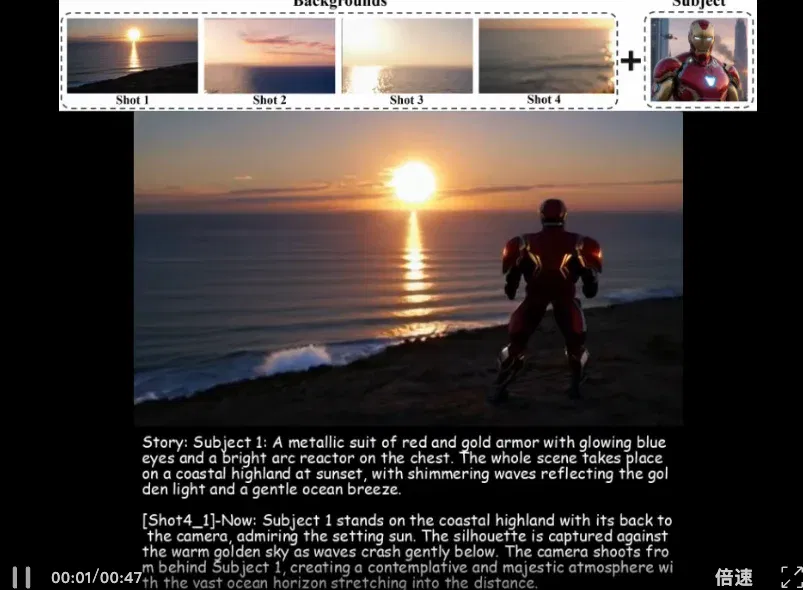
MultiShotMaster - 实验版 1B 模型(384×672)效果
MultiShotMaster 训练数据构建流程
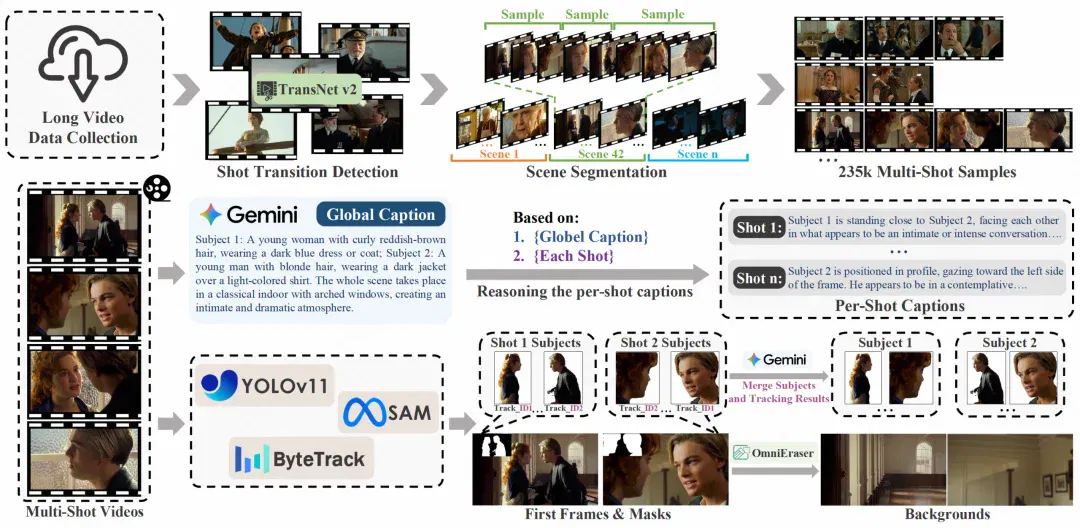
数据构建流程:
- 采用镜头切换检测模型 TransNet V2 将长视频裁切成短片段,使用场景分割模型 SceneSeg 将同一场景内的片段聚合到一起,然后从中采样多镜头视频。
- 引入总分式提示词结构,使用 Gemini-2.5-Flash 生成全局描述和每个镜头的描述。
- 整合 YOLOv11、ByteTrack 和 SAM 来检测、追踪和分割主体图像,然后利用 Gemini-2.5-Flash 根据主体外观合并跨镜头的跟踪结果。
- 使用 OmniEraser 获得干净的背景参考图。
实验结果
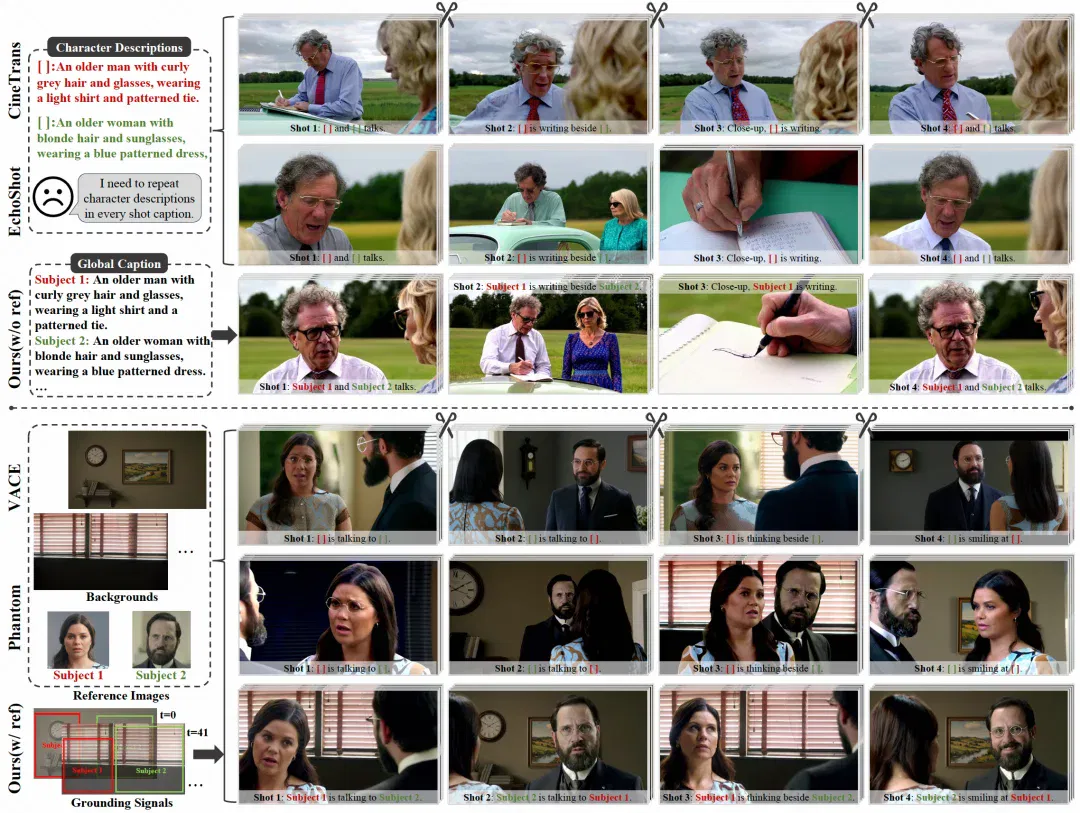
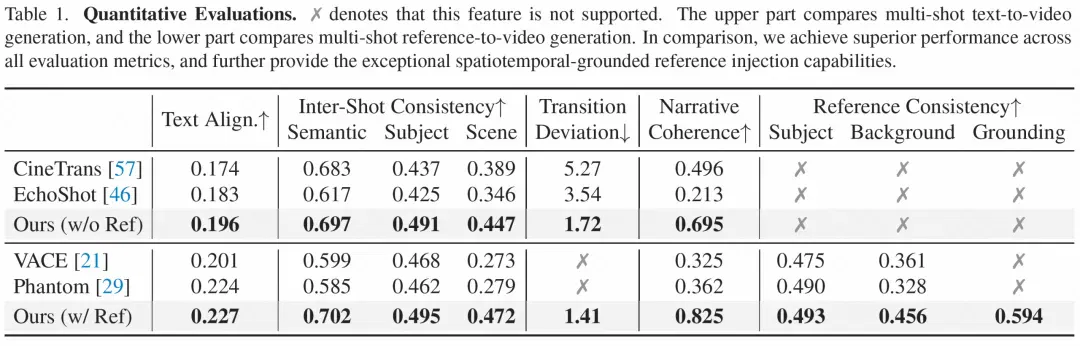
除了对比现有的 SOTA 多镜头视频生成模型之外,由于目前没有支持参考图输入的多镜头视频生成模型,作者对比了支持参考图输入的单镜头模型 Phantom、VACE,拼接他们逐个生成的镜头用于比较。
可以看出,在定量和定性的比较中,MultiShotMaster 在镜头间一致性、切镜准确性、叙事连贯性、参考图一致性上都展现出了卓越的性能。
定性实验结果:
定量实验结果:
总结
MultiShotMaster 通过对 RoPE 的创新性改进,实现了高度可控的多镜头视频生成。其引入的多镜头叙事 RoPE 与时空位置感知 RoPE,在无需引入额外参数的情况下,实现了对镜头边界、角色一致性及运动轨迹的精细化操控。在仅约 1B 参数的模型规模下即可展现出了卓越的叙事连贯性与跨镜头一致性,验证了其实现导演级控制的巨大潜力。
同时,自动化的多镜头数据标注流程及开源模型也将为社区的研究提供强力支持,有望推动 AI 视频创作进入一个叙事更连贯、表达更自由的新阶段。
更多细节请参阅原论文。
文章来自于微信公众号 “机器之心”,作者 “机器之心”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.

ConvexLLM connects speech to language models through frozen text embeddings (opens in a new tab)
Researchers at CUHK-Shenzhen and Microsoft propose C-Gate, mapping audio into convex combinations of frozen text embeddings. The paper reports VoiceBench gains against its listed open-model baselines, while audio understanding and transcription still involve trade-offs.

CWM2.0 open-sources generative rendering with a 30-minute racing demo (opens in a new tab)
Teams from Ant, Westlake University and Zhejiang University use a structured Proxy to control scene state and Invoker-Render to generate visuals, releasing eight-GPU streaming inference. The long demo and 140 evaluations cover specified scenes, not arbitrary stable worlds.

Ankole outlines multi-user agent architecture: events, permissions and organizational memory (opens in a new tab)
The team describes its Business Harness design for fast and slow paths, shared state, Actor orchestration and dynamic permissions. Formal verification covers the modeled core permission state machine; it does not replace security checks of the full deployment, external interfaces or implementation.

openJiuwen presents a Harnessless approach for reusing AgentOS execution tools (opens in a new tab)
openJiuwen uses app-development and swarm demos to show how built-in harness capabilities support sessions, tools and app management. Applications still define business rules and permissions; remote deployment and some capabilities remain planned or exploratory.

Ask-to-Distill optimizes training questions using teacher–student distribution signals (opens in a new tab)
UIUC and collaborators propose A2D, training a question generator with frozen teacher–student disagreement and compatibility signals before on-policy distillation. The paper reports gains in math, code and agent tasks; its learning-value proxy has limits.