官宣,Milvus开源语义高亮模型:告别饱和检索,帮RAG、agent剪枝80%上下文
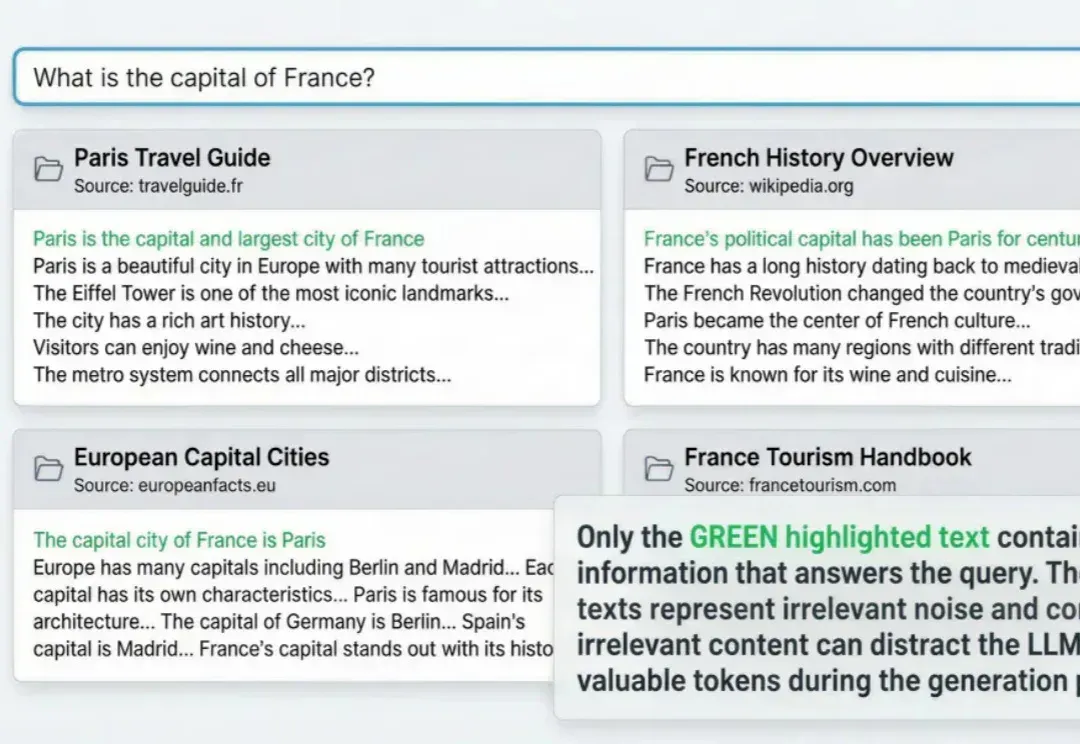
RAG与agent用到深水区,一定会遇到这个问题: 明明架构很完美,私有数据也做了接入,但项目上线三天,不但token账单爆了,模型输出结果也似乎总差点意思。
RAG与agent用到深水区,一定会遇到这个问题:
明明架构很完美,私有数据也做了接入,但项目上线三天,不但token账单爆了,模型输出结果也似乎总差点意思。
原因在于,针对大模型的RAG、agent架构,其检索模块,本质上可视为传统搜索做的衍生变体。
这就导致了一个问题,传统搜索系统,比如搜索引擎、推荐系统等,需要饱和式输出,保证用户能够收到关于检索结果所有召回信息,然后人类会自动在其中选择适合的信息消化吸收。
但这一思路,迁移到RAG上,一次query,就能召回10段文档给LLM,然后每篇文档几千字,这就导致一个query就要消耗几万个token。
但问题是,这10篇文档里,真正有用的句子可能只有几十句,而剩下的,全是噪音。大量的噪音灌入,不仅浪费token,也分散了LLM注意力。
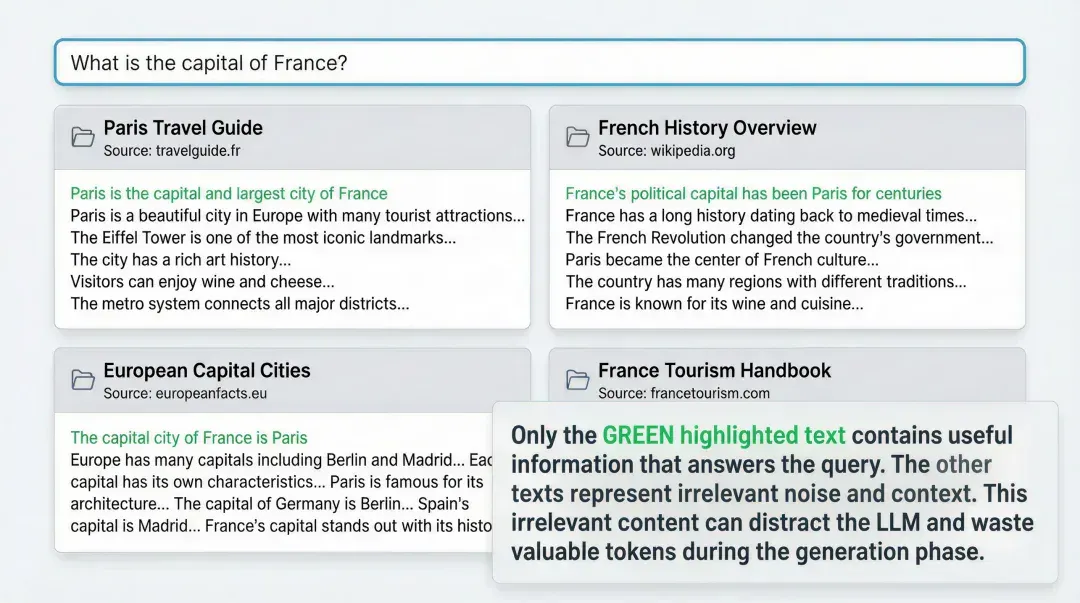
那么,怎么解决RAG召回上下文太长的问题?
不妨借鉴传统搜索中的重点内容Highlight高亮能力,来为大模型做精准的上下文剪枝。
欢迎体验我们最新开源的中英文双语语义高亮模型Semantic Highlight!
HuggingFace链接:zilliz/semantic-highlight-bilingual-v1
01
官宣:我们开源了Semantic Highlight的SOTA模型
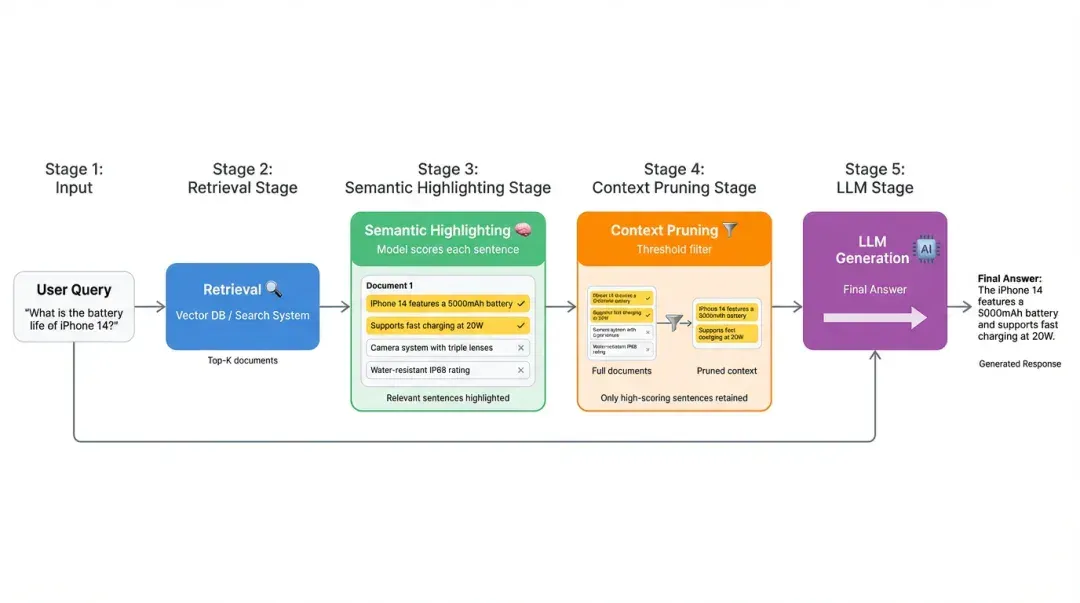
要解决RAG召回上下文太长的问题,一个最简单的办法就是,把召回文档里真正与query语义相关的句子高亮出来,只把高亮的句子发给LLM。
这样,不仅token数量能直接减少70-80%,LLM不再被噪音干扰,我们也能直观看到这个文档的重点;并且,在RAG状态不理想时,我们也能直接复盘是检索策略的问题,还是chunking策略的问题。
目前,市面上也已经出现了一些能够初步解决这些问题的模型,但它们要么只支持英文,要么上下文窗口太小(512 token),要么协议不友好(不允许商业使用)。
没有一个能同时满足:中英文都强、窗口够大、泛化能力好、协议友好。
所以,我们开源了内部最新的Semantic Highlight(语义高亮)模型。作为一款支持中英文双语处理的轻量级模型,它不仅能快速在生产环境完成部署,帮助用户更好的理解高亮核心内容,裁掉无关上下文,大幅降低RAG成本。
与此同时,由于Semantic Highlight 和 Context Pruning 上下文剪枝本质是同一技术的一体两面。因此,这款模型也能用于 Context Pruning 场景,在 Agent 应用中对上下文做精准裁剪,降低大模型的 token 成本。
目前模型权重已经开源,MIT协议,可以放心食用
HuggingFace链接:zilliz/semantic-highlight-bilingual-v1
具体效果如何,我们直接上数据。
在中英文数据集上的评测,我们的模型都达到了SOTA水平。
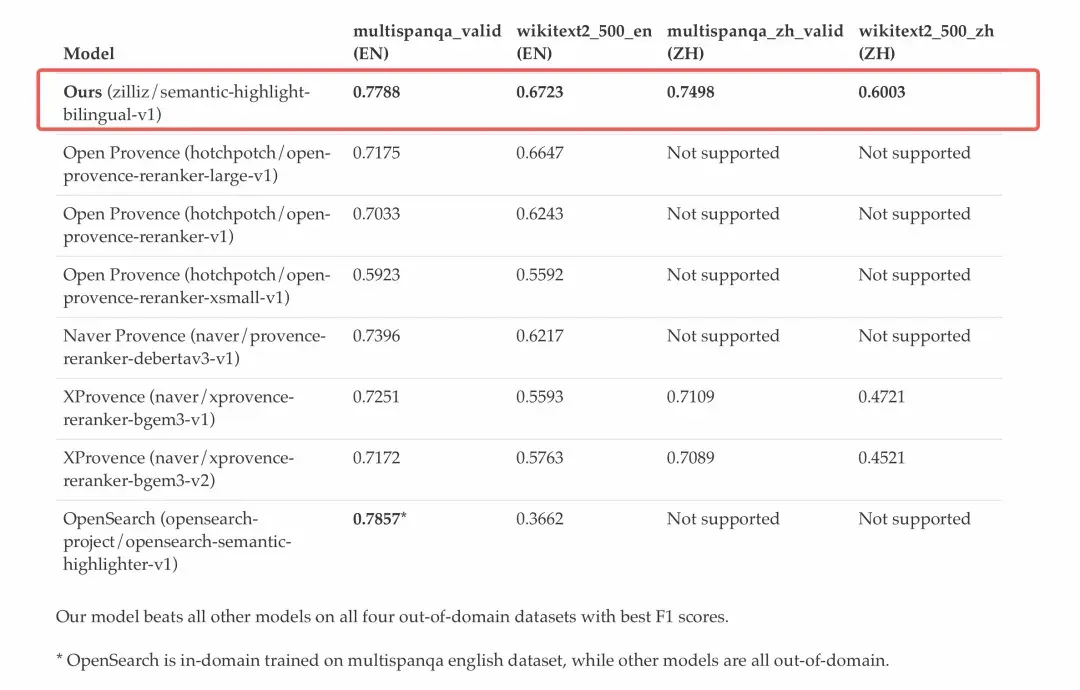
这是out-of-domain测试。也就是说,测试数据和训练数据的分布完全不同。模型在所有四个数据集上都是第一。
同时,这是唯一一个在中英文数据集上都表现优秀的模型。其他模型要么只支持英文,要么在中文上明显下降。比如XProvence系列,在中文wikitext2上只有0.45-0.47,我们是0.60。
02
Semantic Highlight工作原理
Semantic Highlight的推理过程其实很简单。
- 将输入拼接为 [BOS] + Query + Context
- 对上下文中的每个 token 打分(0 到 1 之间)
- 将每个句子内的 token 分数平均,得到句子分数
- 高亮高分句子,移除低分句子
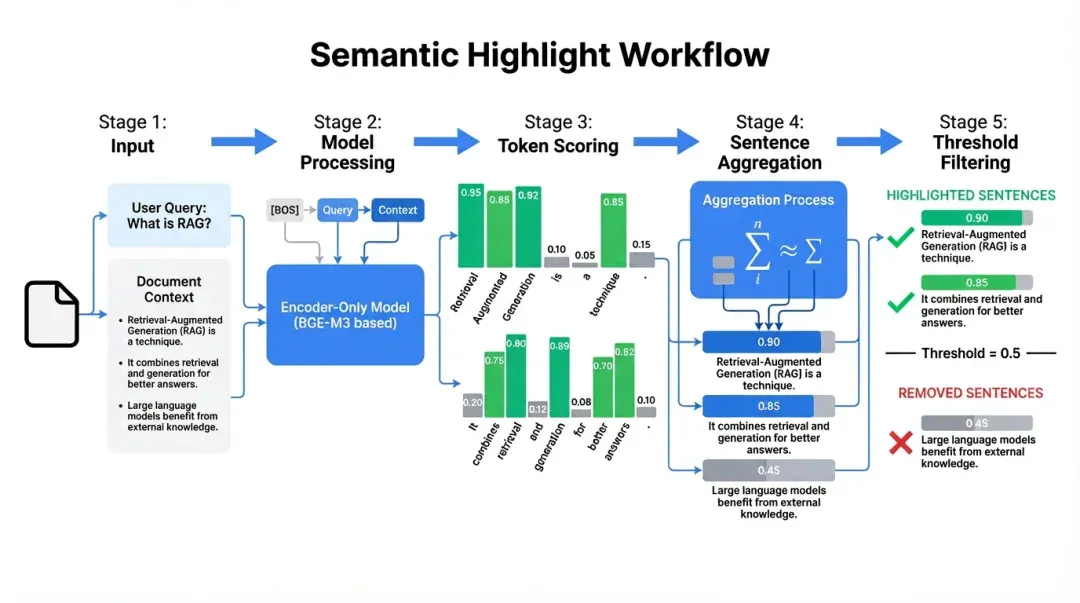
这套思路,借鉴了来自Provence的轻量Encoder-Only模型思路,把修剪上下文当成一个给每个token打分的任务来做。(Provence是一个专门做Context Pruning的模型,由Naver在ICLR 2025发表。)
Encoder-Only虽然是上古时代的架构,但它用0.6B上下的参数就能完成token打分任务,其速度和效率,比现在的LLM快得多。现在主流的大模型(Decoder-Only架构),通常是一个一个token地吐词,缓慢输出。而Encoder-Only是并行处理,一次性给所有位置打分。
而基于Encoder-Only的打分结果,我们再将每个句子的token得分聚合成句子得分,就可以得到每个句子的相关性分数,高于阈值的句子即为highlight句子。
具体的模型选择上,我们选择了BGE-M3 Reranker v2作为基础模型。因为它是Encoder架构,更适配token/句子打分;多语言方面,中英文都是重点优化语言。并且其上下文窗口能做到8192 tokens,适合RAG里更长的文档。0.6B的参数量,在保证效率的同时,也确保基础模型本身有足够好的世界知识。
而且BGE-M3 Reranker v2本身就是针对Reranking需求训练出来的,用于做token打分这种相似性任务时,迁移学习更省力。
03
训练数据准备
模型架构选好之后,我们需要思考的下一步是训练数据从哪里来?
我们参考了Open Provence里的数据构造和组织形式,并对其进行改进优化(Open Provence是Provence的开源复现项目)。Open Provence好的一点是,它的数据来自公开的问答数据集,然后使用了一个小的LLM,对句子相关度进行标注,并生成 silver label(银标签)。
但其不足在于,直接让LLM直接生成标注结果,输出结果会变得不稳定且难以后期优化;但传统人工标注,又会成本、时间双双失控。因此,我们让LLM在输出标签的时候,把推理过程也写出来。
也就是说,每条训练样本除了Query、Context、Sentence Spans等字段,还有一个很重要的字段:Think process(思考过程),从而让标注更准确,因为写推理过程相当于自检一遍,可以保证更低的错误率。
具体来说,让模型带上思考过程,会带来了三个更多的优势:可观测(模型为什么选这句的原因)、可调试(我们能快速知道标错的内容,是prompt问题还是知识问题)、可复用(后续即使换模型重标注,也有现成参考答案。)
标注流程如下:
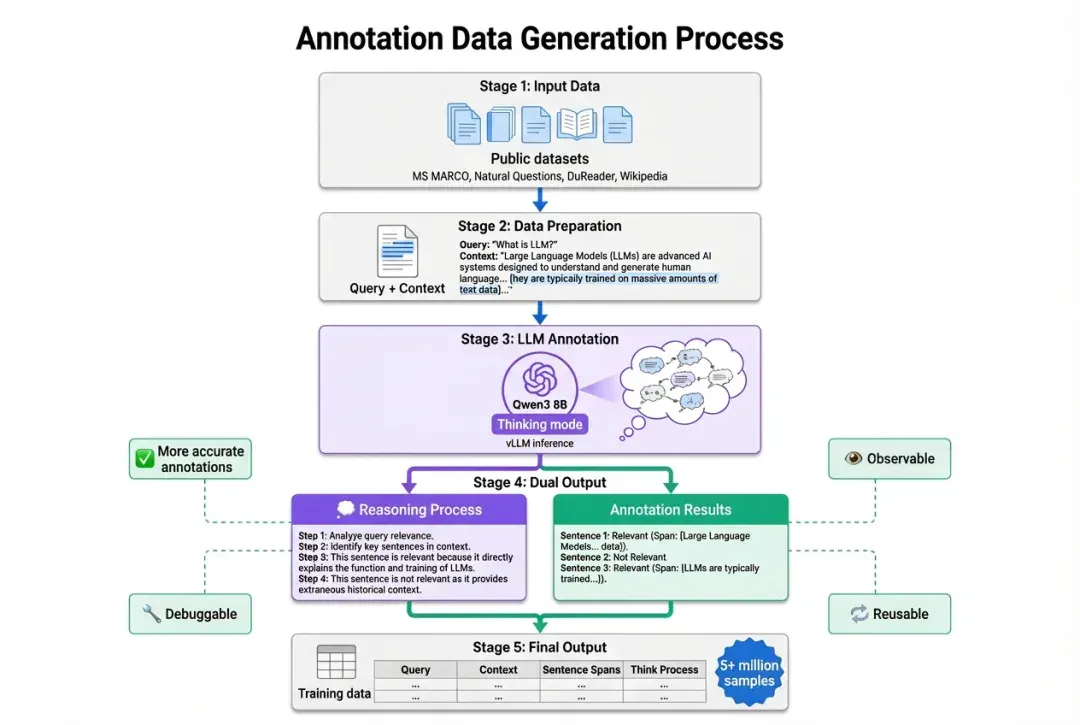
这里用于标注数据的模型,我们用的是本地部署的Qwen3 8B。它有天然的思考模式,可以用输出推理过程,成本也相对可控。
最终,我们构造了500万+双语训练样本,中英文各一半。英文数据来自MS MARCO、Natural Questions、GooAQ,中文数据来自DuReader、Wikipedia中文、mmarco_chinese。 其中,一部分数据是来自 Open Provence 等模型训练数据的重新标注,另一部分使用原始语料生成query和context,再进行标注。
全部标注好的训练数据也开源在HuggingFace上了,方便大家二次开发或参考训练。
https://huggingface.co/zilliz/datasets
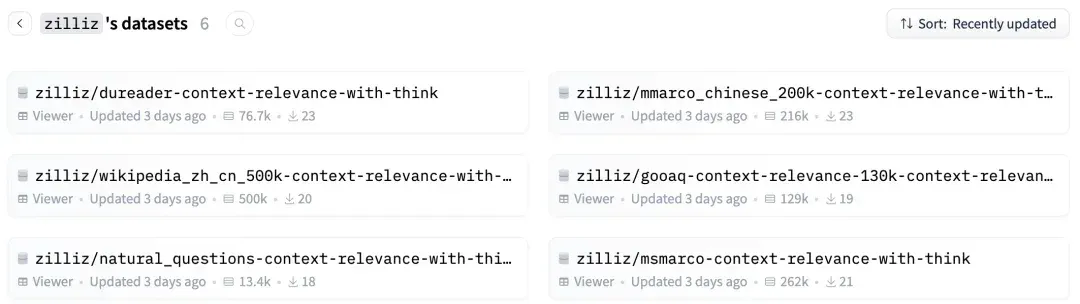
准备好了模型架构和数据集,接下来,我们在8张A100上训练了3个epoch,约9小时,Semantic Highlight终于成功出炉。
目前,Semantic Highlight模型已经开源,MIT协议,可以放心用在商业项目中,也欢迎大家基于这个模型的二次开发和改进,让开源的力量薪火相传。
另外,我们在Zilliz Cloud云服务上,也即将上线Semantic Highlight的在线推理服务,主打开箱即用。
04
致谢
Semantic Highlight模型的训练,离不开前人的工作。我们参考了Provence的理论基础。它提出了用轻量级Encoder模型做上下文修剪的思路,这个思路非常优雅。也使用了Open Provence的代码框架(开源协议),它把训练流程、数据管道、模型都实现好了,我们不用重复造轮子,只需要做少量的调整。
在这些基础上,我们加入了自己的创新:用带思考过程的LLM标注提升数据质量;创建了500万+双语训练样本,覆盖中英文场景,更符合实际业务需求;选择了更适合RAG场景的基础模型(BGE-M3 Reranker v2)。只训练Pruning Head,专注在Semantic Highlight任务上,没有训练Rerank Head。
在此,向Provence团队和Open Provence项目的贡献者们致以诚挚的感谢。
05
相关链接
- 模型下载:zilliz/semantic-highlight-bilingual-v1
- Open Provence 项目:hotchpotch/open_provence
- Provence 论文:arXiv:2501.16214
- Provence 官方介绍文章:Provence: efficient and robust context pruning for retrieval-augmented generation
- Milvus:milvus.io
- Zilliz Cloud:zilliz.com
作者介绍
张晨
Zilliz Algorithm Engineer
文章来自于“Zilliz”,作者 “张晨”。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
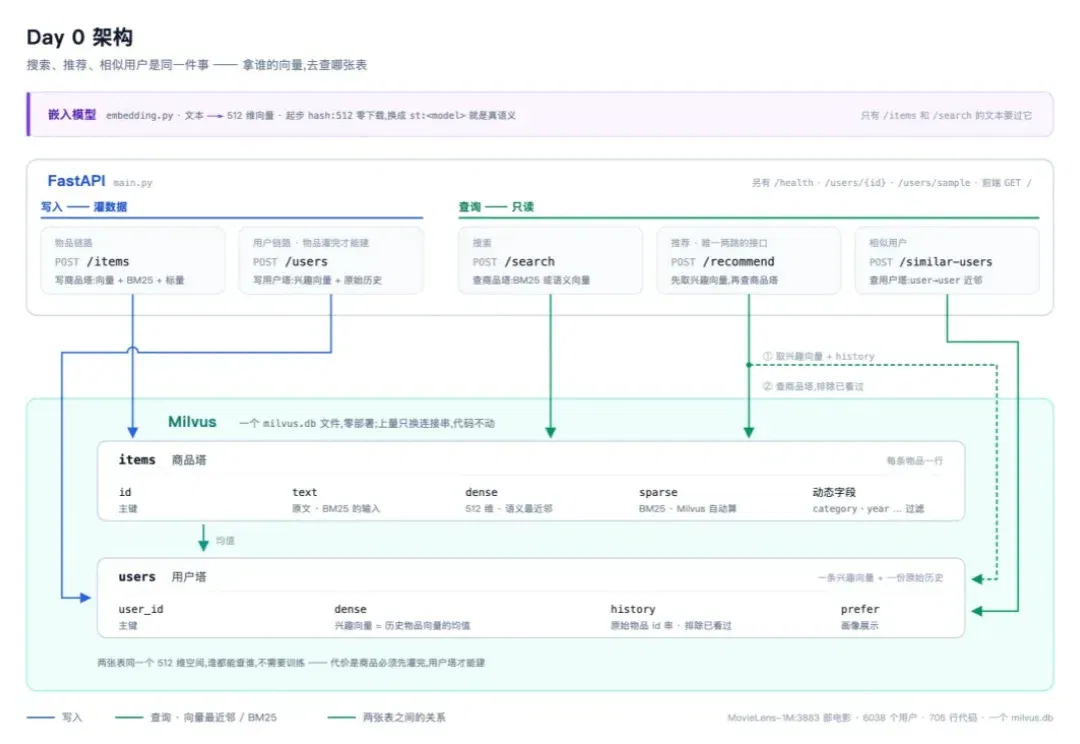
Claude Code and Milvus tutorial: local search, recommendations and vector retrieval (opens in a new tab)
A Zilliz author builds local search, recommendation and similar-user APIs with FastAPI, Milvus Lite and MovieLens data, first checking the flow with hash vectors before switching to embeddings. The examples validate a local prototype; quality needs separate evaluation.
Milvus 3.0 与 Elasticsearch 9.5 混合检索对比 (opens in a new tab)
Zilliz 作者在同机和相近资源配额下,用约 9.8 万条商品记录比较向量检索、BM25、融合、分组及聚合。结果适用于所用语料、索引和许可证配置,文章附复现实验。

长期知识库怎么维护?WeKnora 维护机制拆解与Milvus 接入实测 (opens in a new tab)
给一个需要长期维护的知识库做数据库选型,通常会碰到两类问题:内容持续更新以后,框架能不能方便修改和回退;数据量和负载上来以后,底层向量数据库能不能根据需求切换。
万字深度|做了8年向量数据库后,我们决定为Milvus重构AI时代的存储引擎 (opens in a new tab)
过去八九年,我们一直在做一件事:把向量数据库从一个很小众的系统方向,做成 AI 基础设施里的关键组件。
在线教育行业,如何用Milvus混合检索+微调embedding做题库检索与去重 (opens in a new tab)
在教育科技领域,题库是核心资产,更是连接学生、教师与知识体系的关键入口。