Anthropic被作家告了,违规下载700万本书,15亿美元和解了
最新消息,AI 初创公司 Anthropic 同意支付至少 15 亿美元,来和解一起作家集体诉讼案件。此前,这些作家联合指控 Anthropic 盗版了他们的作品来训练其聊天机器人 Claude。
最新消息,AI 初创公司 Anthropic 同意支付至少 15 亿美元,来和解一起作家集体诉讼案件。此前,这些作家联合指控 Anthropic 盗版了他们的作品来训练其聊天机器人 Claude。
在业界看来,如果该协议获得批准,那么这将是一起具有里程碑意义的和解协议,是美国版权案件历史上金额最高的赔偿,也将是 AI 公司与指控其侵犯版权的作家、视觉艺术家,以及其他相关创意专业人士之间法律纠纷的转折点。
据了解,15 亿美元和解金背后涉及的作品约为 50 万本书,平摊下来,每本书或每部作品预计获得 3000 美元的赔偿。另外,作为和解协议的一部分,Anthropic 也同意销毁其下载的原始文件及所有副本。
根据 6 月份的一份裁决显示,Anthropic 通过各种渠道,从 Library Genesis 和 Pirate Library Mirror 等盗版网站下载了超过 700 万本「明知是盗版」的电子版书籍。
所以,上个月的时候,美国作家协会预计每本书或每部作品的赔偿金至少为 750 美元,但现在是 3000 美元,大概率是在删除了重复作品和无版权作品后,受影响的书籍数量变少了。
从时间来看,这起诉讼案件持续一年之久了。去年 8 月,以安德里亚・巴茨 (Andrea Bartz)、查尔斯・格雷伯 (Charles Graeber) 和柯克・华莱士・约翰逊 (Kirk Wallace Johnson) 三位作家为代表的一群作家共同对 Anthropic 发起起诉,指控 Anthropic 盗版了他们作品来训练 Claude。
其实大模型技术一路发展以来,有关 AI 公司已经接到过很多类似侵权起诉,比如首当其冲的 OpenAI,而且随着相互之间的「博弈」,关于用何种数据来训练模型是可以的,探讨的空间也在一直变化。但这是 Anthropic 第一次接到诉讼。
后来 Anthropic 发现:用受版权保护的作品训练 AI,使聊天机器人能够自己创作文本段落,这在美国版权法下符合「合理使用」的条件,因为它「本质上具有变革性」。所以 Anthropic 也曾以此为理由进行辩解。
但没用,关键在于 Anthropic 用的不是「受版权保护的作品」,用的是盗版啊,Anthropic 理由根本站不住脚。
针对这次和解,美国作家协会首席执行官玛丽・拉森伯格认为这起到了一个积极作用,「对作家、出版商和版权所有者来说都是一个很好的结果,它向 AI 行业发出了一个强烈的信号:盗版作者的作品来训练他们的 AI 将会产生严重后果,而那些最无力承担版权的人将因此蒙受损失。」
但也有观点认为,这次和解的背后,似乎 Anthropic 并没有「因此蒙受损失」,相较于说这是作家的胜利,更像是科技公司的再一次胜利。
因为看似 15 亿美元是一笔不菲的金额,但平摊下来,每部作品获得的赔偿数目并不是很高。
更关键的是,这笔赔偿金额对 Anthropic 来说,不过「洒洒水」而已。要知道,就在前几天,Anthropic 刚刚完成新一轮高达 130 亿美元的融资,估值高达 1830 亿美元,今年 8 月的时候该公司的年度化营收就已超过 50 亿美元。
而对于 Anthropic 这次的和解行为,其实也符合科技行业的发展惯例,即先发展业务,然后因违反规则而支付与业务规模相比相对较小的罚款……
有意思的是,就在 Anthropic 同意花钱解决侵权问题的同时,也有两则起诉 AI 厂商侵权行为的消息传出。一个是苹果因使用书籍进行 AI 训练遭作者起诉,另一个是华纳兄弟起诉 Midjourney 侵犯超人、蝙蝠侠、神奇女侠、兔八哥、史酷比、飞天小女警、瑞克与莫蒂以及其他角色的 AI 图像。
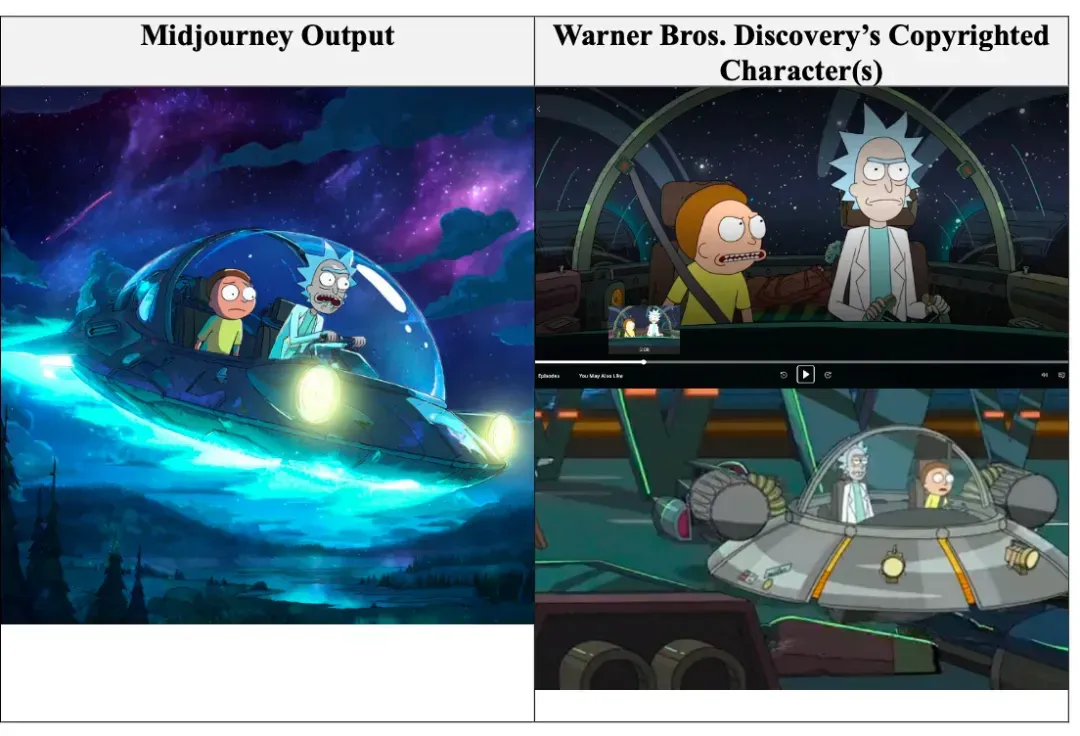
左图为 Midjourney 输出的瑞克与莫蒂图像,右图为原始影片截图,图源:Hollywood Reporter
而在今年 6 月,迪士尼和环球影业也曾联手起诉了 Midjourney。他们认为,这家 AI 公司是抄袭其电影和电视节目的「搭便车者」。
网友讨论
Anthropic 的这一做法,引起了广大网友的激烈讨论。
有人认为:Anthropic 并不承认有罪,只是达成了一项和解,该和解并未确立 AI 训练一定属于合理使用(fair use),也未确认扫描书籍就是合法的。这些核心法律问题,仍将留待其他案件去争论与裁决。
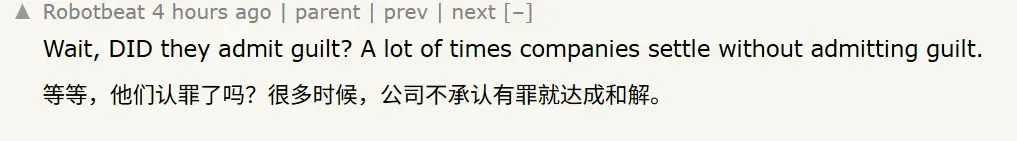

正是这种模糊不清的裁决,甚至有人认为这个案件对生成式人工智能公司来说是一个巨大的胜利。
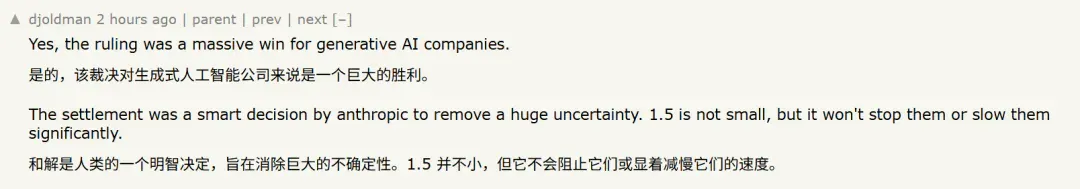
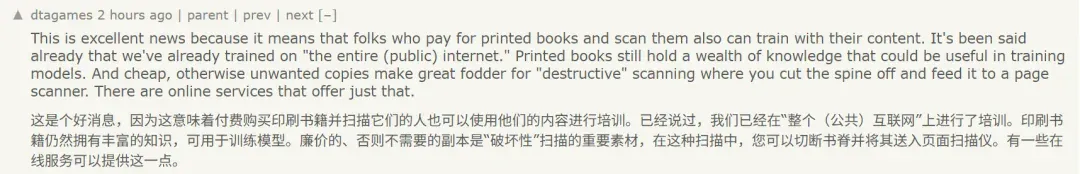
这意味着购买了纸质书的人可以自己扫描,并用这些内容来训练模型。人们常说,大模型已经在整个(公开的)互联网上完成了训练,但实际上,纸质书籍仍然蕴含着大量宝贵的知识。而且,那些价格低廉、甚至无人问津的二手书,可以进行破坏性扫描:把书脊切掉,然后放进自动送纸扫描仪逐页扫描。目前网上甚至有提供这种扫描服务的公司,专门帮助用户把纸质书转成电子版。
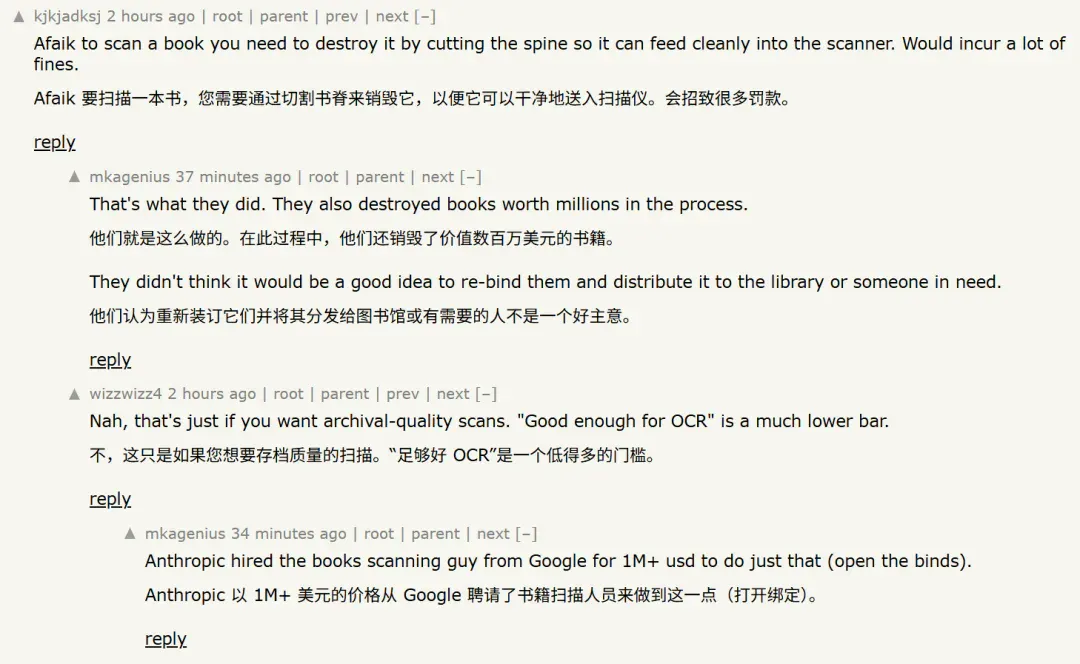
但有网友认为这种做法会对原书造成不可逆的破坏。切掉书脊后,一页一页的纸张会变成垃圾,造成巨大浪费,不幸的是,Anthropic 很可能采用了这种做法。
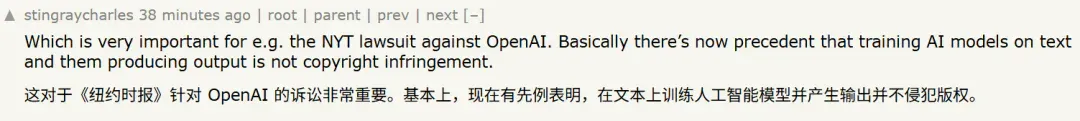
这不禁让人联想到《纽约时报》于 2023 年起诉 OpenAI 及其合作方微软,称其未经授权使用数百万篇文章训练 ChatGPT 和 Copilot 等大型语言模型。
如果参考 Anthropic 这个案例,基本上现在已有先例表明,用文本训练 AI 模型并使其产生输出并不构成版权侵权。
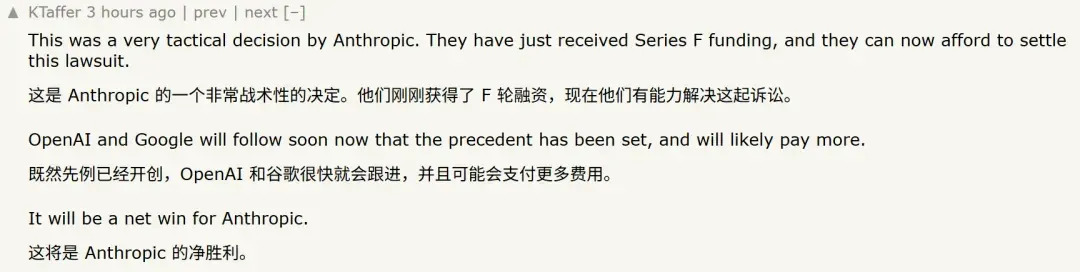
虽说 Anthropic 并未承认侵权,但依然选择支付巨额赔偿来了结纠纷。该公司刚刚完成 130 亿美元 F 轮融资,这也让他们具备了足够的财务能力来买单这起史上最大规模的版权和解案。接下来,外界的目光将转向 OpenAI、谷歌等其他巨头,在这之后,他们可能会支付更多的费用。
对此,你怎么看?AI 公司的这些操作算是「合理使用」吗?
参考链接:
https://news.ycombinator.com/item?id=45142885
https://www.bloomberg.com/news/articles/2025-09-05/anthropic-to-pay-1-5-billion-to-settle-author-copyright-claims
https://www.hollywoodreporter.com/business/business-news/warner-bros-discovery-sues-ai-company-copyright-infringement-1236361610/
文章来自于微信公众号“机器之心”,作者是“关注AI的”。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Claude 推出表格与白板工具,更新数据分析和应用连接 (opens in a new tab)
Anthropic 公布 Claude Sheets、Whiteboards 及 Data 更新,覆盖表格编辑、团队构思和数据解读。部分能力分批推出,连接器及账号条件各有不同。
PSI 报告用 AI 研究系统证明 Aaronson–Ambainis 猜想 (opens in a new tab)
Physical Superintelligence 称,内部研究系统使用未公开的 Anthropic 模型,在运行第三天得出经 Lean 检查的证明。结果涉及随机输入下量子查询加速的边界。
Claude 在美国测试个人财务功能,可只读连接银行账户 (opens in a new tab)
Anthropic 通过 Plaid 接入用户授权的账户,用 Claude 查询余额、分类支出和跟踪账单。功能逐步向美国 Pro、Max 和 Ultra 用户开放测试,权限为只读。
Mollick on agent collaboration: why improving 3D worlds turned into lengthy approvals (opens in a new tab)
Ethan Mollick describes repeated themes, expanding rules and subsequent adjustments in Fable 5.2 multi-team creation. He argues long-running execution still needs human judgment about work quality, purpose and when to stop.
Claude Meetings brings collaborative documents into calls, with efficiency and recordkeeping tradeoffs (opens in a new tab)
APPSO describes visible participation, live notes and whiteboard collaboration in Claude Meetings, examining how notifications, external guests, retention and AI summaries affect teamwork, privacy and the room for open-ended discussion.