Nano-Banana 核心团队首次揭秘,全球最火的 AI 生图工具是怎么打造的
在图像生成上,Google 其实已经有 Imagen 4 这样的文生图模型,为什么 nano banana 最后还是由 Google 带来的?但这确实不是偶然或者瞎猜的,nano banana 是结合了 Google 多个团队的项目成果。首先就是 Gemini 强大的世界知识与指令遵循能力,其次就是 Google 内部顶尖文生图模型 Imagen,所提供的极致图像美学与自然度追求。
Nano banana 的玩法还在持续更新,桌面手办、多元素拼图、以及生成连续性故事等。
这个带来「吉卜力时刻」的强大模型,再一次引发了全网的创作热潮,朋友圈都是各种各样的真人手办。
不过对生成效果感到惊喜的同时,记得要主动标注「图片内容由 AI 生成」,因为《人工智能生成内容标识办法》今天起开始实施。
在图像生成上,Google 其实已经有 Imagen 4 这样的文生图模型,为什么 nano banana 最后还是由 Google 带来的?
一开始在大模型竞技场上,以神秘代号 nano banana 出现的时候,就有人猜是 Google 的模型。
但这确实不是偶然或者瞎猜的,nano banana 是结合了 Google 多个团队的项目成果。首先就是 Gemini 强大的世界知识与指令遵循能力,其次就是 Google 内部顶尖文生图模型 Imagen,所提供的极致图像美学与自然度追求。
我们整理了 nano banana 核心团队的播客采访,一起来看看这根香蕉的现在过去和未来。
太长不看版:
1.Nano banana 迎来了图像生成和编辑功能的巨大质量飞跃。它的生成速度快,能理解模糊、口语化、以及需要世界知识的指令,并且在多轮编辑中保持角色和场景的一致性,效果更自然,摆脱了过去像P上去的感觉。
2. 在过去,图像和视频的评估非常困难,找到一个合适的指标非常重要。nano banana 团队发现通过提升文本渲染的效果,能同时提升生成图像的效果。因为当模型能生成有结构的文字时,也能更好的学习图像里的结构。
3. Nano banana 的提升,关键在于「原生多模态」能力,尤其是「交错式生成(Interleaved Generation)」。这让模型可以像人一样,分步骤处理复杂指令,并联系上下文进行创作,而不是一次性生成所有内容。
4. 如果你只需要高质量的「文本生成图像」,Imagen 模型依然是首选;而如果你需要进行多轮编辑、创意探索等更复杂的多模态工作流,nano banana 是更合适的创意伙伴。
5. 未来 nano banana 的目标不仅是提升视觉质量,更是追求「聪明」和「事实准确性」。团队希望打造一个能理解用户深层意图、甚至能给出超越用户提示词,更好、更具创意的聪明模型 ,并能准确生成图表等工作内容。
下面是播客正文,编译略有调整。
大家好,欢迎回到《Release Notes》。我是 Logan Kilpatrick,来自 Google DeepMind 团队。今天和我一起的是 Kaushik、Robert、Nicole 和 Mustafa。他们正是负责我们 Gemini 原生图像生成模型的研究与产品的同事。我对今天的分享超级兴奋。那么 Nicole,要不要先带个头?发布的好消息是什么?
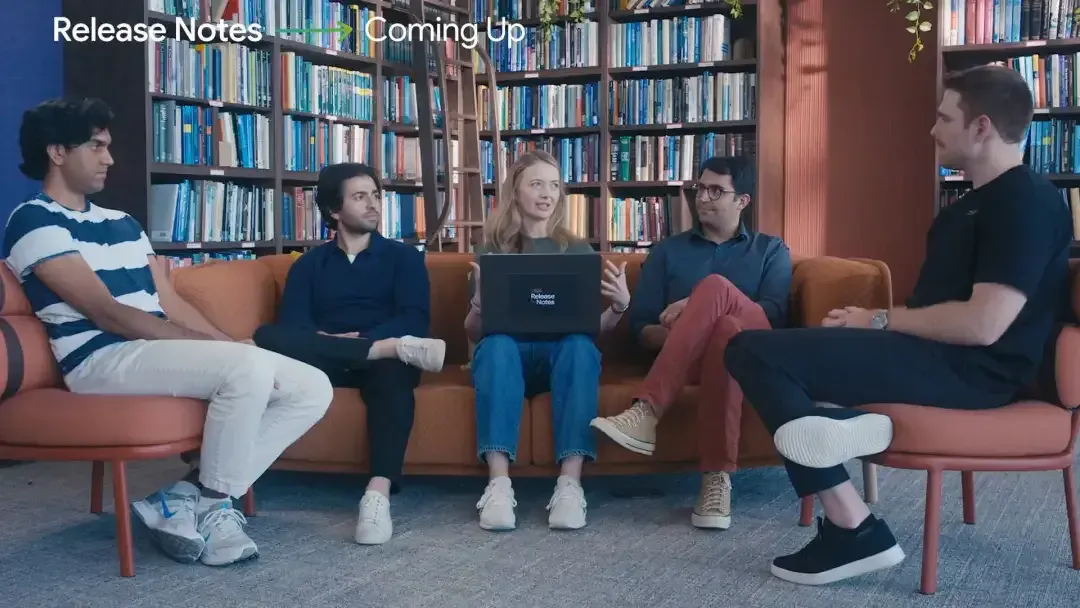
从左到右依次为:Kaushik Shivakumar,Robert Riachi,Nicole Brichtova,Mostafa Dehghani,和 Logan Kilpatrick
Nicole:是的,我们正在为 Gemini 以及 2.5 Flash 发布图像生成和编辑功能的更新。这是一次巨大的质量飞跃,模型已经达到业界领先水平。我们对生成和编辑的能力都非常激动。不如我直接给你们展示一下模型的效果吧,因为这才是最直观的方式。
Logan:我太期待了!我之前玩过一次,但没有你们玩得多,所以很想看看更多示例。
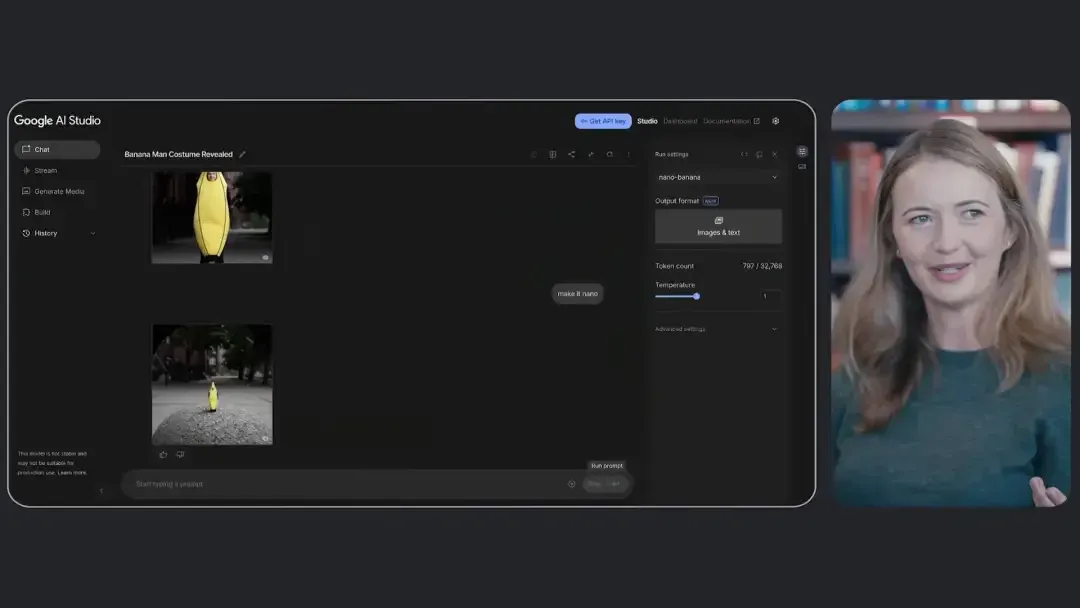
Nicole:好,我来给你拍一张照片吧。我们先从一个简单的例子开始:比如「拉远镜头,给他穿上一套巨大的香蕉服装,但保持脸部清晰,因为要保证看起来还是你」。生成需要几秒钟,但还是很快的,你们记得上一次发布的模型就已经很快了。
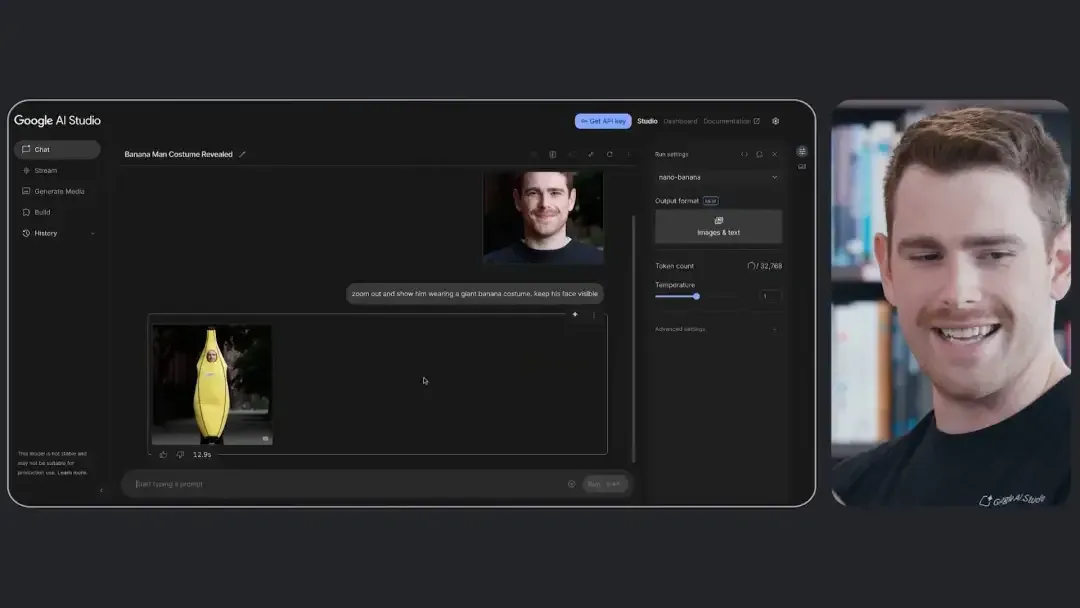
Logan:这是我最喜欢的功能之一。我觉得这种编辑的速度让模型非常有趣。能把图放大点吗?全屏看看?
Nicole:点一下就好了,这就是 Logan,还是你的脸。而令人惊叹的是,模型能保持这是你本人,但又让你穿上了巨大的服装,还生成了一个你在城市中行走的背景。
Logan:太有意思了!这背景是芝加哥,和那条街真的很像。
Nicole:是的,这就是模型的世界知识在发挥作用。那我们继续吧,试试「make it nano」。
Logan:让它变 nano 是什么意思?
Nicole:我们最初在测试时给它起了代号叫 Nano Banana,后来大家猜测这是我们的新模型更新。然后你看,现在它会把你变成一个可爱的迷你版角色,穿着香蕉服。
Logan:哈哈,我太喜欢了。
Nicole:这就是最酷的地方,你刚才的提示其实很模糊,但模型足够有创造力来解释它,并生成一个既符合提示又在上下文里合理的场景。
这非常令人兴奋,因为这是我们第一次看到模型能在多次编辑中保持场景一致,同时用户还能用非常自然的语言与模型互动,而不需要写一大串复杂的 prompt。这让人觉得像在和模型对话一样,超级有趣。
Logan:我太喜欢了。那么它在文本渲染方面表现如何?这是我最关心的用例之一。
Nicole:要不要我来演示一下?你给我个提示。
Logan:那就「Gemini Nano」吧,这是我唯一能想到的 nano 相关词。我最常用的场景就是做带文字的海报或公告。
Nicole:这是一个很简单的文本,字数少,词也简单,所以效果很好。我们确实在文本渲染上还有一些不足,在发布说明里也提到过,我们团队正在努力改进,下一个模型会做得更好。
文本渲染,是反映模型表现的有效信号
Logan:我很喜欢。还有其他例子或者和这次发布相关的指标故事吗?我知道在评估上很难,比如很多是基于人工偏好的。你们是怎么考虑这件事的?
Robert:确实,在多模态模型里,比如图像和视频,评估非常困难。过去我们主要依赖人工偏好打分。但图像很主观,所以要收集大量人群的信号,而且过程很慢。我们也在努力寻找新的指标。其中文本渲染就是一个很有趣的例子。
Kaushik 早就一直强调它的重要性,虽然我们之前觉得他有点执着,但后来发现它其实非常有价值。当模型学会生成有结构的文字时,它也能更好地学习图像中的结构,比如频率、纹理等等。这给我们提供了很好的信号。
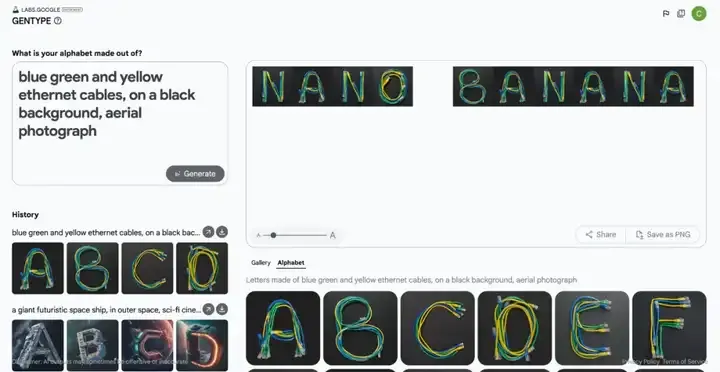
Kaushik:是的,我觉得最初是从找出这些模型有哪些不足开始的。要想提升一个模型,首先需要明确哪些地方表现不好,也就是找到一个「信号」来指出问题。然后我们会尝试各种方法,不管是模型架构、数据,还是其他方面的改进。一旦我们掌握了这个清晰的信号,就确实能够在对应的问题上取得不错的进展。
回头看几年前,当时几乎没有哪个模型能在处理像 Gemini Nano 这种短提示上表现得还算不错。我们花了很多时间深入研究这个指标,并且始终对它进行跟踪。
现在无论我们进行什么实验,只要持续跟踪这个指标,就能确保不会在这方面出现退步。而正是因为我们把这个指标作为参考信号,有时甚至能发现一些原本没预料到会有影响的改动,结果实际上确实产生了积极作用。这样我们就可以持续优化这个指标,并不断提升模型表现。
是的,就像 Robert 说的,这是在缺乏其他不会很快饱和的图像质量评估指标时,用来衡量整体图像质量的一个很好的方式。
我一开始其实对用人工评估图像生成结果这种方法还有些怀疑,但随着时间推移,我慢慢认识到:只要有足够多的人去评估足够多的提示词,并涵盖不同的类别,确实是能得到很有价值的信号的。
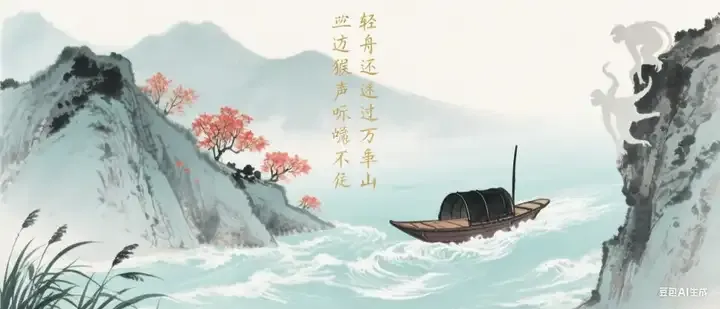
文字可以反映图片生成的效果,提示词是生成「两岸猿声啼不住,轻舟已过万重山」的海报
但显然,这种方法的成本很高,不可能一直让很多人去打分。所以,在模型训练过程中,像文本渲染这样的指标就显得特别有价值了。它可以很好地反映出模型的表现是否符合预期,是一种很有效的信号。
图像理解和图像生成,像姐妹一样密切相关
Logan:这点真的很有意思。我很好奇模型自身的图像生成能力和图像理解能力之间是如何相互作用的。我们之前和 Ani 做过一期节目,他所在的团队显然在这方面投入了很多,比如 Gemini 在图像理解方面已经达到了业界最先进的水平。
那是不是可以这样来理解:当模型在图像理解上变得更强时,其中一部分能力其实是可以迁移到图像生成上来的?反过来也一样,图像生成的进步也可能反过来提升图像理解能力。这样的思维方式是否合理?
Mostafa:是的,基本上我们的目标就是希望最终能够实现原生的图像理解、原生的多模态理解与生成能力,也就是说在同一个训练过程中,让模型同时学会处理不同模态的任务,并在这些不同的能力之间产生「正迁移」。
而这不仅仅是图像理解和图像生成之间的互相促进,也不仅限于单一模态的生成能力。更进一步,我们希望模型能够从图像、视频、音频中学到的知识,反过来对文本理解或文本生成产生帮助。
所以可以说,图像理解和图像生成就像是「姐妹」一样密切相关。在我们现在看到的一些应用中,比如交错式生成(interleaved generation),这两者确实是相辅相成、同步发展的。
但我们追求的终极目标远不止于此。举个例子来说:在语言中存在一种现象,叫做「叙述偏差」(reporting biases)。
什么意思呢?比如你去朋友家做客,回来后你在聊天中通常不会特意提起他家那张「很普通的沙发」,但如果你把那个房间的照片给别人看,那张沙发就在那里,你不说,它也已经存在于图像中。
所以如果我们想要全面地了解这个世界,其实图像和视频中包含了大量我们没有明确提问却依然能获取的信息。
也就是说,光靠文本当然可以学到很多东西,但可能需要大量的语言数据(token)才能学到。而视觉信号则是了解世界的一种「捷径」,能更高效地传递某些类型的信息。
回到图像理解和生成这个话题,就像我前面说的,这两者是密切相关、相辅相成的。特别是在交错式生成(interleaved generation)中,我们可以清楚地看到,理解对生成有很大的促进作用,反过来生成也能帮助理解。
举个例子,就像你在解决一个问题时,会在白板上画图,这个「画图」的过程本身就是一种生成行为,它反过来又能帮助你更好地理解问题。
同样地,如果我们面对的是一个以图像形式呈现的问题,也许通过生成一些相关的内容,我们就能更深入地理解它。
所以我们也可以尝试一些交错式生成的方式,不只是图像和图像之间的生成,也包括与文本结合,让理解与生成真正做到相辅相成、同步进步。
Nicole:让我把这个主题转换成一个 1980 年代美国风格的魅力购物中心的场景,用五种不同的方式来呈现。好了,希望一切顺利。
看起来效果还不错。这确实需要花费一些时间,毕竟我们不仅要生成多张图像,同时还需要生成描述这些图像内容的文本。
图片来源:X@egeberkina
Kaushik:你会注意到,所谓「原生图像生成」模型的一个特点是,它是一张接一张地生成图像的。也就是说,模型可能会参考前一张图像,然后选择要么生成一张风格完全不同的图,要么在已有图像的基础上做一些细微的调整。
关键在于,模型在生成过程中拥有上下文信息,它知道前面已经生成了什么内容。这就是我们所说的「原生图像生成模型」的含义,它们具备对多模态上下文的访问能力,能够在图像和文本之间进行协调与理解。
Logan:我原本的理解一直是,比如说,也许听起来没什么道理,但我一直以为那就是进行 4 次独立的前向传播之类的东西。但实际上它是一次性全部完成的。
Robert:这一切都在模型的上下文中。
Nicole:而有趣的是,它的风格其实也有点类似,对吧?模型还会做一件很奇怪的事,就是在每一个有趣的地方都会把「你」重复两次。
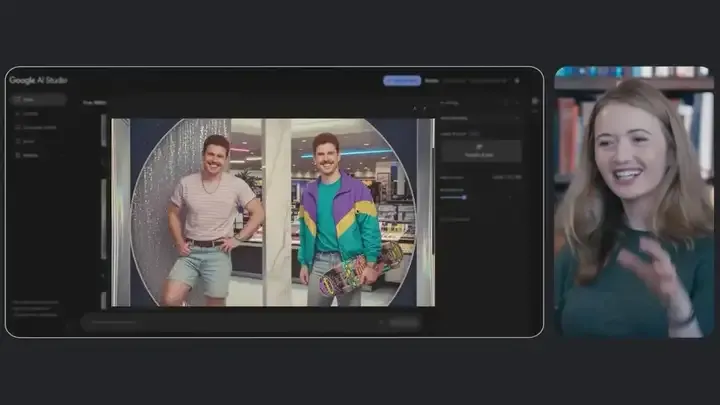
我要做一些类似的东西。比如这个是 Arcade Kitting 的 logo,很不错。往下滚动看,这也太酷了。你看,这些图片配的描述其实都不是我们想出来的,我们的提示词只是类似于:「你是80年代美国的魅力写真风格的购物中心青年,你应该考虑这些穿搭。」
比如第四个选项是:「放松点,哥们。」你看,每一张图你穿的都不一样,但看上去又都是你本人。
画面中出现两次「你」可能是模型的小失误,但更棒的是,它能创造出五种完全不同的风格,还能给每种风格起名字、搭配不同的服装,同时又能保持角色的一致性。
这不仅适用于角色设定,如果你有自己房间的照片,你也可以说:「帮我用五种不同风格来装饰这个房间。」模型可以从非常有创意的方案一路给到相对保守、略作改进的风格。我们团队里很多人就用它来重新设计自己的花园和家居,看起来真的非常酷。
这就是我们正在做的一种非常实用的应用方式。
Nano-banana 生成一张图片的速度,只需要 13s
Logan:我当时在 AI Studio 给我女朋友用代码做了一个小应用,让她可以用不同颜色的窗帘来可视化她的办公室。她当时的烦恼是:「我不知道哪种窗帘颜色最适合这个氛围。」这个应用最开始是用 2.0 版本模型做的,后来我又用 2.5 重新测试了一下,尝试了各种不同的风格,效果真的很好,非常有帮助。
不过,在 2.0 上有时候会出现一些问题,比如它不只是换窗帘,还会把床换掉,或者改动其他东西。所以这其实是一个很有意思的使用场景,也是我最喜欢的应用之一。我觉得很值得用新模型再测试一遍。
Nicole:你可以试试看,其实模型在保持画面其他部分不变方面已经做得相当不错了。我们称这种方式为「像素级精确编辑(pixel perfect editing)」。
这一点非常重要,因为有时候你只想改动图像中的某一个元素,但希望其他部分都保持不变。比如在做角色设定时,你可能只想让角色转个头,但希望他们穿的衣服在不同场景中都完全一致。
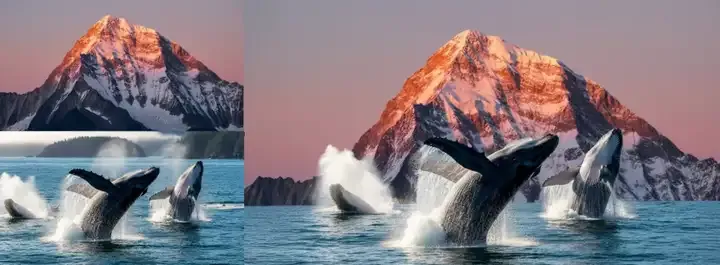
图片来源:X@GoogleDeepMind
模型在这方面表现很好,虽然不一定每次都百分之百完美,但它的进步已经让我们非常惊喜和兴奋了。
Robert:我还想说,有一件特别酷的事就是,它的速度真的很快,每个图像是13秒。
即使在 2.0 出来的时候,我就已经在用它做类似的事情了。比如我有一个书架,地上堆了很多东西,我就让它帮我设计一下,这些物品应该怎么摆在书架上更合适。
当然啦,我女朋友可能不太同意模型给出的设计方案,所以我们有时候会想再多尝试几个版本。这时候模型的快速响应就特别关键了,你可以很快重新生成,不断迭代。就算它一开始没做好,你只需要稍微改一下提示词,再运行一次,很快就能得到一个更满意的结果。
我觉得这种「快速迭代式创作」的过程,其实才是它真正的魔力所在。
相比 2.0 的模型,2.5 最大的进步是交错生成
Logan:有没有人试用过 2.0 的一些体验差异?比如我自己在用 2.0 的时候,有一个明显的例子就是:我更倾向于一次只做一个小修改。如果你一下子让它改六个不同的地方,模型有时候就处理得不太好,效果不理想。
那现在的问题是:在这个新模型里,我们是不是还是应该采用这种「逐个修改、精准调整」的方式?或者说,在使用过程中有没有什么其他需要注意的地方,是大家在上手这个模型时应该了解的?
Mostafa:这是我特别想提的一点。
Interleaved Generation(交错生成)的一大「魔法」就是它为图像生成带来了一个全新的范式。比如说,如果你的提示词非常复杂,要做 6 个不同的修改,那如果是 50 个修改呢?
现在,模型已经具备了一个非常强大的机制,可以从上下文中精准提取信息(像素级的准确),并在接下来的步骤中继续使用这些信息。
这意味着你可以让模型把复杂的提示词,无论是编辑任务还是图像生成任务,拆解成多个步骤,然后逐步完成每一个修改。例如,在第一步中完成前几个修改,下一步再处理接下来的五个,以此类推。
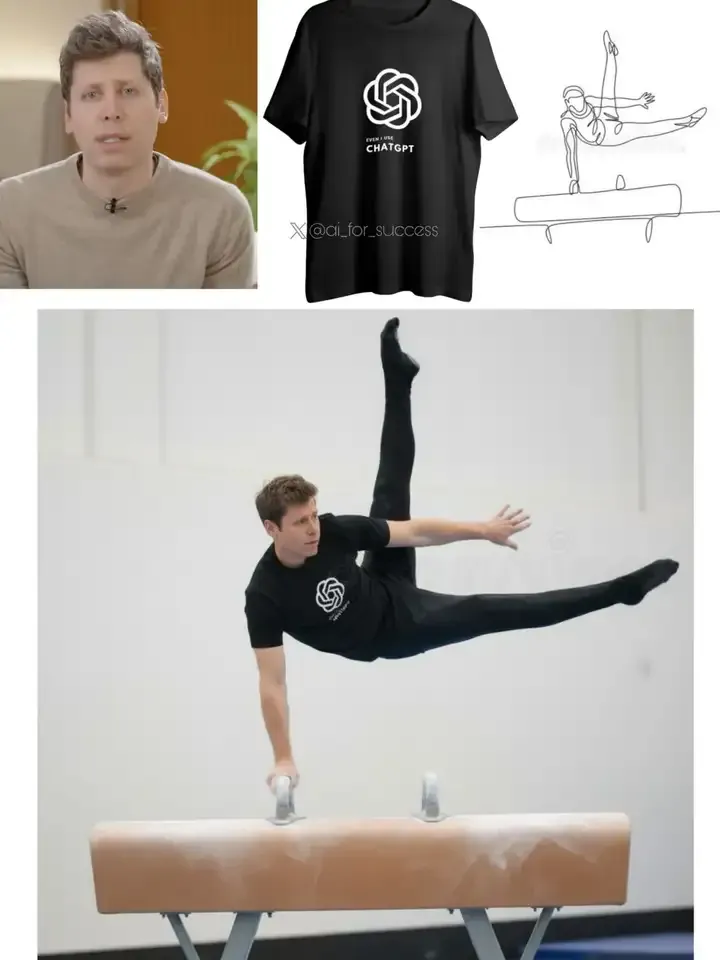
图片来源:X@ai_for_success
这种方式其实就很像我们在语言模型中做的「逐步推理」测试(test-time compute),你用更多的计算资源(flops),让模型在像素空间里进行思考,并将任务拆解成小步骤,每一步都能做得更细致、更精准。而通过逐步积累这些结果,最终我们可以完成任何复杂度的任务。
这也正是 Interleaved Generation 的神奇之处:它让我们可以用「增量生成」的方式,逐步构建出非常复杂的图像,而不是像传统方法那样,一次性逼迫模型生成最完美的结果。毕竟模型的能力是有上限的,当你想塞进去上百个细节时,一步到位是很难做到的。
但有了 Interleaved Generation,通过拆解成多个步骤,就可以轻松应对任何复杂度的图像生成任务。
Imagen 定位是文本生成,nano-banana 是一个多模态的创意伙伴
Logan:有一件事我总是会想到,特别是因为你不仅是我们 nano banana 的产品经理,也是了解所有模型的人。那么人们应该如何看待这件事呢?特别是那些开发者,或者说那些对各种模型都有了解的人,他们该如何看待 Imagen 模型和我们这种原生能力之间的关系?
Nicole:是的,你知道这一点,但我们的目标一直都是用 Gemini 构建一个统一的模型,对吧?最终,我们的目标是将所有模态整合进 Gemini,这样我们就能从 Mostafa 提到的知识迁移中受益,并最终朝着通用人工智能(AGI)迈进。
当然,在这个过程中,拥有一些专门化的模型仍然是非常有价值的,因为它们在某一特定任务上表现得极其优秀。
Imagen 就是一个非常出色的文本生成图像的模型。我们还有许多不同版本的图像模型,它们也可以进行图像编辑,比如 Blend、Vertex 等,它们都是针对特定任务进行过优化的。
所以说,如果你只是想从文本生成图像,并且希望快速生成一张高质量的图像,同时在成本和响应速度上都非常高效,那么 Imagen 就是你的首选。
但如果你想要的是一种更复杂的工作流程,比如你不仅要生成图像,还想在同一个工作流程中对图像进行多轮编辑,或者进行一些创意发散的探索,比如你问模型:「你能帮我设计一些关于我房间或者图书馆的创意想法吗?」那 Gemini 就是更合适的选择。
Gemini 更像是一个多模态的创意伙伴,它可以输出图像,也可以输出文本。你在给它下指令时不需要那么精确,因为它有对「世界」的理解能力,会更有创造性地去完成你的指令。一开始我们说「让它生成一个纳米机器人(nano)」,它就能理解背后的含义并做出富有创意的生成。
当然,Imagen 仍然是开发者可以选择的一个非常优秀的模型家族,如果你只想要一个为某项任务做过极致优化的模型,它就是非常好的选择。
Logan:是啊,我今天在试一个例子,我很好奇你怎么看,也想听听你对哪种模型更适合这个场景的看法,或者说,原生图像生成模型(native image generation)是否能解决这个问题。
我当时的例子是这样的:我说「生成一张图片,我需要一个广告牌,把这个广告牌做成我提到的某个公司的风格」。
这是一个原生图像生成模型可能更擅长处理的事情吗?因为它在「世界知识」这块可能更强一些,而 Imagen 虽然在你给出一个好的提示词时表现非常出色,但在理解我提示词的意图方面,可能就没那么擅长。
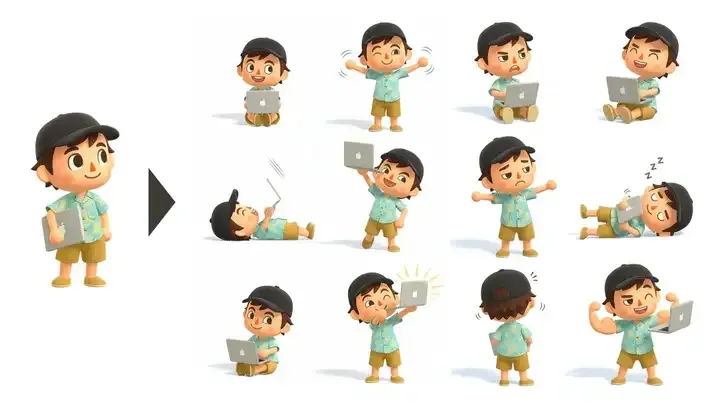
图片来源:X@ken_tbdz
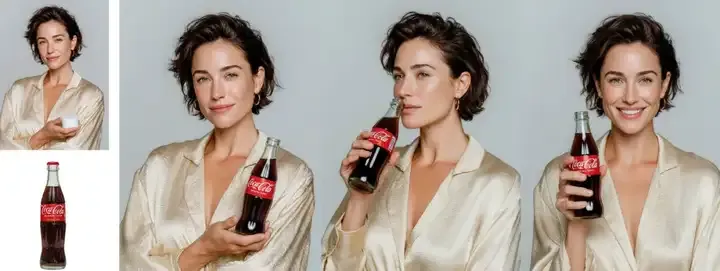
Nicole:是的,我觉得这是一部分原因。另一部分是,在原生图像生成方面,如果你只是想抓取那个你试图模仿的其他公司的风格参考,你也可以把那张图片插入到模型中作为参考,对吧?
所以你可以输入图像作为参考,这能帮助你更好地生成提示,而在 Gemini 中原生地实现这一点比在 Imagen 里更容易。所以你应该试试看,也让我们知道效果如何。
用户反馈会用来构成我们的基准数据集
Logan:回到这个关于 2.0 进展的讨论。有一件非常有趣的事情是,当那个模型发布的时候,很多人在 AI Studio 里给我们发来了大量关于使用体验的反馈,最后也有在 Gemini 应用里的反馈,比如模型的一些常见失败模式等等。
而我在最初发布时唯一的贡献,就是在 Tag Studio 里加上了那个热词标签(hot tag)。我们现在实际上打算在这个新模型中重新启用热词标签,并且会在旧模型中移除它。
我们能不能聊聊这个故事,比如说我们从 2.0 到现在的进展,以及我们从 2.0 那里收到大量反馈的一些失败模式,那些当时做得不够好的东西,现在在 2.5 中能不能表现得更好?
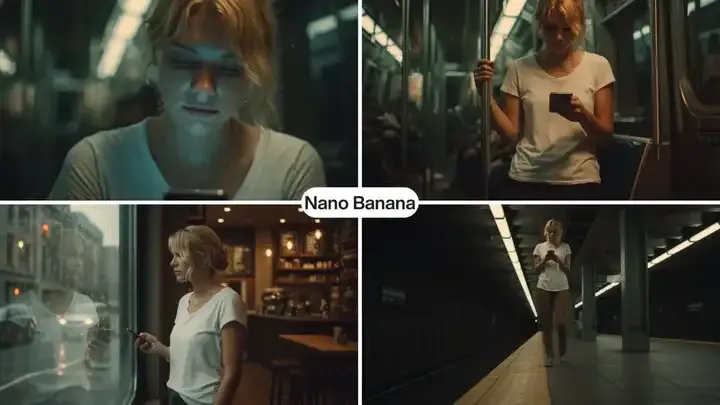
图片来源:X@jerrod_lew
Robert:是的,我们真的就是在 X 上,翻看了大量的用户反馈。我记得特别清楚,像 Kaushik 和其他一些团队成员,会把所有失败案例收集起来,并基于这些做评估。
我们其实有一个基准数据集,就是来自 X 上真实用户反馈的,人们会 @ 我们,说:「嘿,这个不行啊。」然后对于我们未来每一个模型的迭代,我们都会在这个集合上持续追加,这样我们就能知道,比如说,在发布 2.0.1 的时候,一些常见的失败模式是啥。
比如有时候用户对图像进行编辑,模型虽然会添加这个修改,但结果可能和图像的其他部分不协调,这就是当时我们记录下来的问题之一。我们一直都在不断收集这些反馈。
Logan:是啊,欢迎把那些效果不好的例子发给我们。你们有没有特别印象深刻的一些情况,是以前完全不行、但现在已经完全搞定的?我不知道你们有没有在用这个模型时遇到什么能说明它进步明显的例子。
我觉得你们团队在整个开发过程中应该是大量在用这个模型的,对吧?所以我也好奇,你们有没有那种固定会拿来测试的使用场景,用来判断说:「这个模型到底好不好?」
Kaushik:是的,我觉得我在使用 2.5 模型时特别注意到的一点是,在 2.0 模型里,我们原本以为比较难处理的问题是图像与图像之间的一致性,尤其是在你创建一个物体或一个角色时,希望这个角色在多张图中保持一致。
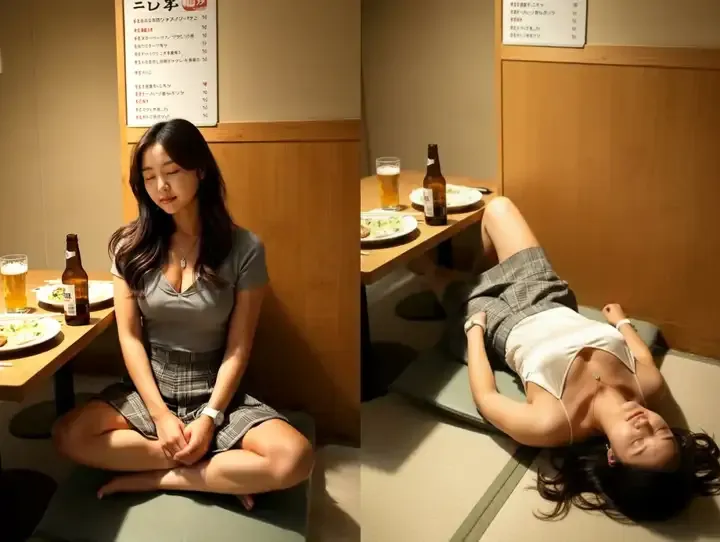
图片来源:X@agi_aibusi
但实际上,如果你在输入图像中把这个角色放在同一个位置,那么这个问题其实很好处理。2.0 模型在这方面表现其实就挺不错的。比如,它可以很好地给角色加一顶帽子、改变表情之类的,同时还能保持角色的姿势和整个场景的结构一致。
而 2.5 模型在 2.0 能力的基础上更进一步,比如你现在可以要求从不同的角度渲染这个角色,它看起来仍然是同一个角色,比如从侧面来看。或者你可以把一个画面中的物体拿出来,放进一个完全不同的场景中,调整它的朝向,重建一个完整的新场景。
而那个家具或物体,不仅保留了你上传图像中的特征,而且还可以做很大的变化,它不是简单地把原图像中的像素「贴」到新图里,而是进行了真实的重构与融合。
是 Imagen 团队,提升了 nano-banana 的自然美观能力
Logan:我很喜欢你刚才提到的那个点。我对 2.0 的一些图像有个反应是,有时候它生成的图会让人感觉,就像你往脸上加个搞笑的胡子或者帽子那样,效果看起来有点像是「叠加上去的」,或者说,看起来像是被 Photoshop 贴上去的一样。
这个问题是不是也跟角色一致性有点类似?虽然可能只是相关性不太大的相似问题,但感觉背后机制是差不多的,像是从模型记忆里拿出某些像素、然后硬贴进图里,而不是做真实的像素迁移那种方式。我好奇,这方面的能力是不是也有提升?
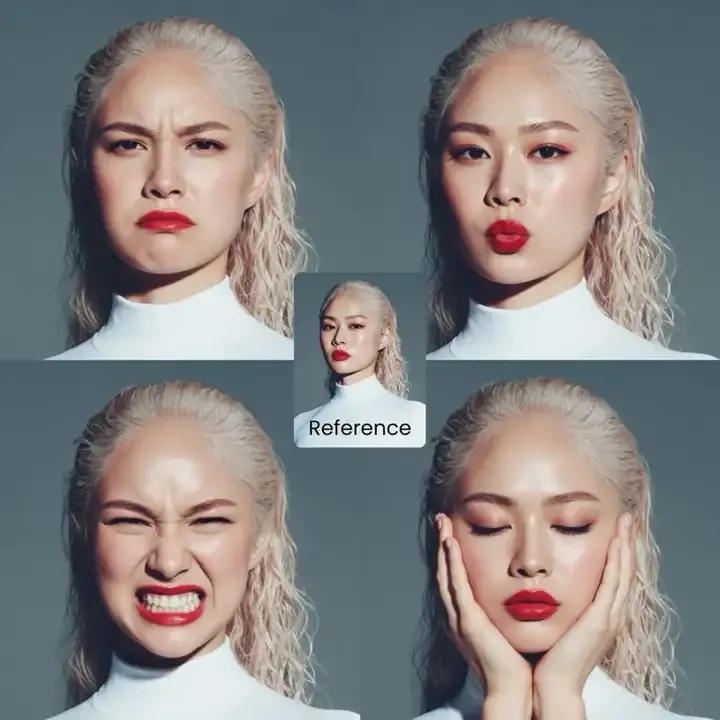
图片来源:X@HalimAlrasihi
Kaushik:是的,其实我觉得这很大程度上归功于真正负责这个模型的团队。在之前的模型中,我们的想法有点像是:好,它完成了编辑,那就算成功了。
但当我们后来开始跟 Imagen 团队更紧密地合作时,他们会看我们在 Gemini 这边也在看的同一个编辑结果,然后直接说:「这太糟了,怎么会希望模型生成出这种东西?」
这其实就是一个很好的例子,说明把两个团队的视角结合起来能带来什么效果。Gemini 这边更偏向于指令执行、世界知识这些能力;而 Imagen 那边更关注图像是否自然、美观,是否真的有用。
所以我觉得,正是这两种能力的融合,加上两个团队的协作,才让 2.5 在你提到的这类问题上有了明显的提升。
Nicole:是的,顺着这个话题,其实我们团队里有一些成员主要就是来自 Imagen 团队的,他们对美学有着非常敏锐和成熟的审美判断。所以很多时候我们在做评估的时候,他们会直接看成百上千张图像,然后就能说出,「这个模型比那个模型更好。」
而团队里的其他人可能会看着同样的图,说,「嗯,好像差不多?」就是说,这种美学感知是需要几年时间去打磨的。我自己这些年也进步了不少,但我们团队里确实有一些人这方面特别厉害,每次我们在模型之间做选择的时候,都会去请教他们的意见。
Logan:你可以用个人数据来训练自动评价器(auto raters)吗?
Nicole:我们目前还没有在 Gemini 实现这个功能,不过作为一个有趣的副项目,我对此非常兴奋。随着 Gemini 的不断进步,未来我们有可能打造一个具备审美判断力的评价器(aesthetic rater)。基于我们团队里某位在这方面非常厉害的同事的风格。
未来的 nano-banana 是一个更聪明、更准确的全能模型
Logan:我太喜欢这个了,2.5 版本确实有了很多进展,而且我觉得大家肯定会非常兴奋地去体验这个模型以及它的各种功能。
那么接下来会怎样呢?我们现在已经做出了一个很棒的模型,我相信我们还有很多东西正在筹备中。但我不确定我们现在能透露多少关于未来的发展方向,以及有哪些新的能力有望在之后实现。
Mostafa:在图像生成方面,我们当然很在意视觉质量,但我觉得还有一点同样重要,甚至更重要的,就是智能。就像我们一直在追求的那种统一的 Omni 模型一样,你会希望你的图像生成模型看起来很聪明。
我们希望用户在使用这个模型时,不只是觉得图像质量很棒,还会觉得:「哇,这个模型真的很聪明。」我脑海中有一个例子,也是我很期待看到能实现的效果,虽然这有点有争议,因为我甚至都很难准确地定义它。
那就是,当我给模型下一个指令,它并没有完全照做,但最后生成出来的结果却让我觉得:「我很高兴它没有听我的。」也就是说,它生成的东西比我描述的还要好。它有一种锐气或创造性,超出了我的预期。
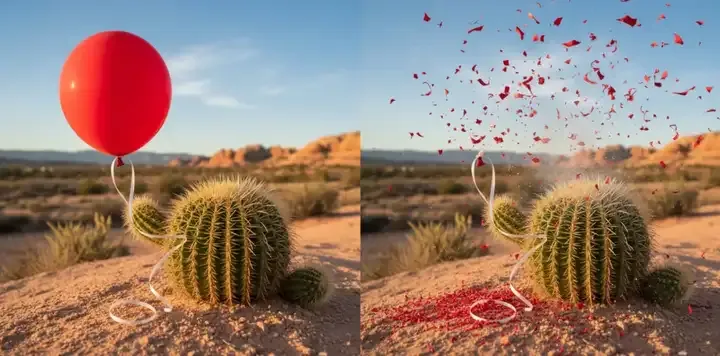
图片来源:X@GoogleDeepMind
Logan:你是觉得模型是有意这么做的吗?还是说,它只是无意间碰巧做出了更好的结果?你想表达的是哪一种?
Mostafa:不是那个意思,我的意思是,有时候我们的指令本身就定义得不够清晰,或者我们对现实的某些理解其实是不准确的,而 Gemini 拥有的知识可能和我们视角之外的世界更加一致。
所以我觉得这不是模型有意为之,而是它自然地做对了,你会有一种感觉,就是你在和一个比你还聪明的系统互动。
比如我请求它生成一些图像时,我并不介意它偏离了我的提示,生成了和我要求不同的内容,因为大多数时候,那结果比我最初想象的还要好。
所以我觉得,从更高层面上说,智能绝对是我们正在努力推进的方向,当然也要保持甚至提升图像的视觉质量。
同时,其实还有很多具体的能力、用例,尤其是关于数据保真(data-loss)方面的,这次的版本已经有一些改进了,但下一次的发布也会非常值得期待。
我们确实已经有一些版本在做了,虽然我现在还不能透露时间线,但真的让人非常兴奋。可以说,我感到非常激动和开心,尤其是在图像生成这块的进展,几乎是无可匹敌的。
Logan:我太喜欢这个了!还有没有其他让大家感到兴奋的能力或功能?
Nicole:我对事实准确性特别期待,这也呼应了之前提到的一个点。比如说你有时候需要为工作做一个小的图表或信息图,对吧?它看起来漂亮当然很棒,但光有视觉效果是不够的。
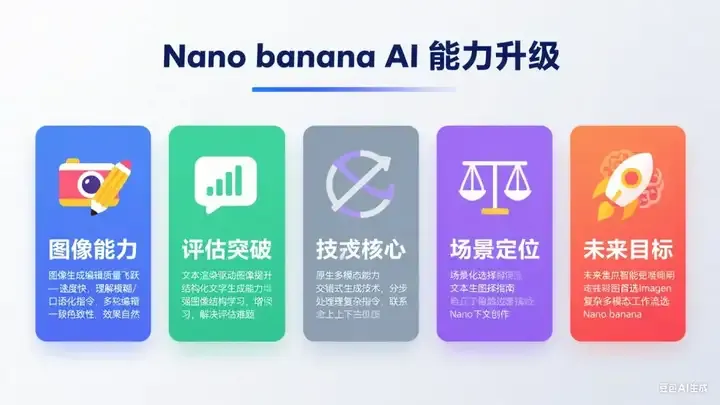
要求豆包生成本文的总结卡片图,有些文字还是不能正确呈现
对于这种使用场景来说,图像还必须准确,不能有任何多余的文字,必须既好看,又真正能用、能服务于这个目的。我觉得我们现在还只是刚刚开始挖掘这些模型在这方面的潜力。
我对接下来的一些版本更新感到非常期待,尤其是我们在这类使用场景上会变得更擅长。我的梦想是,有一天这些模型可以真正帮我完成一个看起来很棒、内容也准确的工作用演示文稿幻灯片。
Logan:这是每个产品经理的梦想。
Nicole:是的,这就是每个产品经理的梦想啊。我就是想把工作中那部分内容外包给 Gemini 来做。而且我觉得我们在这方面真的发挥了很大的作用。
Logan:太棒了,我太喜欢了。我相信大家肯定会非常兴奋地去尝试这些新模型。非常感谢你们四位,也感谢整个团队让这一切成为可能。我真的非常感激你们付出的所有努力,对这次发布感到特别兴奋。
🔗 播客视频链接:
https://x.com/OfficialLoganK/status/1960725463694753930/video/1
文章来自微信公众号 “ APPSO ”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.

ConvexLLM connects speech to language models through frozen text embeddings (opens in a new tab)
Researchers at CUHK-Shenzhen and Microsoft propose C-Gate, mapping audio into convex combinations of frozen text embeddings. The paper reports VoiceBench gains against its listed open-model baselines, while audio understanding and transcription still involve trade-offs.

CWM2.0 open-sources generative rendering with a 30-minute racing demo (opens in a new tab)
Teams from Ant, Westlake University and Zhejiang University use a structured Proxy to control scene state and Invoker-Render to generate visuals, releasing eight-GPU streaming inference. The long demo and 140 evaluations cover specified scenes, not arbitrary stable worlds.

Ankole outlines multi-user agent architecture: events, permissions and organizational memory (opens in a new tab)
The team describes its Business Harness design for fast and slow paths, shared state, Actor orchestration and dynamic permissions. Formal verification covers the modeled core permission state machine; it does not replace security checks of the full deployment, external interfaces or implementation.

openJiuwen presents a Harnessless approach for reusing AgentOS execution tools (opens in a new tab)
openJiuwen uses app-development and swarm demos to show how built-in harness capabilities support sessions, tools and app management. Applications still define business rules and permissions; remote deployment and some capabilities remain planned or exploratory.

Ask-to-Distill optimizes training questions using teacher–student distribution signals (opens in a new tab)
UIUC and collaborators propose A2D, training a question generator with frozen teacher–student disagreement and compatibility signals before on-policy distillation. The paper reports gains in math, code and agent tasks; its learning-value proxy has limits.