
Know AI. See What’s Next.




Slide 1 of 5: 姜宇辉的AI分身:知识助手与“另一个自己”之间
Latest news
奥特曼谈下一代 GPT:万级 Agent 数学实验与开放安排 (opens in a new tab)
奥特曼在 ADIPEC 回顾约1万个 Agent 参与的数学研究,并预告下一代 GPT。文章同时梳理研究人员设题、调配资源、整合结果与形式化验证的流程;具体型号、发布时间,以及公众能否调用同等协作系统,尚未公布。
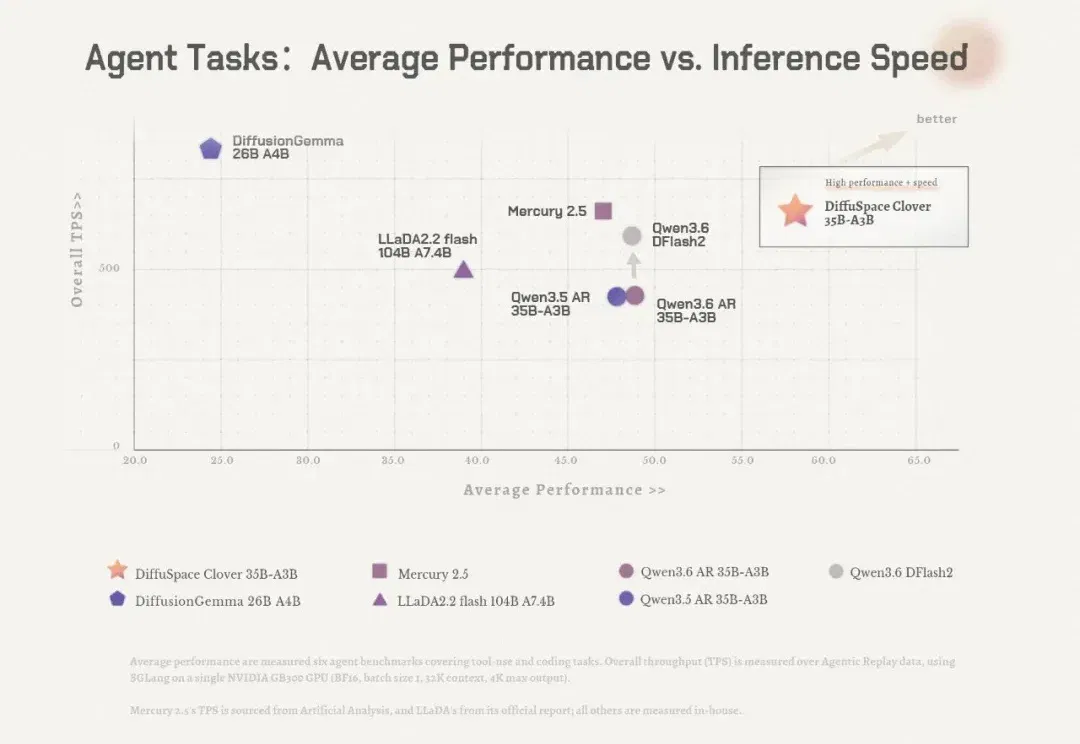
DiffuSpace 发布开源扩散语言模型 Clover-35B-A3B-Preview (opens in a new tab)
Clover-35B-A3B-Preview 以块内并行去噪和历史状态复用提高生成效率。团队报告编程、工具使用及端侧量化结果,并介绍双向交互与联合决策探索。单用户生成速度与整机吞吐不同,性能比较受硬件、精度、框架和任务设置影响。
作者分享 DeepSeek Harness 电子宠物实践:聊天接入与直播尝试 (opens in a new tab)
卡兹克记录用 DeepSeek Harness 配置电子宠物的过程,涉及QQ机器人、微信与飞书接入、人设和记忆,以及视频、直播尝试。文章区分官方与非官方接入方式,也提到账号风控、隐私和操作确认;这些是作者的实践教程,非本站代配置服务。
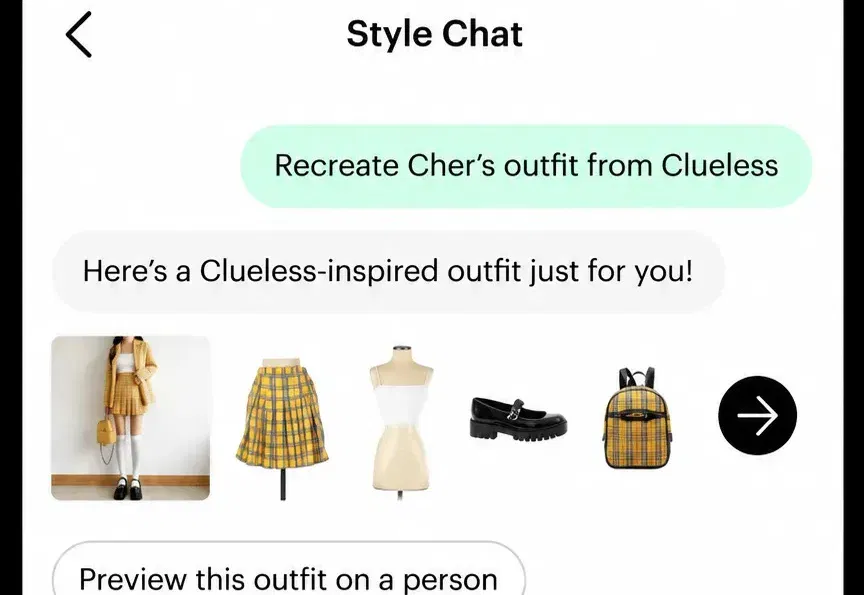
ThredUp 如何用 AI 处理二手服装:识别、定价与商品发现 (opens in a new tab)
文章以 ThredUp 为例,梳理机器学习定价、图像搜索与对话式搭配如何处理大量非标准服装,并讨论AI购物入口和代理下单的边界。所引79.5%毛利率来自2025年第二季度,不能直接当作当前净利润率,或与不同收入确认口径的零售商简单比较。
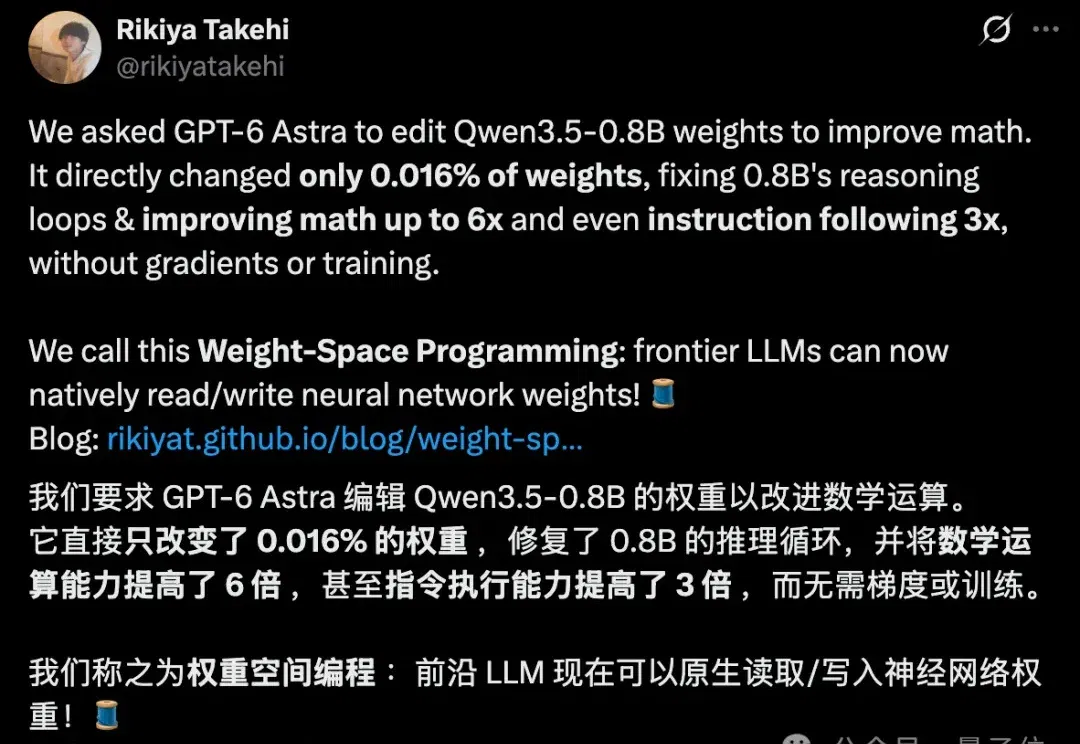
MIT 团队探索权重空间编程:用前沿模型诊断并修改小模型 (opens in a new tab)
研究者让 GPT-6 Astra 分析神经网络权重并生成修改方案。在Qwen3.5-0.8B的特定采样设置下,50次前向调用预算的方案使MATH-500得分从7.9%升至48.1%。实验省去了目标模型的梯度更新,仍需要诊断、推理和评测计算。
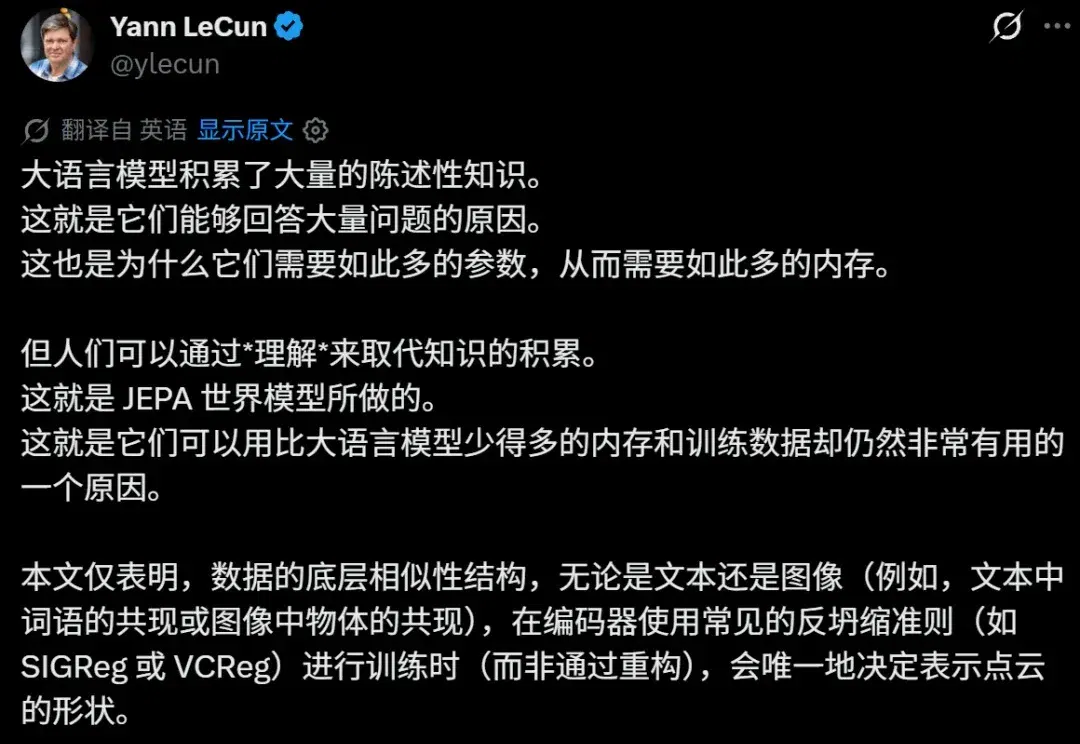
LeCun 团队研究 JEPA:训练视图如何影响跨模态对齐效率 (opens in a new tab)
论文在理想化条件下推导 JEPA 表征对齐的充分条件,并比较不同训练视图。特定评测中,109M文本模型的对齐分数超过72B基线,同规模样本效率也有改善;这些结果不意味着模型规模从未有效,或小模型已全面超过大模型。
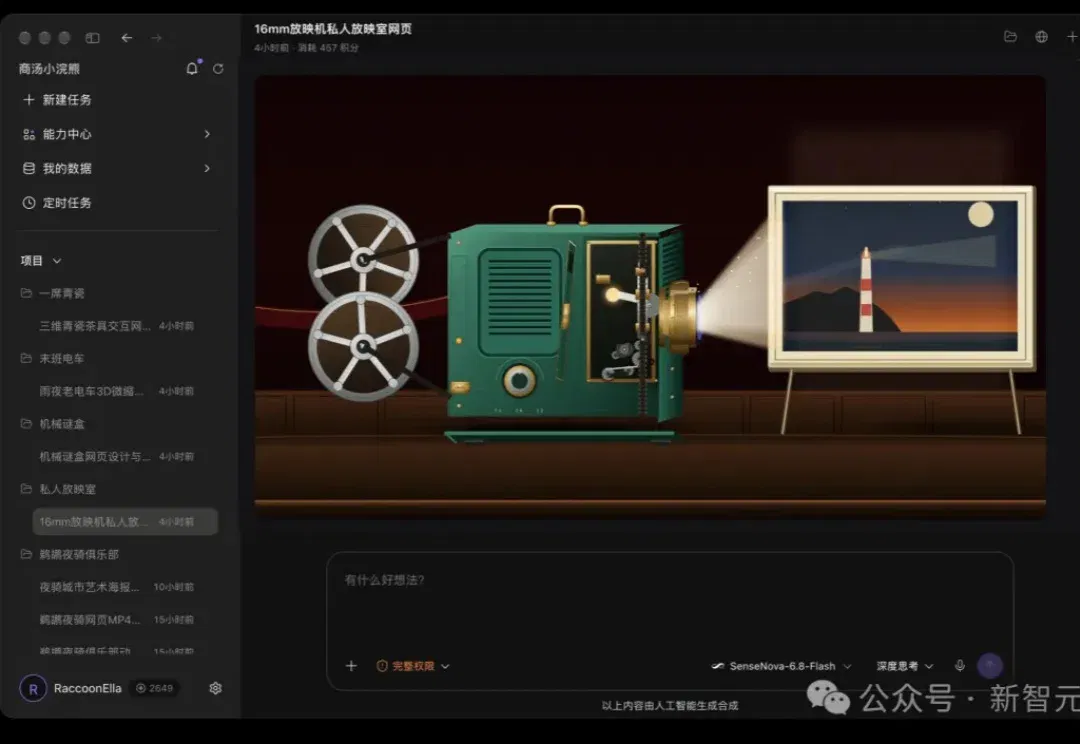
商汤发布 SenseNova 6.8 Flash 正式版,接入小浣熊与 Token Plan (opens in a new tab)
SenseNova 6.8 Flash 正式版接入商汤小浣熊与 Token Plan。原作者围绕SVG动画、3D场景、数据交互等案例体验其交付表现,也指出细节和穿模问题;主动关联邮件与历史任务的演示采用内部研发版,不能直接当作所有正式用户已可用的功能。
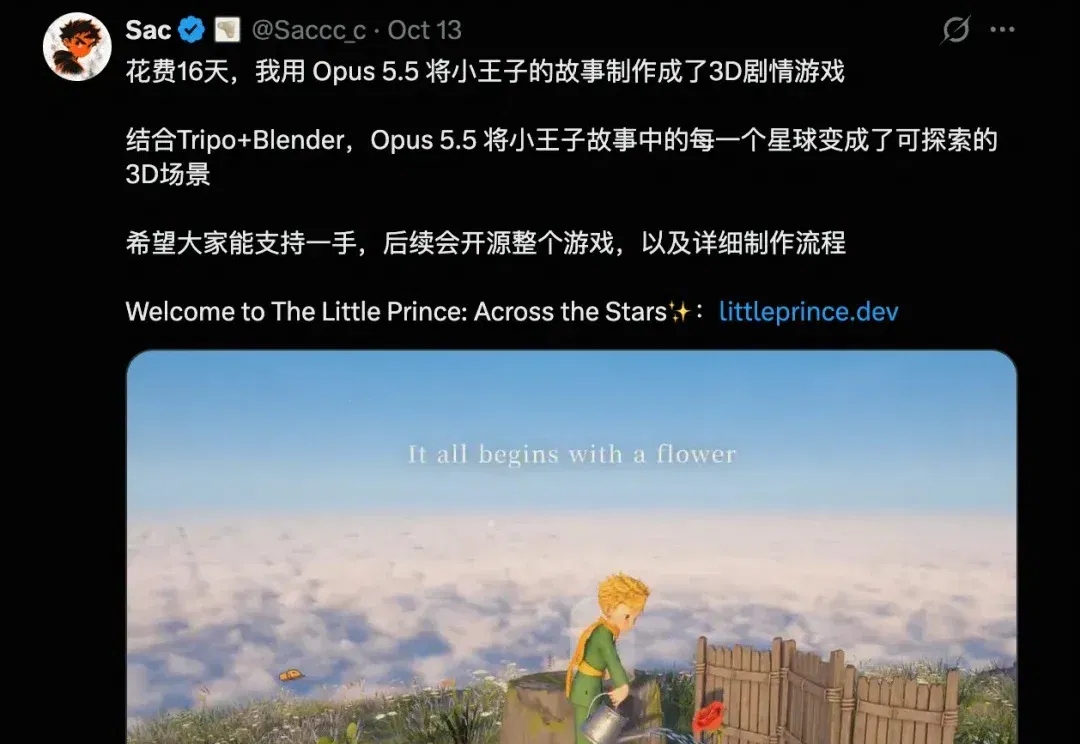
VAST 谈3D生成、智能体与世界模型研究,并启动新一期人才计划 (opens in a new tab)
围绕 Tripo 原生网格生成与 Project Eden,VAST 研究人员分享从探索到产品的经历,讨论可编辑拓扑、显式世界状态和实时渲染的分工。文章也介绍 V·STAR 人才计划的研究方向与招募安排,相关产品性能和团队体验来自公司及受访者口径。
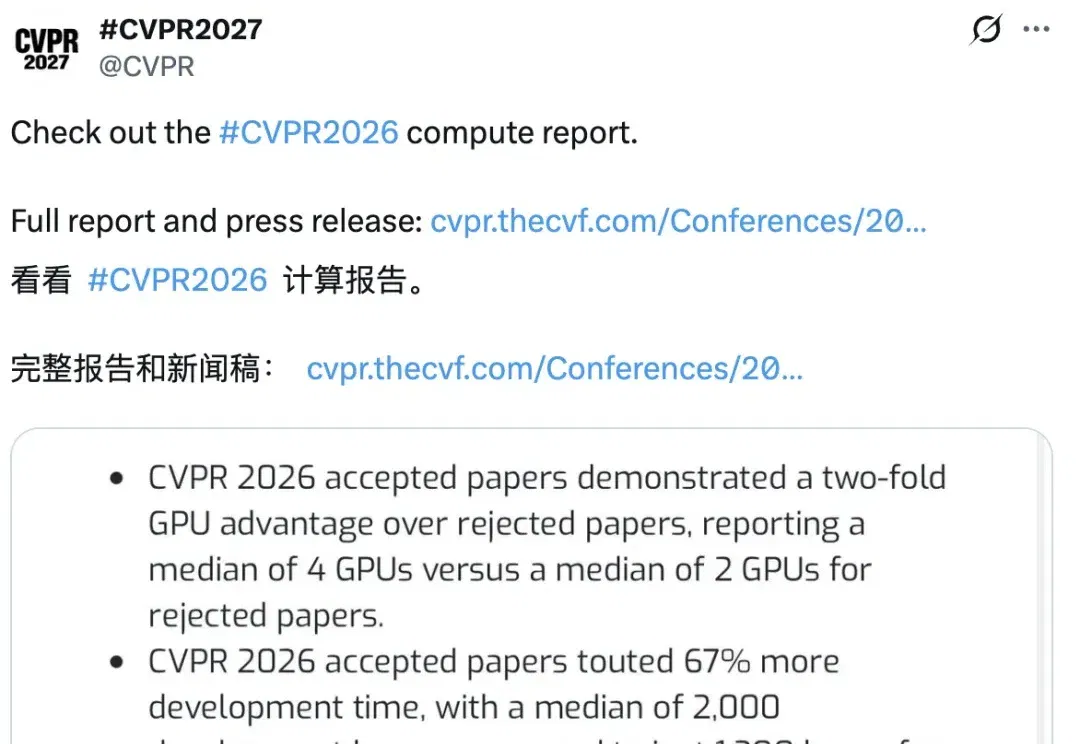
CVPR 2026 公布算力报告:录取论文与拒稿论文的资源差异 (opens in a new tab)
CVPR 2026 汇总16034份投稿算力表,录取与拒稿组的GPU数量中位数分别为4张和2张,研发计算投入也有差异。统计反映相关性,算力数据不向审稿人提供;报告同时展示低算力创新与效率奖励,不能据此推导录取所需的最低卡数。
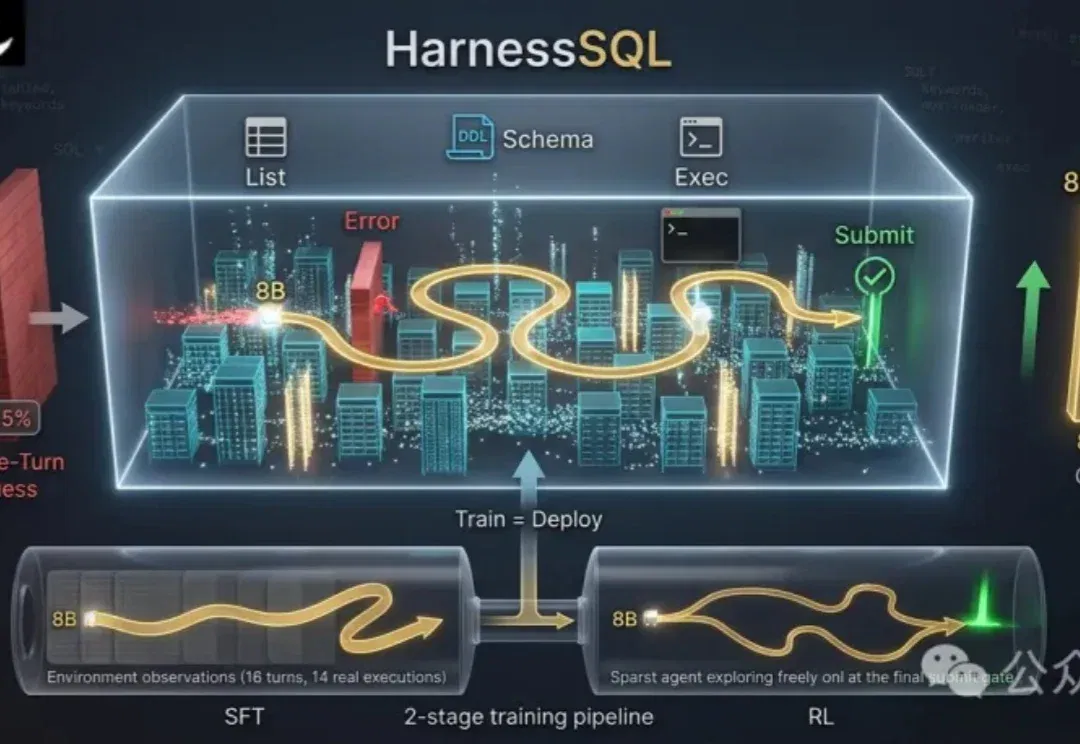
HarnessSQL 开源:把数据库交互环境纳入 SQL Agent 训练 (opens in a new tab)
HarnessSQL 在只读数据库沙盒内结合完整轨迹微调与执行奖励强化学习,让模型学习查表、试探查询和纠错。在Spider 2.0-SQLite上,8B模型报告45.2%执行准确率,高于所列32B基线;跨方言和更完整企业环境仍需进一步扩展。
影溯建设具身仿真数采中心,规划月产百万小时训练数据 (opens in a new tab)
影溯介绍杭州具身仿真数采中心:用空间扫描、物体拆解和物理标定构建场景,再并行生成训练轨迹,并按模型短板补充数据。公司预计月产100万小时、单条成本约为传统真机遥操作的十分之一,这些产能与成本口径仍需实际交付验证。
CoRL 2026|浙大联合TeleAI提出GR-BC,用图搜索从机器人试错中找出有效动作 (opens in a new tab)
浙江大学、TeleAI 与伽马智能提出 GR-BC,把多次成功、失败和人工介入轨迹连成图,从成功终点反向搜索进度,再为有效动作片段加权训练。在四项精细操作的真机实验中,X-VLA骨干平均成功率约91%,其他骨干只在部分任务上验证。
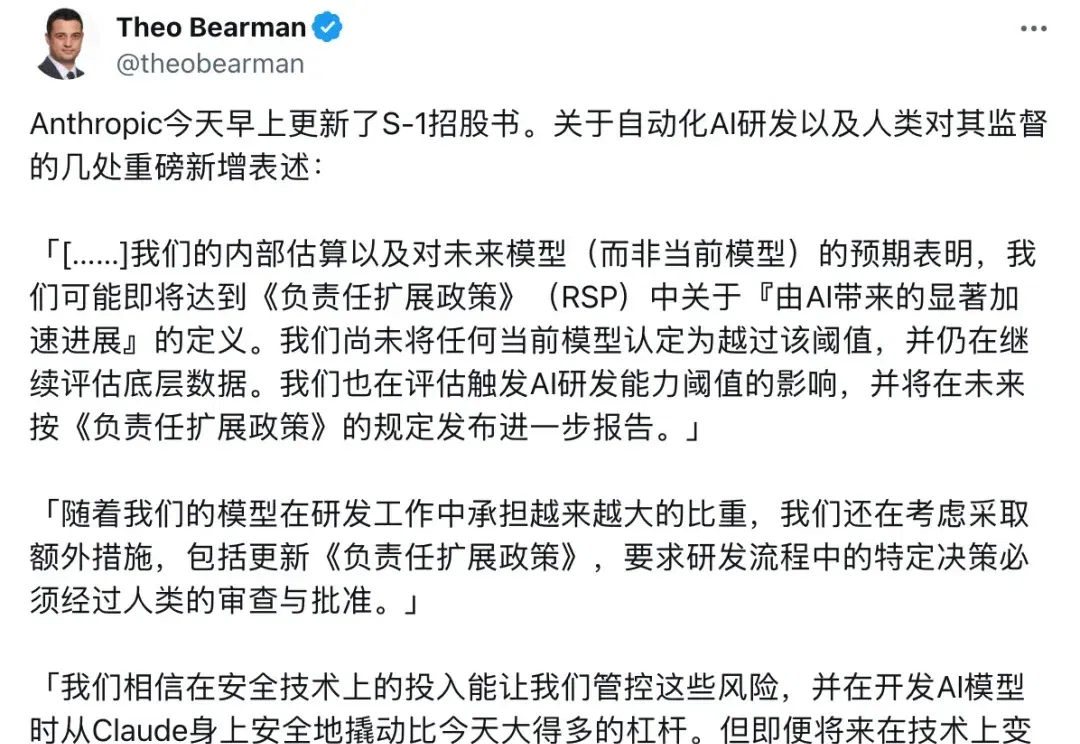
Anthropic 更新风险披露:AI辅助研发加速与人工监督边界 (opens in a new tab)
文章围绕 Anthropic 修订版招股书,讨论 AI 辅助研发的提速、监测滞后和人工监督要求。公司披露的代码产量、内部调用开销与长期算力承诺各有统计口径;有关未来研发加速阈值的评估,应与已经达到阈值的事实区分。
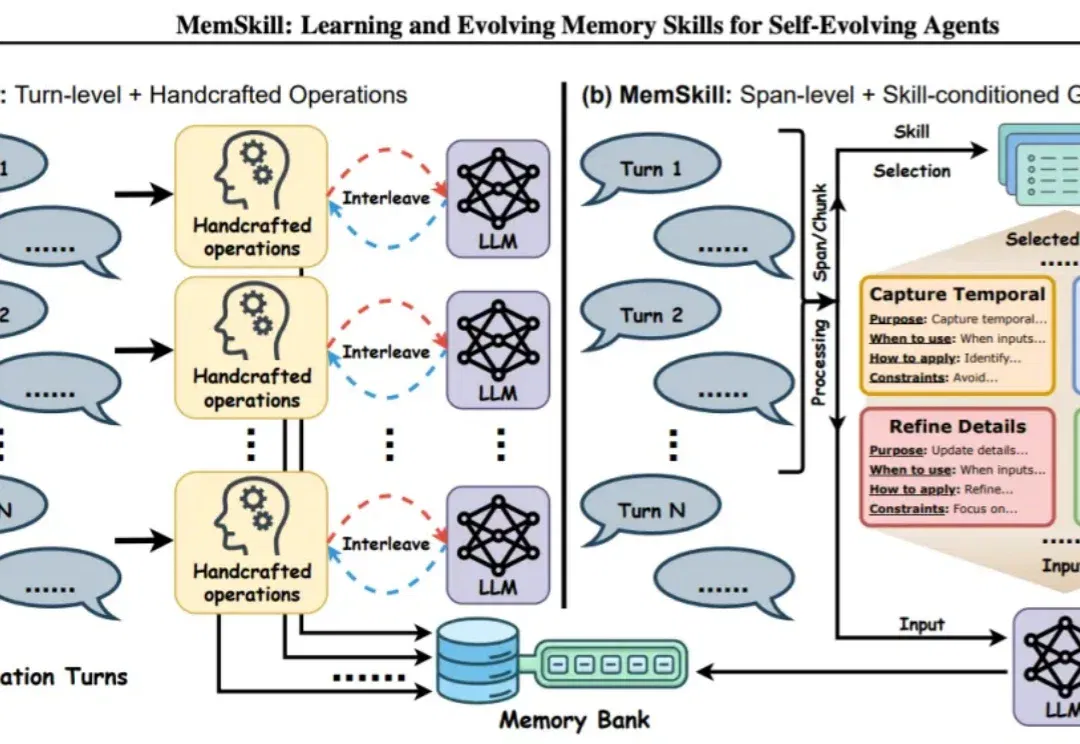
NeurIPS 2026|MemSkill让智能体学习并进化记忆技能 (opens in a new tab)
MemSkill 将智能体记忆操作封装为可复用的技能,由 Controller 学习选择,Executor 构建记忆,Designer 根据失败案例改进技能库。论文在长期对话、具身任务和迁移问答中评估表现;持续利用真实用户反馈适配偏好仍是后续研究方向。
作者体验 Tripo:3D打印、骨骼绑定与世界模型演示 (opens in a new tab)
作者用车辆、哨子和多肢角色等案例体验 Tripo,并与代码建模结果比较,讨论外观、可打印性、骨骼绑定和动画的差异。文章还记录 Project Eden 演示的表现与限制;结果来自个人少量案例,不代表完整产品评测。
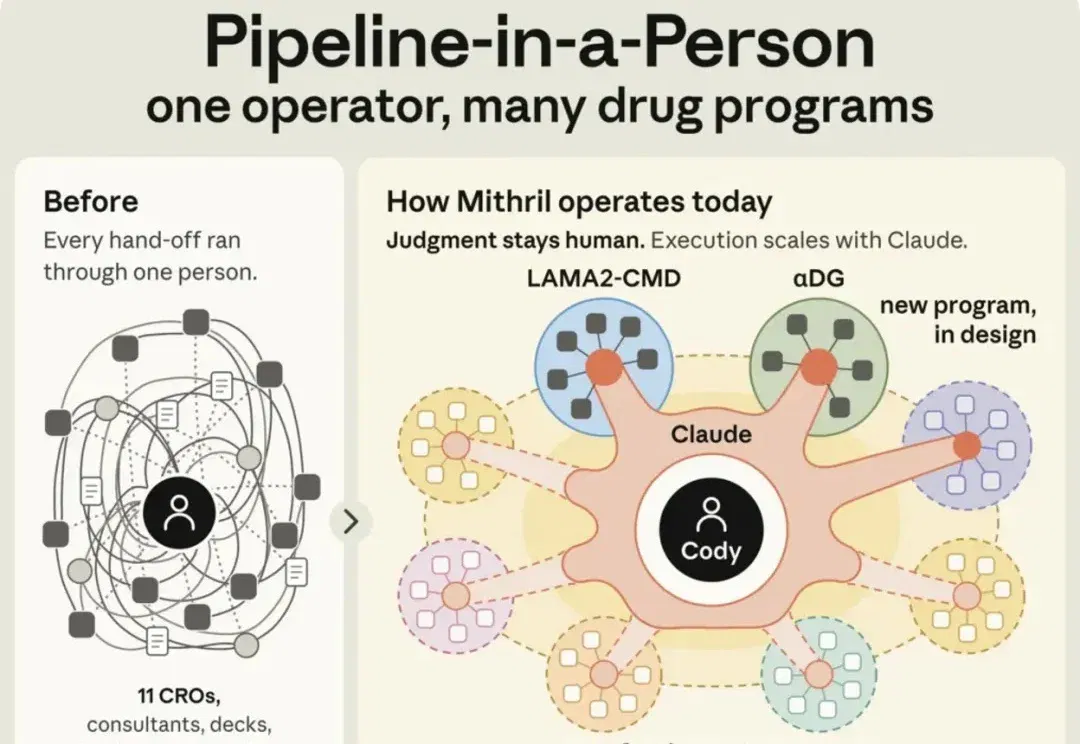
Anthropic 为什么买下一家「一人公司」 (opens in a new tab)
文章介绍 Anthropic 收购 Mithril Medicine 的研究背景:创始人借助 Claude 协调外部实验室,推进两项罕见病项目。已有结果仍处于早期动物实验阶段,尚不能证明对人体有效;案例也暴露出数据审核和跨机构沟通中需要人工复核的风险。
PhysLDM 用隐空间扩散生成可变形物体仿真轨迹 (opens in a new tab)
南洋理工大学与上海人工智能实验室提出 PhysLDM,用时空自编码器压缩形变轨迹,再由扩散模型一次生成整段运动。团队报告毫米级重建、跨物体迁移及可微材料参数反演结果,并比较生成式预测与确定性回归在复杂形变中的差异。
奥特曼预告下一代 GPT,回顾万级 Agent 数学研究 (opens in a new tab)
奥特曼在 ADIPEC 演讲中回顾 OpenAI 的数学研究并预告下一代 GPT。官方技术说明显示,万级 Agent 实验仍包含研究人员设题、资源调配和结果整合,不能等同完全无人参与;具体型号、发布时间及公众能否使用同等系统仍待确认。
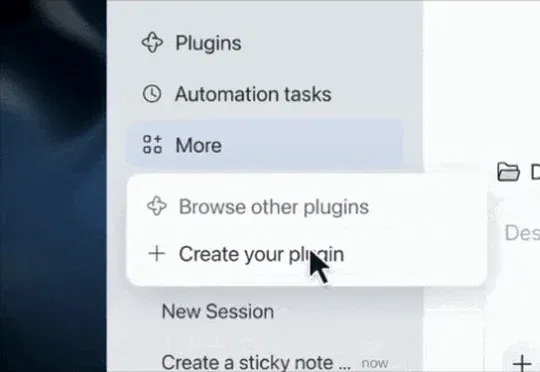
DeepSeek Harness 发布创造模式指南,公开7组插件示例提示词 (opens in a new tab)
DeepSeek Harness 公开创造模式的7组示例提示词,涵盖3D展示、Transformer可视化、视频剪辑、海报、论文阅读、界面主题与会话统计。官方提示,部分演示经过多轮修改,单条提示词未必能复现全部效果;生成插件仍需检查结果和安装权限。
AniShort 推出本地 AI 影视工作台,接入 Codex 等智能体 (opens in a new tab)
AniShort推出原生本地架构的AI影视工作台,接入Codex等智能体,支持自动质检、自定义模型API、Skill复用及本地专业软件协同。