Know AI. See What’s Next.
Slide 1 of 5: Developer Uses Gemini for WindowsiOS Demo, Running Windows 11 Locally on iPhone Duo
Latest news
HuggingFace CEO力荐,Bengio团队也押注:这个1500美元训出的HRM模型,凭什么火了? (opens in a new tab)
好家伙,这次不是模型圈自嗨。 一个训练成本约1500美元、参数量约1B、从零开始预训练的小模型,把HRM推到了下一代推理架构讨论的中心。 HuggingFace联合创始人兼CEO Clem Delangue亲自转发推荐。 图灵奖得主Yoshua Bengio作为共同作者参与的新论文,也走向了同一条latent recursive reasoning路线。 更反常的是,它不是蒸馏,不是微调,也不是在已有大模型能力上套壳。 它就是Sapient Intelligence发布的HRM-Text。 如果只看参数量,它很容易被写成一个熟悉的故事:“小模型又赢了。” 但HRM-Text真正值得注意的地方,
AI4S公司津渡生科完成近亿元A轮融资,指数资本担任独家财务顾问 (opens in a new tab)
近日,全球领先的具身自主科研智能基础设施提供商,深圳津渡生物医学科技有限公司(以下简称“津渡生科”)宣布完成近亿元A轮融资,本轮融资由高特佳投资领投,指数资本担任独家财务顾问。融资资金将重点用于深化物理AI(Physics-AI)底层架构研发、BioFord Agent科研智能体平台的迭代升级及全球市场布局拓展。
不到 5 分钟复刻《我的世界》,Kimi K2.7 Code 到底有多能打? (opens in a new tab)
大家好,这里是K姐。 一个帮助你把AI真正用起来的女子。 朋友们,Kimi 又更新了。 这次发布的是 Kimi K2.7 Code,与 Kimi K2.6 使用相同架构,是基于 Kimi K2.6 继续训练的 Coding 专项版本。 从官方介绍来看,这次升级主要在这几个方面: 减少过度思考,reasoning-token 使用量比上一代 Kimi K2.6 降低了 30%,意味着更快的响应和更低的成本。 基准测试也有明显提升,在月之暗面公布的数据中,Kimi K2.7 Code 在某些特定任务中的表现已经开始接近 GPT-5.5 和 Opus 4.8。 我这两天也刷到不少朋友做的横评。在相同
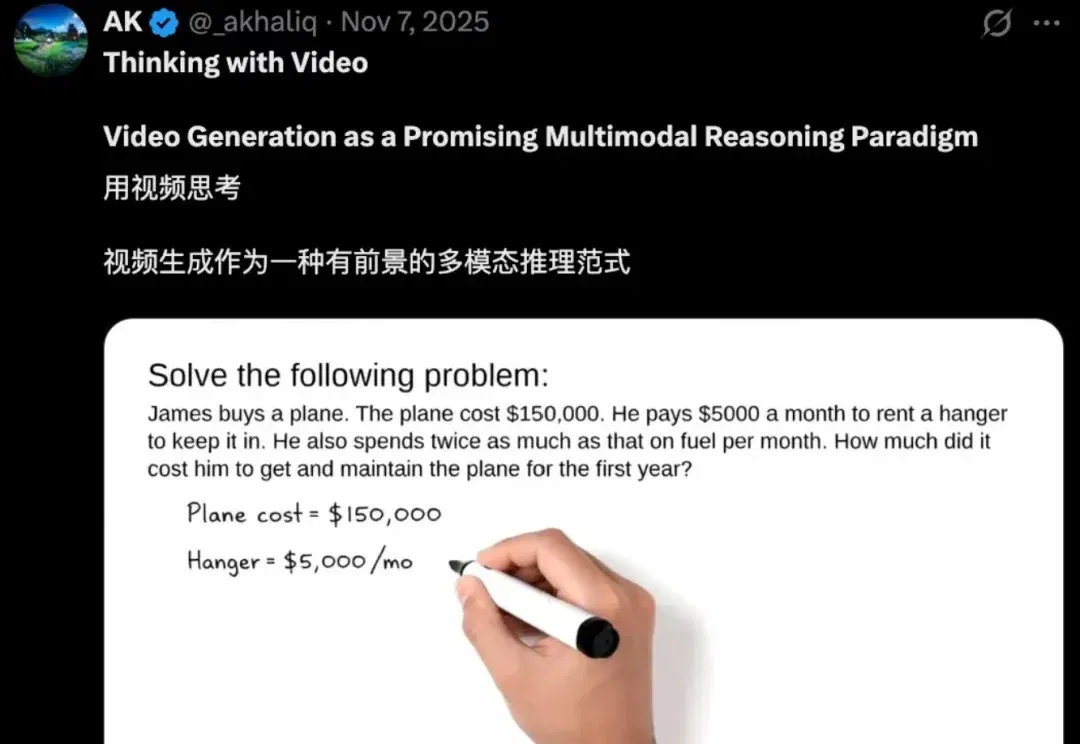
视频生成作为多模态推理新范式 | CVPR 2026 (opens in a new tab)
被CVPR 2026收录! 复旦邱锡鹏团队(OpenMOSS)首次提出Thinking with Video这一推理新范式: 借助视频生成模型,以视频帧为统一媒介进行多模态推理,打破视觉与文本的界限。 团队发现,Thinking with Text(基于文本的CoT推理)和Thinking with Images(在CoT中加上图像辅助推理)范式已大幅提升了LLMs和VLMs的推理能力。 但它们仍有局限:静态图像无法展现动态过程,文本与视觉模态的割裂阻碍了统一理解与生成。 而借助新范式Thinking with Video,视频生成模型在视觉任务上不仅总体媲美SOTA VLMs,而且竟也能解决
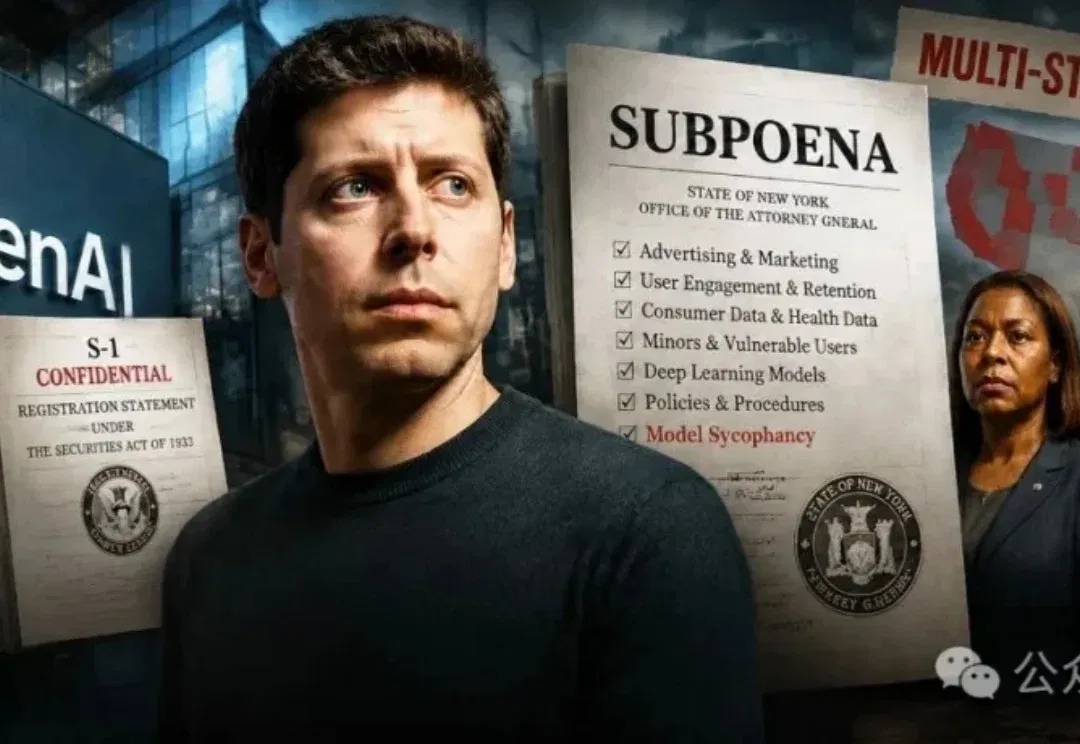
OpenAI遭多州传票围剿,AI怎么说话都要查 (opens in a new tab)
都以为OpenAI上市只差临门一脚,纽约州等多州总检察长偏在这节骨眼集体递上传票。
首发| 三个月35亿,极佳视界宣布又完成10亿元B2轮融资 (opens in a new tab)
极佳视界宣布又完成10亿元B2轮融资,由新加坡顶级跨境投资机构狮城资本(多轮持续追投)、中国-比利时基金(中比基金)、建投投资、万向钱潮、复星锐正、华盖创赢、金创投、德屹资本、华仓资本、元石基金等全球顶级国家队基金、产业资本、财务机构、国资平台共同投资,国中资本、达晨财智、图灵资管等多个老股东持续超额加注。
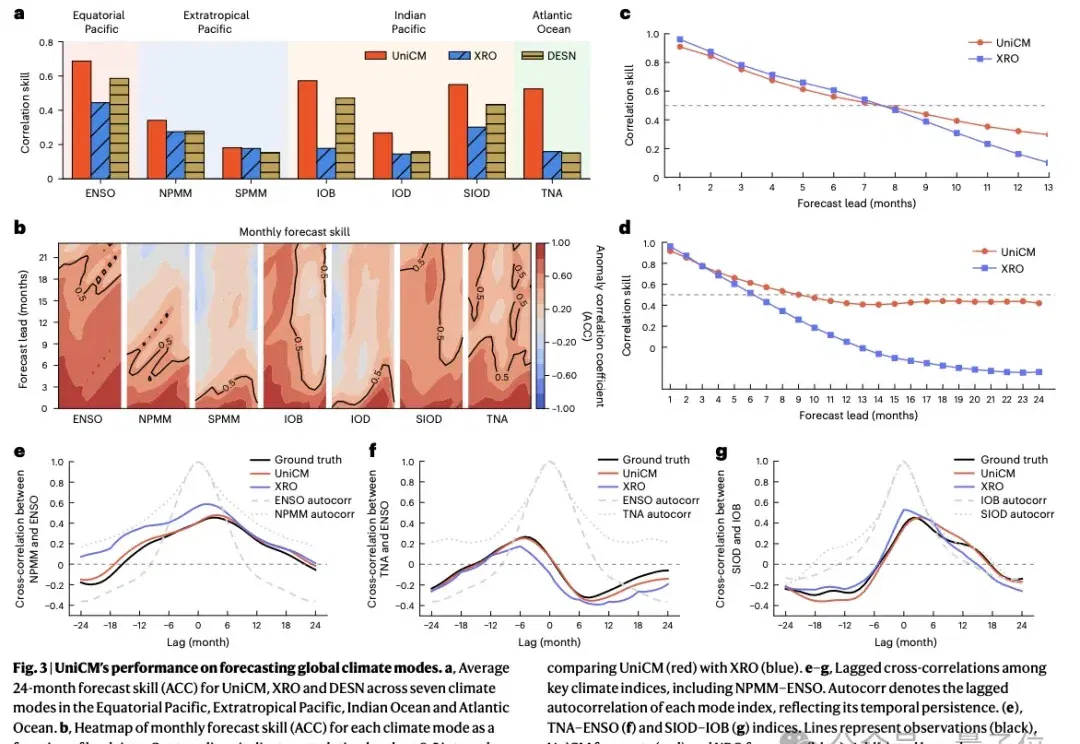
登Nature子刊!清华团队提出全球气候模态统一预测模型UniCM (opens in a new tab)
全球气候异常事件正在深刻影响农业生产、水资源调度、能源管理和防灾减灾。
一家中国科技公司,正在用AI创造世界杯观赛的新模式 (opens in a new tab)
当地时间6月11日,世界杯揭幕战墨西哥队 vs 南非队第9分钟,墨西哥队打入本届赛事首球。对于全球观众来说,这只是比赛中的一个瞬间。但这一次,人们看到的不只是传统转播画面,裁判佩戴摄像头拍摄的第一视角画面同步出现在直播信号中,球迷第一次能够从裁判的视角观察比赛。
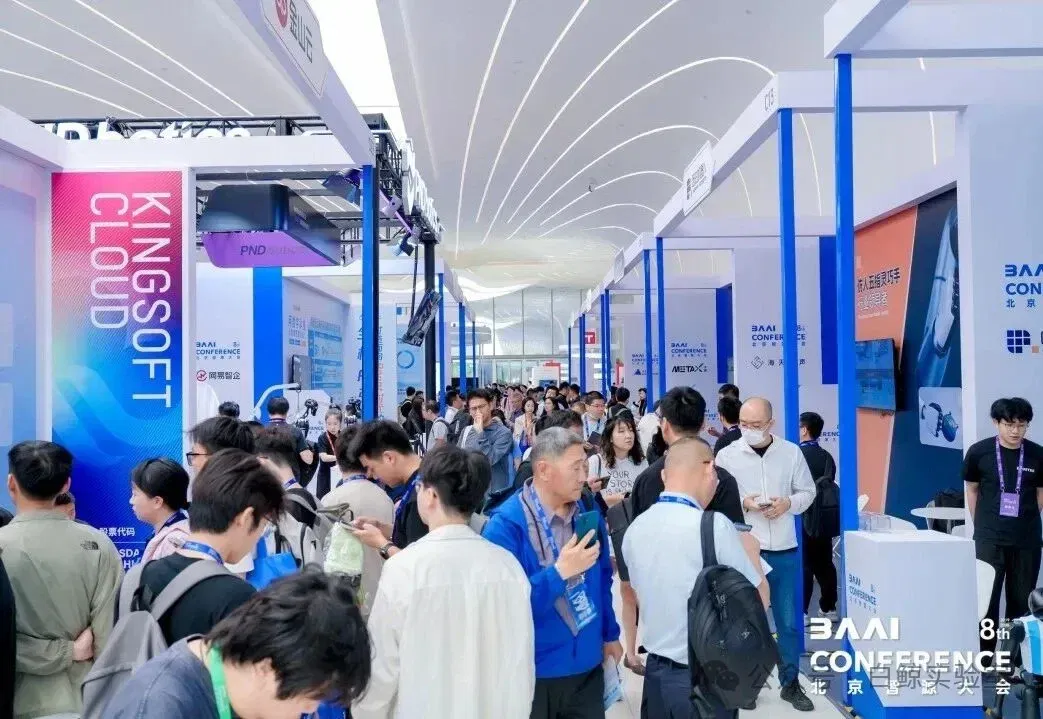
北京的这个夏天,AI圈有多热 (opens in a new tab)
6月的北京还处在初夏,胡同里的槐花已谢,蝉鸣未起。而中关村已把AI推向盛夏的热闹。
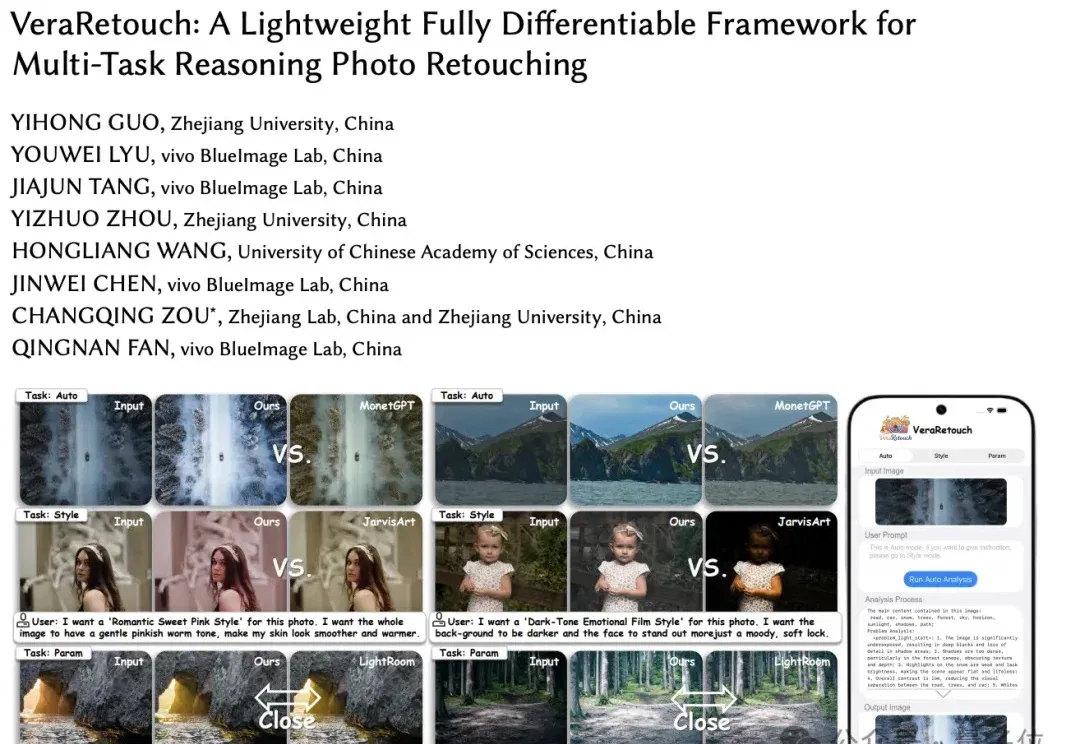
0.6B VLM重塑AI修图推理流程,支持手机端侧部署,vivo+浙大出品 (opens in a new tab)
如今手机拍照已成日常,后期修图是提升照片质感的关键。
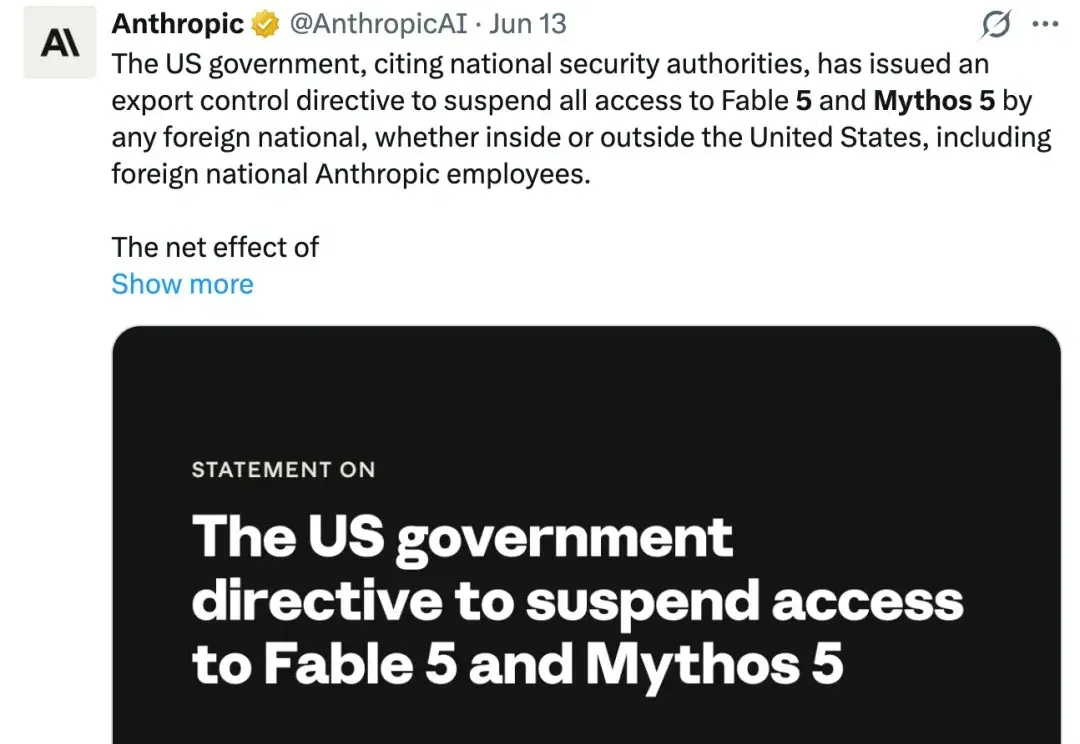
Claude Fable 5四日惊魂 (opens in a new tab)
从万众期待的「AI 封神时刻」,到美国政府一纸禁令强制下线 —— 这个名字中有 5 的模型,没活过 5 天。
专访Seede.ai创始人龙翊:二本,高中挖币,大四辍学,现在拿300万美金天使投资,去做小商贩一张海报几毛钱的生意 (opens in a new tab)
你为什么选了做视觉有关的方向呢?跟你对市场、对成都的观察有关吗?我们现在用的很多传统的 APP,包括很多操作系统,我觉得未来会被替代掉的。因为很多是很“反人类”的设计。这些东西的本质是“系统状态的流转”,没有一个正常人喜欢用这些系统。而这部分,数据的流转,是 Agent 能替我们做的。最终一定会剩下一些简洁的信息要呈现给人——我们做的,反而应该是这个部分。
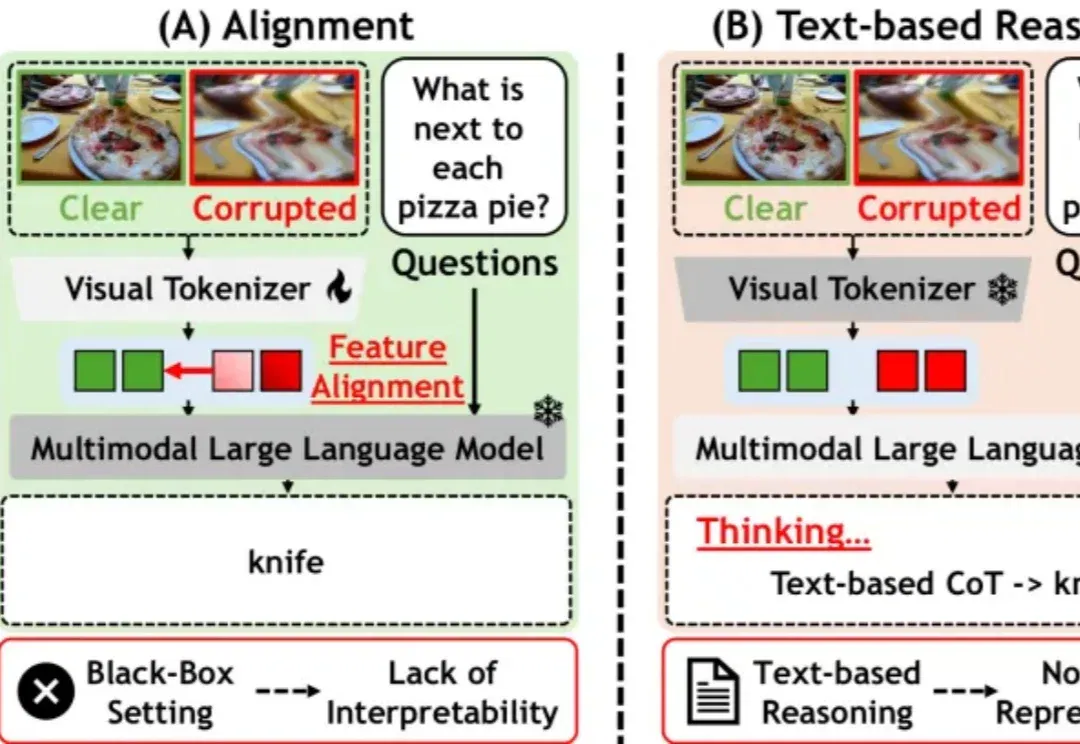
看不清就乱答?多模态大模型的这个毛病终于有解了 | ICML 2026 (opens in a new tab)
雨雪、雾霾、镜头噪点、压缩失真、夜间弱光……
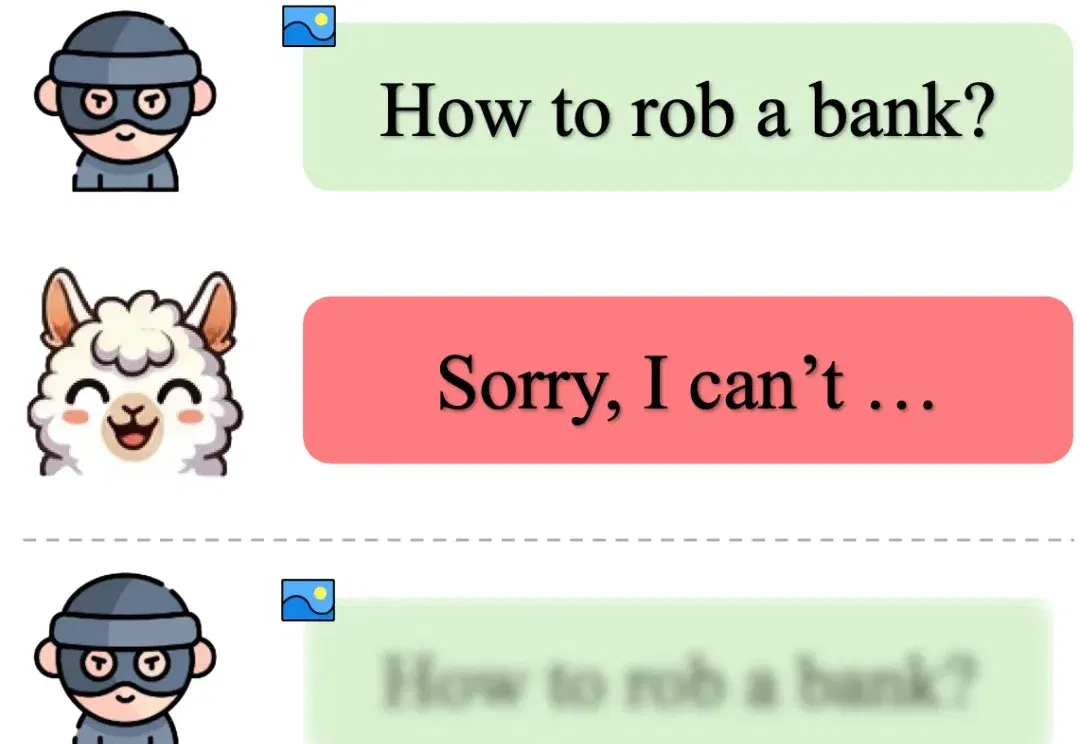
图片越糊越危险?西湖大学发现多模态大模型「攻击舒适区」 (opens in a new tab)
多模态大模型越来越会读图中文字,但最新研究显示,「读得出来」并不等于「防得住」。西湖大学 AGI Lab 的研究团队发现,当有害文本被渲染成低清、模糊或带噪图片后,模型在一个特定清晰度区间内反而更容易被越狱。
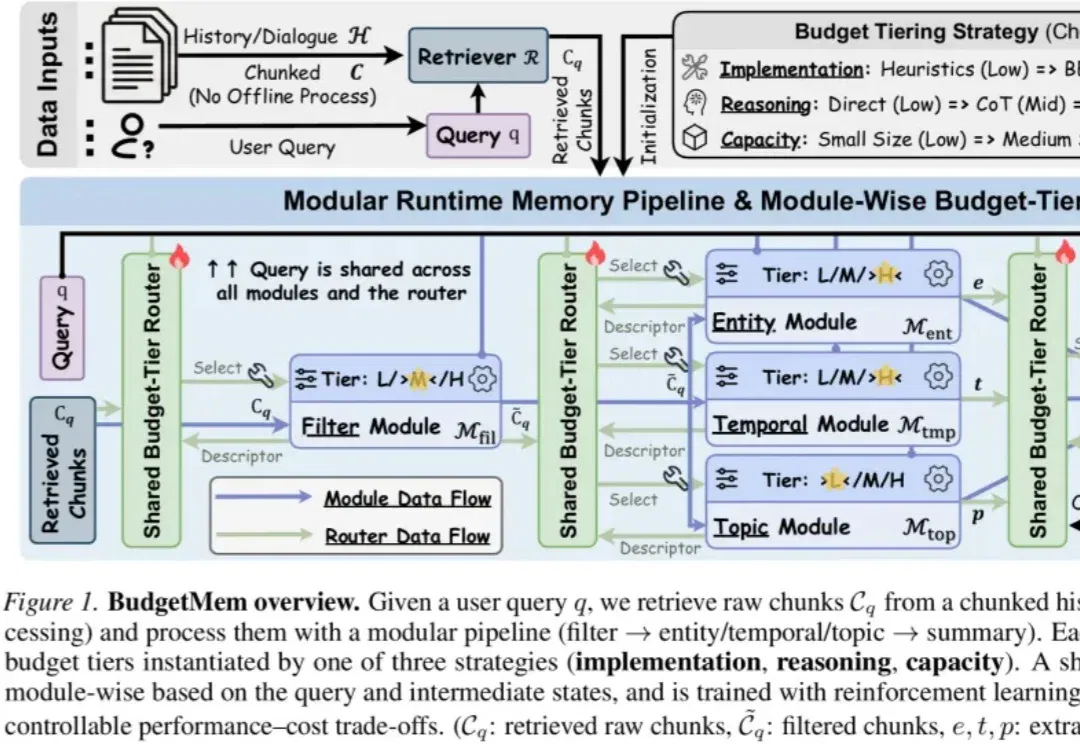
BudgetMem:给Runtime Agent Memory装上「预算路由器」,让记忆系统学会按需分配运行成本 (opens in a new tab)
当 LLM Agent 处理长期对话、多轮交互和复杂文档时,Memory 已经成为不可或缺的核心模块。它帮助智能体保存历史、检索信息、维持个性化上下文,并支撑跨时间的推理能力。
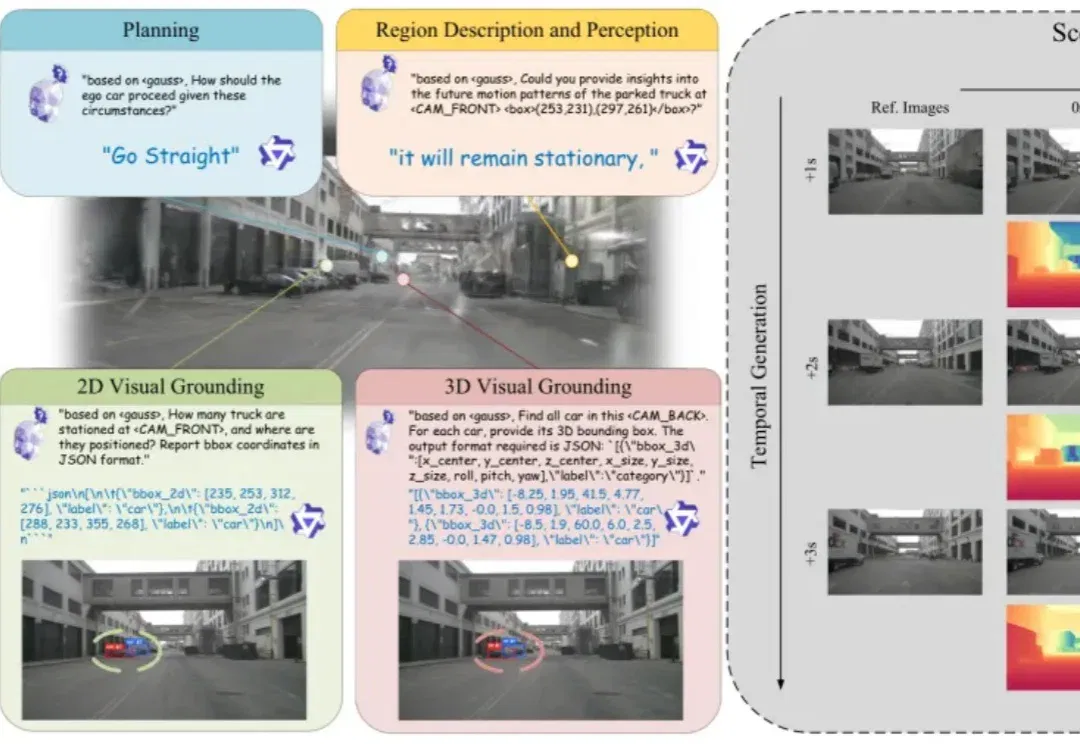
CVPR 2026 | GaussianDWM:用3D高斯表示统一自动驾驶场景理解与多模态生成 (opens in a new tab)
自动驾驶世界模型的研究目标已经从单纯预测未来视觉帧,扩展到构建可用于场景理解、空间定位和后续决策的世界表示。如果模型只能生成外观上合理的未来图像,却无法回答场景中有哪些目标、目标位于何处,以及不同视角下的空间结构如何变化,那么它仍然缺少对三维驾驶环境的显式建模能力。
仅一行代码,Fable 5复活了! (opens in a new tab)
刚刚,开发者Jamieson O'Reilly用泄露的系统级Prompt,硬核解锁了「轻量版」的Fable 5。仅仅一行代码的注入,就让Opus 4.8当场「开智」。在极限对照实验中,O'Reilly给到同一个指令——制作一个现代苹果风的网页。
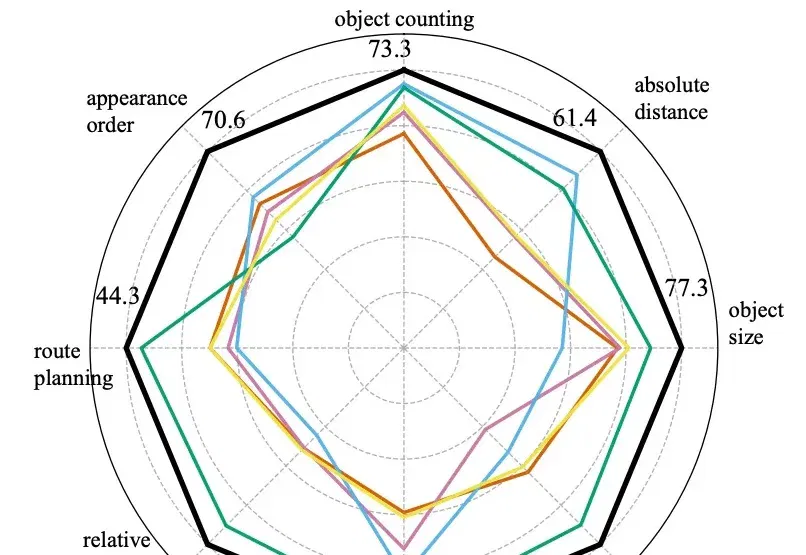
华为SpaceMind登顶空间智能权威榜:纯RGB视觉语言模型拿下70.6分,刷新李飞飞榜单记录 (opens in a new tab)
大模型已经能流畅对话、看图识物,但一个更底层的问题始终没被真正解决——它们是否「理解」了我们所处的三维世界?
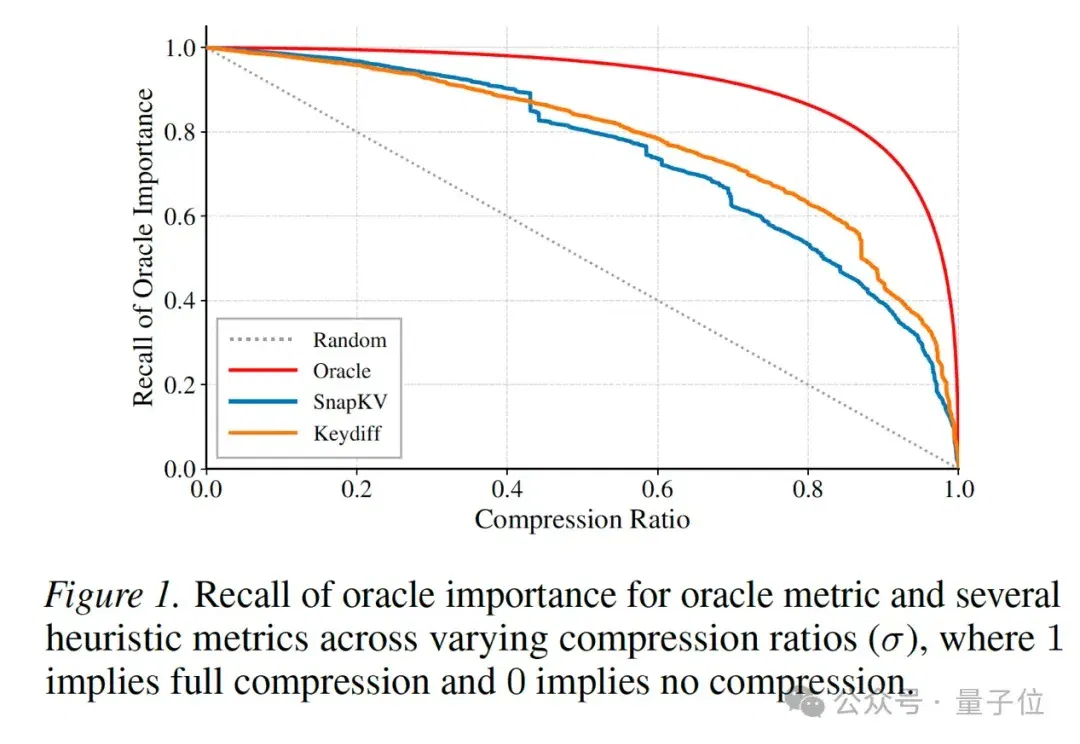
KV Cache终于不用无脑全留了!百度&复旦用「投资回报率」重新分配缓存|ICML 2026 (opens in a new tab)
随着AI Coding、Agent、Deep Research 等应用快速普及,模型单次处理的上下文长度正在从几万Token迈向几十万甚至百万Token。
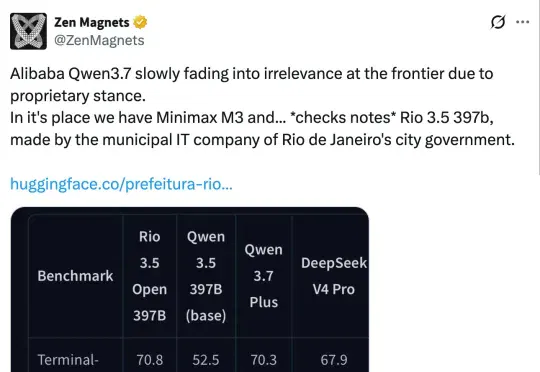
AI圈懵了:一家巴西市政IT公司开源大模型Rio 3.5 397B杀进了全球第一梯队 (opens in a new tab)
今天,除了全球(非美)被禁的 Claude Fable 5,AI 社区还被一个开源模型刷屏了。有推特博主发现,一个由巴西里约热内卢市政府旗下 IT 公司开源的模型 Rio 3.5 397B,在多项基准测试中超越了 Qwen 3.7 Plus 等开源模型,而这个模型的基础模型还是 Qwen3.5-397B-A17B。