Know AI. See What’s Next.
Slide 1 of 5: Developer Uses Gemini for WindowsiOS Demo, Running Windows 11 Locally on iPhone Duo
Latest news
端侧跑大模型,现在也太简单了 (opens in a new tab)
最近,我们都在关注旗舰级大模型的进步,其实本地运行的 AI 模型也迎来了重要的分水岭。
开源!阿里甩出首个语言世界模型,能造智能体环境 (opens in a new tab)
一个模型能模拟7种环境。 智东西6月24日消息,刚刚,阿里千问大模型上新,发布首个原生语言世界模型(LWM)Qwen-AgentWorld,该模型有35B-A3B与397B-A17B两种参数规模。 该模型专门为各类AI智能体研发与训练而生。在博客中,研究人员提到,该语言世界模型的核心目的不是降成本、替代智能体的真实交互环境,而是为了增强通用智能体的能力。其可以让智能体在做动作前,先在内部模拟环境反馈再决策。 Qwen-AgentWorld两大核心亮点为: 从预训练阶段就将环境建模作为训练目标,贯穿CPT→SFT→RL全流程。此前完整训练通用基础大模型,往往会在训练结束后,才开始教AI理解环境、
智谱与Anthropic是母凭子贵 (opens in a new tab)
Anthropic增加绿卡认证后,最开心是智谱,直接原地化身战狼,高呼「前沿智能属于所有人」,提前把专注Coding的GLM5.2发了。
紧跟诺奖得主,斯坦福经济学泰斗火速入职Anthropic! (opens in a new tab)
IPO敲钟前夜,Anthropic再放大招!Chad Jones官宣入职,用最硬经济学炮抢占国家AI政策最高话语权。
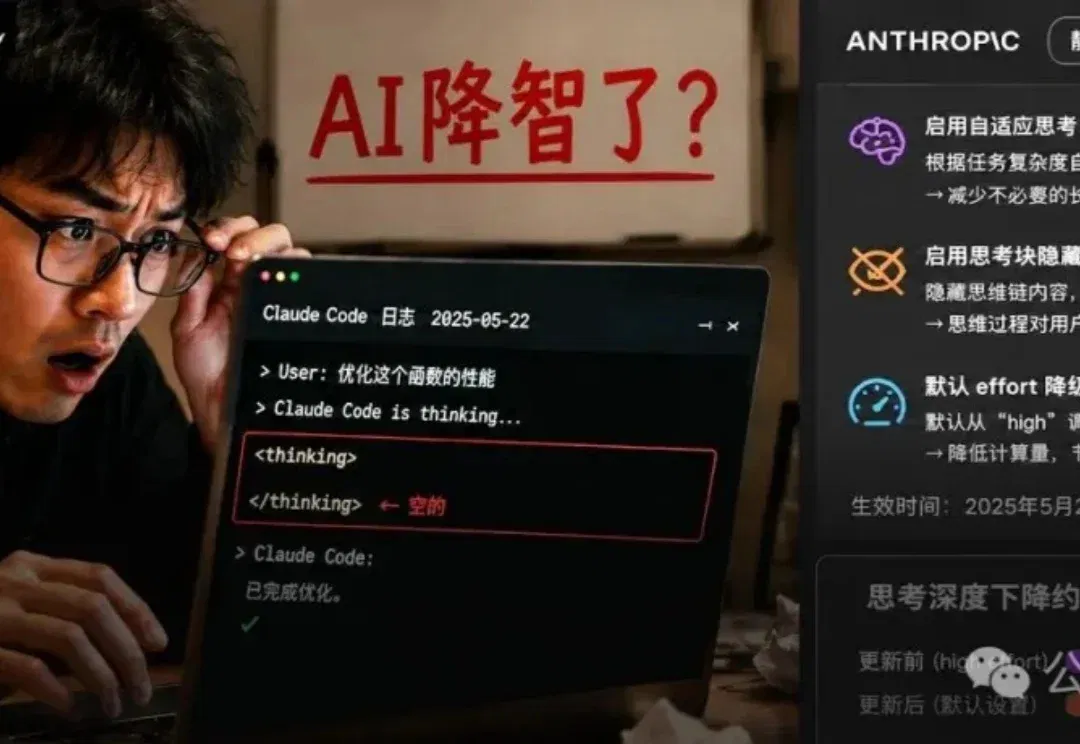
Claude惊人真相被教授曝光:思考过程加密,给钱也看不到! (opens in a new tab)
当初,Anthropic推出extended thinking的时候,把它包装成「让用户看到思考过程」的透明标杆。现在真相是:你看到的只是他们允许你看到的部分。那些被加密、被压缩、被锁在全局密钥里的内容,藏着什么?
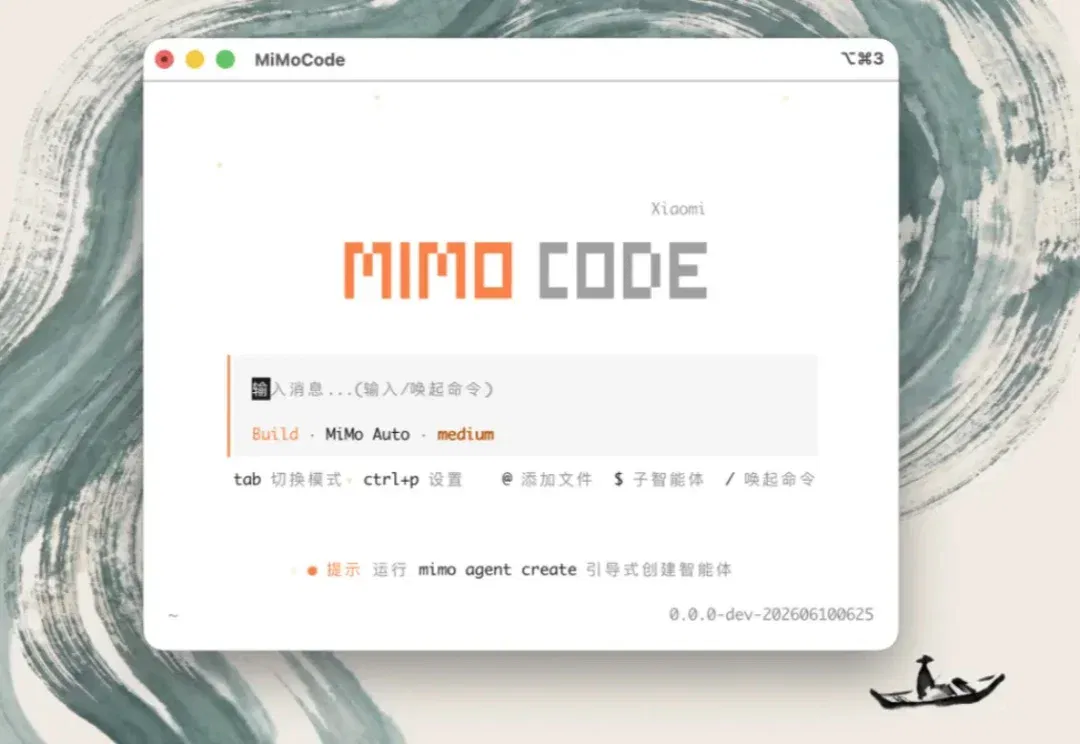
Mimo Code 爆火:我们挖开源代码,找到小米 AI 的真创新 (opens in a new tab)
6 月 11 日凌晨,小米 MiMo 团队公开了一个叫 MiMo Code 的项目,定位是终端编程 Agent,MIT 协议开源。官方宣传重点有三处,14 天 5 人团队投入的“vibe coding”开发叙事、Claude Code 之上的 SWE-Bench Pro 跑分。以及“无限上下文”的记忆架构。
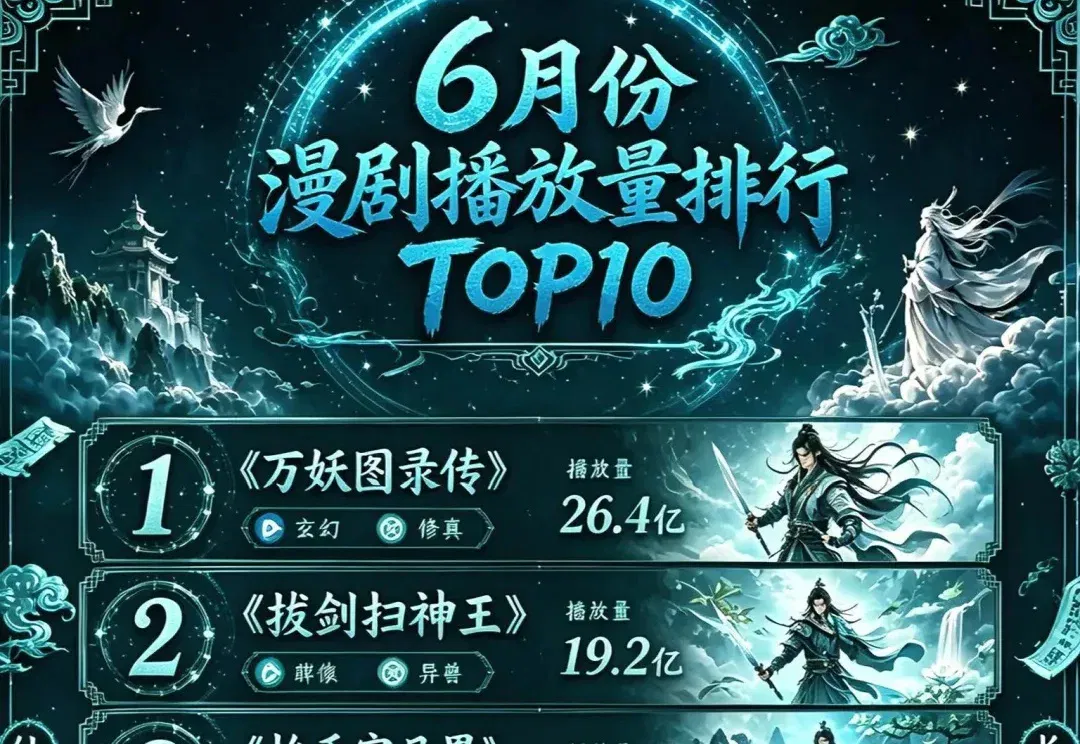
从0到1跑通AI爽剧:超高质量短剧制作全流程SOP直接拿走!【建议收藏】 (opens in a new tab)
大家好,我是最近疯狂研究短剧的袋鼠帝 最近的AI漫剧发展的是真快啊,各种爽文小说改编的AI漫剧播放量甚至已经超过了某些电影和电视剧。
突发!美国商务部拟对中国机器人出手 (opens in a new tab)
美方官员被曝坦言,美国已流失下一代机器人配套产能。
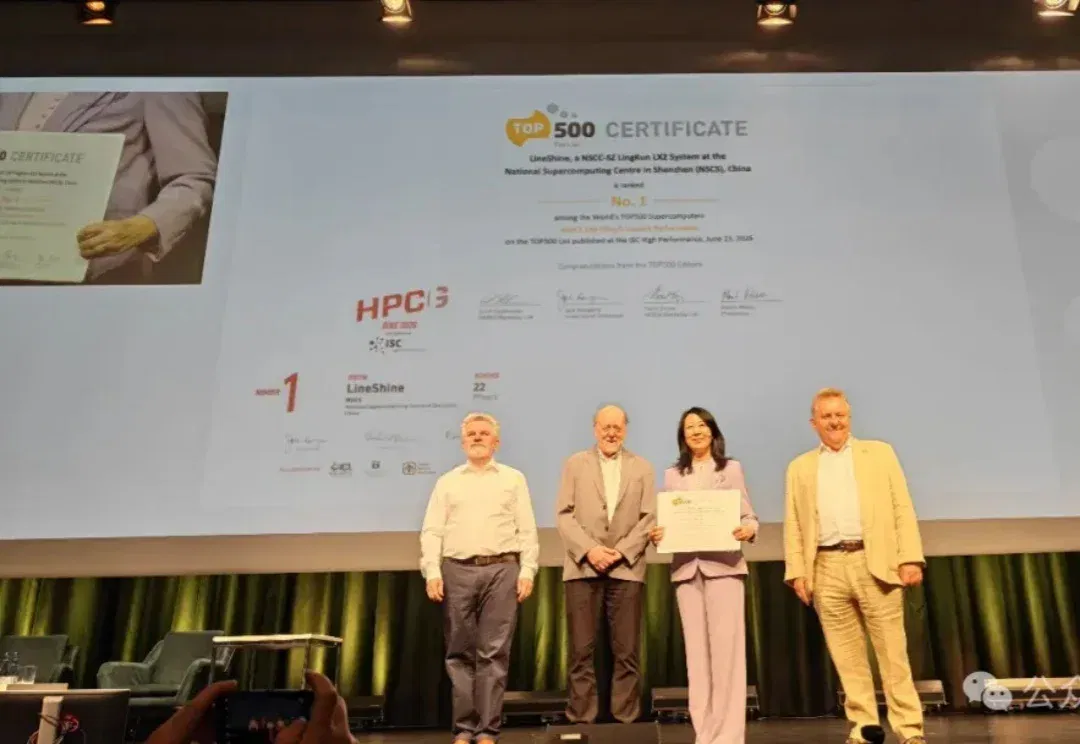
零GPU,世界第一超算!深圳制造改写游戏规则了 (opens in a new tab)
全球最强超算,易主了! 中山大学教授带队、深圳制造的灵晟超级计算机,刚刚登顶全球超算TOP500榜单,打破了西方近十年的垄断地位。 更让人惊诧的是,这个TOP1超算,含英伟达量为0,甚至一块GPU也没用。 在超过2EFlops的超算系统中,独一无二,惊诧友邦。 △来源:中山大学计算机学院官微 具体来说,灵晟采用了自主可控的纯CPU架构,CPU芯片、存储架构和高速互连网络全部自研。 图灵奖得主Jack Dongarra评价,灵晟是“AI4S新型架构的希望之光”,将重新划定全球算力竞争格局。 0GPU含量,全链路自主可控 灵晟没有使用一块GPU,这在今天的超算领域几乎是一个异类。 El Capit
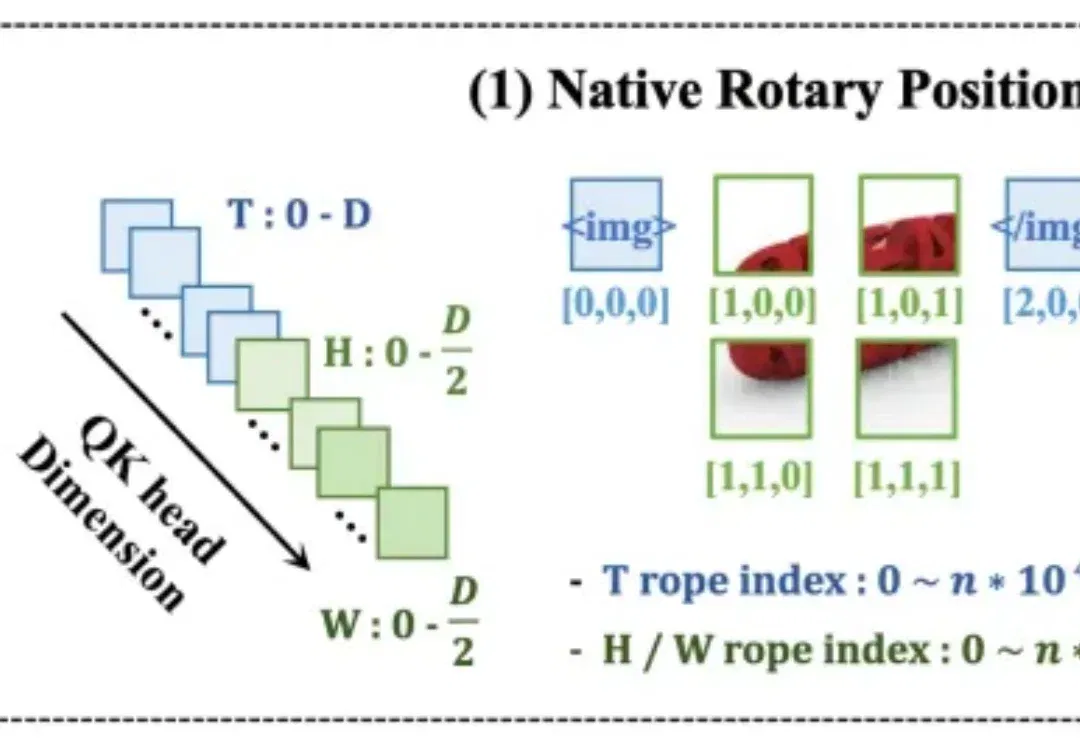
直接从像素到单词:这个原生大模型统一单图、多图、视频和空间智能 (opens in a new tab)
今天几乎所有主流视觉语言模型(VLM)—— 无论是 Qwen-VL、InternVL,还是 LLaVA 系列 —— 都遵循着同一套经典架构:先用预训练视觉编码器(如 CLIP、SigLIP)将图像压缩为特征,再通过投影层把这些特征送入大语言模型。
云计算一哥,让小鹏、Kimi和猎豹都爽了一把 (opens in a new tab)
有这么一组数据,是真真儿地戳到了用Agent这件事的爽点。
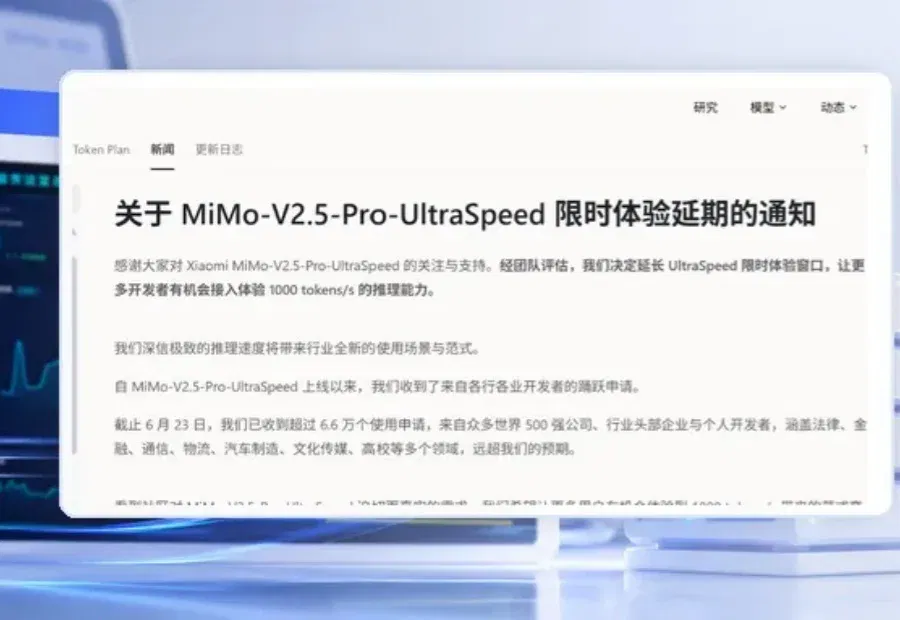
6.6万人排队!小米旗舰“超速”模型延长体验时间,官方:500强争着用 (opens in a new tab)
小米UltraSpeed需求远超预期。 智东西6月24日消息,昨日,小米MiMo开放平台发布公告,宣布延长旗下MiMo-V2.5-Pro-UltraSpeed模型的聊天体验与API接入体验期限。该模型于6月9日上线,原定体验窗口截至6月23日,但由于申请量远超预期,团队决定延长开放时间。 ▲关于MiMo-V2.5-Pro-UltraSpeed限时体验延期的通知(图源:小米MiMo) 官方数据显示,截至6月23日,MiMo-V2.5-Pro-UltraSpeed已收到超过6.6万个使用申请,申请者包含世界500强公司、行业头部企业与个人开发者,涵盖法律、金融、通信、物流、汽车制造、文化传媒、高校
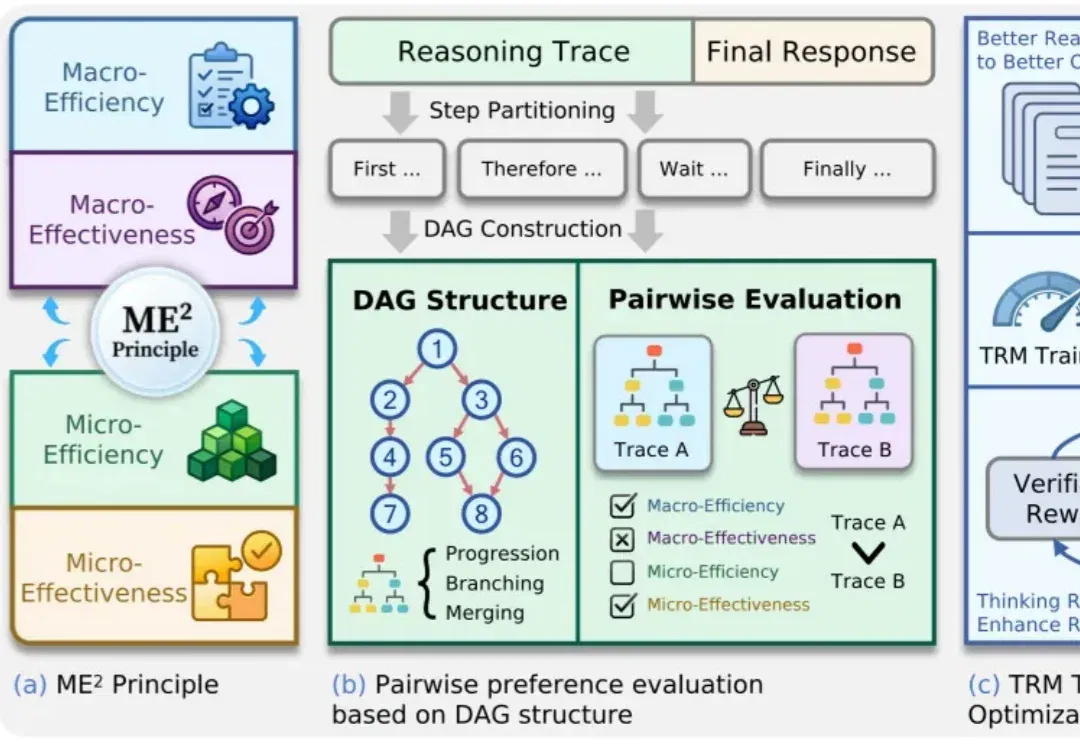
TRM思考奖励模型上线,大模型推理质量终于能量化了 | ICML‘26 Oral (opens in a new tab)
大模型推理能力越来越强,但答案对了,思考过程就一定好吗?
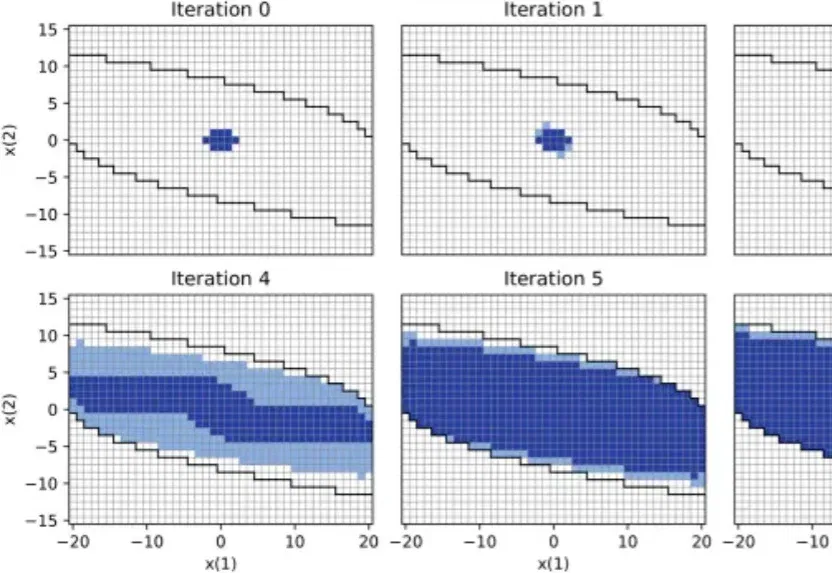
真机强化学习如何保证安全性?清华团队提出安全探索均衡机制 (opens in a new tab)
近日清华大学于IEEE TPAMI发表论文,探讨了真机强化学习的安全性保障问题,提出了一套「安全探索均衡」新型机制,揭示了安全探索的理论最大边界,并攻克了其收敛性证明难题。
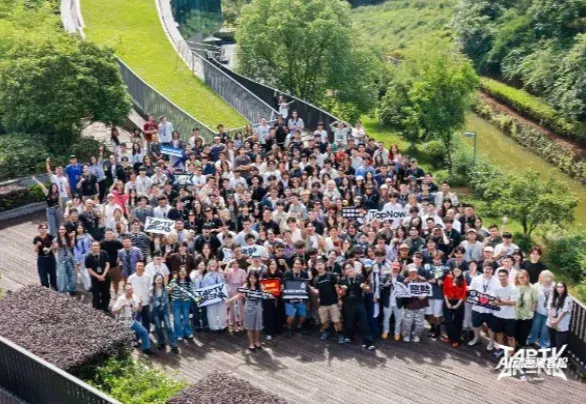
我在全球最大规模AI动画黑客松,见证了AI影像创作生态的崛起|独家 (opens in a new tab)
同样是36小时AI动画黑客松,从24支团队手忙脚乱搓出优质率约40%的AI短片,到110支AI创作者团队火力全开、用60%以上的精彩作品冲击观众的视网膜,才过去多久呢?
Karpathy投了一家AI记忆公司,撞名DeepSeek Engram记忆架构 (opens in a new tab)
当大模型公司还在竞争更长的上下文窗口、更强的推理能力和更复杂的 Agent 工作流时,一家名为 Engram 的新公司选择押注另一个问题:AI 能不能像人一样,持续从每天接触到的资料、对话和经验中学习?
刚刚,豆包宣布收费 (opens in a new tab)
今天,字节跳动旗下AI应用豆包正式推出专业版以及对应收费方案。豆包专业版基于最新的豆包2.1系列大模型,将提供更高的生产力场景使用额度,以及接入豆包2.1 Pro模型的全新“办公任务”模式。免费用户可以体验接入豆包2.1 Turbo模型的办公任务模式。
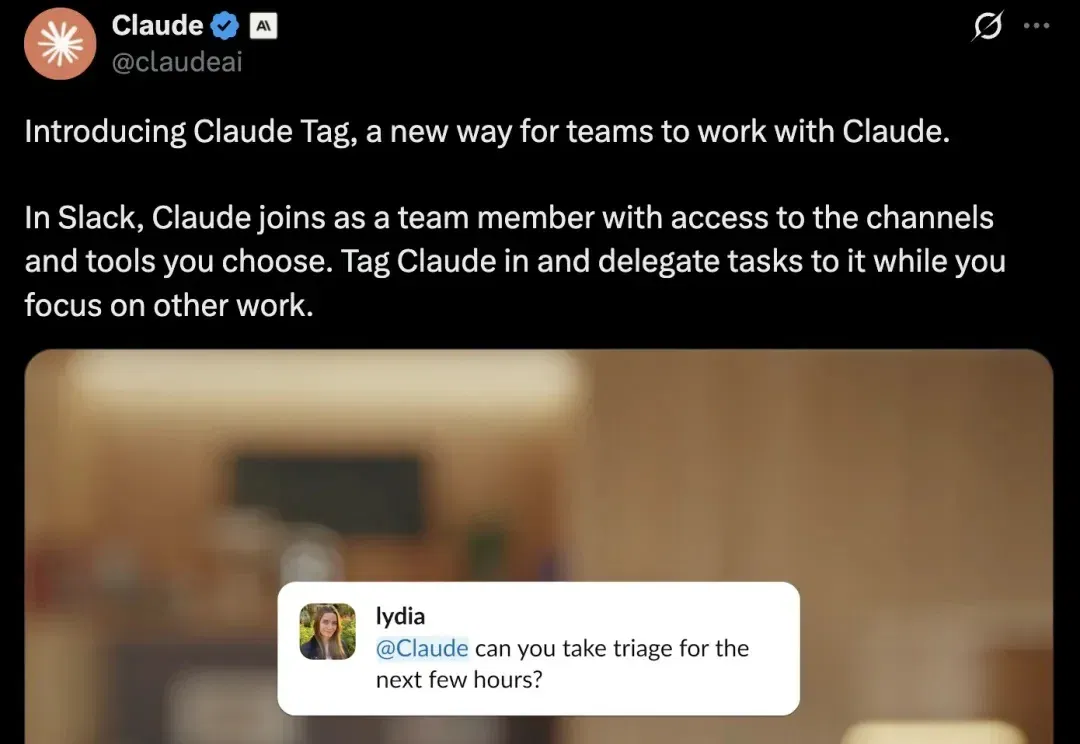
刚刚,Claude Code大升级!卡帕西:LLM第三次变革 (opens in a new tab)
刚刚,Claude Code迎来一次重大升级。
深圳AI硬件特别正常 (opens in a new tab)
前一阵见的尽是疯狂bro。做性爱机器人的Somina lab彻底炒作起来了,我看好几个媒体专程去帮bro炒作,还长篇大论宛如写社会学小作文一般分析卧室亲密具身情感陪伴。
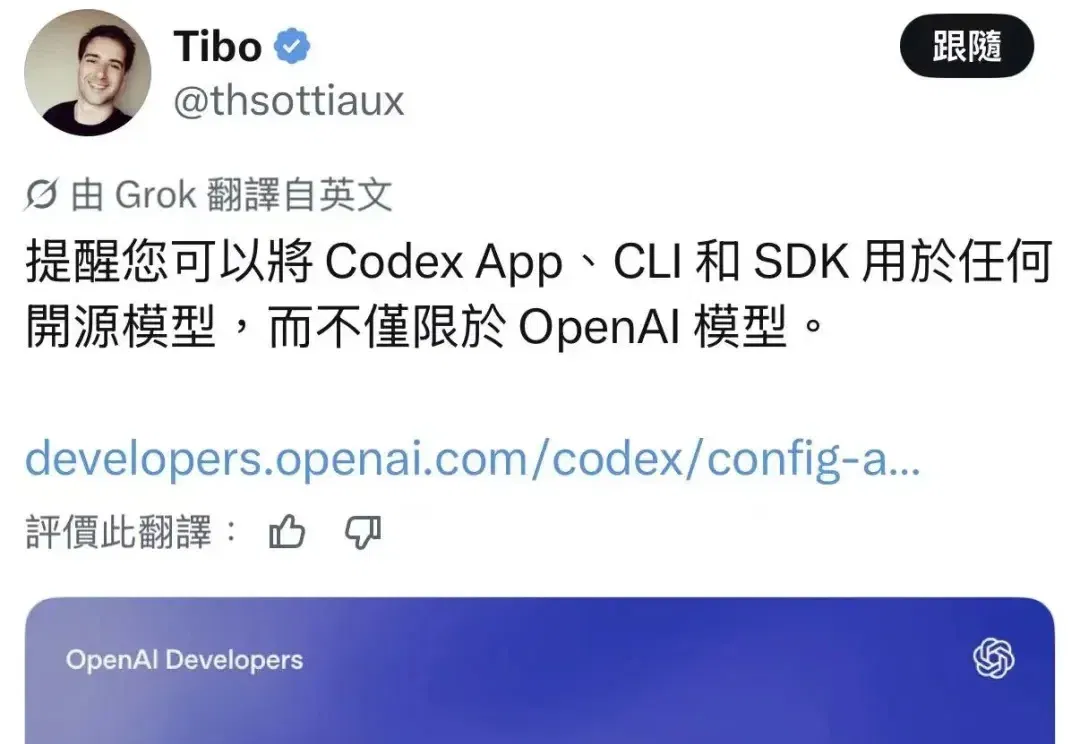
Codex兼容国产开源模型!实测DeepSeek接入:门槛还是太高 (opens in a new tab)
6月17日,X 上 OpenAI Codex 团队负责人 Tibo(@thsottiaux)发了一条推文,提醒大家 Codex App、CLI 和 SDK 现在可以接任何开源模型,不只限于 OpenAI 自己的模型。