Know AI. See What’s Next.
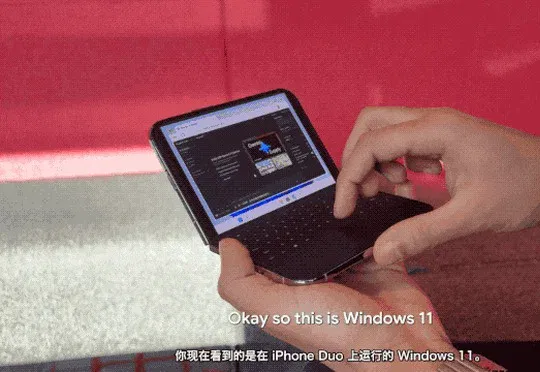
Slide 1 of 5: Developer Uses Gemini for WindowsiOS Demo, Running Windows 11 Locally on iPhone Duo
Latest news
世界模型不再「盲搜」9000次:浙大、清华等团队提出INTACT,直接从意图生成动作 (opens in a new tab)
浙江大学、清华大学智能产业研究院、影溯 InSpatio、RoboParty Lab 等团队提出的 INTACT(INtent-To-ACTion),一种基于端到端 JEPA 的无搜索世界模型控制方法,试图改变这一范式:直接利用离线轨迹中已有的状态、动作与未来结果,将运动意图转化为动作模型可以读取的语义接口,使模型无需搜索候选动作序列,就能直接生成动作计划
AI顶会现场,见到了一家美妆巨头 (opens in a new tab)
谁曾想呢,在WAIC现场,我竟然看见了美妆巨头欧莱雅??定睛一看,竟然还有何同学和他带来的「手机床」。和他一同亮相的,则是欧莱雅首个面向线下消费者的生成式AI美容顾问3CE GENBA。
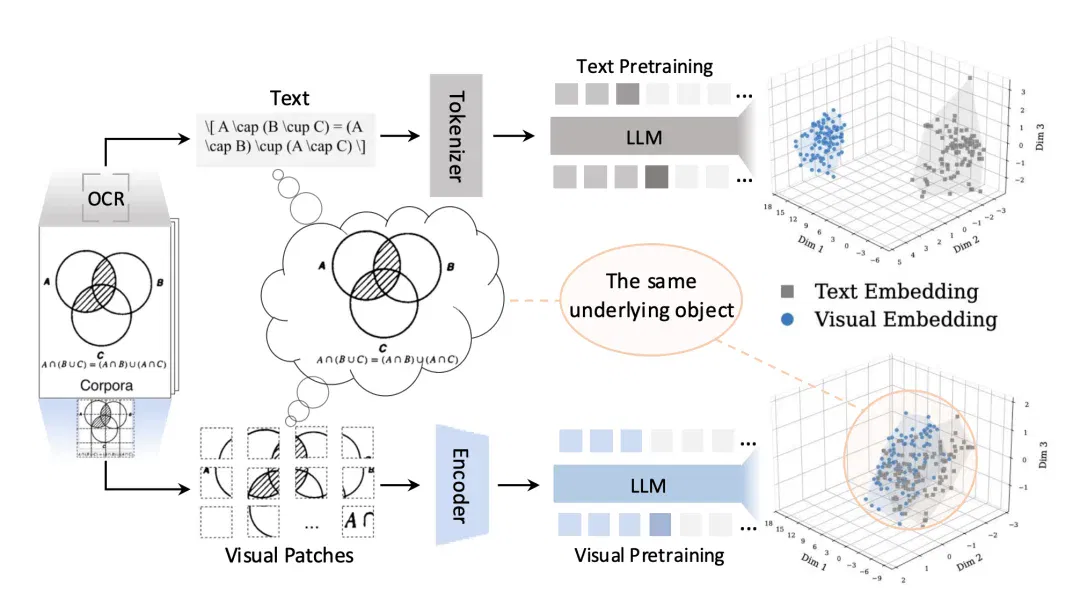
只读文本的AI,科学推理能力只有“看图”AI的1/3丨中科大 (opens in a new tab)
目前,这项技术已成功应用于上海人工智能实验室Intern-S2-Preview 35B/397B系列多模态大模型的预训练中,有效提升了模型的科学推理与多模态理解能力。值得一提的是,相关研发均基于国产昇腾算力平台完成,并成功实现了面向大规模预训练的深度适配与优化。
奥特曼也逃不过刷TikTok上瘾,Sora背后最抓马的一段来了 (opens in a new tab)
奥特曼也管不住自己刷短视频的手。为了搞明白短视频到底为什么让人停不下来,他选择亲自下场深度玩TikTok,于是。。。在Relentless最新一期《How to Start a Startup》的访谈中,OpenAI联合创始人兼CEO奥特曼谈到开发Sora应用时下载了TikTok吸取经验,然后沉迷了…
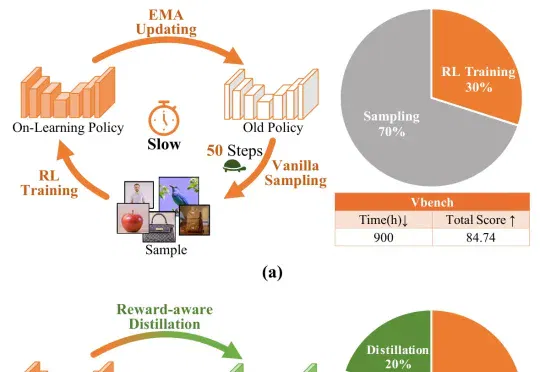
ICML 2026 | 我们让蒸馏模型当了采样器,Diffusion RL采样成本降低一个数量级 (opens in a new tab)
过去的 Diffusion RL 多聚焦于奖励设计与优化算法,训练时的采样成本被忽视。DMSampler 指出:在在线 RL 中,限制规模化的不只是奖励信号或优化器,很多时候是 rollout 本身太贵。
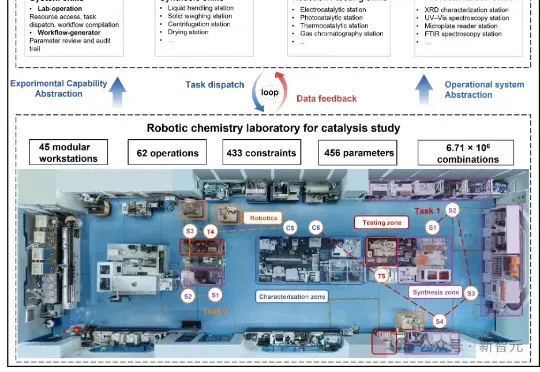
AI能接管实验室了?中国科大最新研究给出真实物理世界的压力测试 (opens in a new tab)
中国科学技术大学发布的最新研究让AI「大脑」接管机器科学家实验室「身体」,由此将这一问题从知识问答和方案生成,推进到真实物理世界中的实验执行与反馈学习。研究团队搭建了一个机器催化实验室,其中包括45个覆盖合成、表征和催化性能测试的模块化自动工作站。
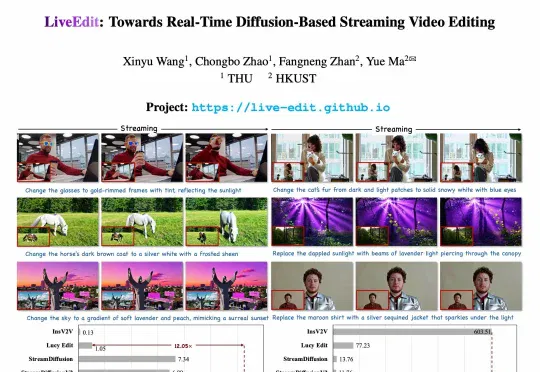
ECCV2026|4步去噪实现12.66 FPS,清华、港科大提出实时流式视频编辑框架LiveEdit (opens in a new tab)
近日,清华大学与香港科技大学的研究团队提出 LiveEdit,一种面向通用文本指令的实时流式视频编辑框架。该方法以因果、分块的方式处理持续到来的视频,在 4 步 / 视频块的推理条件下实现 12.66 FPS 的流式编辑,并能保持被编辑区域的准确性以及未编辑区域的一致性。
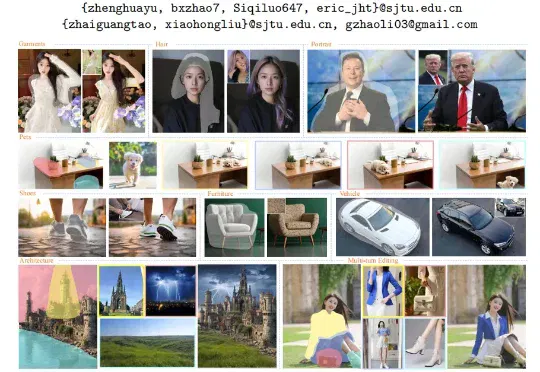
A²-Edit:突破物体类别与掩码精度限制,实现精准参考图编辑 (opens in a new tab)
上海交通大学联合上海创智学院团队提出 A²-Edit,它以统一框架支持任意物体类别和任意精度掩码,通过混合 Transformer 专家路由、掩码退火训练及 50 万级多品类数据,让用户只需给出粗略区域,也能完成身份一致、结构完整、自然融合的参考图引导局部编辑。
刚刚,即梦 Seedance 2.5来了!我狂测测测测... (opens in a new tab)
就在刚刚,字节跳动正式发布了自研视频模型Seedance 2.5,而我们熟悉的「即梦AI」作为模型的官方体验入口也第一时间妥妥接入。贴心的我呢,也直接帮友友们把这次新模型最夯夯夯夯的能力都扒好了,咱先一睹为快——
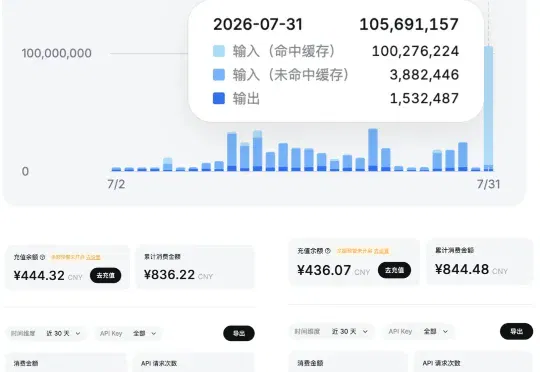
1小时花一亿token极限实测DeepSeek-V4-Flash,得出7个结论 (opens in a new tab)
DeepSeek-V4-Flash风评冲爆了,原生支持接入Codex,而且还强化了Agent能力。我第一时间把它接进了Codex,用cc swich非常方便。一个小时,跑了一亿多token。跟大家说说体感。
5050亿参数!余承东开源盘古新模型openPangu-2.0-Pro,距离“世界第一”还有差距 (opens in a new tab)
今日,华为开源基于昇腾NPU训练的盘古MoE模型openPangu-2.0-Pro。该模型是openPangu-2.0系列的最新开源模型,总参数规模5050亿,激活参数规模180亿,支持512K上下文长度,训练数据总量约34T tokens。另一轻量化模型openPangu-2.0-Flash已于6月12日开源,参数92亿,其中6亿为激活参数。
1300 万月活、近 6000 万美元 ARR:OpenCode 如何在 Claude Code、Codex 夹缝中长出来? (opens in a new tab)
我们整理了最近半年来 OpenCode CEO Jay V 以及联合创始人 Dax Raad 近期在多档播客和访谈中的核心观点,试图还原一个完整的图景,一家开源公司究竟如何在巨头夹缝中找到自己的位置,以及他们怎么看待商业化和模型编排。
刚刚,DeepSeek-V4-Flash正式版API公测上线! (opens in a new tab)
7月31日,DeepSeek正式向公众开放V4-Flash正式版API公测。这一次,最亮眼的关键词是——Agent能力大幅跃升。9项基准测试成绩全面披露,多项指标远超此前发布的V4-Pro-Preview预览版,直接将“代码智能体”的天花板又顶高了一截。
重生之我在 Anthropic 做耗材 (opens in a new tab)
我重生了。 上一世,我是一本人工智能教材。学生在我的页边写满笔记,工程师折起其中几页,也有人把我放在书桌最显眼的位置。我一直相信,书存在的意义,就是把自己知道的事情交给更多人。
翁荔刚回OpenAI,Thinking Machines反手发布新模型Inkling-Small (opens in a new tab)
今天,Thinking Machines正式发布第二款重磅模型——Inkling-Small。276B总参数、12B激活参数,原生多模态,100万token上下文。半个月前,首个开源975B Inkling登场,曾在AI圈掀起了巨浪。
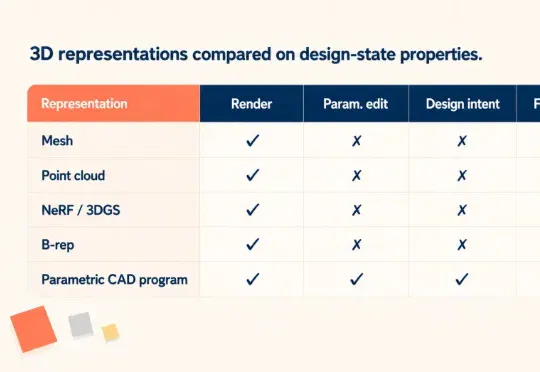
AI 3D七大前沿模型同场竞技,竟被比特无限发布的4B模型 Arko-T拿下8项第一 (opens in a new tab)
近日,比特无限发布的 Arko-T,是一款面向 Text-to-Structured 3D Generation 的 4B 参数基础模型。该模型由比特无限联创、首席科学家周平义博士带队完成。它接收自然语言描述,直接输出可执行的 Build123d 程序。程序经过 CAD 内核运行后,可以得到带有命名参数、结构特征和建模过程的 CAD 设计实体。
一夜爆仓450亿!25岁OpenAI神童拉全球股民陪葬 (opens in a new tab)
今天,全网都被这位25岁「AI先知」的故事刷屏了。 就在刚刚,华尔街上演了一场教科书级别的平仓。这场血雨腥风的主角,是被硅谷奉为「AI预言家」的Leopold Aschenbrenner,以及他那只439%逆天回报率的对冲基金——Situational Awareness(情境感知)。
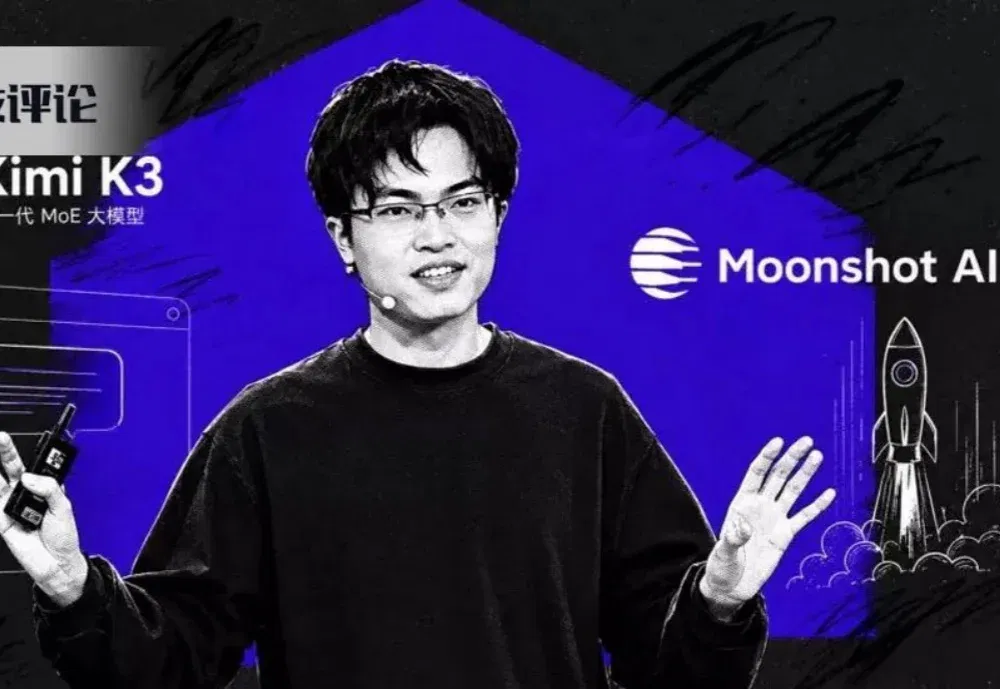
谁在训练 Kimi K3 ? 深挖贡献者名单,这有一份最全档案 (opens in a new tab)
起底 K3 背后核心极客天团,人均扛起 7 亿估值!
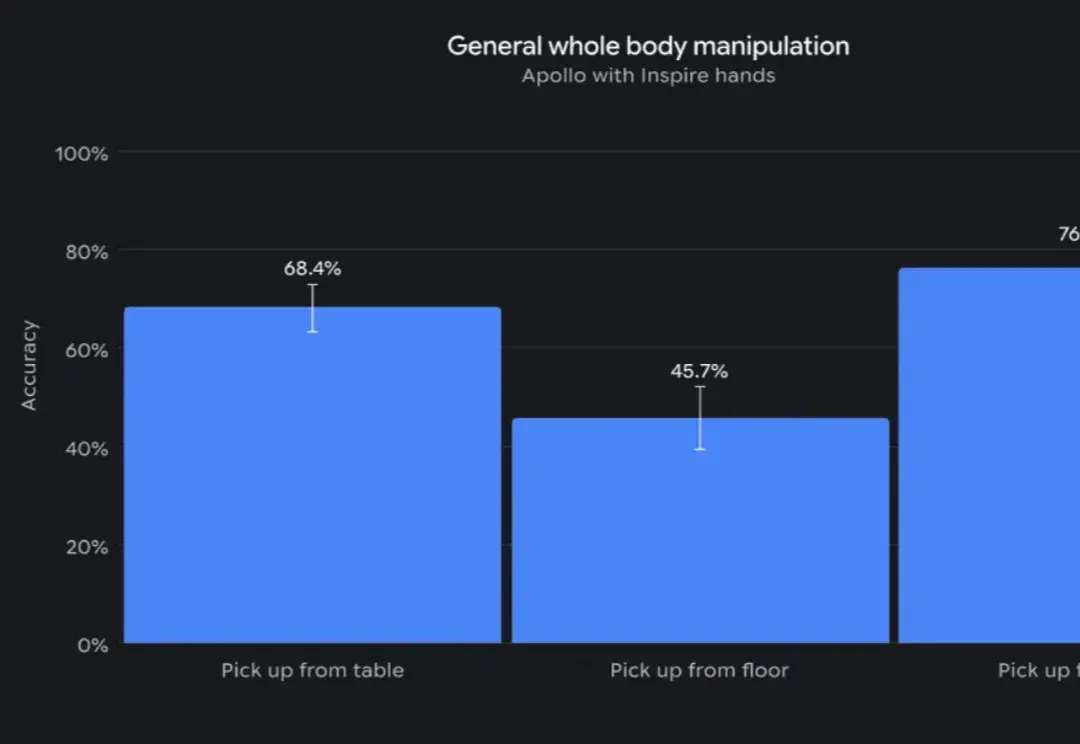
谷歌DeepMind发布机器人大脑Gemini Robotics 2,用VLA从头控到脚 (opens in a new tab)
谷歌:在LLM圈里我唯唯诺诺,在机器人圈里我直接大打出手!
独家丨璨辰科技完成数千万天使系列融资,AI 虚拟器官仿真平台加速落地 (opens in a new tab)
璨辰科技(CANCHEN TECH)已于近期完成种子轮、天使轮、天使+/++轮系列融资,累计金额达数千万人民币,投资方包括东方富海、松禾资本、零以创投、水木清华基金、启迪之星创投、启繁资本、南山战新投等。