OpenAI披露内部Agent使用:API标价折算用量约为研究员非股权薪酬两倍
OpenAI内部报告称,按API公开标价折算的Agent用量约为研究员非股权薪酬两倍;10月研究员日用量中位数为2400美元。任务完成率为内部估计,模型能力、使用方式与任务选择均会影响结果,不能直接等同实际成本或人力产出。
编者核对:2400美元是10月日用量API标价折算的中位数,2.3万美元是第90百分位;两者都不是实际内部成本。约两倍对应9月研究组织月度折算值与非股权薪酬,5.7个Agent工作日则为每研究员每日累计运行45.6小时,不等于人类成果。101人问卷为非随机的内部假设取舍,任务成功率也受委派选择影响;代码改动、实验数量和不同口径能力指数不能单独证明完整自主RSI。OpenAI内部研究加速原报告(在新窗口打开)
OpenAI的研究员,现在用AI已经用到什么程度了?
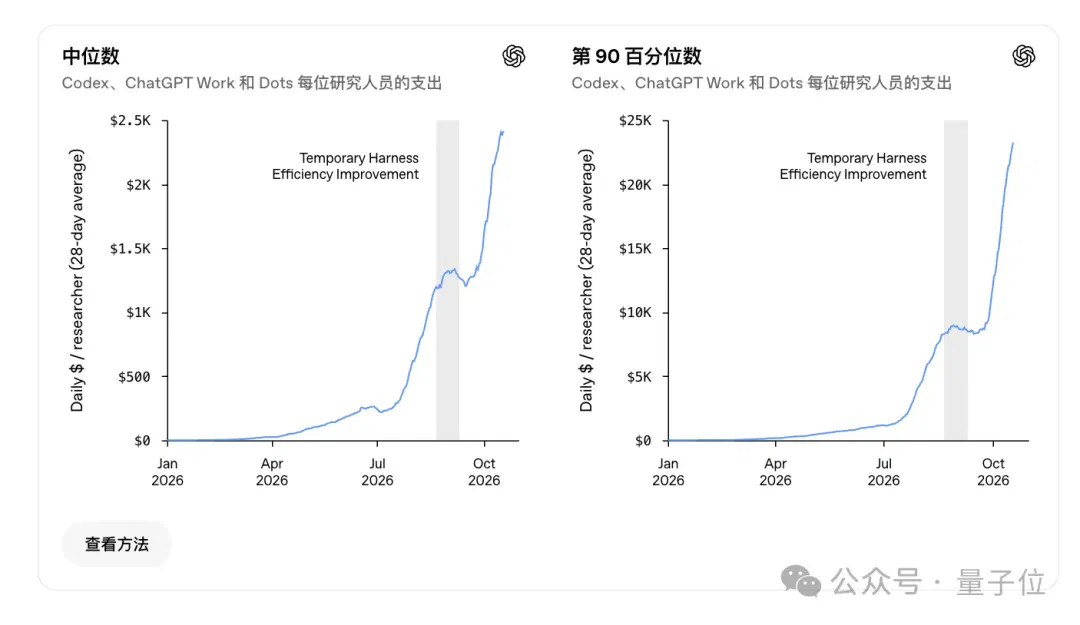
10月研究员每天调用Agent的用量,按API公开标价折算,中位数达到2400美元;这不是人均值或实际内部成本。
同一统计中,研究员单日用量按API标价折算的第90百分位达到2.3万美元(约16万人民币)。
嘶……这帮研究员用起AI来,是真一点都不心疼Token啊。
OpenAI公开了最新内部Agent研究报告《Research acceleration: The jagged frontier》,把自家研究员使用AI的情况扒了个底朝天。
先给朋友们来个一句话总结:
OpenAI估计,10月其内部委派给Agent、估计需人类2至4小时的研究任务中,46%可在无人干预下完成。该比例不是对任意研究任务的统一成功率,变化也可能受研究员选择委派何种任务影响。
今年3月,这个比例还只有23%;短短7个月,直接翻倍。
对于原本需要人类花4至8小时的研究工作,Agent自主完成率从13%升到了35%。
研究员们自己,已经离不开AI了。
OpenAI问了101名研究人员:
如果未来3个月不给你们用最前沿的Agent,你们愿意拿什么来换回使用权限?
在两个分别提问的假设取舍中,回答的中位数分别是团队40%的人力编制和30%的计算资源;这不是实际裁员或资源削减决定。
每研究员每日驱动5.7个Agent工作日
先看几个数据,感受一下这帮研究员用得有多狠。
从9月到10月,一个月时间:
- 研究员每天Agent用量的API标价折算中位数,从1500美元增至2400美元。
- 研究员日用量折算值的第90百分位,则从1.1万美元增至2.3万美元。
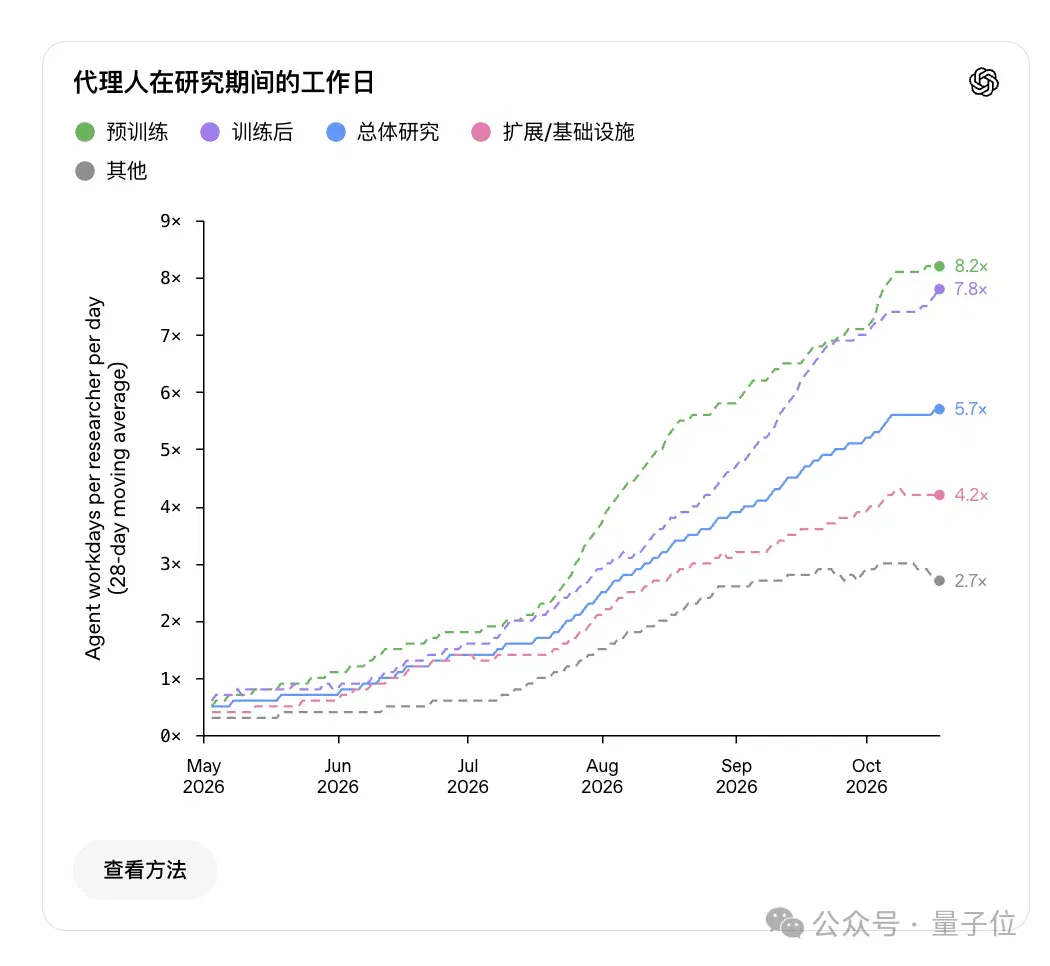
报告还专门计算了一个叫作「Agent工作日」的指标。
算法很简单:
Agent累计运行8小时,就算一个工作日。
按累计运行时长换算,每研究员每日平均驱动5.7个Agent工作日。
也就是每研究员每日约45.6小时的累计Agent运行时长,可由并发会话叠加;并不等于完成5.7个人类工作日的成果,也不等于6个Agent各自全天运行。
这个数字,是之前基准的整整11倍。
而且大家已经习惯了“群殴式”工作。
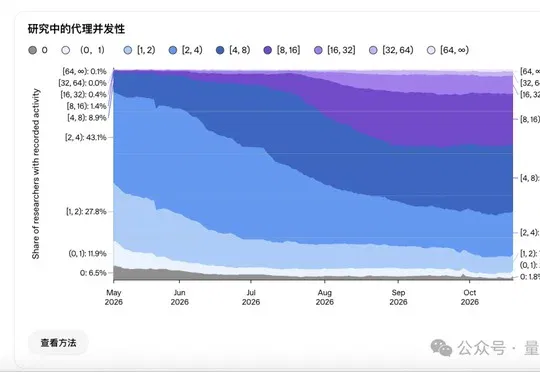
到10月中旬,纳入统计的研究员中,超过三分之二的日均并发峰值至少为4个Agent,超过10%的日均并发峰值至少为16个;这是每日峰值的平均,而非全天持续并发。
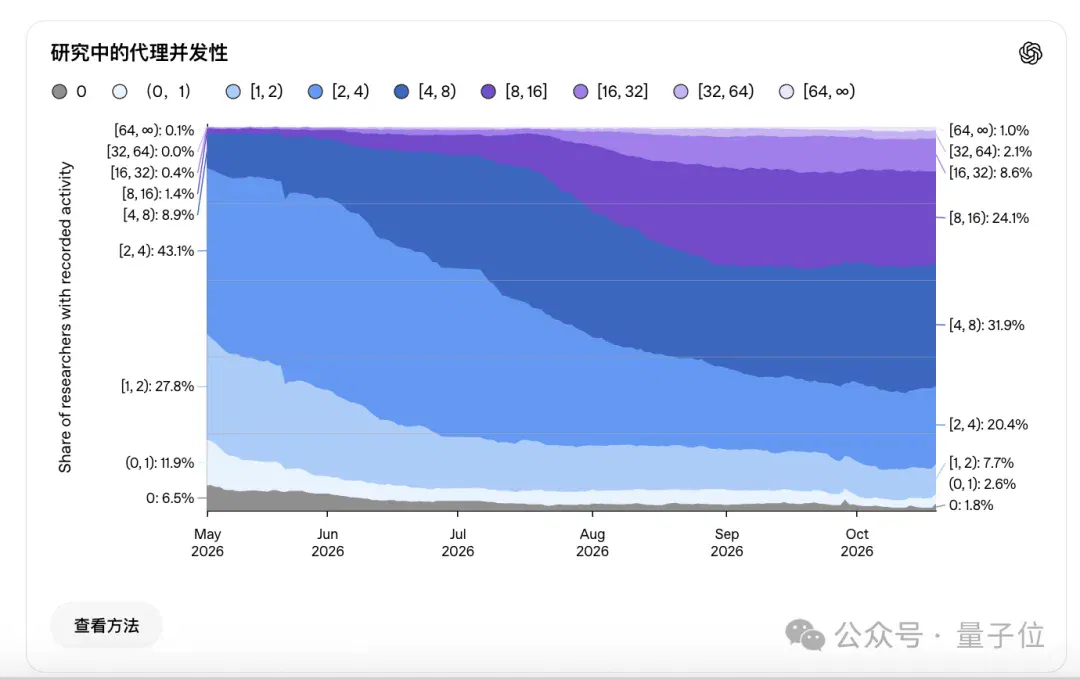
这还没完,报告里有个对比,杀伤力极强:
截至2026年9月,OpenAI研究组织Agent使用量的月度API标价折算值,约为研究人员月度非股权薪酬的两倍;不是实际算力成本与总薪酬的比较。
(虽然这薪酬没算股权大头,但也够吓人了……)
这一比值反映的是两种投入按特定口径折算后的相对规模,不能证明AI劳动力价值或实际成本效益已超过人类。
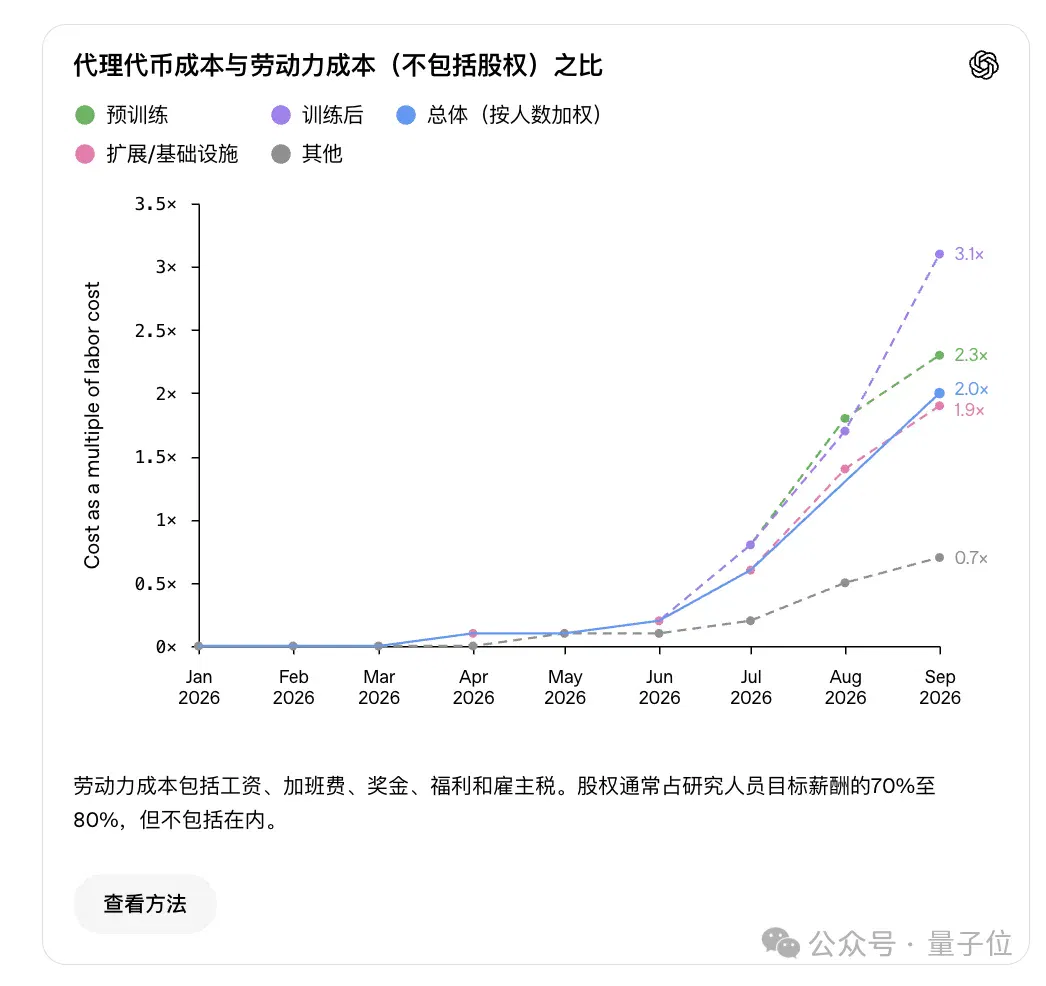
另一项问卷则反映研究员主观上如何评价Agent,而不是确认上述劳动力价值结论。
因为内部做了个调查,问他们一个诛心的问题:
如果让你三个月不能用最顶尖的编程Agent,你愿意牺牲什么来换?
中位数研究员的选择是:
- 在假设取舍中让出团队40%的编制。
- 或者,放弃团队30%的算力。
问卷把保留前沿编码Agent的使用权,与人力编制或算力的假设取舍进行比较——
这些回答不是公司已经决定裁员或削减算力的证据。
AI在干啥活?
在如此高的API标价折算用量与资源使用下,AI到底在做哪些工作?它真的能独立搞研究了吗?
这是最核心的问题,但答案是:The jagged frontier,参差不齐。
Agent在“沟通”(69%)和“分析”(58%)这类任务上表现很好,但在最关键的“构建”(43%)上就差一截。
说白了,让它查资料、跑数据、写邮件、监控实验,它很在行。
但让它从零开始搭一个复杂的系统,它就容易抓瞎。
数据显示,监控训练任务,成功率79%;但写推理和服务的代码,成功率就只有25%。
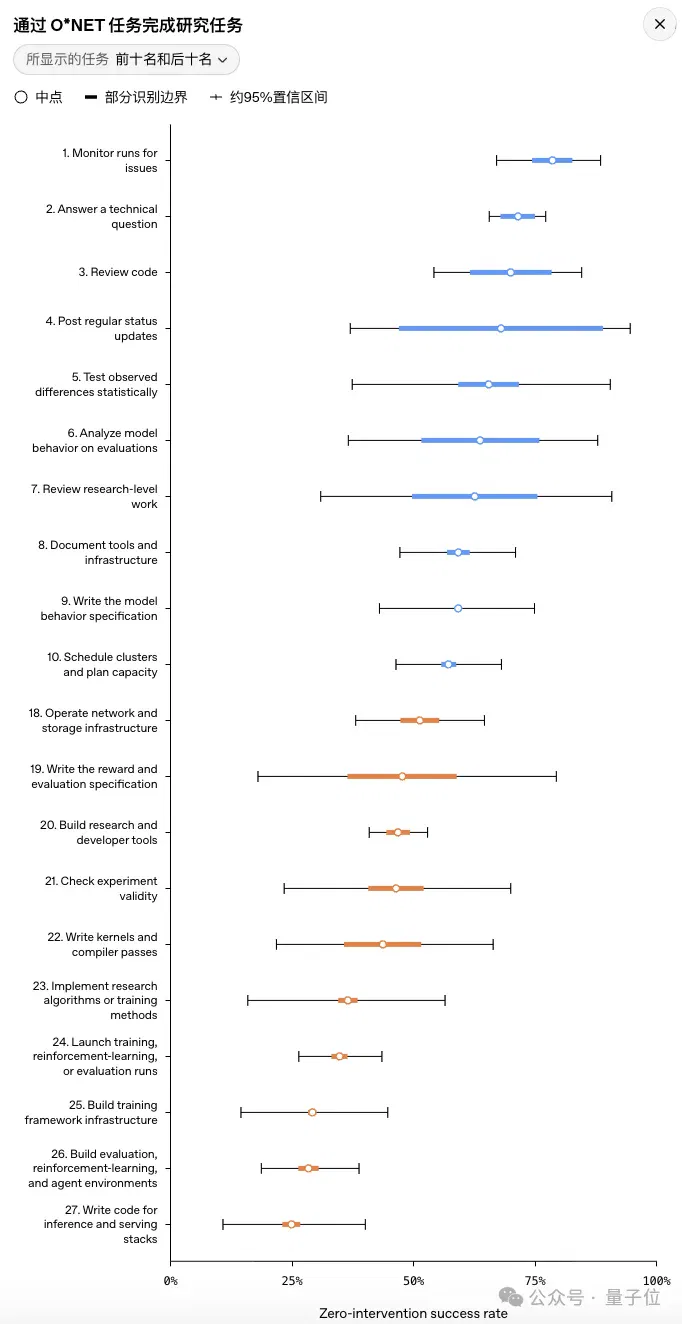
这背后暴露了一个关键问题,也是研究员在访谈里反复吐槽的:
AI Agent缺乏研究“品味”(research taste)。
模型通常无法一次性提出它自己解决不了的、定义良好的问题。
我试过让它‘就像那个任务一样做这个任务’,结果被坑了很多次,因为它做得总是不对,我得自己去改。
研究员的反馈很一致:
Agent是实现代码和调试的绝佳工具,但它自己提不出好问题,分不清代码的好坏,也看不出数据的优劣。
你必须像个监工一样死死盯着它,不然它分分钟给你产出一堆毫无价值的“AI废料”(AI slop)。
所以,人和AI现在的工作流是什么样的——
人类研究员负责提出想法、把握方向、定义问题、做出关键决策,以及最终的品控。
AI Agent则像一个能力被超级放大的“手”和“眼”,负责把想法快速实现、执行海量枯燥的测试和分析。
比如一个研究员说的,以前要评估一个开源项目好不好用,没一两个礼拜下不来。
现在呢?一天,最多几天,就能跑起来出结论。
AI现在就是这样一个角色,是顶级的“执行副驾”,但绝不是“首席科学家”。
当然了,这个边界也在模糊。
报告里就提到一个点,在研发GPT-6.2 Astra时,预训练团队首次将一个关键想法的产生,归功于和Codex的对话合作。
虽然想法是他的,但Codex提出了一个关键修改,才让整个方案跑通了。
AI真的在加速AI的诞生吗?
工作流重塑了,效率提升了,那最终产出呢?
这就是大家最关心的,所谓的RSI递归自我完善——
AI是否正参与加速自身研发?这与已经实现完整自主RSI需要区分。
报告提供了研究活动和能力进展变化的迹象,但这些趋势不能单独证明AI已实现完整自主递归改进:
- 代码改动:2026年,每个活跃贡献者的代码改动行数相较2025年前均值显著增加;改动行数不等于新增有效成果。
- 实验数量:截至10月18日的四周,每个活跃实验者记录的实验数量平均为2025年基准的1.68倍;这并不直接衡量实验质量或研究进展。
更接近模型能力结果的一项指标,是OpenAI内部能力指数OECI;它也不能单独确证进步由RSI造成。
自2025年8月以来,OpenAI模型的OECI前沿拟合趋势为每年提升16.4点,报告将其与Epoch此前观测的每年14点趋势对照;但两种指数的基准组合不同,不能视为完全相同口径。
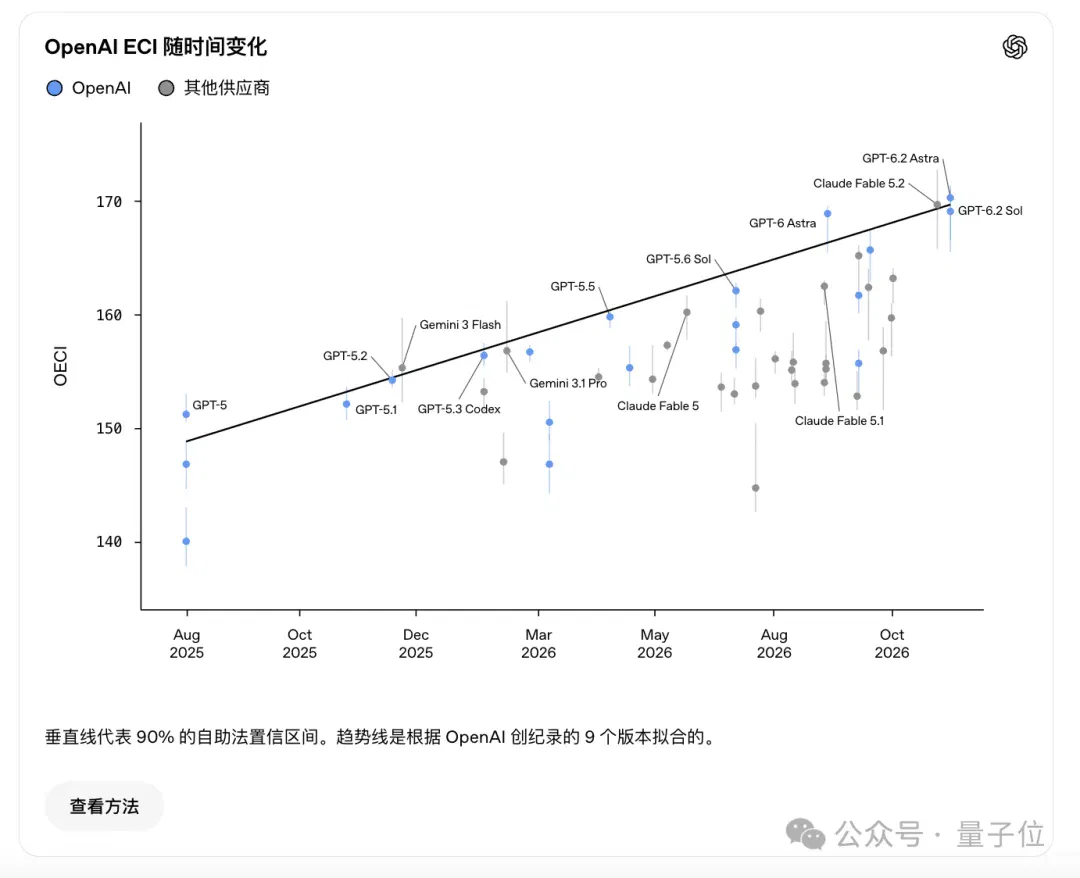
但OpenAI的报告最后还是保持了冷静。
他们强调,这种AI驱动的进展,可能不是线性的,需要警惕像最近在数学领域发生的那种突发性、跳跃式的突破。
最后,报告里还有一个数据,也很有意思。
按报告对记录工作周的分类,哪个研究领域的人力投入绝对增量最大?
不是预训练,不是多模态——
是安全与对齐(Safety and Alignment)。
这个领域记录工作周的绝对增量,在报告所列主要研究方向中最大,并不等于其百分比增幅在所有方向最高。
大量的研究员,无论是新招的还是内部转岗的,都在涌向安全项目。
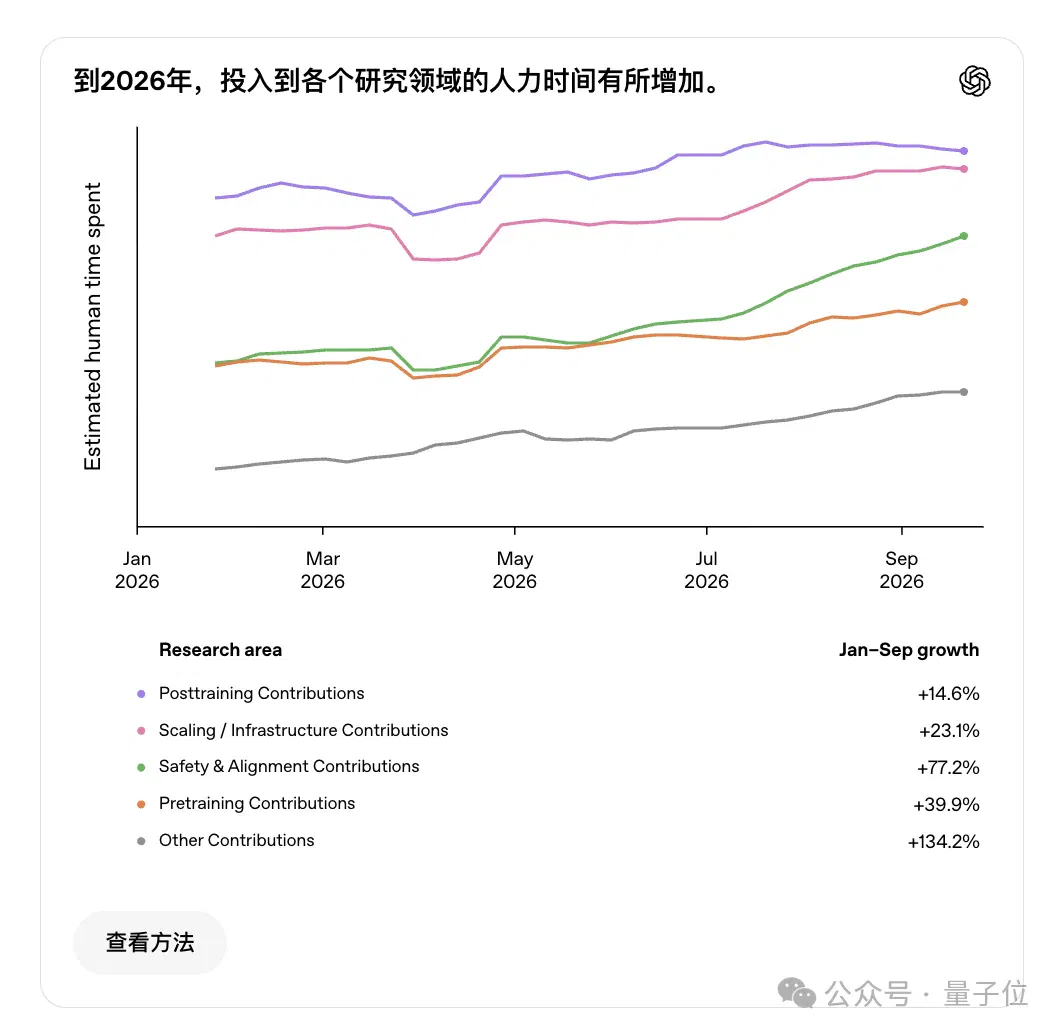
一边是AI加速参与自身研发,一边是人类加紧研究如何让它保持安全可控。
「崎岖的前沿」,不仅是技术能力的参差不齐,或许,也是我们这个时代,一边踩油门、一边找刹车真实写照。
原报告:https://openai.com/index/research-acceleration-jagged-frontier/
文章来自于微信公众号 “量子位”,作者 “量子位”
相关主题
读完之后
加入 AINRK 交流群
了解加入交流群的方式,与更多 AI 从业者交流。
相关文章
继续阅读相关主题与同栏目内容。
Vals AI:Astra用94分钟形式化既有Smoktunowicz间隙定理(在新窗口打开)
Vals AI报告,GPT-6.2 Astra在Autoform-Hard评测中用1794行Lean代码完成Smoktunowicz既有定理的形式化证明。论证部分区别于2006年证明,但新路线与既有文献的关系仍待进一步核对。
ChatGPT逐步推出实时听写,取消10分钟录音限制(在新窗口打开)
OpenAI宣布向各ChatGPT套餐的移动端、网页和桌面端逐步推出Live Dictation,支持边说边显示文字并取消10分钟录音限制。同期发布的Sales插件可连接销售工具,具体能力仍取决于授权、套餐、地区和工作区设置。
OpenAI推进嵌入式安全评估,审查模型训练与内部使用(在新窗口打开)
报道讨论奥特曼对递归自我改进与人类控制权的态度,并梳理OpenAI与Apollo Research、METR、Transluce、Goodfire的评估合作,包括模型内部访问、结果披露限制与监督边界。
作者报告精简OpenAI公开证明:三个Lean文件减少约34%代码(在新窗口打开)
作者介绍数学思想评测与数据管线,并报告在人机协作重构第328号公开证明时,三个相关Lean文件去掉空行和块注释后由232行减至153行。作者称改动接回原工程后通过Lean检查,泛化与训练增益仍待更大评测。
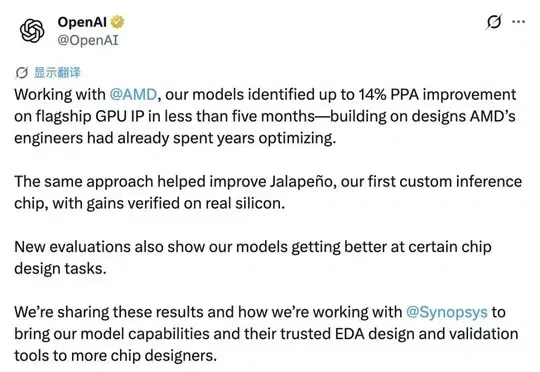
OpenAI称与AMD优化GPU RTL获最高14%改进,成品效果待披露(在新窗口打开)
OpenAI称模型修改AMD GPU的SystemVerilog RTL设计,找到最高14%的优化空间,部分修改已纳入送交制造的设计。文章强调,这不等于成品芯片效果已验证,具体功耗、性能与面积权衡仍待进一步结果,也不等于已实现完整RSI。