无界方舟开放 Edge0-145B 与推理引擎,探索笔记本本地运行
团队披露稀疏架构、分层存储及测试中的内存和速度,并展示编程与三维创作;实际表现取决于硬件、上下文及工具配置。
编辑更正(2026年11月16日)原文部分配置与当前官方模型卡不一致,已按版本和测试条件修正。29GB并非任意电脑的总资源需求,离线推理不代表零总成本或自动合规。参考:https://huggingface.co/Edge0/Edge0-145B-NVFP4 。 模型权重另受Edge0及上游社区许可约束,部分商业服务需要另行授权,不能把框架开源等同权重无限制商用。
可以 Vibe Coding 的千亿参数端侧模型。
2024 年,苹果尚未正式公布 Apple Intelligence,关于哪家模型企业能成为苹果在中国的 AI 合作伙伴,一度成了给国产大模型排座次的隐形榜单。这个榜单上,百度、阿里、腾讯、字节跳动的名字都曾陆续被提及。到 2025 年 2 月,阿里一度因为确认参与合作,当天港股盘中大涨 9.2%。
AI 尚未真正落地端侧,市场就已经为它写好了 Make Mobile Phone Great Again 的新剧本。
直到 2026 年 10 月底,苹果终于公布国行版本的上线安排。那个能理解复杂需求、替用户四处办事的升级版助手新一代 Siri AI 仍遥遥无期,首批交付的写作、翻译、照片处理等功能也并未超过传统端侧 AI 的射程范围。
大模型已经渗入工作生活方方面面的当下,苹果为什么又跳票了?
内存墙,是绕不开的答案。
模型运行需要可访问权重,但不要求全部参数始终常驻同一级内存;量化、稀疏计算和分层存储会影响内存、显存、磁盘及带宽需求。
这也是为什么云端模型发展已经一日千里的情况下,端侧模型还依然困在智能、内存与 IO 之间的不可能三角中反复取舍。
一个端侧模型,想要高智能,又不想让权重常驻挤占内存,就要靠稀疏激活、按需加载,代价是 IO 带宽被持续消耗,一个最简单的问题,可能需要几分钟时间才能回答。
端侧部署需要权衡模型能力、存储、内存、带宽和延迟,具体取舍依赖实现,不能由这组描述推出小模型智能上限已被锁死。
但端侧模型的上限真的就此被锁死了吗?
一个名叫无界方舟的公司,提供了新的破题思路。
千亿参数,
探索千亿规模模型的本地运行
团队此前发布Edge0-35B,探索通过稀疏激活和按需加载降低活跃内存需求;这里没有足够依据认定为行业首次。
按照官方测试数据,Edge0-35B 在适配的手机上,峰值运行内存约为 2.5GB,生成速度超过每秒 37 个 token。
也就是说,模型仍然保留着 350 亿参数的规模,但设备在某个时刻需要留在内存里的,只是其中的可以被快速激活的一部分。其余权重存放在设备的存储空间中,由推理框架提前准备、按需调入。
成绩加持下,Edge0-35B 发布不久,在海外社区未投放的情况下,帖子当天的阅读量就突破 120 万,来自 OpenAI、NVIDIA、高通等公司的多位技术专家和研究员纷纷转发,模型随即登上 Hugging Face 全站 Trending 榜第一。
模型权重与推理框架应分别核对许可。当前Edge0模型受社区许可及上游条款约束,商业打包、模型服务和独立商业编程或办公助手等场景需要另行书面授权;框架代码的开源许可不自动覆盖这些用途。
如果说过去的思路是手机只能装下小模型,Edge0-35B 尝试回答的就是:能不能让手机每次只装下大模型当前要用的部分,同时把等待压到足够低?
沿着这条路线,无界方舟又把端侧模型规模推到了 145B 的千亿规模。今天,Edge0-145B 已经在 Hugging Face 开放模型权重,全新的端侧统一推理引擎也在 GitHub 开源,并提供一键部署工具与完整硬件适配指南。借助该模型,可以实现:写代码、操作软件、搭建三维场景,以及围绕一个目标连续规划、执行和修改等等过去主要依赖云端模型完成的复杂任务。
当前官方文档区分平台和格式:Q3_K提供Apple Silicon macOS的Metal路径,NVFP4为CUDA构建;Linux和Windows支持也依赖对应硬件与构建。不能把平台列表理解成所有电脑均可直接运行。
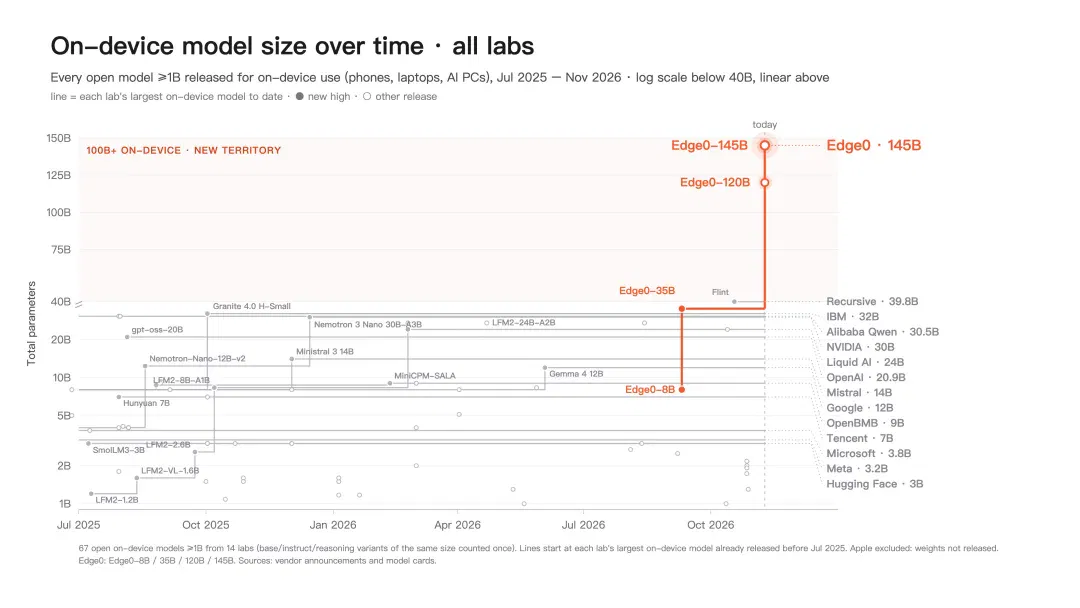
图示为团队对端侧模型规模与能力演进的介绍,不足以证明其为第一个可本地运行的千亿参数模型。
该版本展示了本地模型的部署与任务能力探索。所列性能需按具体权重格式、硬件和工作负载理解,不能宣布端侧模型首次整体追平云端。
- 内存与显存应分开核算。当前官方NVFP4示例在RTX 5090 D上启用驻留时使用约23.25 GiB显存与38.27 GiB主机内存;原文29GB不能作为所有平台的总资源保证。
- 预填充吞吐量不等于首字即时出现;输入长度、模型加载、缓存、硬件与调度共同影响等待时间。
- 解码速度应限定所测硬件、量化格式和上下文条件,不能保证所有个人笔记本都达到每秒80个token。
- 长时间运行的功耗、散热和降频情况取决于设备及负载,不能由一次典型功耗数值作出普遍保证。
- 模型卡列有长上下文配置,但长输入会改变缓存、访存和执行成本,不能保证长任务速度不衰减。
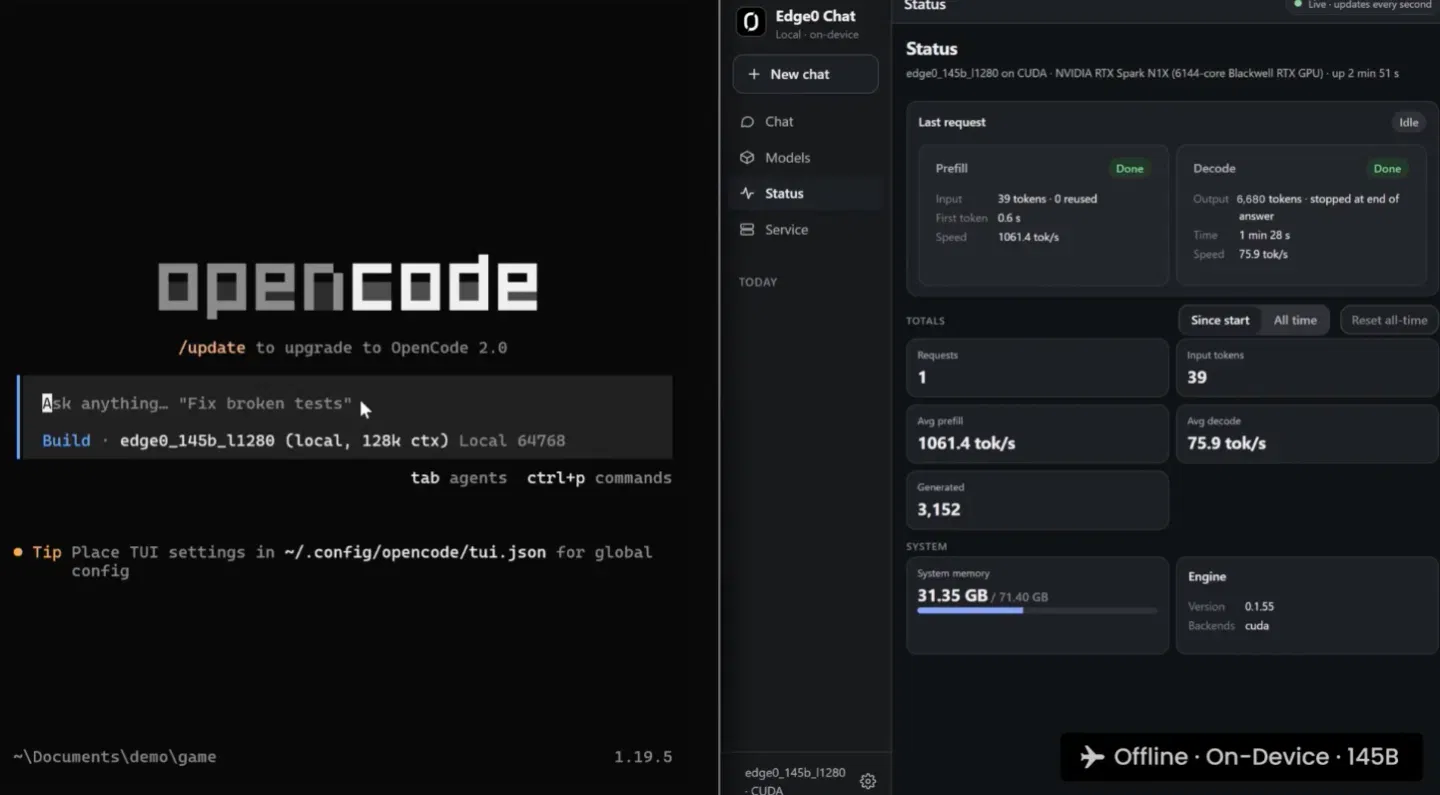
不同型号和硬件的吞吐及内存不能直接类比;请按目标格式、设备与任务核对资源需求,原文手机与笔记本数字不构成同条件对照。
千亿模型,
如何从端侧可用到端侧好用
解决了可用问题后,一个新的问题随之而来。
一个千亿参数模型,即使能在本地加载,但用户真的愿意用吗?
把模型启动起来,只解决了第一步。几十页代码输入后,要等多久才能开始回答?生成速度能否跟上阅读?任务持续半小时,设备会不会因为发热而降速?模型跑着的时候,其他软件还能不能正常工作?
这些问题,直接关系着实际的用户体验。
无界方舟的解法,是同时调整模型结构、权重存放方式和计算调度。
当前官方版本描述为latent稀疏MoE,包含路由专家、共享部分及嵌入等组件,标注总参数145B、每token活跃约10.12B。架构与参数计数需按具体版本核对,不能沿用原文6.6B作为当前统一配置。
架构确定之后,就是根据架构以及端侧的需求,做针对性的模型训练。
在此之后,是解决加载难题。稀疏架构只减少了计算量,没有自动解决权重放在哪里、需要时如何及时取到的问题。一个专家即使暂时不用,它的参数仍要占据某处存储空间。
Edge0-145B 的选择是让不同层级的存储各司其职:经常调用的部分尽量留在更快的显存里,其余部分分布在系统内存和 SSD 中。模型一边计算,系统一边准备后续需要的数据,尽量减少算完一步再等下一批权重的空档。
最后一步,是调度,让 CPU 和 GPU 协同工作,再通过投机解码,一次提出、验证多个候选 token,把部分计算与读取开销分摊到更多输出上。
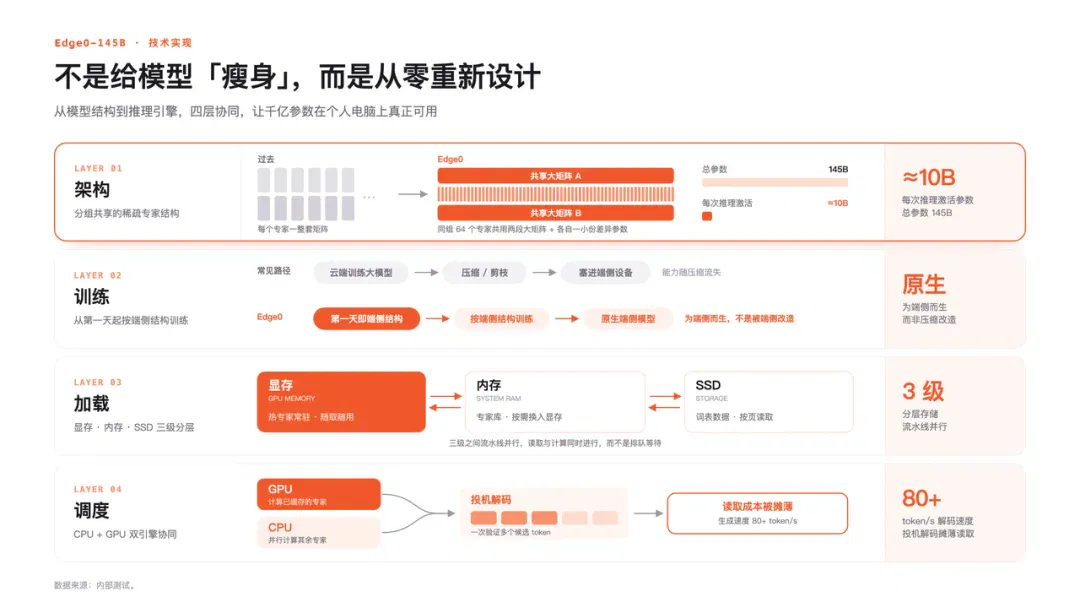
通过这几步的优化,千亿模型被加载到端侧设备以及流畅高效运行不再是难事,而接下来它要回答的,就是这款模型,究竟能做多少事。
从能聊天走向能干活
千亿模型部署到端侧如果只能断网聊天,那么无非只是个用于秀肌肉的摆设,能真正独立完成复杂任务才是真正的目标。
无界方舟公布的六项主流评测中,Edge0-145B 在 DeepSWE 1.1 64.6、Terminal-Bench 2.1 86.5、HLE 35.4、GPQA-Diamond 90.4、IFBench 80.6、AA-LCR 79.3,综合水平与 DeepSeek-V4-Flash 等主流开源云端大模型处于同一档位。它的强项在智能体与编程。在 DeepSWE 和 Terminal-Bench 这两项智能体编程评测上,Edge0-145B 超过了同档位的开源模型;在 Terminal-Bench 2.1、IFBench 和 AA-LCR 上,它的得分还高于云端闭源模型 Claude Opus 4.6(Max)。
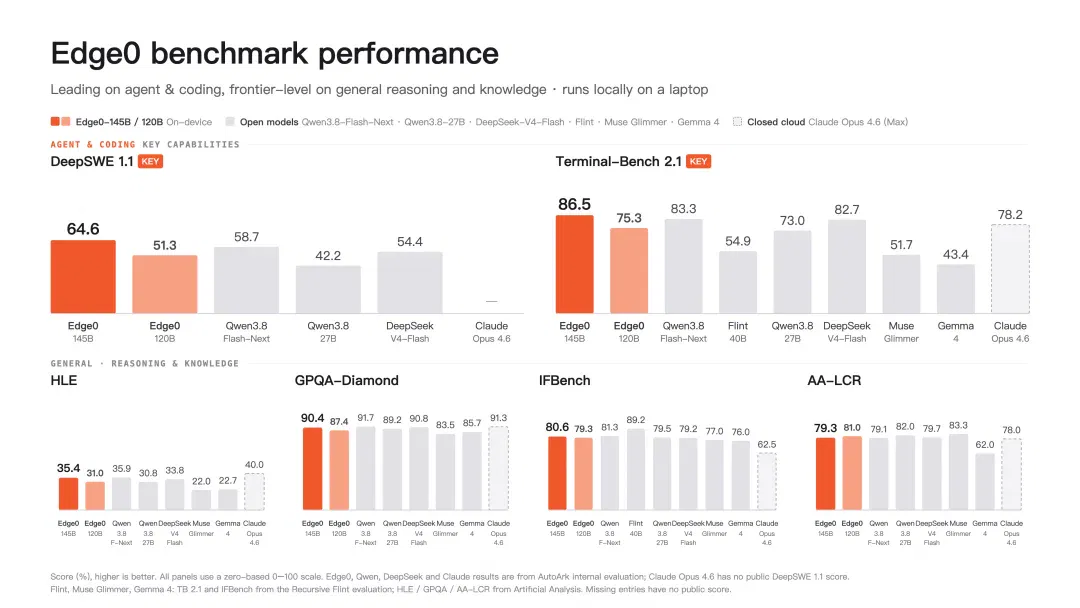
图示比较的是所列评测配置;单项分数不能证明端侧模型首次整体达到云端顶级模型能力。
与百亿参数水位的主流端侧模型相比,Edge0-145B 在智能体与编程任务上的提升最为明显:Terminal-Bench 提升 18.5%,DeepSWE 提升 53.1%;在推理与知识类任务上也有 1%–15% 的提升(HLE +14.9%、GPQA +1.3%、IFBench +1.4%)。完整的测试设置、硬件环境与复现方式,随技术报告一同公开。
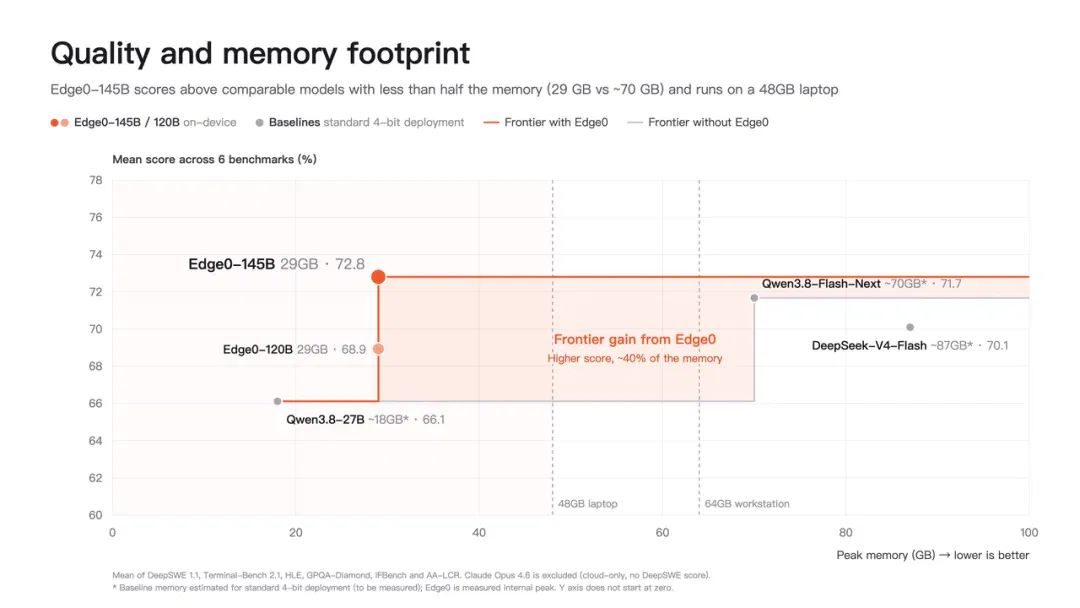
本地运行还需计算显存、主机内存、权重磁盘空间与缓存,不能将一台48GB笔记本作为无条件部署保证。
但 benchmark 只是能力的切片,真实世界要求模型把事情做成。
Vibe Coding 正是检验模型真实水平的一个试金石。借助 Edge0-145B,用户只需要一句自然语言指令,模型就会在本地完成整条工作链:先拆解需求、规划步骤,再编写代码、调用工具运行,遇到报错自己调试修复,最后截图检查画面效果,不满意就继续改,直到交付一个完整可用的作品。整个过程往往包含几十轮规划、执行和自我检查,这正是过去只有云端大模型才能胜任的长链路智能体任务。
本地模型可减少云端推理调用,但工具、调研、素材和外部服务是否联网取决于实际配置;不能保证整套任务断网可用或所有数据均不离机。
比如,这是让Edge0-145B生成一个讲解 Roadster 的视频,向大众科普汽车为什么能飞。在该任务中,Edge0-145B 能独立完成技术原理调研、脚本撰写、素材生成与创意剪辑。没有云端调用,没有云端 token 消耗,也没有网络延迟。
本地推理可以减少按token收取的云服务费用,但设备、能耗、存储、工具和人工检查仍有成本;演示耗时不能代替专业成品的同条件成本比较。
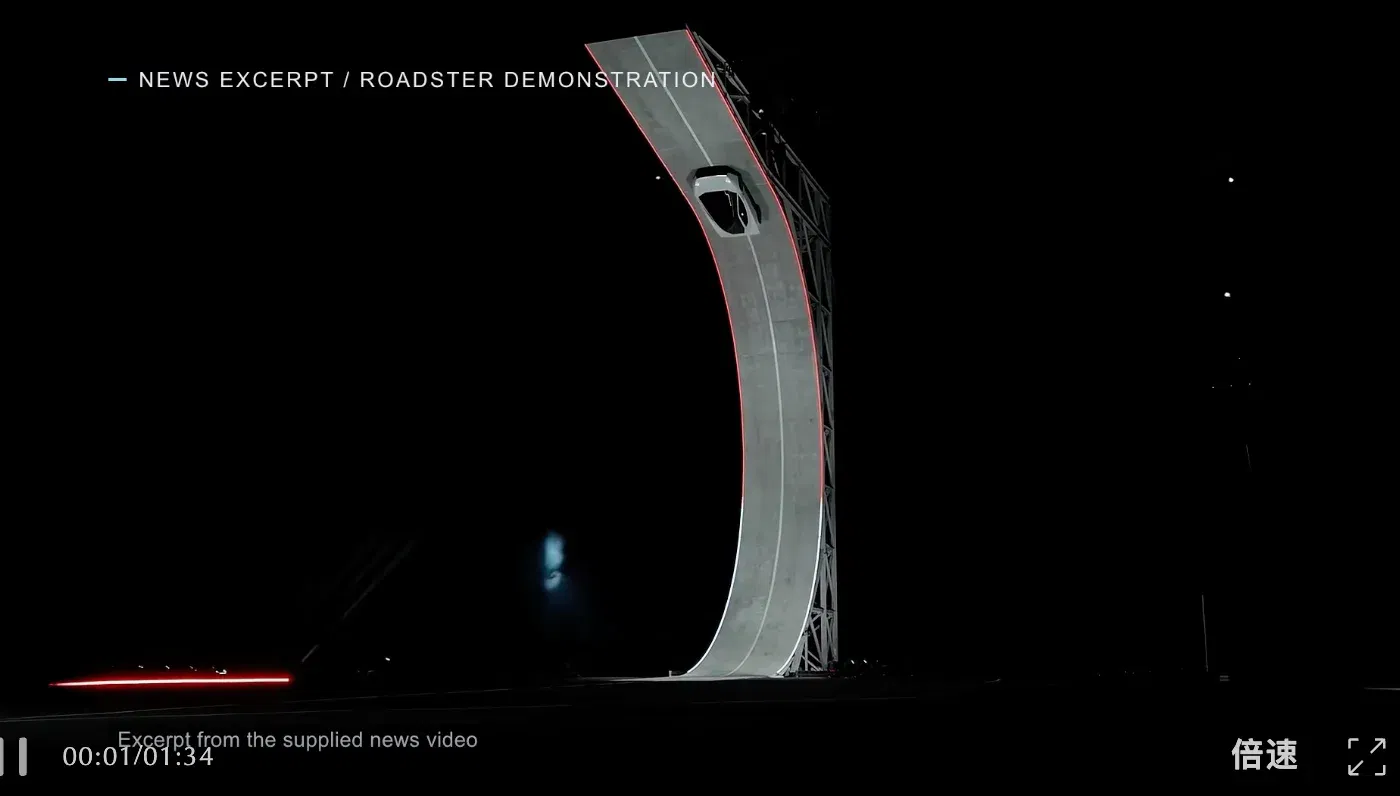
同样的能力,也被用在了三维场景创作中。
在 3D 创作场景中,Edge0-145B 可以操作 Blender,从文字和参考图出发建立场景、调整材质与灯光,并依据渲染结果持续迭代。我们让它生成曼哈顿的城市建模,它看到的不只是像素,也能理解物体、空间关系和创作目标。过去由人工看画面、人工写代码、再人工修改的断裂流程,现在模型在 Blender 里把三个步骤直接渲染完成,全程不离开本地。
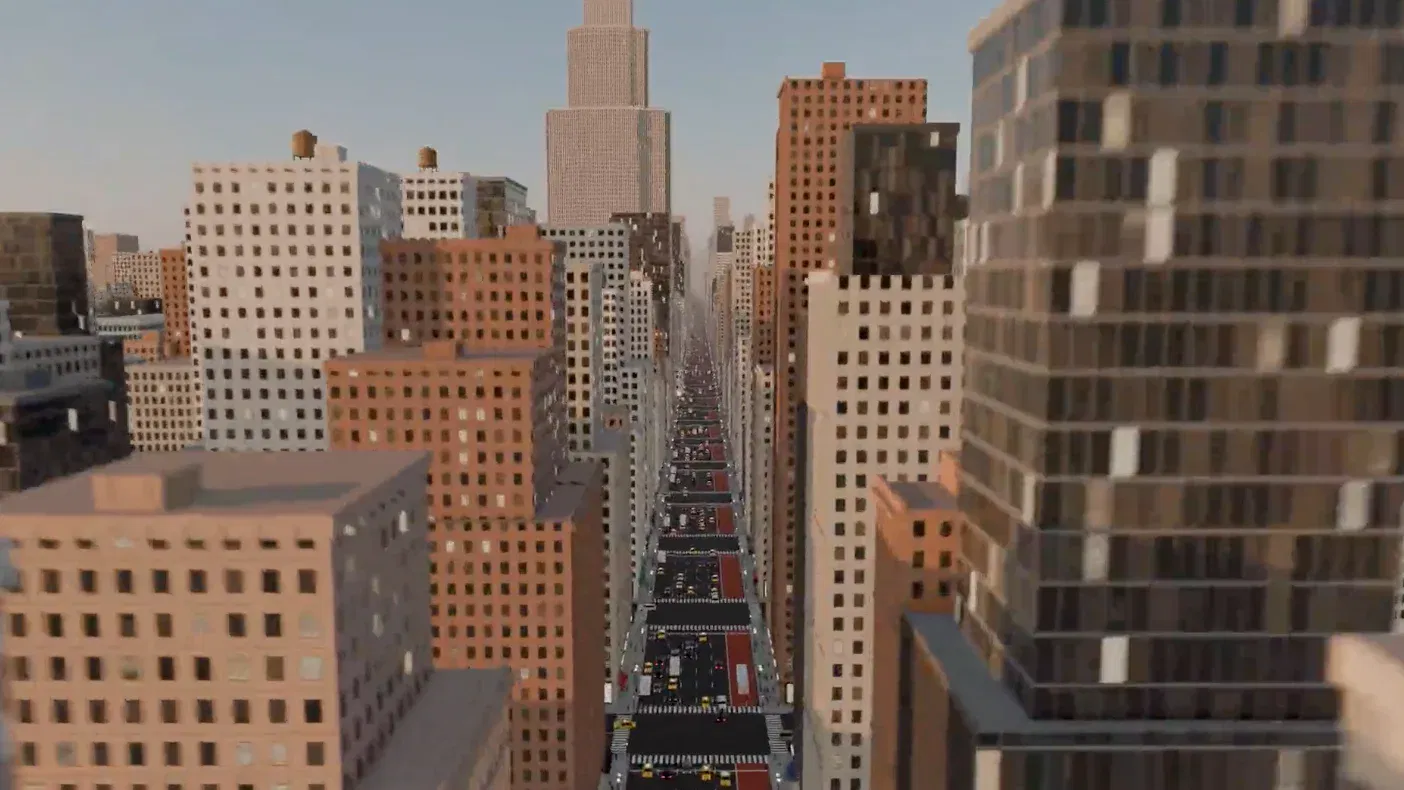
这段三维演示不能证明与人工成品具有相同质量、范围与交付责任;本地运行减少部分云调用费用,不代表三维制作总成本为零。
在 3D 建模的基础上,Edge0-145B 还能直接为游戏搭建一整座世界。我们给了它一份游戏宣传片级别的需求:为一款奇幻 RPG 搭建一座原创的中世纪主城,并渲染一段 20 秒的飞越镜头。在这个任务里,Edge0-145B 自主规划了整体设计,在 Blender 中从零搭建城墙、上千栋老城民居、广场喷泉、哥特式双塔立面、肋拱顶中殿和彩窗,最后按照固定的镜头路线完成渲染。类似场景中,任何一处穿模、遮挡或比例失调,都会在镜头里暴露无遗。但它能一边建模,一边检查渲染画面、自行修正,全程不离开本地。
对照成本应同时公开模型版本、输出质量、工具调用与缓存计数等条件。原文未提供足以独立复算全部费用的材料,不能据此保证所有同类项目零成本或固定节省幅度。
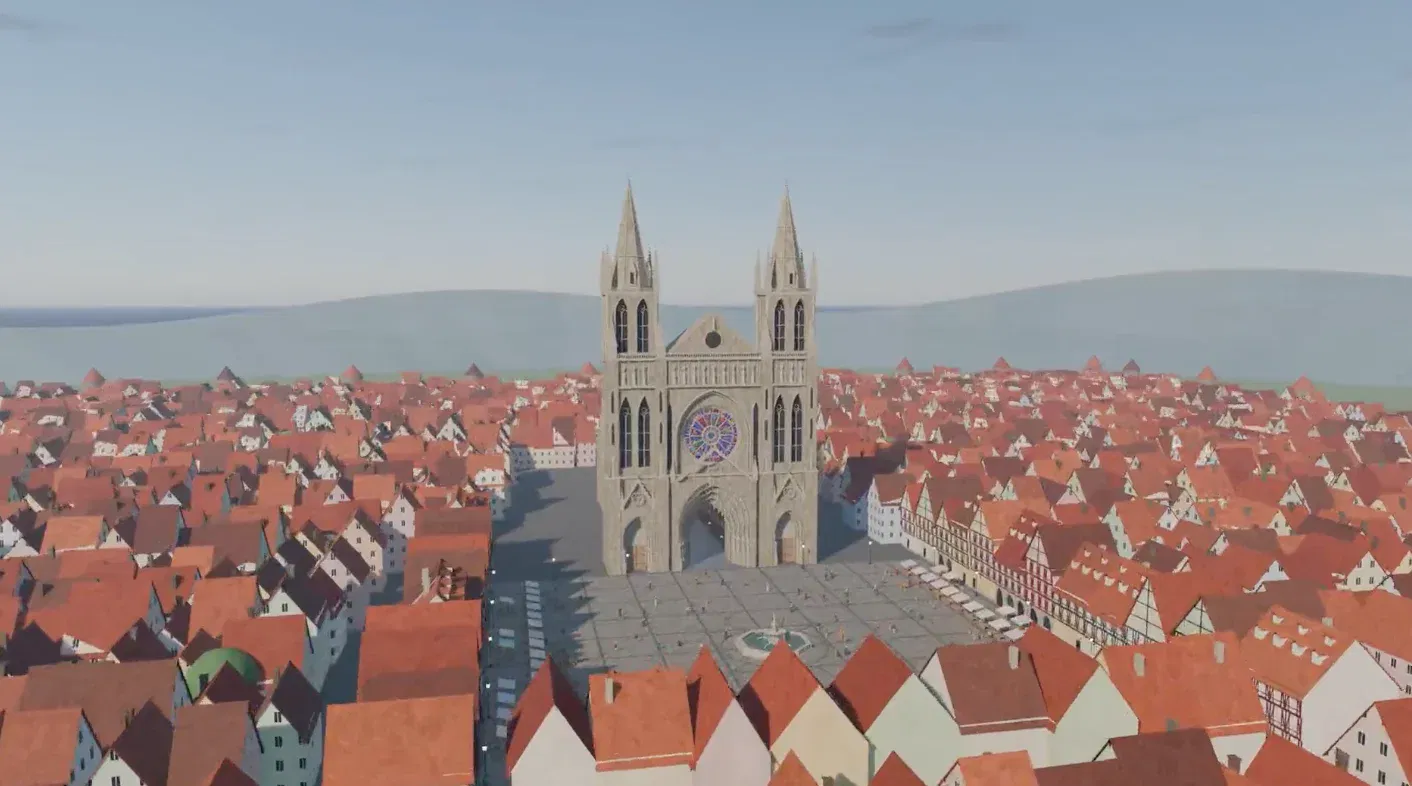
这条链路还可以延伸到硬件开发。
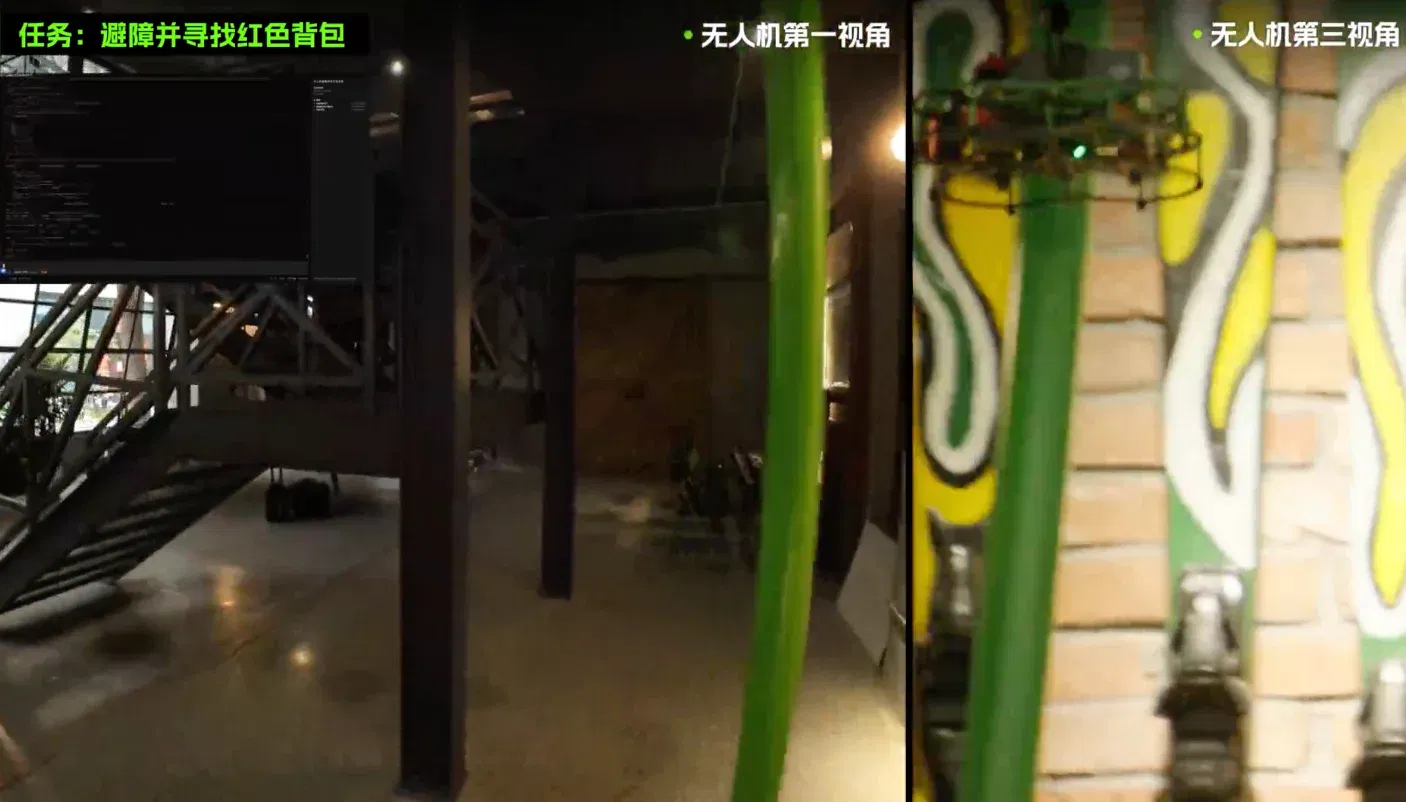
在无人机案例中,团队向模型提出的要求是:「编写一个无人机程序,穿越障碍,寻找一个红色背包。」随后,我们看到了模型生成飞控与视觉识别程序后,无人机在室内穿过障碍,并定位到了目标。
除了视频、3D 建模和游戏,我们还测试了更高难度的任务,走进硬件工程师的工作台,从零到一设计一块 PCB。在 PCB 案例里,模型需要同时理解并使用两类软件:先在 KiCad 中完成元器件布局与双层走线,再把电路板导入虚幻引擎 5,设置镜头和灯光,生成制造与组装过程的展示动画。
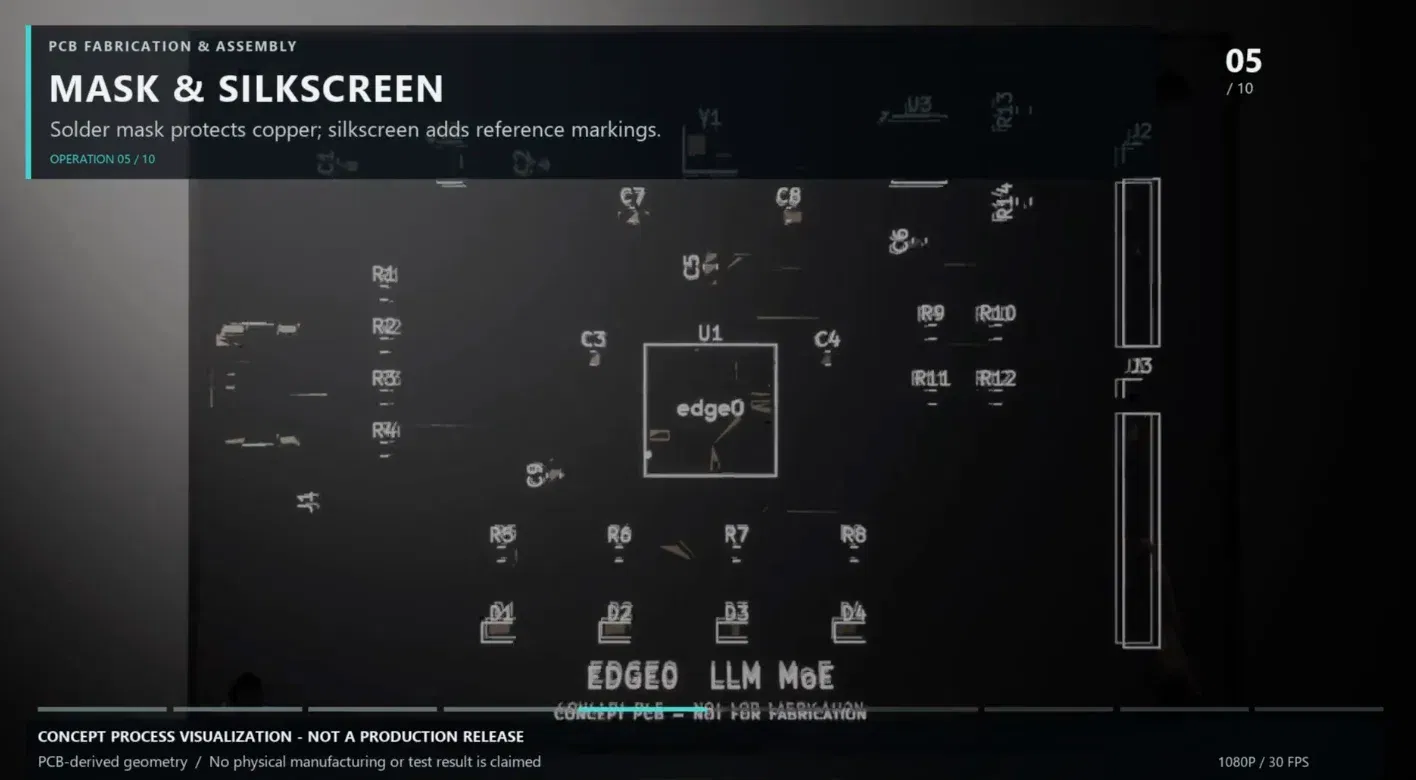
本地部署有助于减少数据传输,但还需检查工具联网、日志、权限、依赖和数据处理流程,不能自动保证保密或合规。
为什么是无界方舟
端侧模型不是新赛道,海外已有多家估值数百亿人民币的 Neo Lab 在做,论文不少,但真正能在消费硬件上跑起来的端侧模型却少之又少。
落地端侧,这需要模型企业不能只交付一份模型权重。它还要回答:模型在什么配置下运行,调用多少内存,怎样与系统里的其他任务共存,以及硬件厂商如何把它接进自己的产品。
而这也是无界方舟的优势所在:
其一是完整的模型产品线配置。过去一年,无界方舟发布了一共四个模型家族、200 款模型可以像人脑一样分工协同:Audio8 语音模型负责听与说,Decision0 决策模型负责快思考,约 40 毫秒就能做出判断;Edge0 端侧大模型,负责复杂智能体任务和 Vibe Coding;Embedding0 向量模型负责记忆。参数从千万级、百亿级到千亿级,一路把端侧的智能上限向上突破。
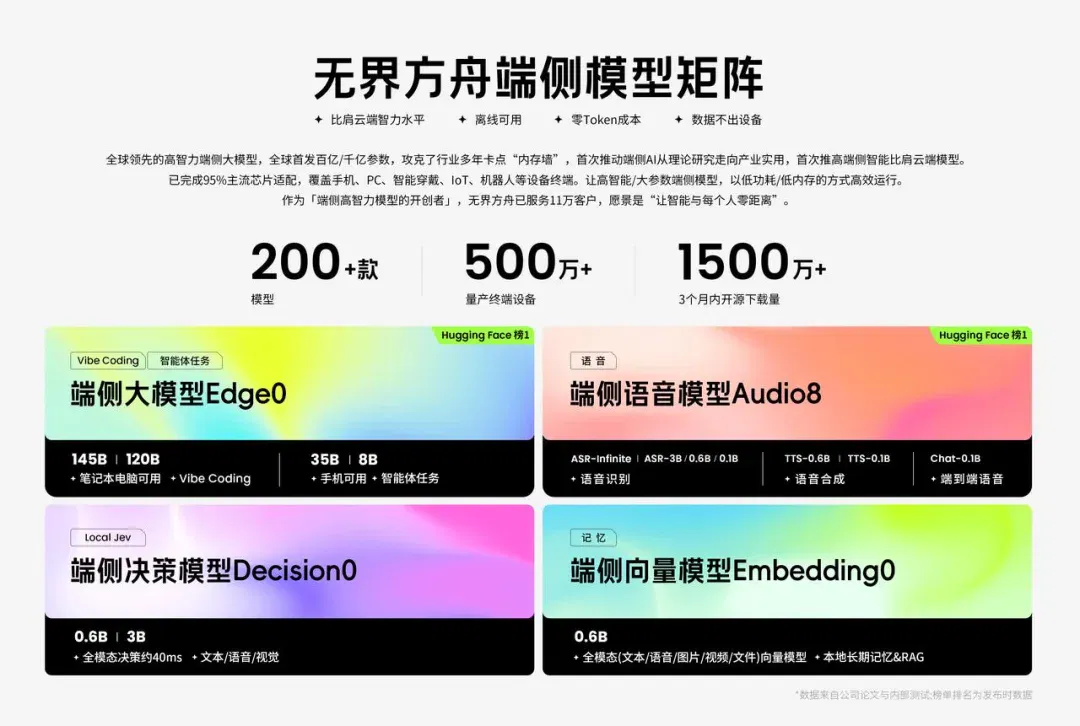
其二是全栈路线。无界方舟走的是端侧 AI 全栈研发路线,核心是让模型、推理框架与硬件芯片协同优化。为此,无界方舟既做端侧模型,也做端侧推理框架:从训练阶段就针对硬件特性优化模型,同时改造推理引擎,让模型在不同芯片上高效运行。
其三是产业飞轮。当下,端侧市场高度碎片化,不同芯片的 NPU 架构不同,对 INT4、INT8、FP4 等计算精度的支持各不相同,通用模型直接部署,很难发挥出硬件性能。无界方舟的做法是把每一颗芯片都啃下来。目前已适配覆盖 95% 的主流芯片平台——高通、恒玄、瑞芯微、全志、地瓜、英伟达等,覆盖耳机、眼镜、手机、PC、机器人等各类硬件形态。每适配一款芯片、部署一个模型、落地一款产品,都会沉淀一次可复用的优化能力,让下一次部署更快、更省。
截至目前,无界方舟开源模型在 3 个月内下载量已经突破 1,500 万次,多次登顶 Hugging Face 趋势总榜第一;截至 2026 年 10 月,客户数已突破 11 万家。
尾声
再往后看,端侧模型能力的变化,或许会进一步影响云端模型的定位。
过去,端云分工往往由能力决定:设备上处理唤醒、识别和简单指令,复杂需求交给云端。用户想让 AI 更聪明,通常就要接受联网、等待,以及持续发生的调用费用。
当端侧开始接住更复杂的任务,这个默认分工成立的条件开始逐渐被松动。
最先发生变化的,可能是高频、相对明确、与设备本身关系紧密的需求。
成本是他们的第一重选择逻辑。
采用纯云方案时,每卖出一台设备,都可能带来一段持续发生的推理支出,用户越活跃,服务成本越高。而硬件低毛利,长期靠 SaaS收费的商业模式,在追剧都要借会员的国内,或许并不是一个短期可以跑通的路径。把适合的任务放回端侧,可以减少这部分持续支出,让服务成本更容易预测。
其次,是数据合规。AI 开始读取代码库、订单、财报、客户资料和硬件设计文件之后,企业关心的不只是答案质量,也包括哪些数据需要离开自己的设备。本地推理让部分任务可以在数据所在的位置完成,减少上传与远程处理的必要性。对那些因为资料敏感而迟迟没有接入 AI 的工作流程,这可能是一个更容易落地的入口。
还有一类变化,发生在网络不可靠的地方。设备如果必须联网才能理解用户,它的能力就始终受到网络条件约束。耳机、眼镜和机器人尤其如此:用户不会因为信号不好,就降低对即时反馈的期待。端侧能力越强,设备在弱网或断网时能够保留的功能就越多。
成本、数据和网络,这些需求一直存在。过去的问题是,为了获得更强的模型能力,用户往往必须在其中作出让步。现在,端侧智能水平开始提高,选择才真正多了起来。
但这并不意味着所有任务都该迁回本地。
在无界方舟看来,随着端侧 AI 智能水平的突破,端与云的边界已经随之发生了三次位移。
2026 年 9 月之前,是云端为主,端侧为辅。Apple Intelligence 是这一阶段的代表:隐私保护做到了,但端上能做的事很少,真正的智力仍留在云端。
2026 年 9 月 10 日开源 Edge0-35B 之后,变成日常任务在端侧,复杂任务上云。端侧第一次接住了高频、日常、需要即时响应的需求。以某头部耳机厂商为例,无界方舟为其搭建了端云协同的解决方案,已经有 92% 的 AI 使用是通过端侧模型,仅 8% 通过云端。在可穿戴消费硬件中,日常对话占据大部分需求场景。
2026 年 11 月 13 日开源 Edge0-145B 之后,边界会再推进一步。
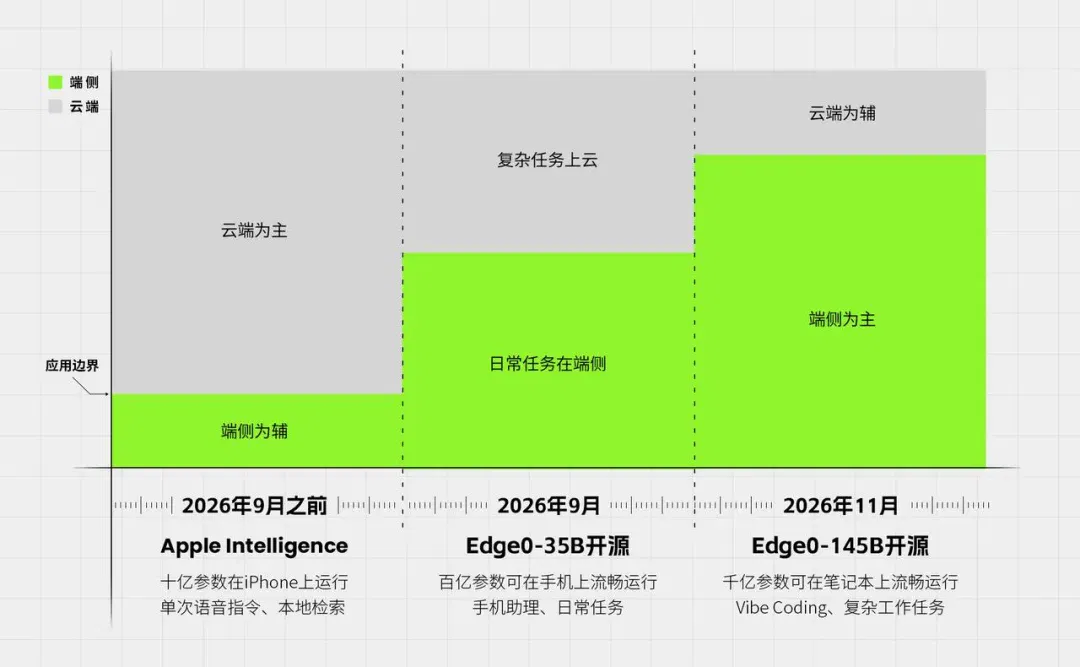
一个端侧为主,云端为辅的未来,或许已经指日可待。
文章来自于微信公众号 “极客公园”,作者 “极客公园”
相关主题
读完之后
加入 AINRK 交流群
了解加入交流群的方式,与更多 AI 从业者交流。
相关文章
继续阅读相关主题与同栏目内容。
苹果真正的AI杀手锏,根本不是 Siri(在新窗口打开)
苹果真正的AI杀手锏并非Siri,而是硬件路线——在新任CEO John Ternus主导下,苹果计划于2029年前后重返企业服务器市场,推出搭载两枚或四枚M8 Ultra芯片的设备用于本地AI推理,凭借统一内存架构为企业提供开箱即用的AI部署方案。
Qwen Intelligence负责人许主洪:Agent手机的竞争,不只在模型(在新窗口打开)
Qwen Intelligence负责人许主洪在云栖大会期间表示,Agent手机竞争的核心已从模型能力转向模型之外的系统能力,阿里通过Qwen Intelligence为手机厂商提供基于千问大模型的AI手机全栈解决方案。
刚刚,高通2nm双旗舰来了,为智能体AI重造架构,手机能跑300亿参数大模型(在新窗口打开)
骁龙首次双旗舰齐发,最高8核CPU、GPU内置AI核、NPU内存扩容,安卓旗舰大战正式开打。
端侧AI从「能跑」到「会进化」,元空智能跑进惠普预装(在新窗口打开)
静态互联网数据的增长红利,见顶了。 下一轮模型能力的跃迁,会越来越依赖与真实环境持续交互的「端侧」。 当整个行业还在想办法把更强的模型塞进设备时,一支从北大走出来的团队,给出了上述这一激进的行业判断。 甚至在端侧AI迎来爆发的这个时间节点,他们还直接给它重新下了一个定义: 生产力=元空端侧AI=模型×Agent×设备。 端侧AI也由此从一条「把模型搬下来」的单向链路,开始变成一套能自己转起来的飞轮。 △ AI生成 得出这个反常识判断的公司,大家应该也不陌生:元空智能(元空AI)。 三年前,这支从北大走出来的创业团队,靠国内最早一批AI Excel产品ChatExcel迅速出圈,短时间积累上百万
首发 | 端侧AI算力基础设施公司烨知心(Yeats.AI)宣布完成Pre-A轮融资,(在新窗口打开)
端侧AI算力基础设施公司烨知心(Yeats.AI)完成Pre-A轮融资,成立一年累计融资近10亿元,由深创投、和利资本、TCL创投、中科创星联合领投,创始团队来自苹果Apple Neural Engine团队,专注面向Agentic与Physical AI的下一代NPU软硬件研发。