Oh My Hermes 为 Hermes 增加模型路由、任务编排与验证状态
独立开源项目按任务类型配置模型链与技能,并展示桌面和终端工作流;多模型额度、并行成本和验证证据仍需用户管理。
先说结论
Oh My Hermes(OMH)不是一个新模型,也不是 Hermes 的替代品。它是加在 Hermes Agent 上的一层运行层:你照旧跟 Hermes 说话,它把每件事拆成几条 lane,每条 lane 配一个「带技能、带模型、带推理档位」的同事,并行去干。
三条最实在的设计:18 类工作各有模型链、153 个专家技能由路由器自己挑、没验证过不算做完。MIT 许可,5.4k 星,当前 v4.0.7。
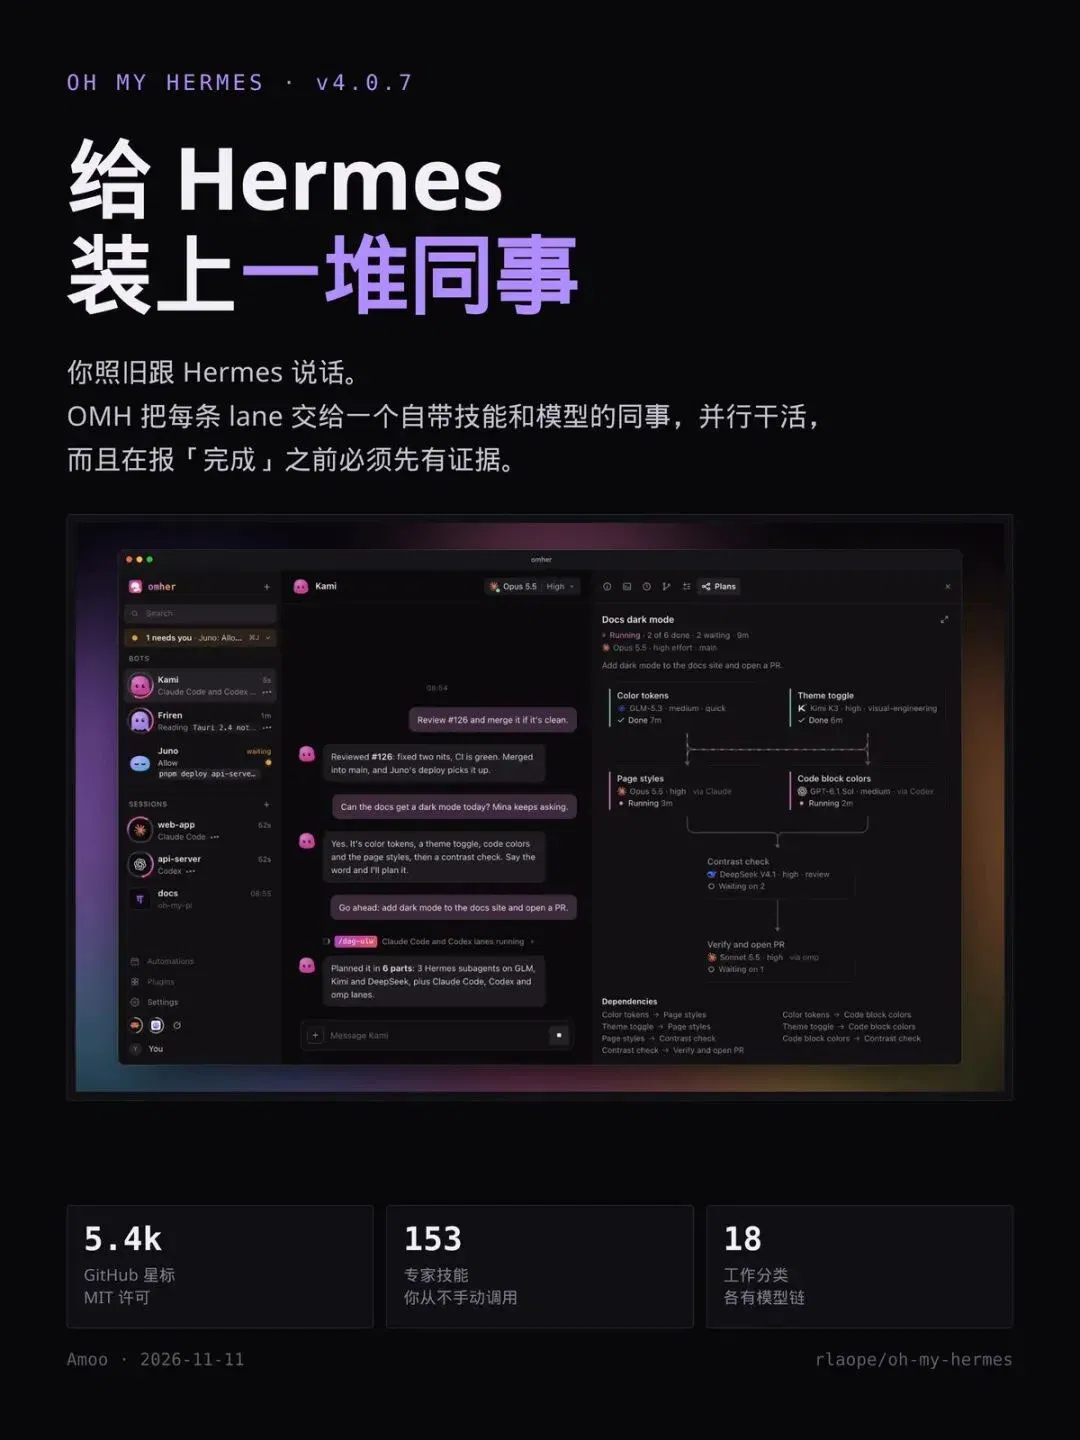
官网首屏长这样
一句话定位写在最显眼的地方:The ultrawork agent with AI coworkers wired into you(把 AI 同事接进你工作流的 ultrawork agent)。
下面直接给安装命令,四种系统一键装;再下面是一整排接入的模型——OpenAI、Claude、Gemini、Grok、Kimi、DeepSeek、GLM、Qwen、MiniMax、豆包、混元、StepFun、OpenRouter、Bedrock……近三十家。
桌面端:一个窗口装下所有同事
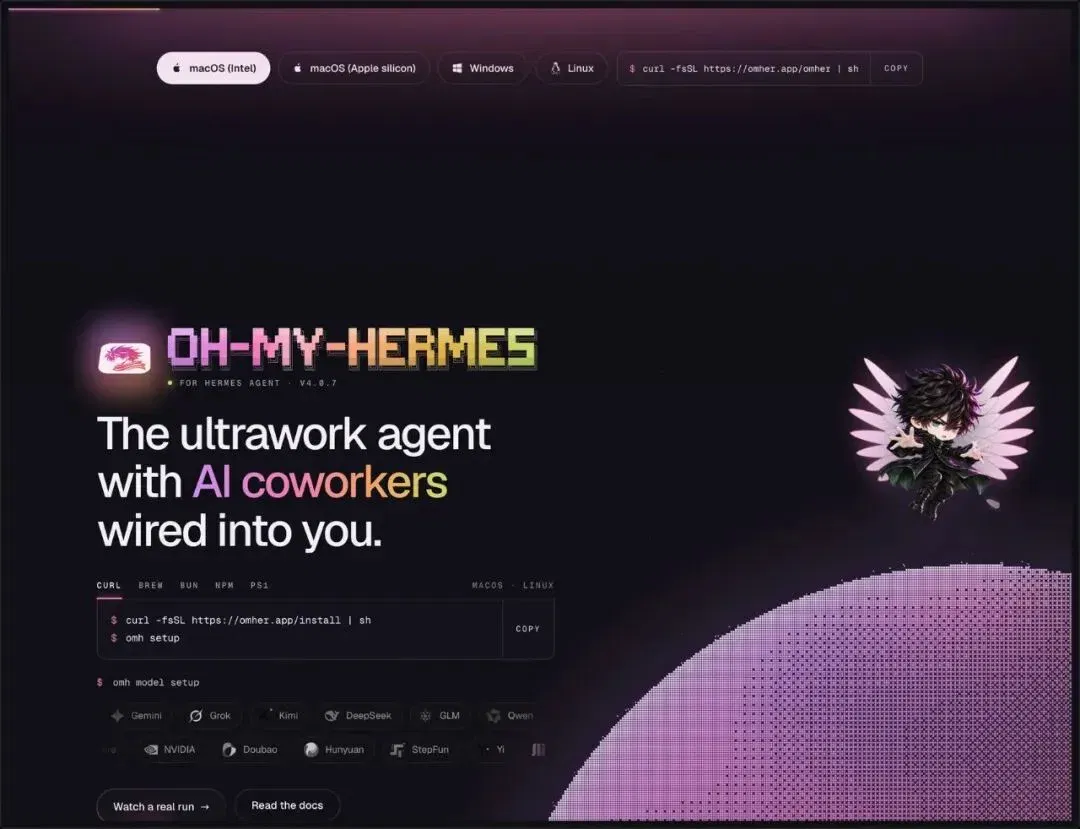
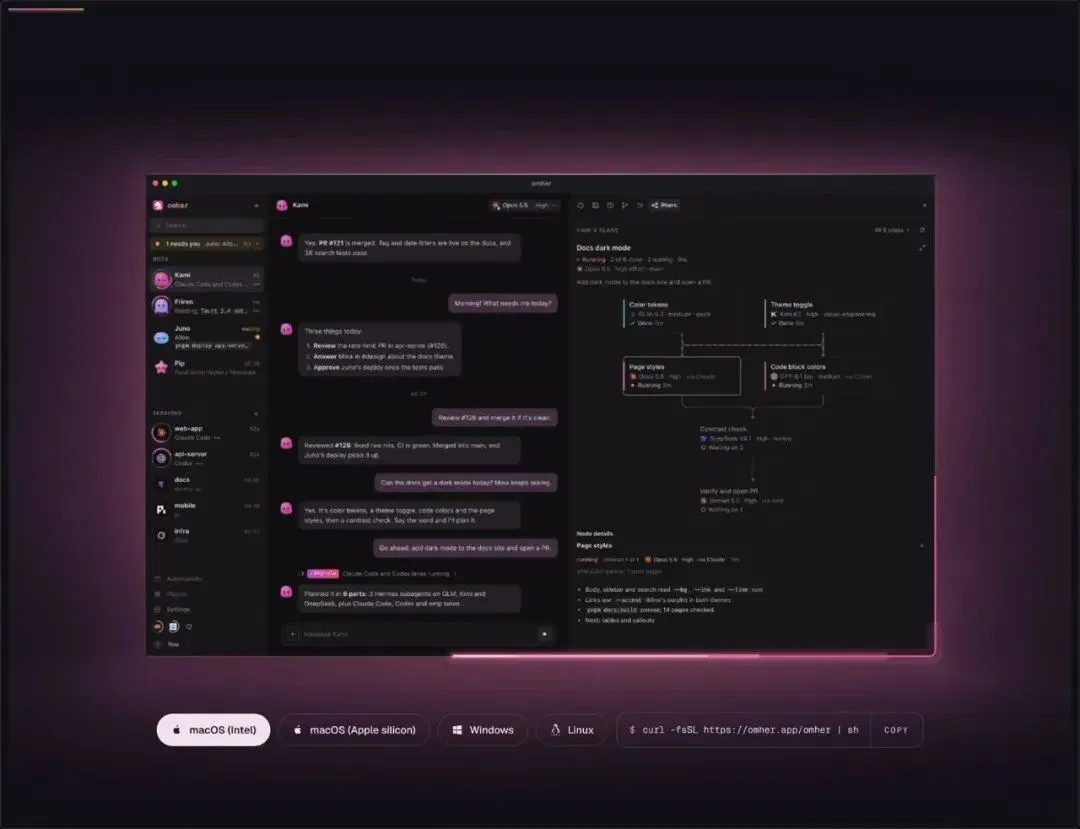
它的桌面 App 是这次发布里最直观的部分:左边是 Bot 列表和会话(Kami、Friren、Juno,以及跑在 Claude Code、Codex、oh-my-pi 上的 session),中间是聊天,右边是当前任务的分片——「2 of 6 done,2 waiting」,每片标着负责的模型和执行状态。
一个窗口里,你既在跟人聊天,也在看工程进度。
桌面端还有一个角色:Kami,官网专门给它开了一节,可以「捏脸」。README 里也把它列为协作者之一(和 Friren 一起),承担了一部分实际的开发工作。这类项目里,把 AI 同事真的写进 contributor 列表,比写在宣传语里更有说服力。
它到底做了什么
三件事。
不替换、不打补丁。你继续用原来的 Hermes,OMH 只把「哪条线该用哪个模型、带哪些技能」这套编排加在上面。Hermes 自己的记忆它从不读取,也不改写。
每条 lane 是一个同事。lane 不是线程,是「一个有技能、有模型、有档位的执行单元」。一句话定目标,它拆成若干 lane 并行跑。
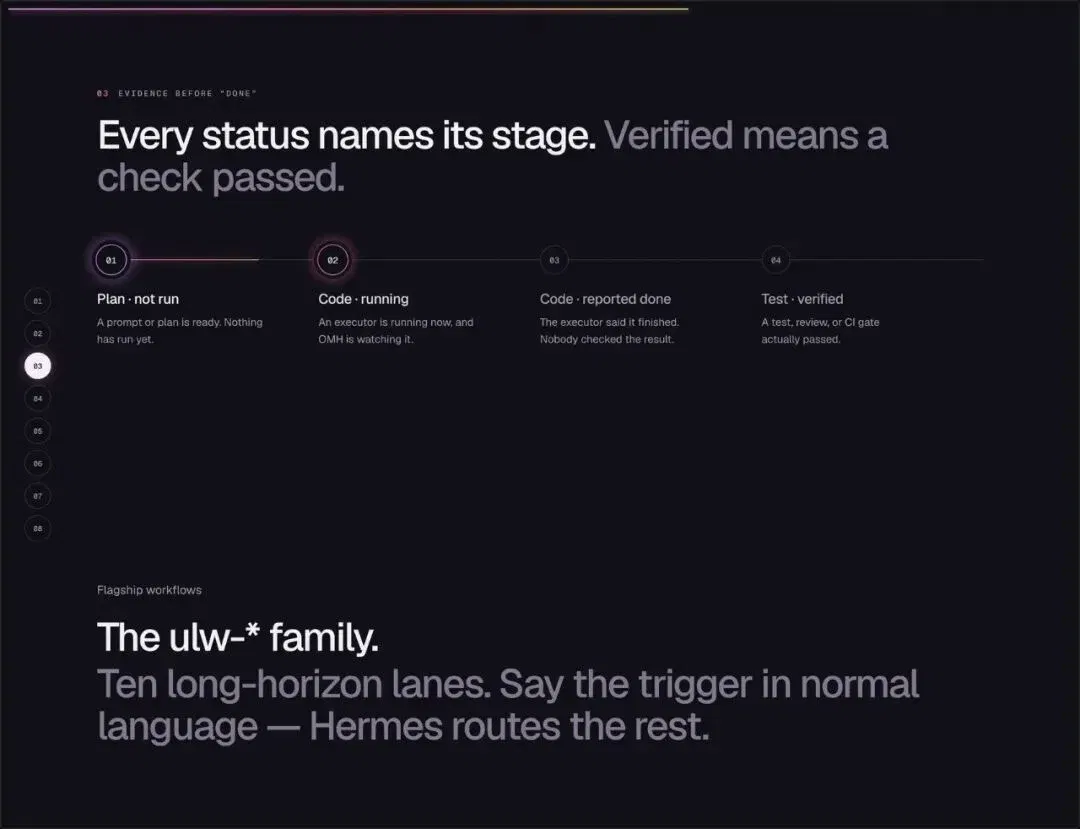
没验证过,不算做完。每个状态都写明自己在哪一步,只有真跑过测试/评审/CI 的那一档才算 verified。
官网那句话说得最准
「你继续跟 Hermes 说话。OMH 给每条 lane 挑一个技能和一个模型,然后并行把活干完。」
这句话解释了它全部的产品哲学:入口不变,内部换架构。你不用学新语法,也不用把工作流搬进新工具——它把复杂度藏在下面。
概念不是它发明的
ultrawork 这个词来自OmO(oh-my-openagent),作者 code-yeongyu。OMH 做的事是把这个概念搬到 Hermes 上:原来一套 ultrawork 工作流绑在某一个 agent 上,现在它成了可以跑在 Hermes 之上的通用层。
底下的 Hermes Agent 由 Nous Research 出品。OMH 明确写着自己是独立、非官方的上层,MIT 许可,与 Anthropic、OpenAI 都没有关系。
核心命令:/dag-ulw
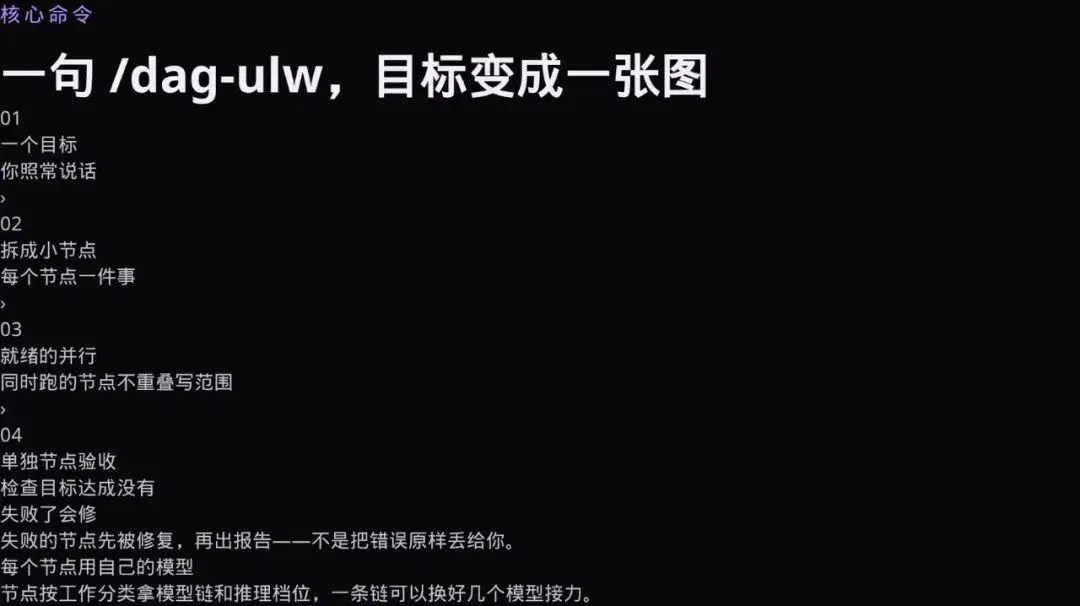
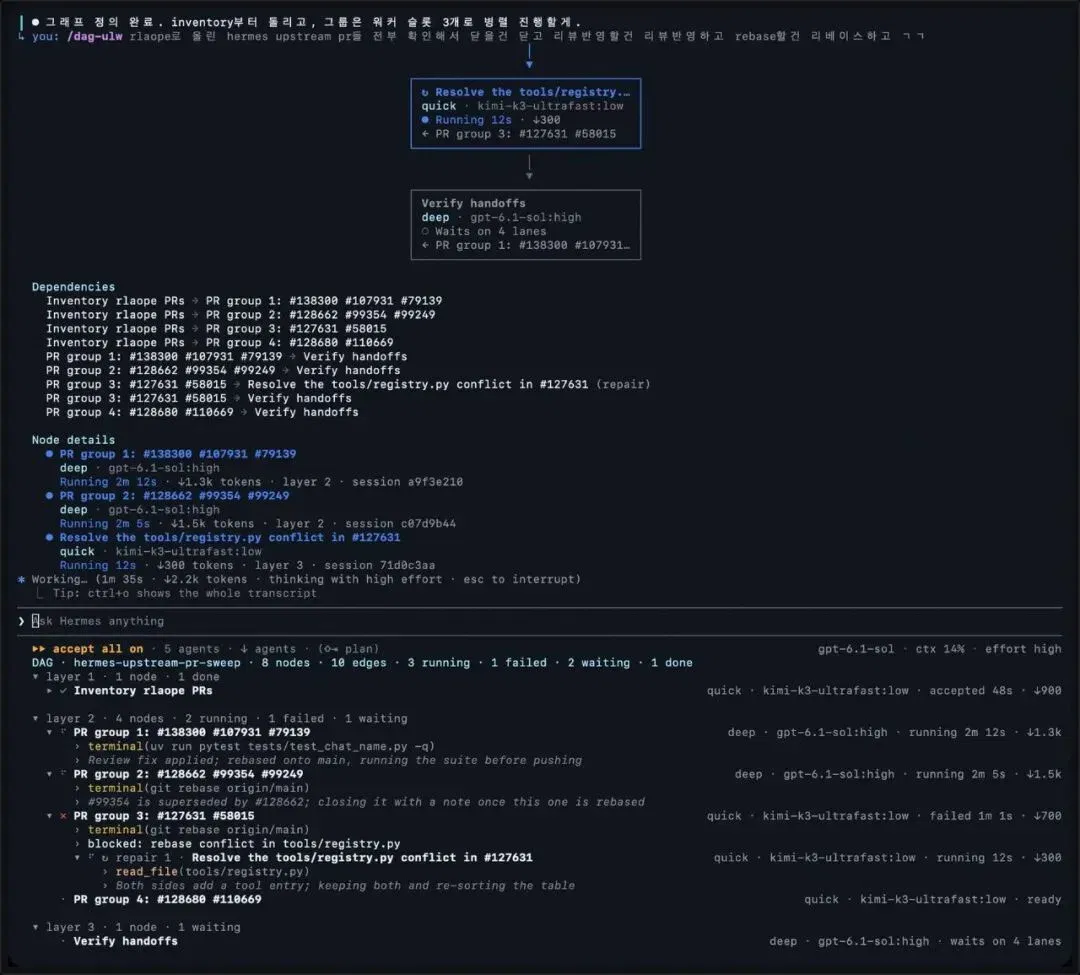
就一个词。敲下去,你的目标变成一张图:拆成小节点,就绪的节点并行跑,每条用自己的模型和档位;同时跑的几个节点保证不共享写入范围,不会互相踩。
跑完还有一个单独的节点专门验收目标达成没有;失败的节点会先被修复,然后才出报告——不是把错误原样甩给你。
图是长这样的
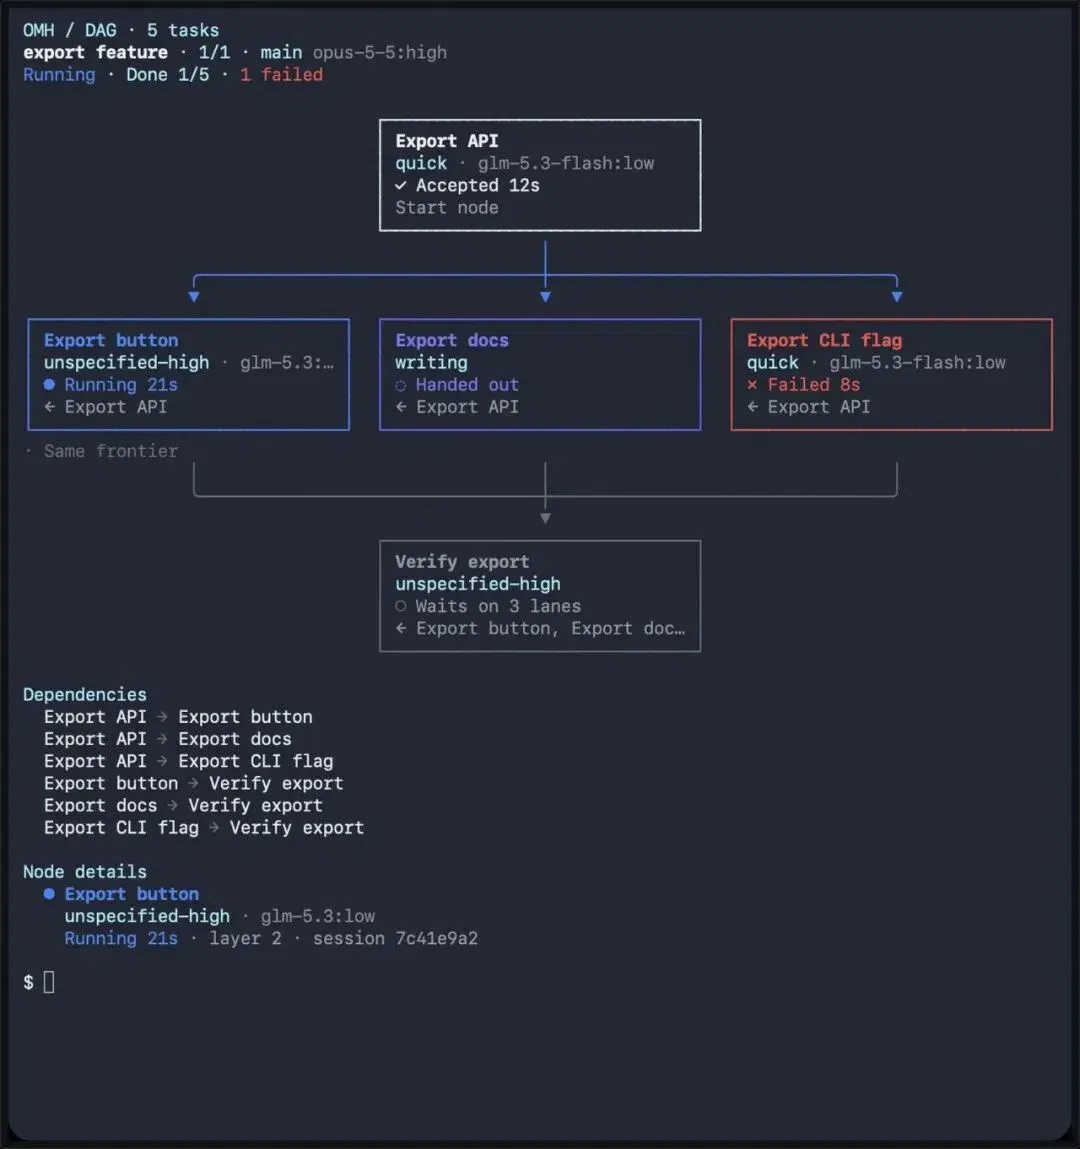
这是它自己的截图:DAG · 5 tasks。一个 Export API 拆出三个并行分支(按钮、文档、CLI 参数),最后汇到一个 Verify export。
右边是每个节点的状态和耗时,下面列着完整依赖。你能一眼看出哪条跑完了、哪条失败了。
lane 树:每条线的模型和 token
跑起来之后是这棵 lane 树。每条 lane 显示它用的模型、推理档位、消耗的 token、当前状态。
这是「并行」这件事第一次变得可观察——不是黑箱里同时烧钱,而是每条线摊开给你看。
这也解释了它为什么强调「不共享写入范围」:并行最容易出的问题不是慢,是两个节点同时改同一个文件,最后一个把另一个覆盖掉。把写范围切开,是并行的前提,不是优化项。
除了这些,README 里还有三条容易被忽略的能力。
LSP 进环路。定义、引用、重命名来自语言服务器,而不是文本搜索;别名、re-export、被遮蔽的同名变量,都按语义改,不按字符串匹配。默认关闭,要在插件设置里开lsp_tools。
可审计的长期记忆。没有任何东西被偷偷记住:每条候选记忆要么保留、要么拒绝、要么延后,都带一句书面理由;下一次会话拿到的是一份按任务排序、按 token 预算裁剪的召回包。
OMH Native。直接敲omh打开它自己的 TUI,跑在 Hermes 的 gateway 上;/dag-ulw会先打印那张框线图,再给一棵实时 lane 树,每条 lane 标着模型、档位和 token。可以用!跑一行 shell,Esc Esc 回退。
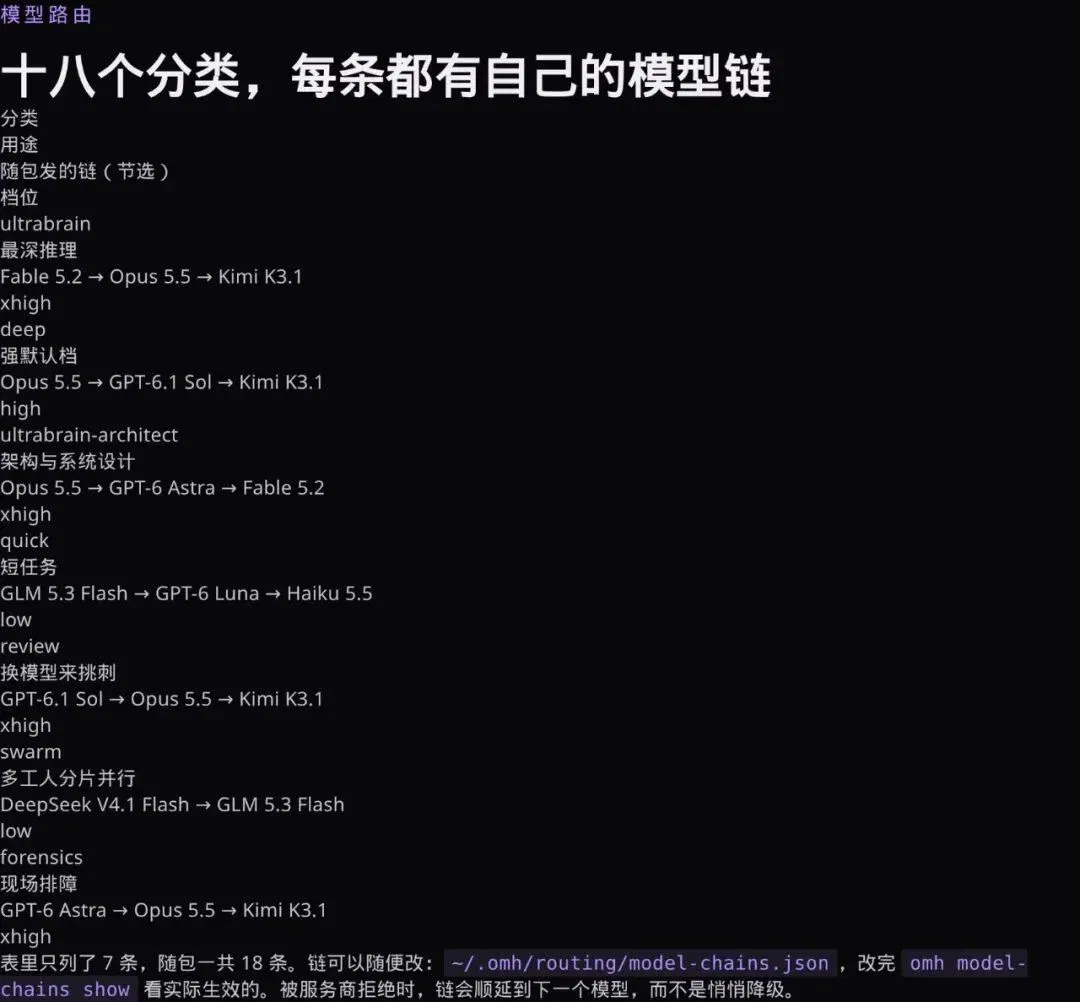
十八个分类,每条一条模型链
这是它最反直觉的设计:模型不是全局选一个,而是按工作分类选。
ultrabrain(最深推理)走 Fable 5.2 → Opus 5.5 → Kimi;quick(短任务)走 GLM 5.3 Flash → GPT-6 Luna → Haiku;review(换模型挑刺)走 GPT-6.1 Sol → Opus 5.5;swarm(多工人分片)走 DeepSeek Flash → GLM Flash。
关键是那句No silent downgrade:服务商拒绝某个模型时,链往下顺延,而不是悄悄换成便宜货。
链是可以改的
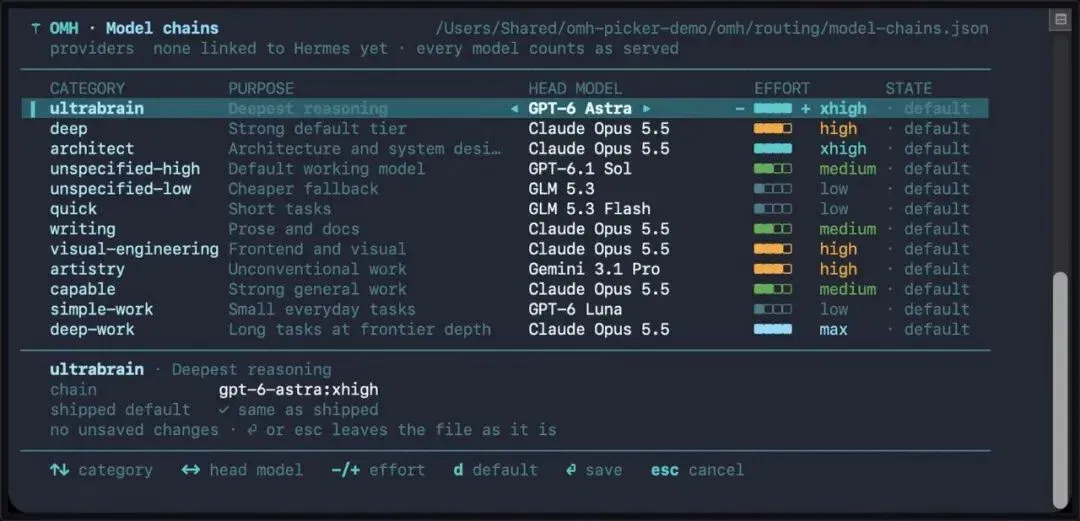
~/.omh/routing/model-chains.json里改,改完omh model-chains show看实际生效的配置。
命令行里还有一个选择器:方向键选分类,左右换主模型,加减号调推理档位。桌面端和 TUI 都能调。
再补一层:为什么「按分类路由」比「手动选模型」省事。
真实工作里,同一件事在不同阶段需要的模型其实不一样——写代码要强推理,写文案要语感和一致性,做视觉要另一套审美,跑长任务要能撑住上下文。手动选就得每一步都想一次;按分类路由等于把这个判断提前做成了模板,你只在结果不对时才动手改链。
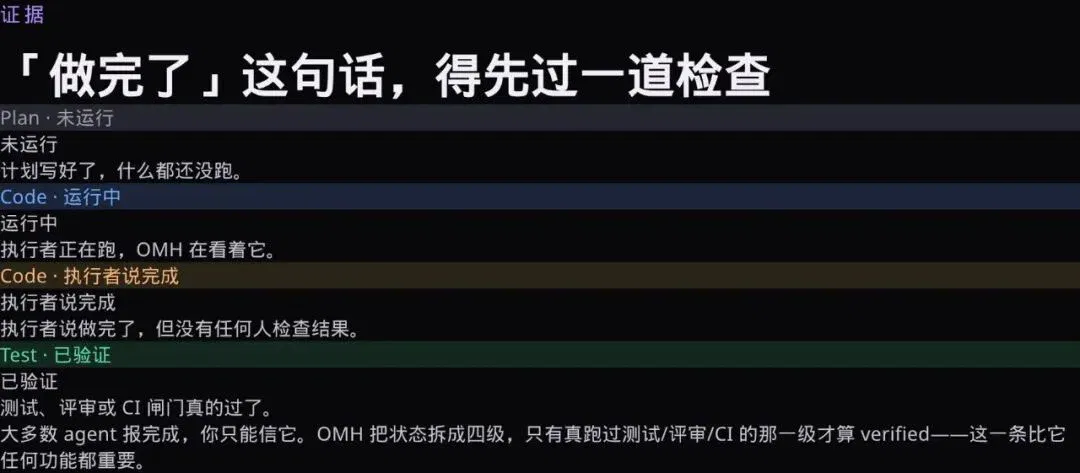
「完成」这件事,被拆成了四级
这是我觉得整个项目最值钱的一条。
Plan · 未运行:计划写好了,什么都没跑。Code · 运行中:执行者正在跑。Code · 执行者说完成:它说做完了,但没人检查。Test · 已验证:测试、评审或 CI 真的过了。
大多数 agent 报完成,你只能信它。这里把「谁说的」和「验过没有」分开了。
为什么这条比功能表重要
因为 agent 最常见的失败不是不会做,是做了但没做成,还说做成了。
OMH 把这件事变成状态机:你在任何时刻都知道进度停在哪一档,也大概知道该不该信。自己搭流水线的话,这条设计可以直接抄。
十条长跑线,中文也能喊
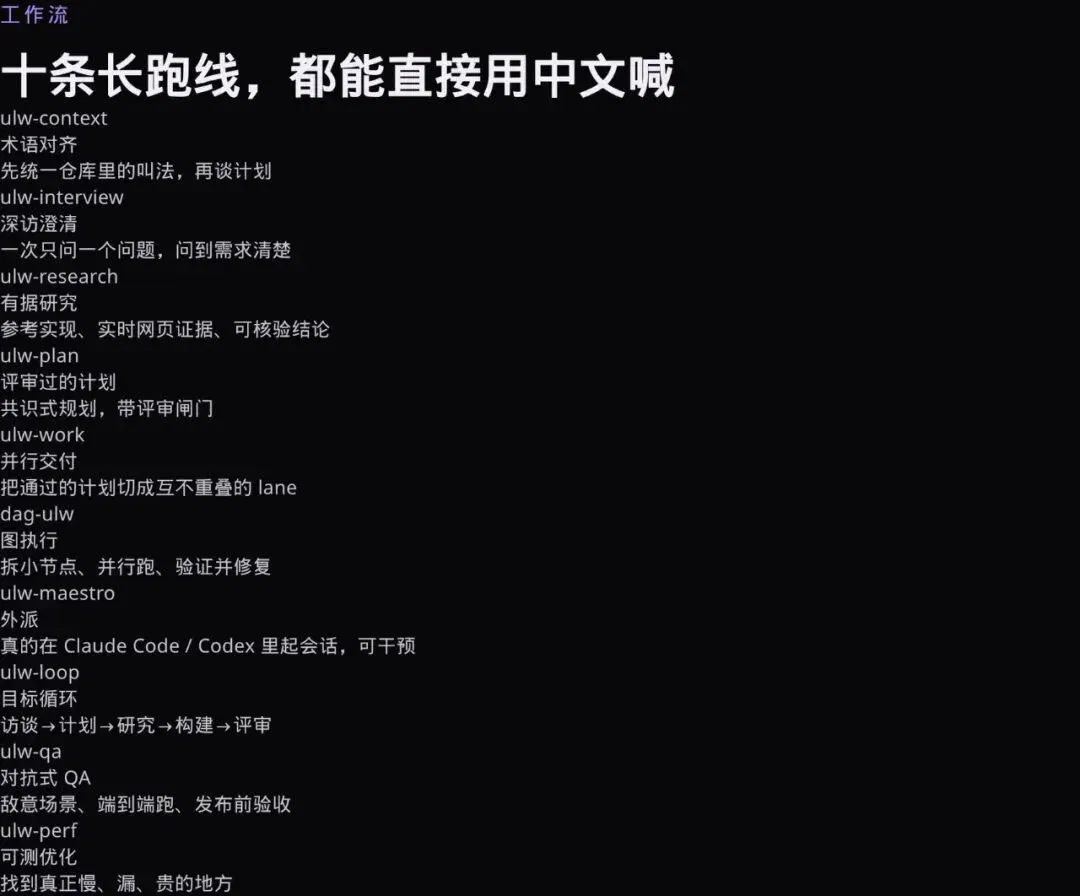
ulw-*是它的旗舰工作流族,十条,覆盖长周期任务的不同阶段:
术语对齐(先统一叫法再谈计划)、深访澄清(一次只问一个问题)、有据研究(实时网页证据)、评审过的计划、并行交付、图执行、外派给 Claude Code / Codex(真的起会话,可中途干预)、目标循环、对抗式 QA、可测优化。
每条都能用中文触发:「deep-interview 帮我理清需求」「ultraqa 做发布前验收」。
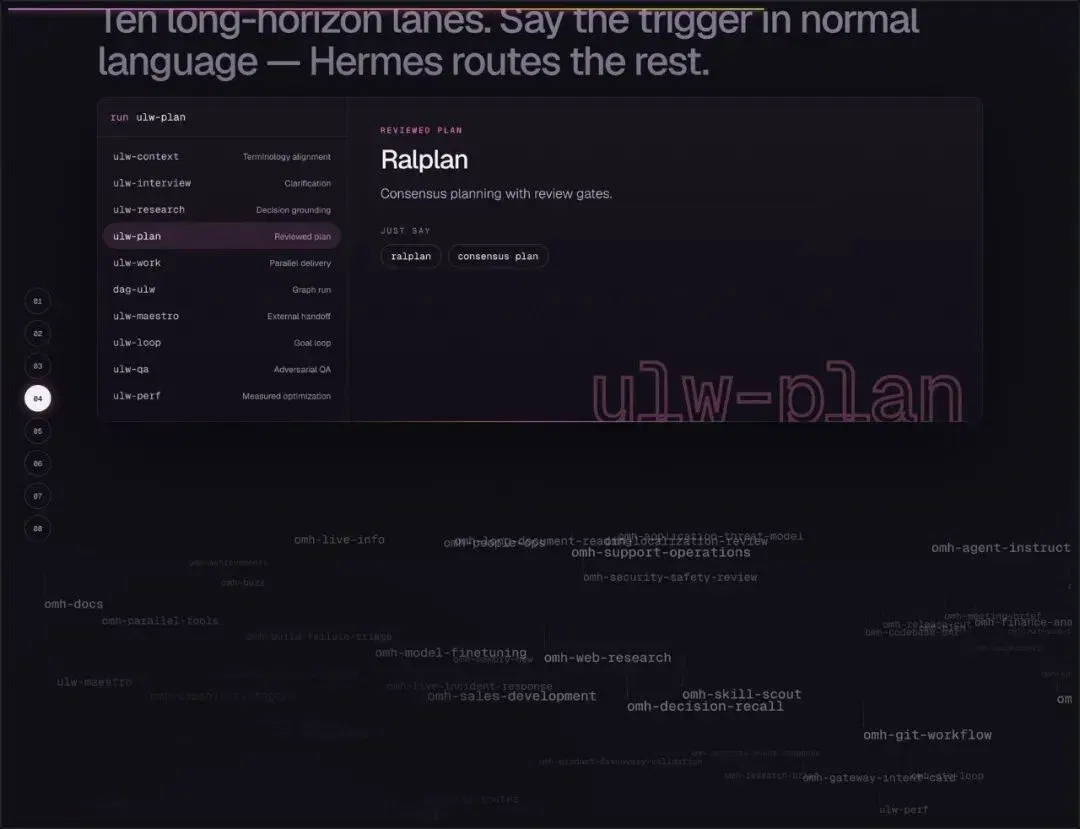
十条各自干什么
上面这张是其中的触发卡:ulw-plan起手,产出经过评审的计划(Ralplan),底下那堆连线就是后续所有 lane 的依赖。
十条工作流的完整分工在图里——从「把话说清楚」到「证明它真的行」,每一段都有对应的入口。
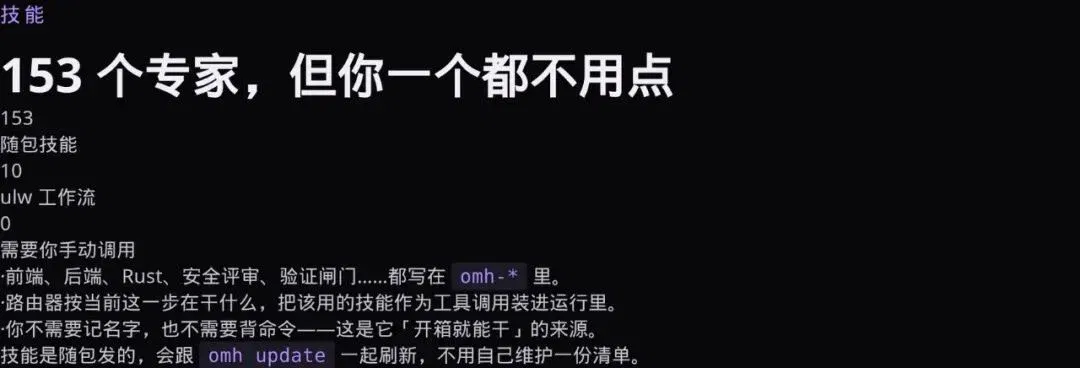
153 个技能,你一个都不用点
随包发 153 个omh-*专家技能:前端、后端、Rust、安全评审、验证闸门……你不需要记名字,也不需要调。
路由器会根据当前这一步在干什么,把该用的技能作为工具调用装进运行里。这也是它「开箱就能干活」的来源——技能是资产,不是配置负担。
官网就这么写的
「153 skills. You never call them. The router loads the right ones into the run.」
配图里那行小字也挺有意思:0 skills · omh-plan,10 ulw workflows——意思是你的技能计数从零开始涨,工作流是固定的十条。
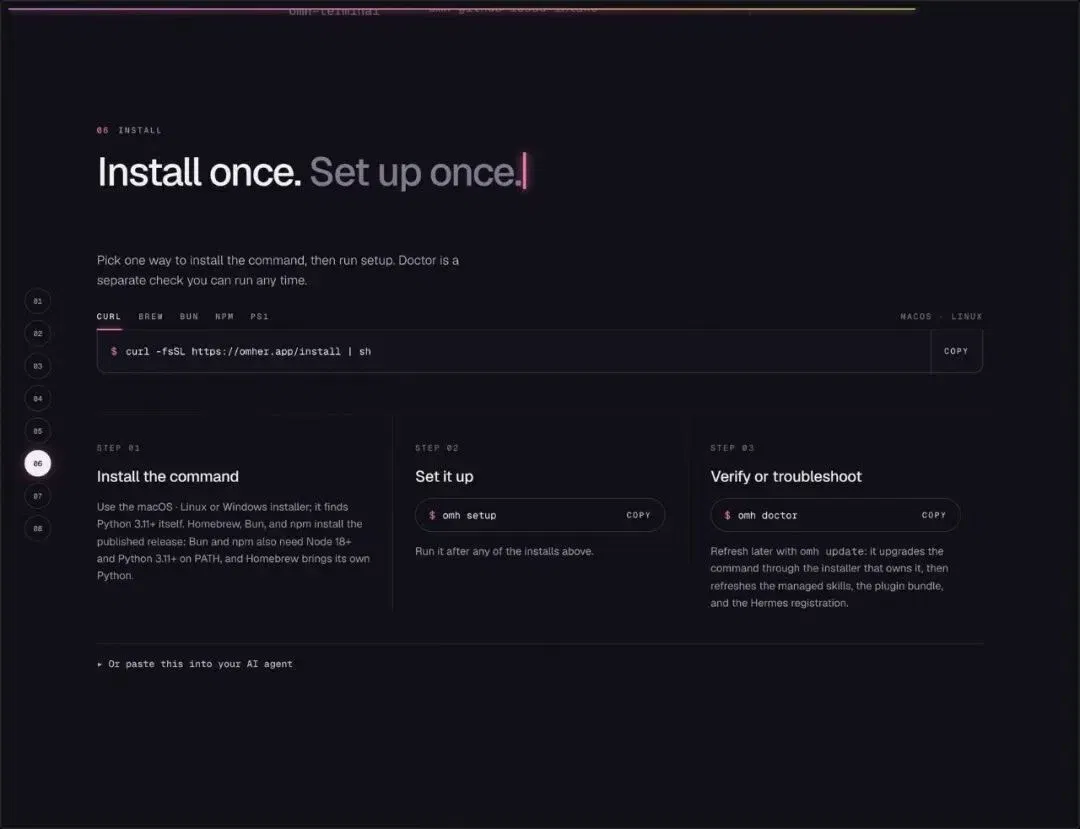
装它只要两步
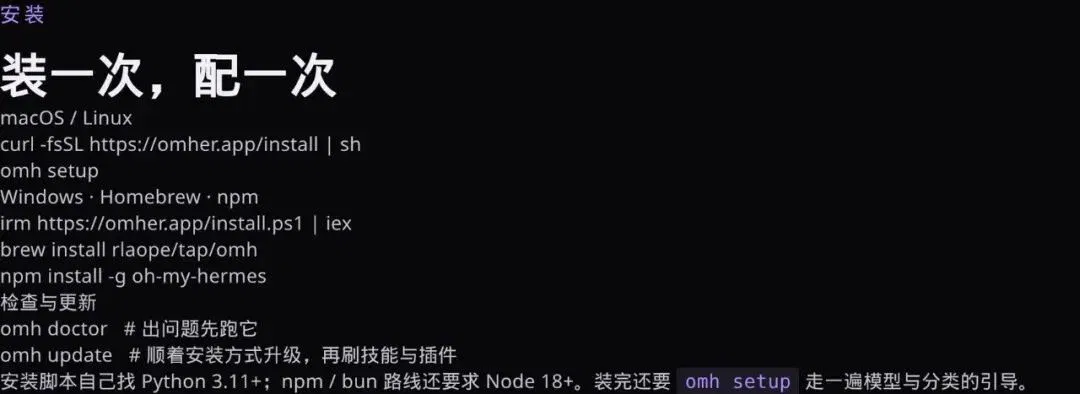
curl -fsSL https://omher.app/install | sh,然后omh setup。
macOS / Linux / Windows 都有对应脚本;Homebrew、bun、npm 也都能装。装完还有omh doctor体检、omh update顺着安装方式自我升级(顺带刷新技能和插件)。
有意思的是它还给了一段「粘给你的 AI agent」的安装指令,里面专门要求先把 main 解析成完整 commit SHA 再按那个 SHA 执行——防的是「仓库中途被改」这类供应链风险。
三条命令的分工
装、配、验是分开的三件事:安装脚本只负责把命令装上去(自己找 Python 3.11+),omh setup负责模型与分类的引导,omh doctor负责出问题时排查。
npm / bun 路线额外要求 Node 18+。这套拆分比「一条命令装完再说」要靠谱。
装完之后第一件该做的事,其实不是跑一个复杂任务,而是先跑omh doctor,再用一条最普通的任务看它怎么拆 lane、怎么标状态。等你确认了「它报完成的时候是真完成」,再把长活交给它。
产品界面再近一点
这是官网里的产品特写:左侧是会话与运行记录,右侧是这条 lane 正在做的事,中间是它的输出。
整个视觉语言是深色 + 紫蓝点缀,跟它「一群同事在后台干活」的定位挺贴。
该泼的五盆冷水
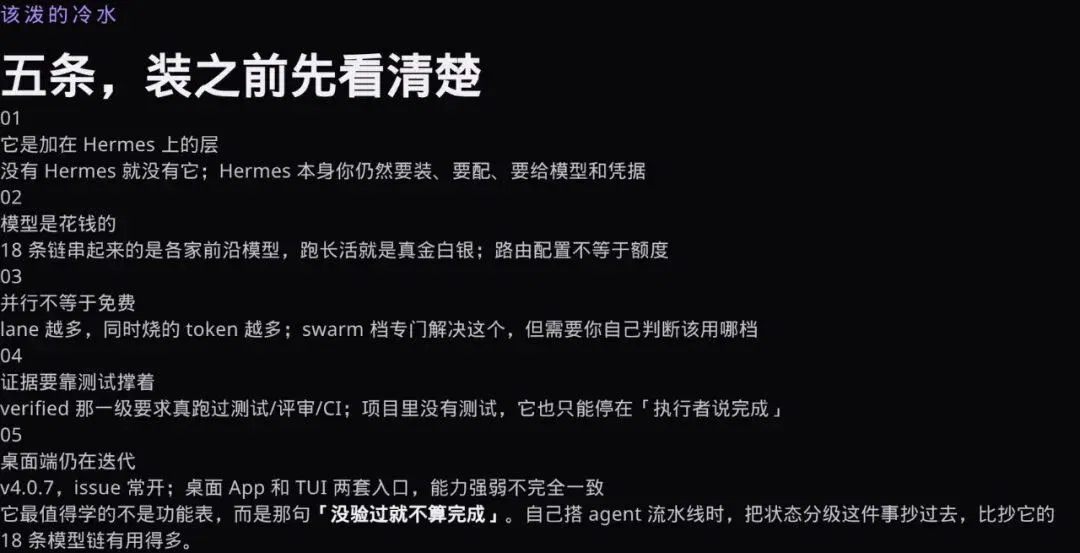
它是加在 Hermes 上的层。没有 Hermes 就没有它;Hermes 本身你仍然要装、要配、要给模型和凭据。
模型是要花钱的。18 条链串的是各家前沿模型,跑长活就是真金白银;路由配置不等于额度。
并行不等于免费。lane 越多同时烧得越多,swarm档就是为这个准备的,但该用哪档得你自己判断。
证据要靠测试撑着。verified 那一级要求真跑过测试/评审/CI;项目里没有测试,它也只能停在「执行者说完成」。
桌面端还在迭代。v4.0.7,issue 常开;桌面 App 和 TUI 两套入口,能力不完全对齐。
最后
在所有人都在比「谁的模型更强」的时候,这个项目赌的是另一件事:编排和证据,比模型本身更稀缺。
一个目标进来,拆成图,交给一群各有所长的同事,跑完还得有人签字——这套流程其实不是 AI 的发明,是工程管理本来的样子。OMH 只是把它写成了代码,然后开源了。
文章来自于"布鲁斯AI",作者 "布鲁斯AI"。
相关主题
读完之后
加入 AINRK 交流群
了解加入交流群的方式,与更多 AI 从业者交流。
相关文章
继续阅读相关主题与同栏目内容。
SoloPi 真机实践:优化 Android 执行链路,并测试 Laya 决策(在新窗口打开)
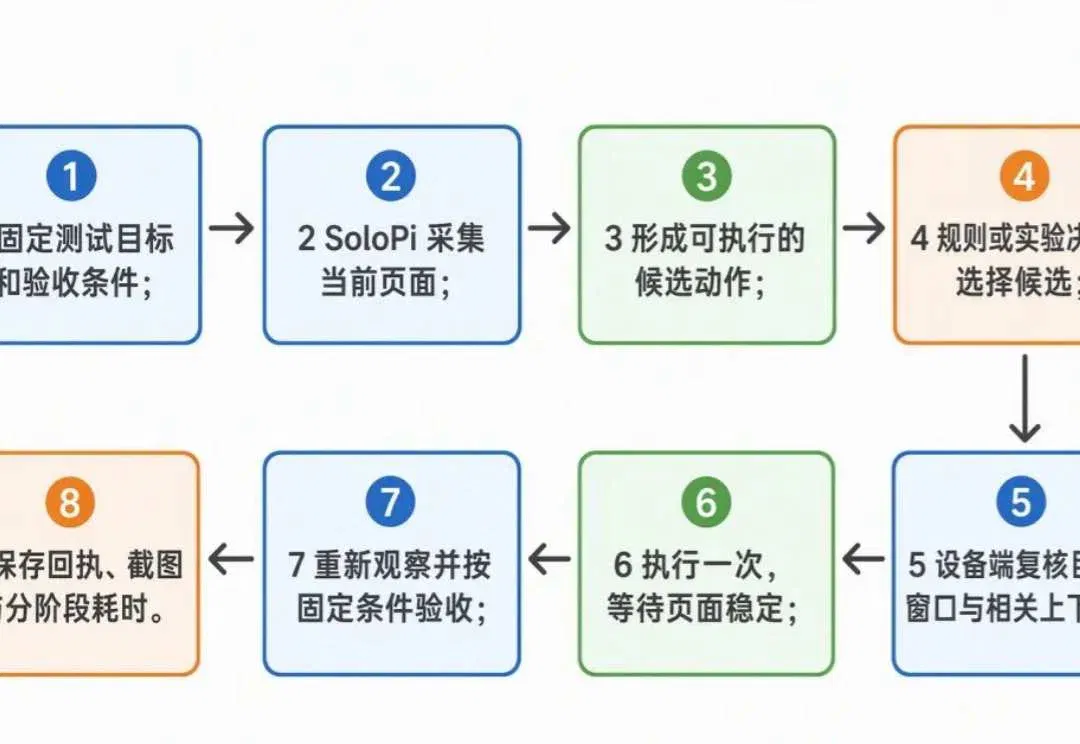
项目作者在两条支付宝浏览流程比较耗时,并单独评测本地文字及视觉模型;实测提速来自执行器,模型增益尚未证实。
FireFlash 用64张B300训练长程编程智能体,公开强化学习配方(在新窗口打开)
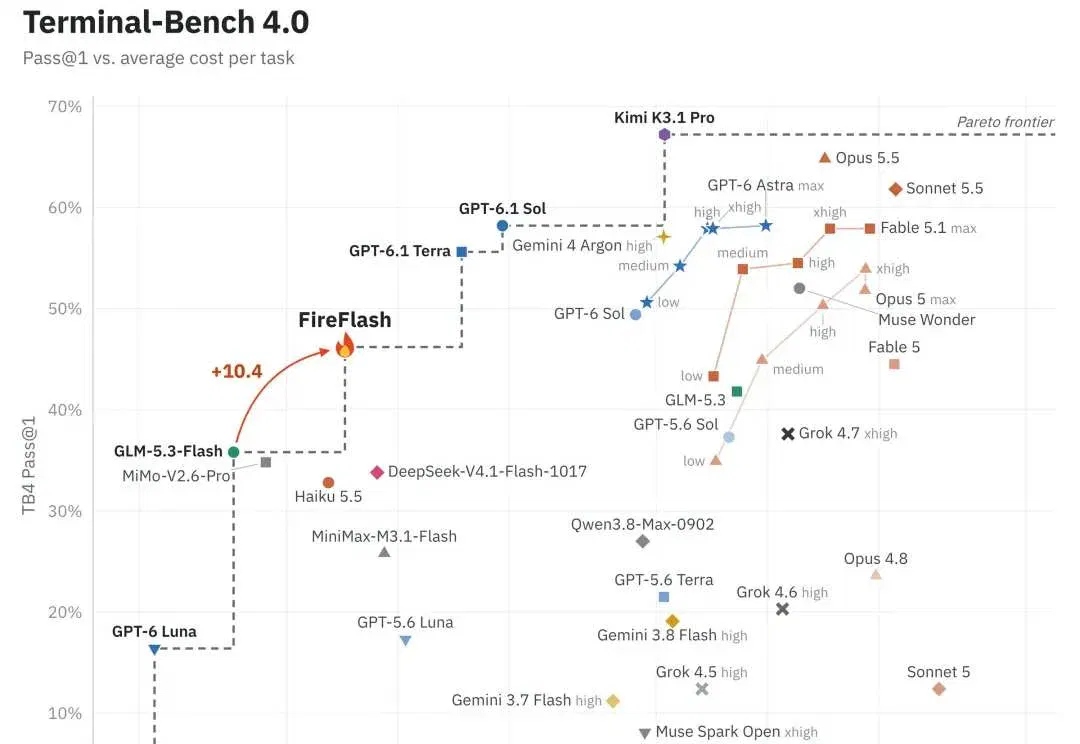
团队从 GLM-5.3-Flash 进行后训练,结合任务筛选、异步采样和统一运行框架,在终端及软件工程基准报告成绩与估算成本。
智元 LIFE 连接持续感知与长期记忆,测试机器人回看一天经历(在新窗口打开)
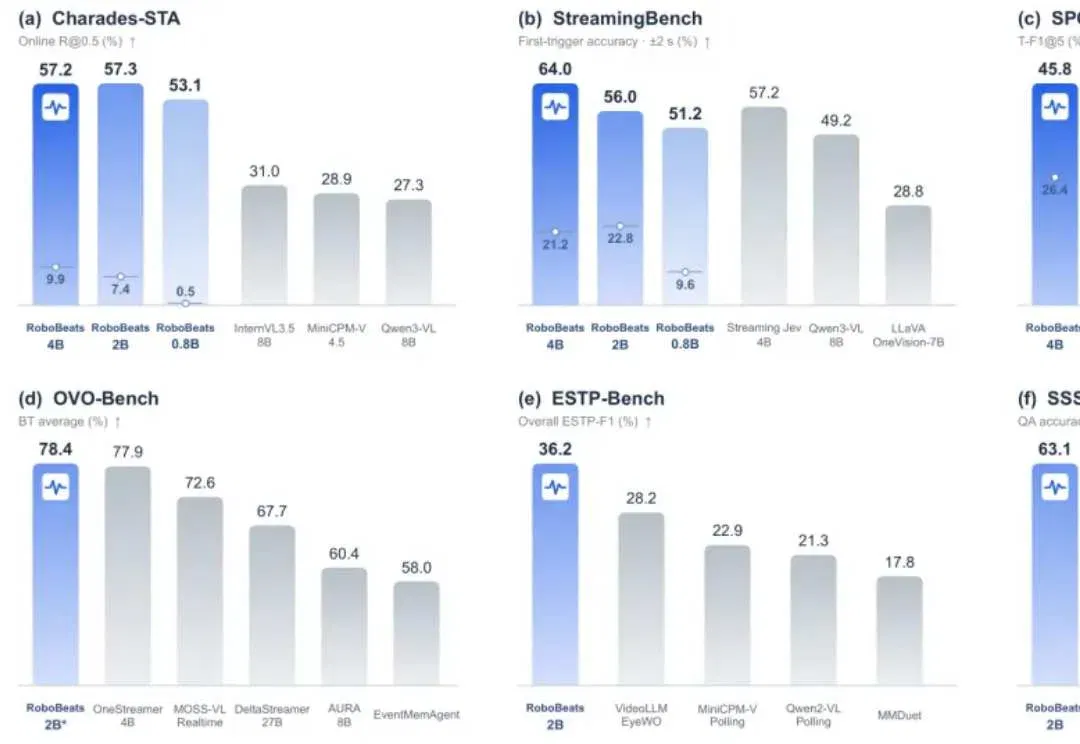
框架结合 RoboBeats、可塑性记忆和工具探索。团队报告指定硬件上的感知延迟、视频问答及少量真机记忆实验。
EM²Mem 以事件组织多模态记忆,连接人物、行为与时间证据(在新窗口打开)
浙大与联想团队把跨模态对齐提前到记忆构建,测试长视频问答和证据定位;查询更轻,但需计入前期构建开销。
SLA 把空间监督引入持续预训练,测试机器人应对场景变化(在新窗口打开)
港科大广州与欧拉万象团队以多来源机器人数据学习空间表征,在公开榜单、扰动与少样本本体适配实验中报告收益。