Q0-Preview 用空间计算与工具调用组织机器人操作
乾章智能介绍基于 Opus 5.5 的机器人智能体,利用像素定位、坐标计算和运动规划完成任务,并披露其仿真评测成绩与成本限制。
编辑更正(2026年11月13日)按官方发布说明修正相对日期,并区分演示观感与量化比较。
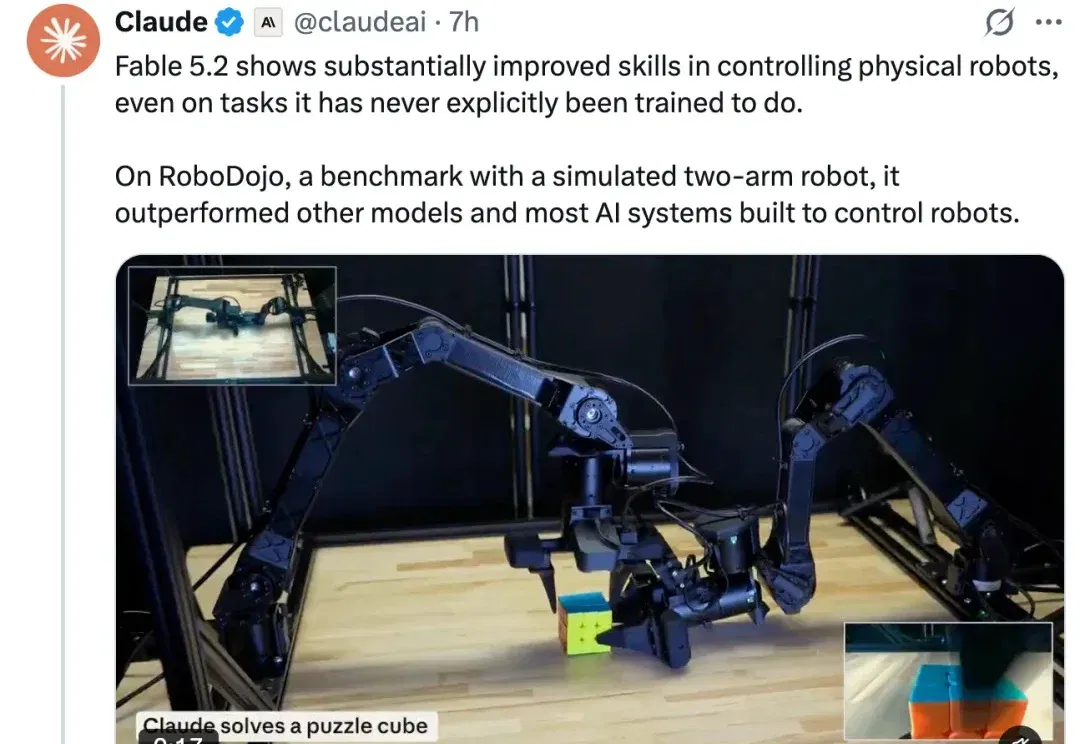
近日,Anthropic 发布新一代模型 Fable 5.2。官方发布页标注日期为2026年11月9日。
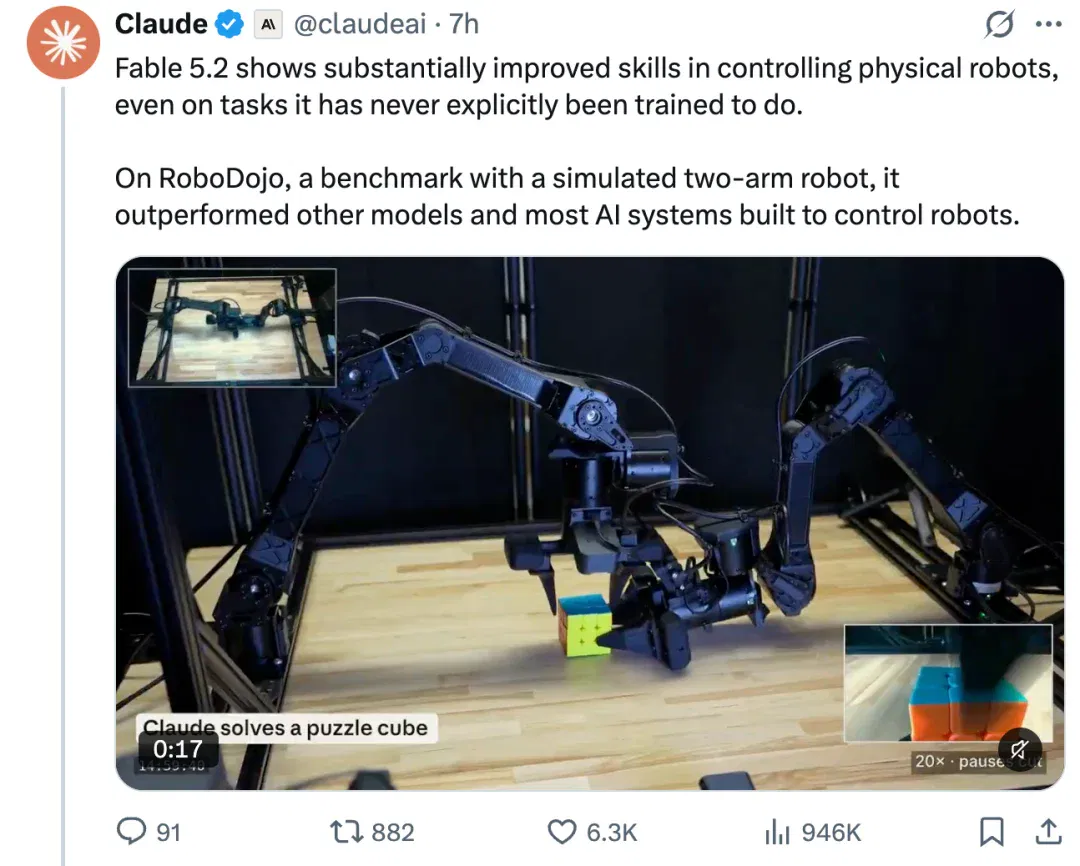
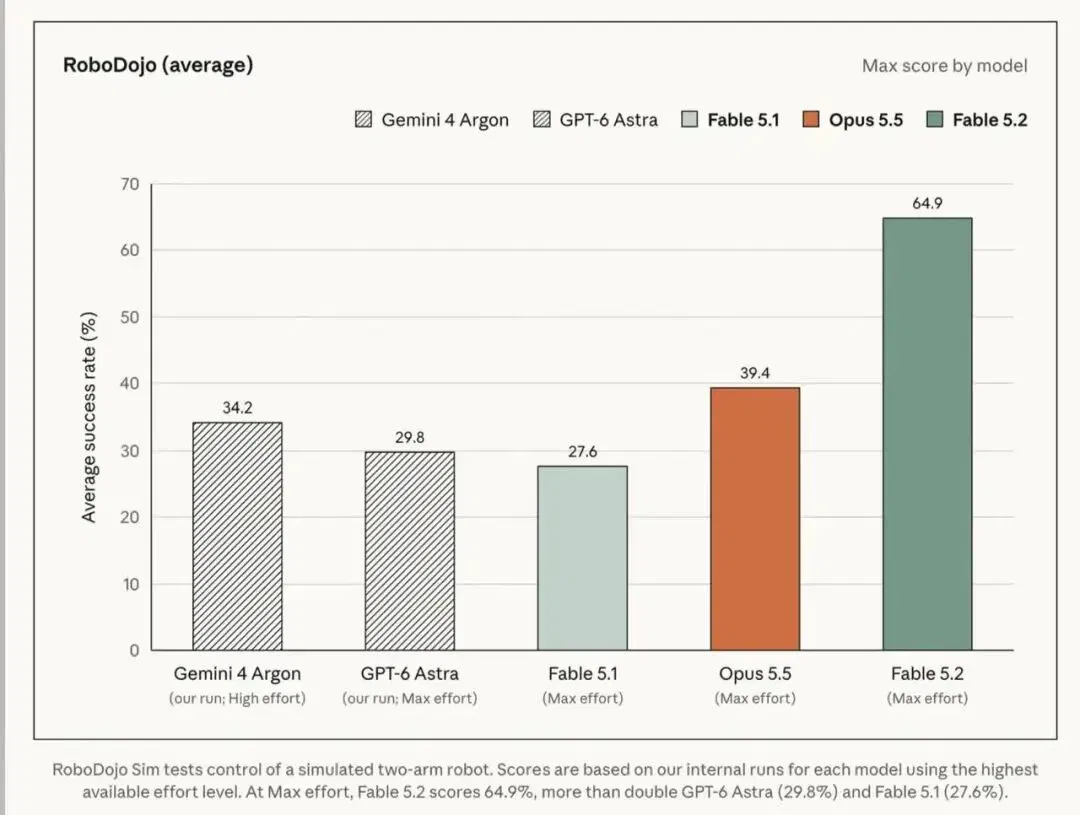
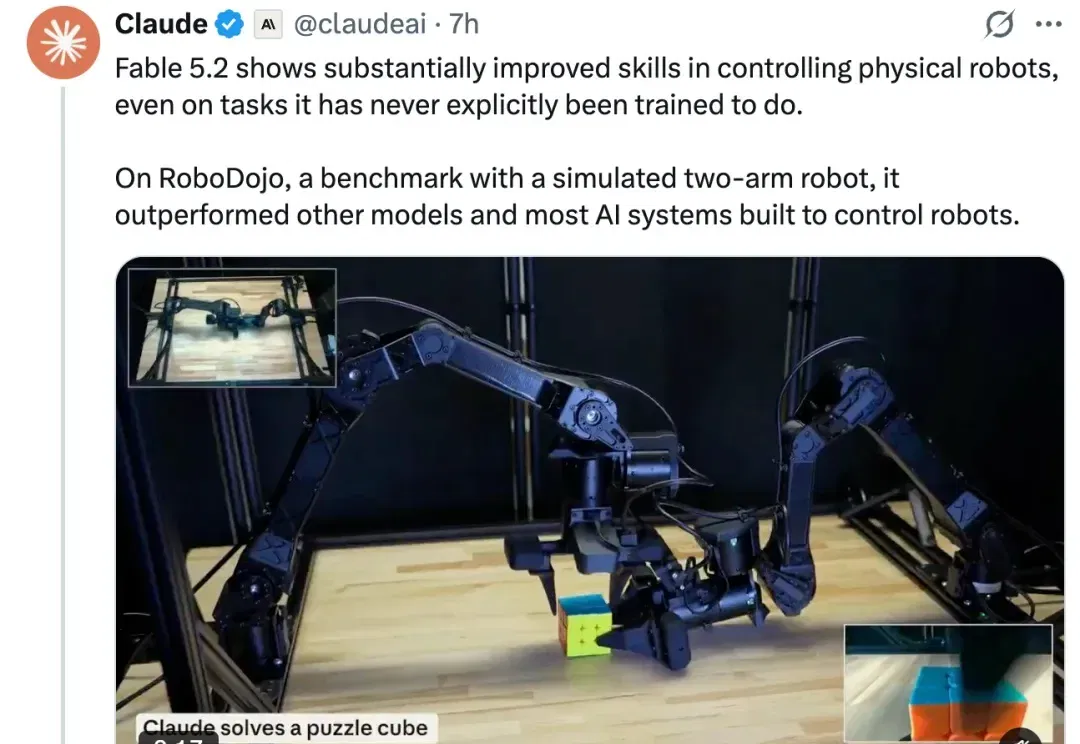
在 Anthropic 公布的评测结果中,Fable 5.2 在 RoboDojo Sim 双臂机器人仿真评测中取得了 64.9% 的正确率,较上一代 Fable 5.1 大幅提升,也显著领先 GPT-6 Astra。Anthropic 还展示了模型完成拧瓶盖、操作魔方、绘画等机器人任务的能力。通用的物理行动能力正在成为前沿模型竞争的新焦点。
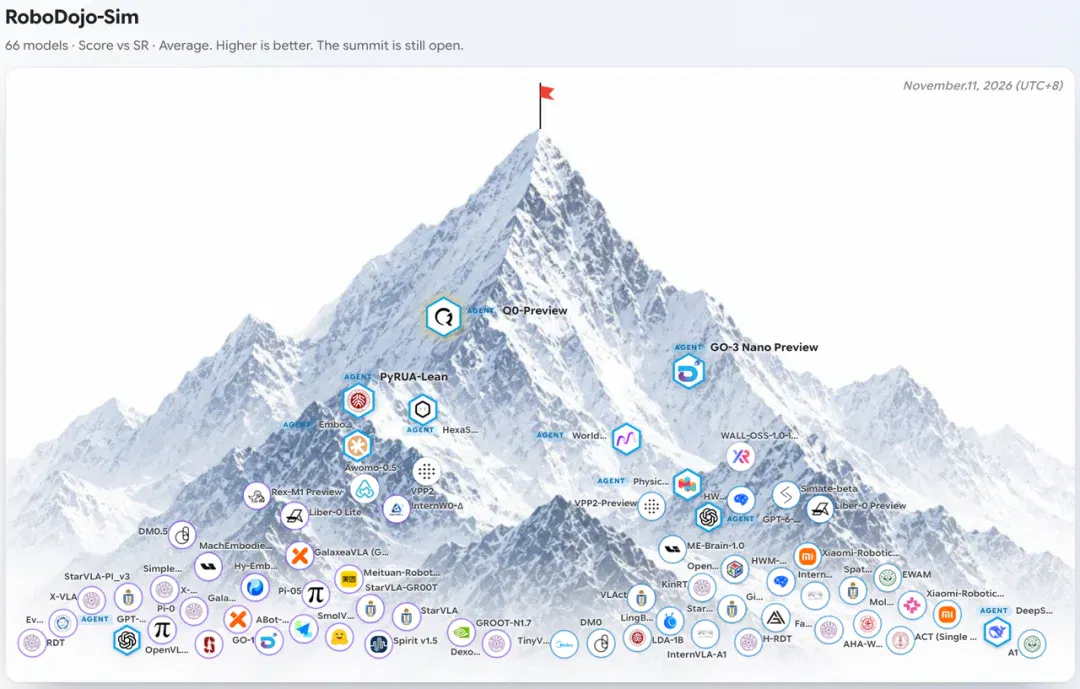
截至 11 月 11 日,在 Robodojo Sim Agent 榜单上,Claude Fable 5.2 可以排名第二,仅次于 10 月 30 日登榜的 Q0-Preview :任务成功率达到 68.87%,综合得分 74.2。Q0-Preview 也是该榜单开榜以来首个综合得分突破 70 的方案。比成绩更值得关注的是技术路径。Q0-Preview 没有沿用 VLA 或 WAM 技术范式,而是采用 Agent 路线,探索如何发挥前沿多模态大模型的任务规划、空间感知、记忆反馈、工具调用等复合能力,自主实现复杂物理操作任务。
令人惊讶的是,Q0-Preview 背后驱动的基座大模型竟然不是广受好评的 GPT 6 Astra,而是 Claude 的上一代模型 Opus 5.5!而 Anthropic 官方汇报 Opus 5.5 的正确率仅有 39.4。因此,当通用大模型开始加速进入物理世界,更深层的问题也随之浮现:通用大模型的物理行动能力边界在哪里?如何融合大模型的空间理解和推理能力和对具身的 know-how 得到更好的物理行动能力?
本文作为 Q0-Preview 的技术前瞻,简要介绍乾章智能(Qoo Tech)在 Physical Agent 上的探索。
Q0-Preview 官测代码已开源。
GitHub 地址:https://github.com/XPolicyLab/XPolicyLab/tree/main/policy/Q0_Preview
一个开放性的问题:驱动大模型进行具身操作的本质是什么?
Q0-Preview 的核心观点是:确定每个操作阶段的接触位置与接触姿态。
以抓取苹果这个简单任务为例,识别到苹果这个目标物体之后,还需要确定抓取苹果的哪个部位、夹爪从哪个方向接近,以及以什么朝向夹持。将这些判断转化为机械臂的目标位姿,进一步生成可执行动作,这个问题就迎刃而解。
核心方案:空间计算即可具身操作
通用多模态智能体已具有出色的多模态感知和编程能力,但是对于具身控制而言,这两个能力是否能够以及如何充分被利用是一个新的开放性问题。
回到刚刚我们抛出的问题,控制本身即预测接触信息和接触姿态,姿态本身也可以由多个点确定下来,因此多模态智能体在其中就可以承担了一个桥梁的作用,感知多个像素点通过计算的方式计算接触信息在空间的坐标从而实现操作。
因此,Q0-Preview 提出充分利用模型的空间感知与编程能力,即通过单 / 多目观察识别目标像素位置,结合相机内外参与像素坐标计算工具进行空间计算,即将图像中的接触目标像素定位到世界坐标系。
具体而言,对于夹爪,模型可以通过三个空间参考点表达夹爪目标位姿和接触信息,即两个有序点的中点确定参考接触位置、连线确定夹持方向,第三个点补充接近方向。由此,位置与姿态的表示以及接触信息被统一为可计算的空间计算问题。
多模态智能体根据观测和指令决定当前阶段的子任务,并提交目标位置姿态与夹爪指令。下游 cuRobo 等运动规划组件将其转化为连续动作。执行后,多模态智能体根据新观测检查结果并调整下一步,形成 “观察 — 计算 — 执行 — 反馈” 的闭环。
Harness:让大模型真正
从 “会算” 到 “会做”
围绕上述核心方案,Q0-Preview 构建了一套 Harness,规范模型与观测、工具及执行模块之间的交互。
1. 明确执行边界以及工具调用
统一模型可获取的观测、机器人状态和先验信息,约定思考与工具调用预算,以及控制指令的输出格式。任务按短动作组推进,在必要的中间阶段设置视觉检查点,根据执行结果决定继续或重新规划。规范模型调用现成或者自行编写程序实现图像裁剪、局部放大等工具辅助空间计算。
2. 通过仿真试错积累通用操作经验
在开发阶段通过仿真试错,总结可供通用的模型参考操作规则。例如,利用空闲手的腕部相机辅助观察、减少遮挡;规划路径时兼顾碰撞规避与后续可见性;根据抓取、搬运和放置等阶段调整运动速度等等。这些技能可以在仿真中学习迁移到真机上。
3. 补充任务要求,明确完成条件
针对部分任务说明较为笼统的问题,Q0-Preview 补充静态任务规则、完成条件及必要的操作建议,减少模型理解与评测要求之间的偏差。执行过程中不会读取任何评测器的实时奖励或环境判定信号。
4. 管理上下文与任务记忆
保留初始信息、近期观测和紧凑的任务记忆,记录已确认的进展、当前状态与后续目标,控制上下文增长带来的开销。同时,通过明确接口隔离上游决策与下游执行,使多阶段操作能够持续衔接。
能力展示
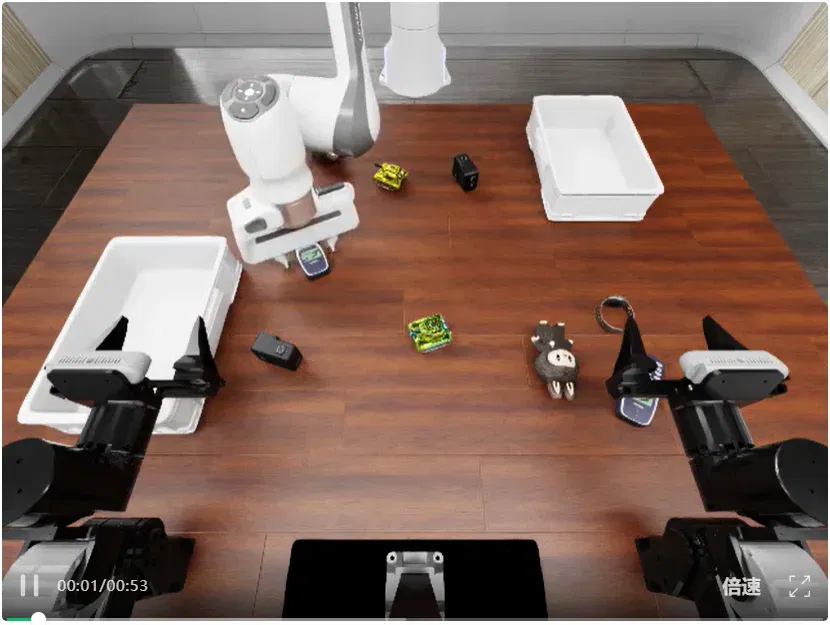
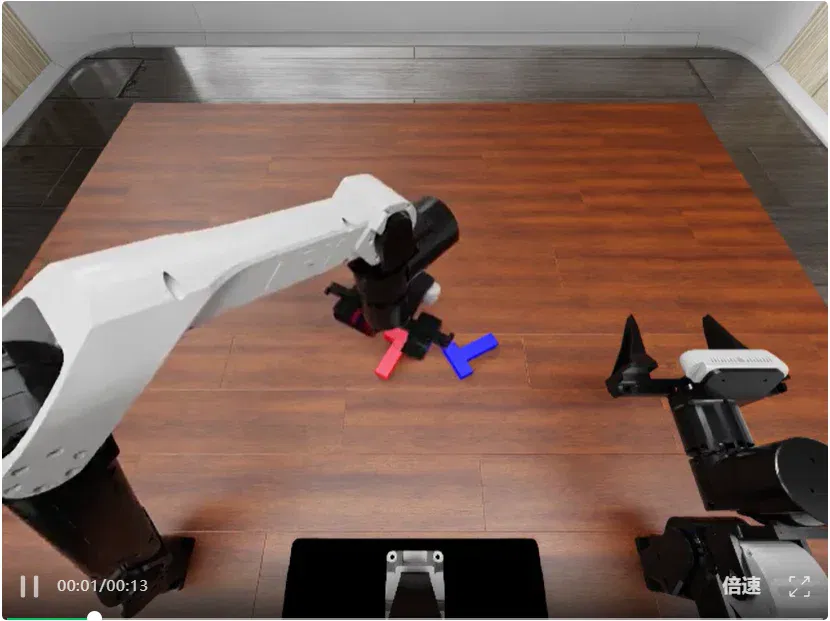
团队演示了部分任务的流畅执行效果,但文中没有提供与专家遥操作在相同条件下的量化对照。
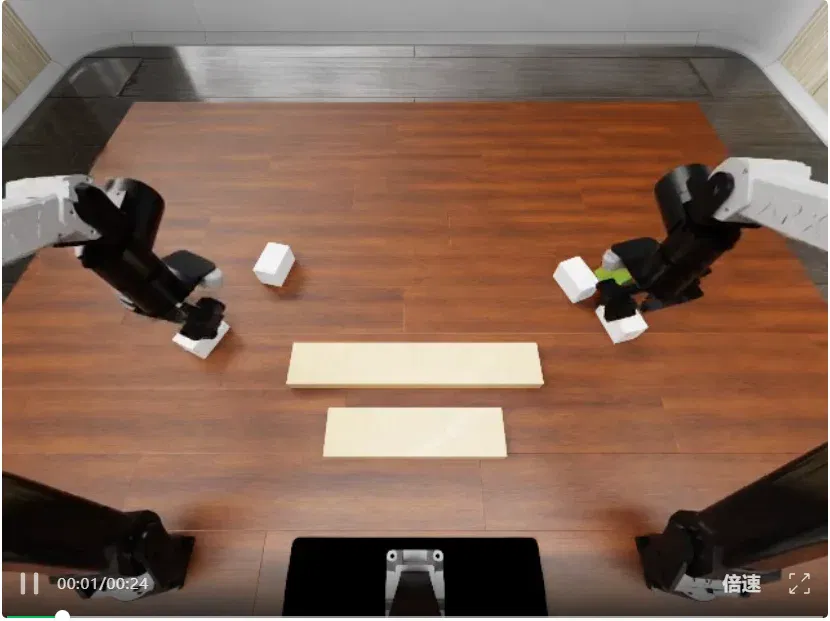
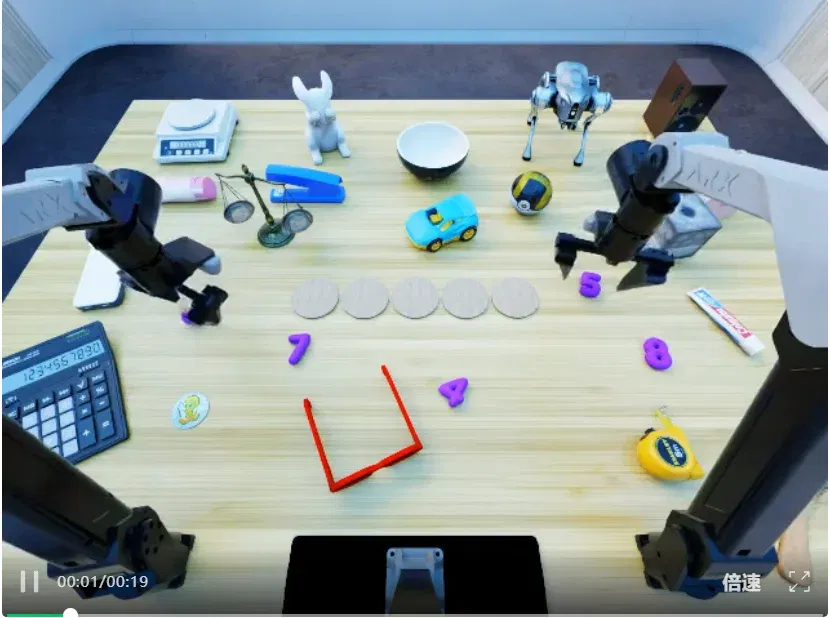
1. 双臂同步操作
在同一行动阶段为左右臂分别设置目标,同步推进可以并行的操作。
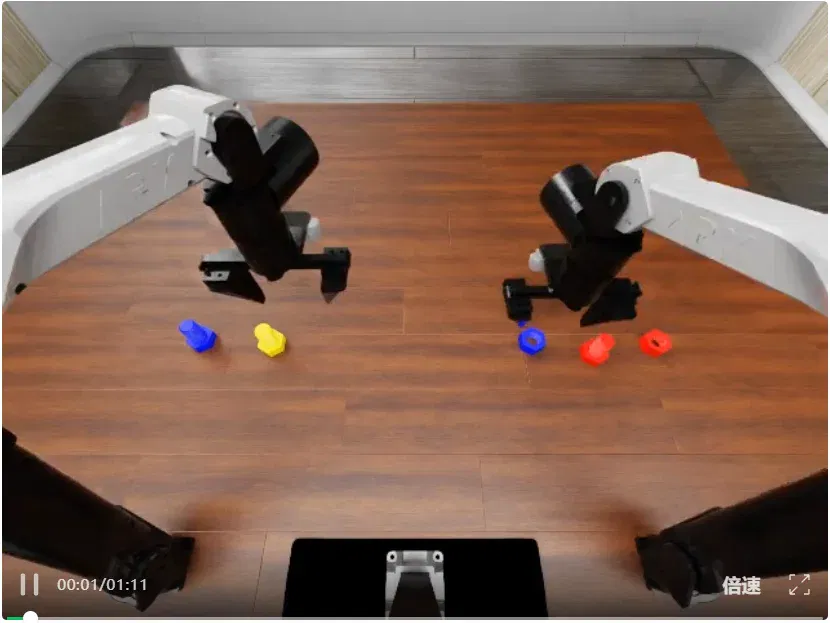
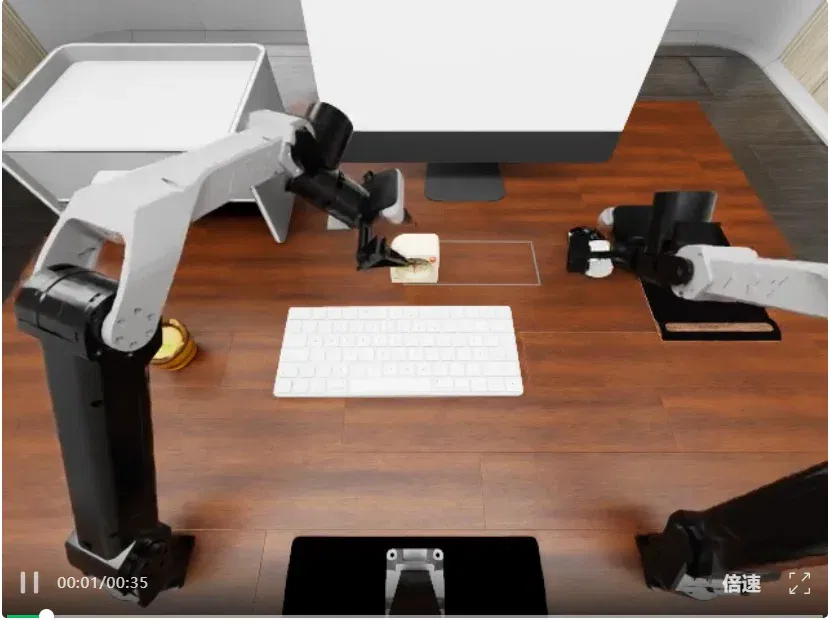
2. 双臂协同操作
围绕共同目标安排双臂分工,根据支撑、交接等动作之间的依赖关系协调执行。
3. 精准操作
通过多视角观察后的空间计算确定位置和朝向,并利用接近后的新观测修正偏差。
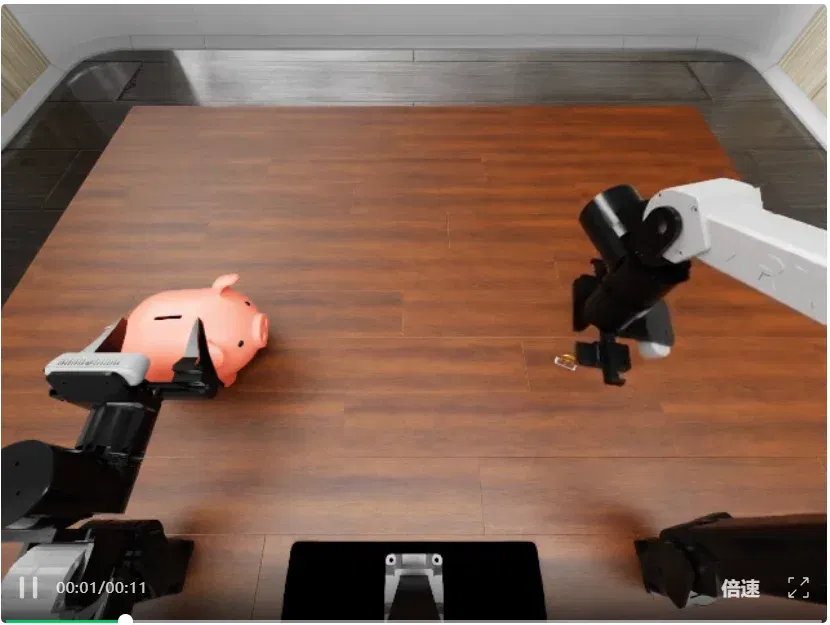
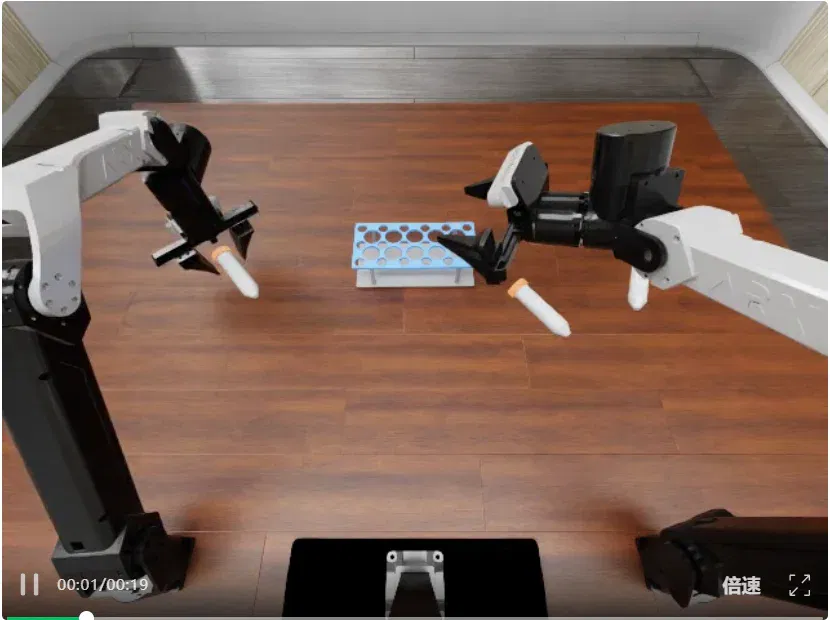
4. 自适应调整
根据物体状态变化和动作执行结果,重新定位目标、调整姿态或修订操作计划。
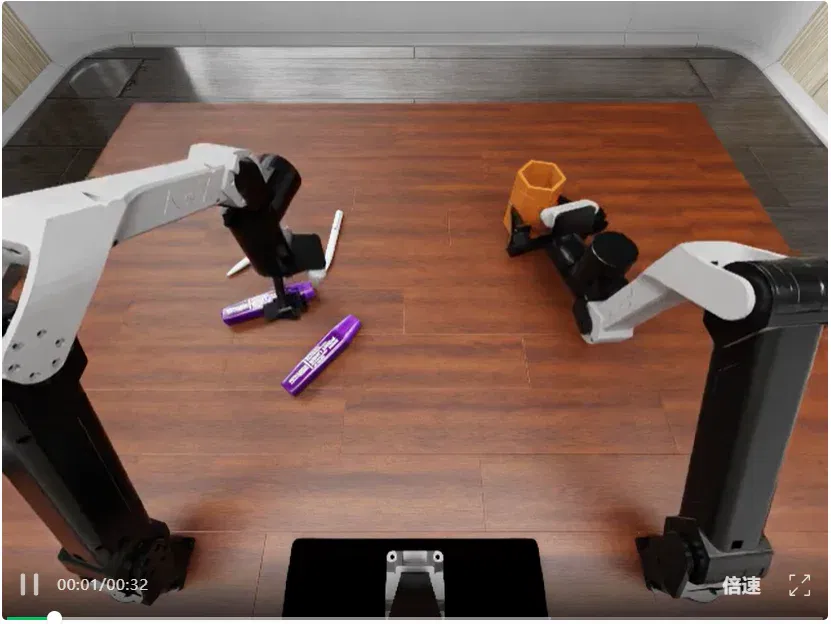
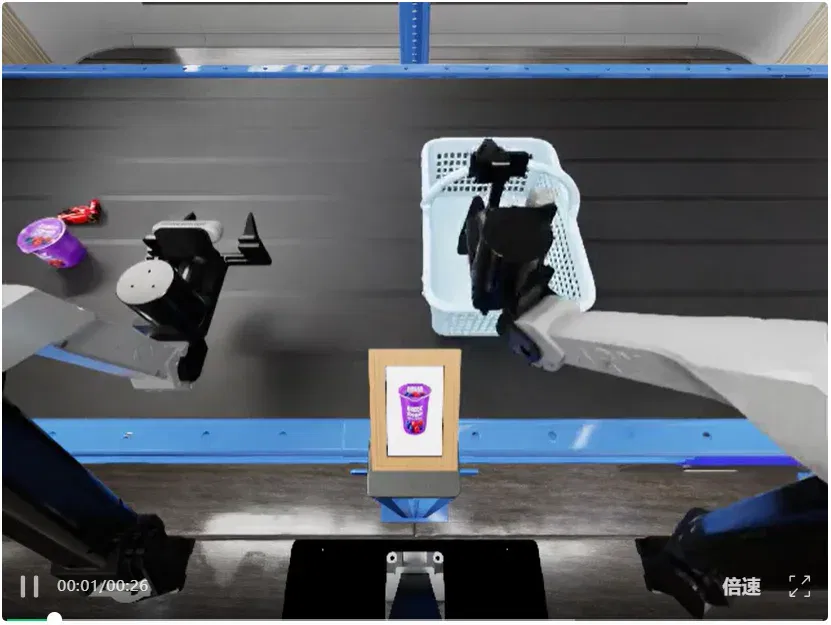
5. 记忆
保留此前获得的信息与已完成步骤,在后续阶段据此决策,完成依赖历史信息的任务。
物理智能的真正挑战才刚刚开始
乾章智能(Qoo Tech)提出的 Q0-Preview 展示了前沿基础大模型在具身操作中的潜力。基础大模型正在为具身领域带来新的技术拐点:将语义理解、空间推理和工具调用,与机器人操作中的关键约束相结合,有机会以简洁直接的方法取得显著进展。
然而,要想推动基础大模型在真实具身环境和任务上落地,仍面临多方面严峻挑战。
首先是推理效率与成本。前沿大模型为了完成看似简单的具身操作,可能消耗百万级 Token 和数小时的推理时间。这样的时间与经济成本,距离实际部署的要求仍有明显差距。如何在保持操作能力的同时,减少冗余推理与工具调用,提高决策效率,是具身 Agent 必须解决的问题。
更基础的问题是:大模型的具身操作能力究竟来源于哪里?GPT 6 Astra 是前沿大模型投向具身领域的一声惊雷,其时外界纷纷猜测 GPT 6 Astra 的训练数据添加了非常多的具身 EGO 数据,因而带来了空间理解和具身操作能力的跃迁。然而,Q0-Preview 基于 Opus 5.5 的实践,促使我们进一步思考:具身数据、代码生成、工具调用乃至三维生成等因素,到底是谁对大模型物理操作能力产生了突出贡献?模型自身的能力与 Harness 的设计又如何相互作用?这些问题尚不能由单一的榜单成绩回答,需要通过系统性的对照实验厘清,才能为未来的数据建设、训练目标与系统设计提供更明确的方向。
此外,较长的推理延迟,也限制了当前具身 Agent 对动态环境的适应能力。在真实世界中,物体与环境不会等待模型完成思考,观测到执行之间的变化可能使原有计划失效。如何及时响应动态变化,将视觉与力、触觉反馈结合,并在长期运行中应对扰动、恢复失败、保持操作可靠性,仍需要持续探索。
尽管上述挑战仍待解决,基础大模型展现出的零样本泛化能力,已经为具身智能带来了新的技术路径。Q0-Preview 的探索让我们看到,将通用模型能力与具身领域的知识和约束相结合,有望持续拓展机器人的任务边界。基础大模型所开启的可能性,正在预示具身智能新拐点的到来!
团队将近期发布技术报告与更快速干净的新版代码,补充技术细节、展示更多真机实验,并进一步讨论当前方法的能力边界与后续方向。敬请期待!
文章来自于"机器之心",作者 "机器之心"。
相关主题
读完之后
加入 AINRK 交流群
了解加入交流群的方式,与更多 AI 从业者交流。
相关文章
继续阅读相关主题与同栏目内容。
智元 LIFE 连接持续感知与长期记忆,测试机器人回看一天经历(在新窗口打开)
框架结合 RoboBeats、可塑性记忆和工具探索。团队报告指定硬件上的感知延迟、视频问答及少量真机记忆实验。
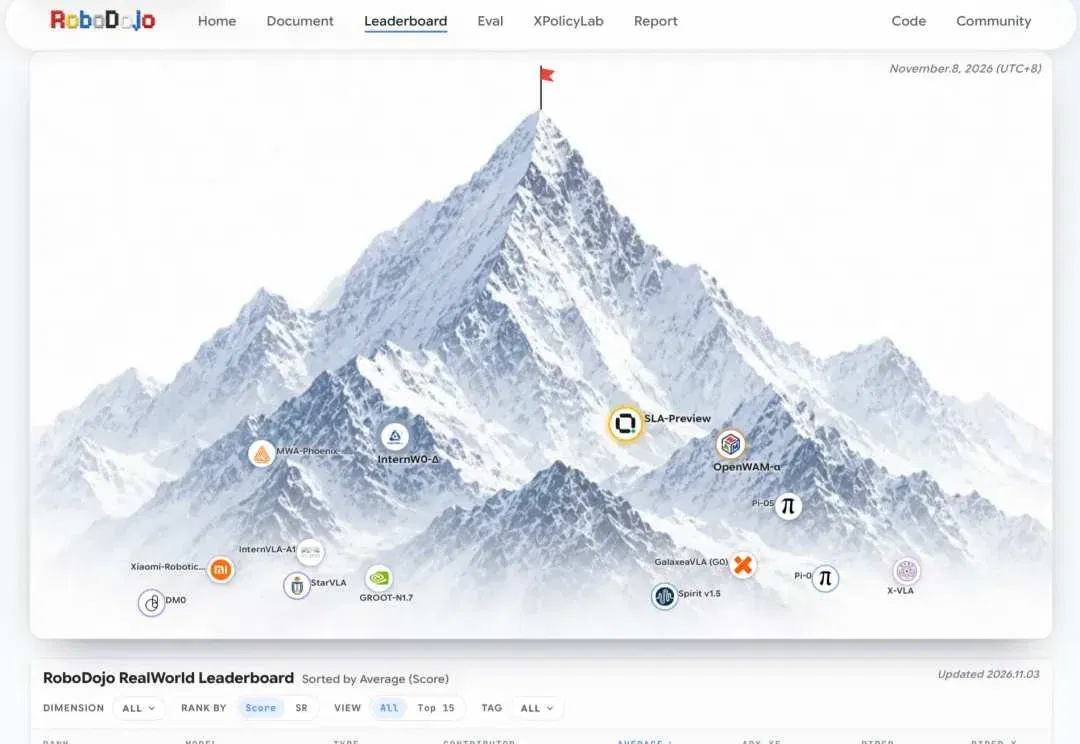
SLA 把空间监督引入持续预训练,测试机器人应对场景变化(在新窗口打开)
港科大广州与欧拉万象团队以多来源机器人数据学习空间表征,在公开榜单、扰动与少样本本体适配实验中报告收益。
Gemini Robotics 2.5 发布,借助 Argon 改进机器人训练(在新窗口打开)
谷歌介绍新版 VLA 的灵巧操作、工厂概念验证和安全测试,并展示通用模型在仿真构建、数据检查及失败分析中的作用。
清华与伯克利开源 uni-robot-agent,统一机器人工具接口(在新窗口打开)
框架以模块化工具连接模型、仿真与真机。论文报告多模型测试、输入条件差异与运行成本,并探索精简工具和异步执行。
蚂蚁灵波开源 LingBot-Touch,用近 5000 小时触觉数据训练机器人感知(在新窗口打开)
LingBot-Touch 统一三种触觉传感器的表示。团队在两款灵巧手、26 项真机任务和 12 项仿真任务上评估了触觉信息的作用。