Milvus Function Chain解读|语义最相似的数据,为什么不一定是业务需要的结果?
语义搜索能够帮用户找到最相关的内容,但有时候,相关性高,并不代表结果就应该被优先展示。
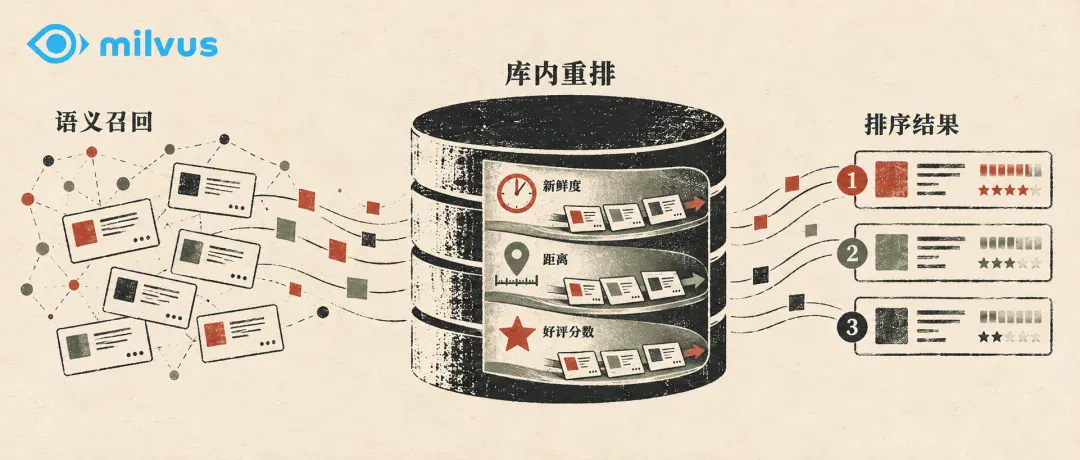
语义搜索能够帮用户找到最相关的内容,但有时候,相关性高,并不代表结果就应该被优先展示。
比如用户搜索「适合小办公室的深色木桌」,向量检索返回了一批描述和图片都符合要求的商品,但语义最相近的那张桌子,价格可能远超用户预期,或者差评多到让人无法下手。
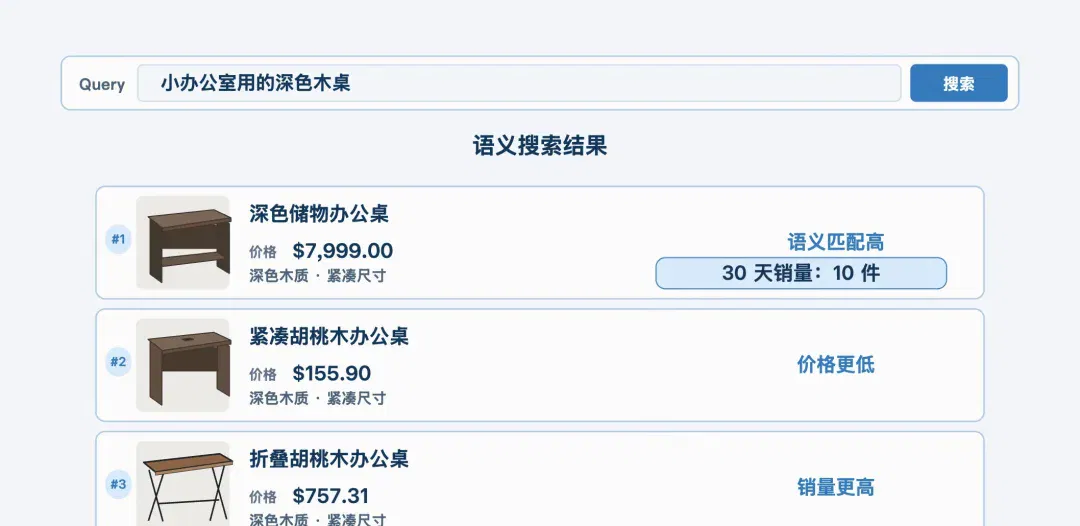
除了在电商搜索中,商品要考虑价格、销量和评价;在企业知识库里,文档的版本、更新时间和来源也同样会影响检索质量。
要解决这种问题,就需要在语义检索结果的基础上,根据价格偏好、评分、销量等信号进行业务重排,并据此决定候选的展示顺序。此外,对于一些有明确预算或者评价分数需求的硬性条件,则可以先通过过滤排除不符合需求的商品。
但过去,开发者往往会在向量数据库完成相似性检索后,再由应用层计算业务特征、调用排序模型,最后返回重排结果。
但在Milvus 3.0 中,我们引入了 Function Chain,将特征计算、分数组合和模型重排组合在一起,开发者可以在检索阶段引入业务排序逻辑,从此不再需要额外维护一整套应用层排序流程。
01
从语义相关到业务排序
原本按语义分数排列的 A、B、C(只取top 3时),在加入业务判断后,可能会变成了E、C、A,不仅排序顺序变了,可能进入候选的数据本身也会同步变化。
这时,把 rerank 下沉在数据库端的好处在于:它能在更大召回池里融合多维度业务信号统一筛选,不会因为语义召回提前截断而漏掉像 E 这类业务更优的候选,同时减少传给业务层的数据量,简化调用链路。
先看一个简单的例子:向量数据库如何在语义相关性之外,引入商品的新鲜度做重排。
以下是使用 decay 将上架时间转换为 0~1 的新鲜度分数,再通过 num_combine 按 8:2 的权重组合语义分数与新鲜度的查询方式。
(上架时间转化为新鲜度的这个特征工程转化的原因在于,时间戳记录的是具体时刻,与语义分数相加会出现数值量级不匹配的情况,也没有办法表达业务希望的衰减速。)
import time
from pymilvus import FunctionChain, FunctionChainStage
from pymilvus.function_chain import col, fn
# Convertthetimestampintoafreshnessfeature.
freshness_expr = fn.decay(
col("release_epoch"), function="exp",
origin=int(time.time()), scale=180 * 86400, decay=0.5,
)
# Combinesemanticrelevancewithfreshness.
ranking_expr = fn.num_combine(
col("$score"), col("freshness"),
mode="weighted", weights=[0.8, 0.2],
)
chain = (
# L0/L1 rescore before global reduction and can change which items reach Top-K.
# L2 reranks the globally reduced pool, which may exceed the final output size.
FunctionChain(FunctionChainStage.L0_RERANK)
.map("freshness", freshness_expr)
.map("$score", ranking_expr)
)
# Runthechainaspartofthesearchrequest.
results = client.search(**search_args, function_chains=chain)
这里的关键是两次 .map():
第一次通过指数衰减,将 release_epoch 转换为 freshness。示例设置了 180 天的衰减尺度,经过这段时间,新鲜度分数降至 0.5。
第二次读取原始 $score 和新生成的 freshness,计算加权分数并更新 $score。随后通过 .sort() 按新分数降序排列。
freshness 是链中的中间特征,不需要提前存储。增加其他排序信号时,可以继续添加 .map(),复用前面已经计算的结果。
实际使用中还需要注意分数尺度:加权前应确认向量分数的取值范围和排序方向,尤其是在使用不同距离度量时。
02
Function Chain 支持哪些排序能力?
除了上面的两个函数,Function Chain 还支持精度处理和模型评分。
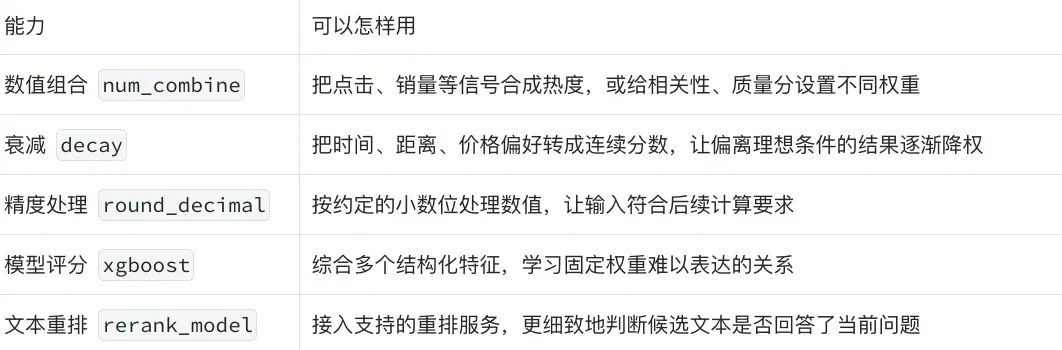
其中,decay 适合表达连续偏好。例如,资讯搜索可以让较旧内容逐渐降权,而不是根据发布时间设置一个突变的排序边界。
同样的机制也可以用于距离、价格等数值特征。调整参考点、衰减尺度和权重,即可实现不同的排序策略。比如,查历史资料时,可以围绕用户关心的日期打分;找近期动态时,再提高新鲜度的影响。
03
从手写规则,走到模型重排
对于少量且关系明确的业务信号,手工规则通常足够。但当排序涉及多个特征及其非线性关系时,固定权重就不一定能表达实际业务目标。
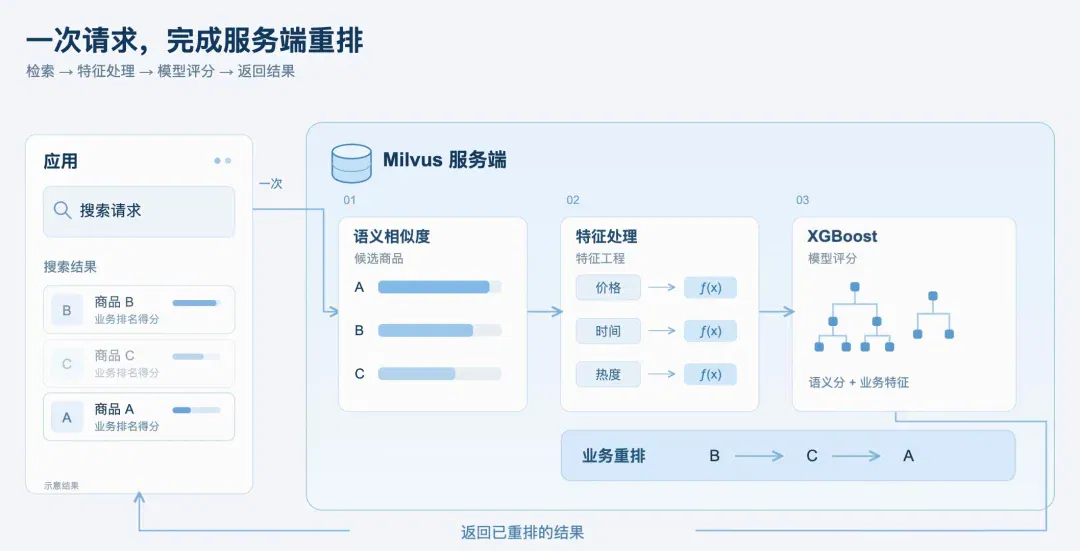
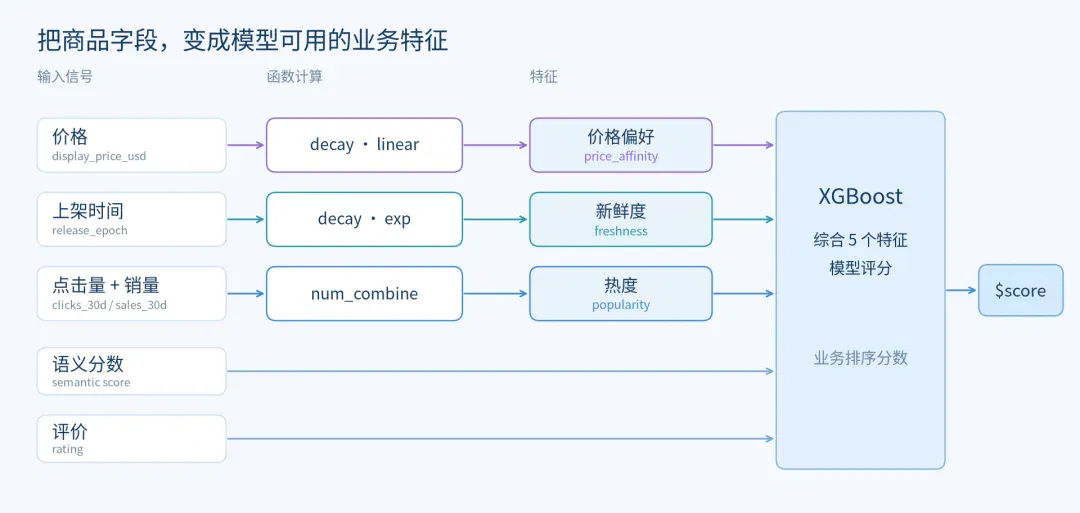
Function Chain 支持接入训练好的 XGBoost 模型,将特征工程与模型评分串联起来。
以电商搜索为例,可以通过 num_combine 将点击量和销量组合成热度,通过 decay 计算价格偏好与新鲜度,再将这些特征与语义分数、商品评价一起输入 XGBoost,得到新的排序分数。
XGBoost 模型可以离线训练,并作为 FileResource 注册到 Milvus,在 L0 阶段执行推理。这样,模型可以直接消费 Function Chain 生成的特征,而不需要应用层重新组装候选数据。
除了 XGBoost,还可以通过 rerank_model 接入支持的文本 Rerank 模型或服务。比如 Cross-Encoder 类,Voyage,Cohere 等模型,会把查询与候选文本一起判断,更细致地比较哪一段真正回答了问题。
两类模型解决的问题有所不同:XGBoost 更适合综合结构化业务特征,文本 Rerank 模型则更侧重查询与内容之间的语义匹配。开发者可以根据排序目标选择相应的函数和模型。
04
重排应该发生在搜索的哪个阶段?
Function Chain 不只支持组合函数,还允许开发者指定重排的执行阶段。
Milvus 3.0 提供 L0、L1、L2 等重排阶段。它们的区别在于执行位置:
L0 和 L1 在全局结果汇总前执行。较早引入业务分数,可以改变哪些候选进入后续的 Top-K 结果。
L2 在全局汇总后执行。它适合对已经汇总的候选池进行更精细的排序,但无法重新找回此前被淘汰的候选。
因此,重排阶段的选择不仅影响执行位置,也影响业务信号能够介入的候选范围。
对于前面的简单规则,以及原生 XGBoost 评分,可以在 Milvus 服务端完成相关计算。应用只需发起一次带 Function Chain 的搜索请求,便能获得重排后的结果。
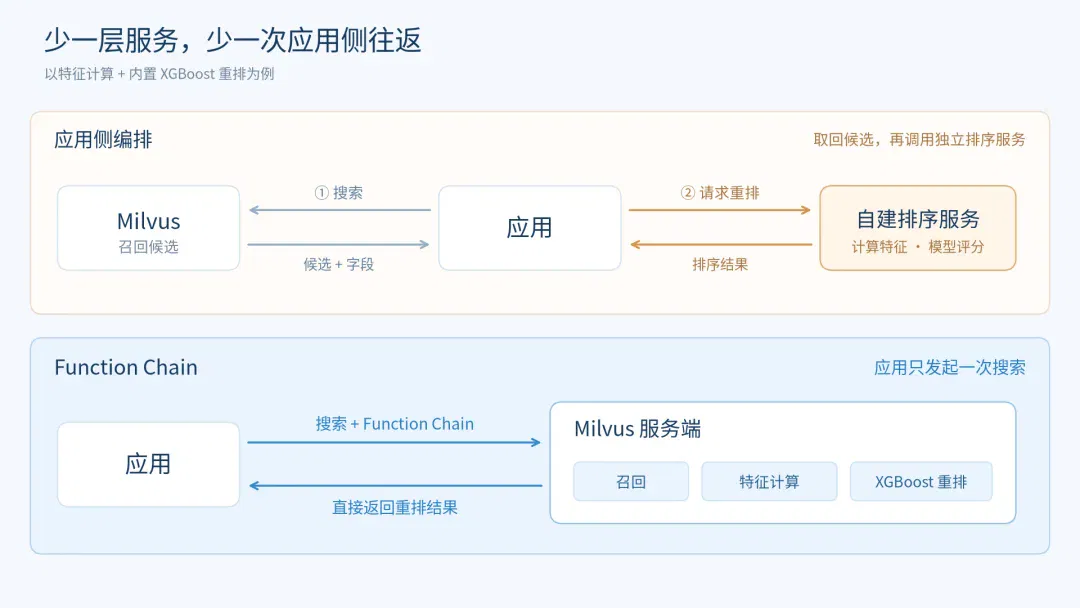
如果使用外部 Rerank API,Milvus 也可以负责发起模型调用。应用侧仍然只需提交一次搜索请求,但外部模型本身的网络延迟和推理成本依然存在。
05
不止于电商搜索
Function Chain 的价值并不局限于商品排序。只要业务能够提供额外的排序信号,就可以采用类似的处理方式。
资讯和社区搜索可以结合发布时间、内容质量与热度;
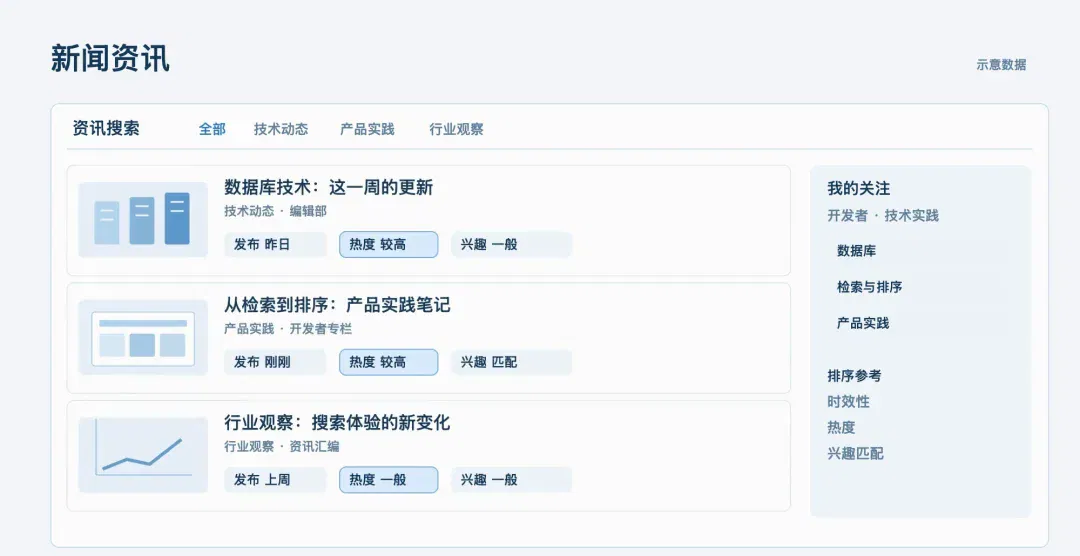
企业知识库可以考虑文档版本、更新时间和来源可信度;Agent 的工具检索则可以纳入工具适用条件、历史成功率和调用成本。对于记忆检索,还可以考虑记录的时效性及其与当前任务的关联程度。
这些场景使用的信号不同,但排序机制相似:先通过检索获得候选,再利用业务特征和模型进一步决定结果顺序。
此外,我们准备了一个电商搜索 Demo,可以直接对比纯语义排序与引入业务信号后的排序结果,观察商品顺序如何变化。链接在: https://demos.milvus.io/function-chain-rerank/
张晨
Algorithm Engineer at Zilliz
文章来自于"Zilliz",作者 "张晨"。
相关主题
读完之后
加入 AINRK 交流群
了解加入交流群的方式,与更多 AI 从业者交流。
相关文章
继续阅读AI技术文章栏目中的内容。
AI终身学习新解法:成功经验自蒸馏进权重,交互轮数直接减半(在新窗口打开)
LLM智能体如何在部署过程中,通过自身执行持续进化?
先在平行世界里试一试,机器人再动手:清华提出ParallelWorld(在新窗口打开)
机器人动手前,能不能先看一看不同选择会带来什么后果?ParallelWorld 将多步预演引入具身智能体的高层规划,将任务成功率从 56% 提升至 83%。
「牛来」将彻底成为过去式!Hi3D重塑三维模型新高度,V1.0正式开源(在新窗口打开)
自从电影《牛来》现象级爆火,那只造型粗糙、通体发黄的小牛,就成了不少人提起三维建模时的第一反应。
不用反向传播,也能预训练Transformer,Jeff Dean投的这家公司出成果了(在新窗口打开)
训练大模型,能不能不用反向传播? 这事一直有人琢磨。只是反向传播太成功了:过去这些年,反向传播一直是训练神经网络的唯一主流算法。我们今天所有的架构、优化器、甚至 GPU 硬件,某种意义上都是围着它长出来的。 但一直有人不信这个邪:反向传播要求整个网络处处可微,这其实是个很强的限制,不可微的模块、离散的计算、外部程序,统统进不了训练回路。 那么,如果算力足够便宜,能不能干脆不「算」梯度了,改用一种最原始的思路 —— 随机把网络改一改,看它变好还是变坏,变好的方向就保留,变坏的就扔掉。这种办法笨是笨,但胜在什么都不挑:不管网络内部长什么样、可不可微,它都能用。 一家叫 Q Labs 的小型研究实验
让JEPA真正理解世界背后的生成机制,DSReg让世界模型的每一维都有了真实含义(在新窗口打开)
JEPA 能不能真正理解观测背后的生成机制?