MiniMax M3.1 Flash 正式发布:成本降 70%,速度提 3 倍
刚刚,MiniMax 正式发布了 M3.1 Flash
刚刚,MiniMax 正式发布了 M3.1 Flash
这个模型的预览版,也便是 OpenRouter 上那个匿名模型 Space Bunny 太空兔(匿名期间处理了超过200Ttoken)
前几天大家还在吐槽国模已经好久没声音了,然后我们就看到:周末 DeepSeek 发了 4.1 Flash,现在 MiniMax 带来了正式的 3.1 Flash
是所谓:江山代有才人出,天天都有斩杀线
作为新一代 Flash,M3.1 Flash 在 agent 任务、编程、Computer Use 和网络安全上都是代际提升,线上推理速度提升了近 3 倍,使用成本降了 70%
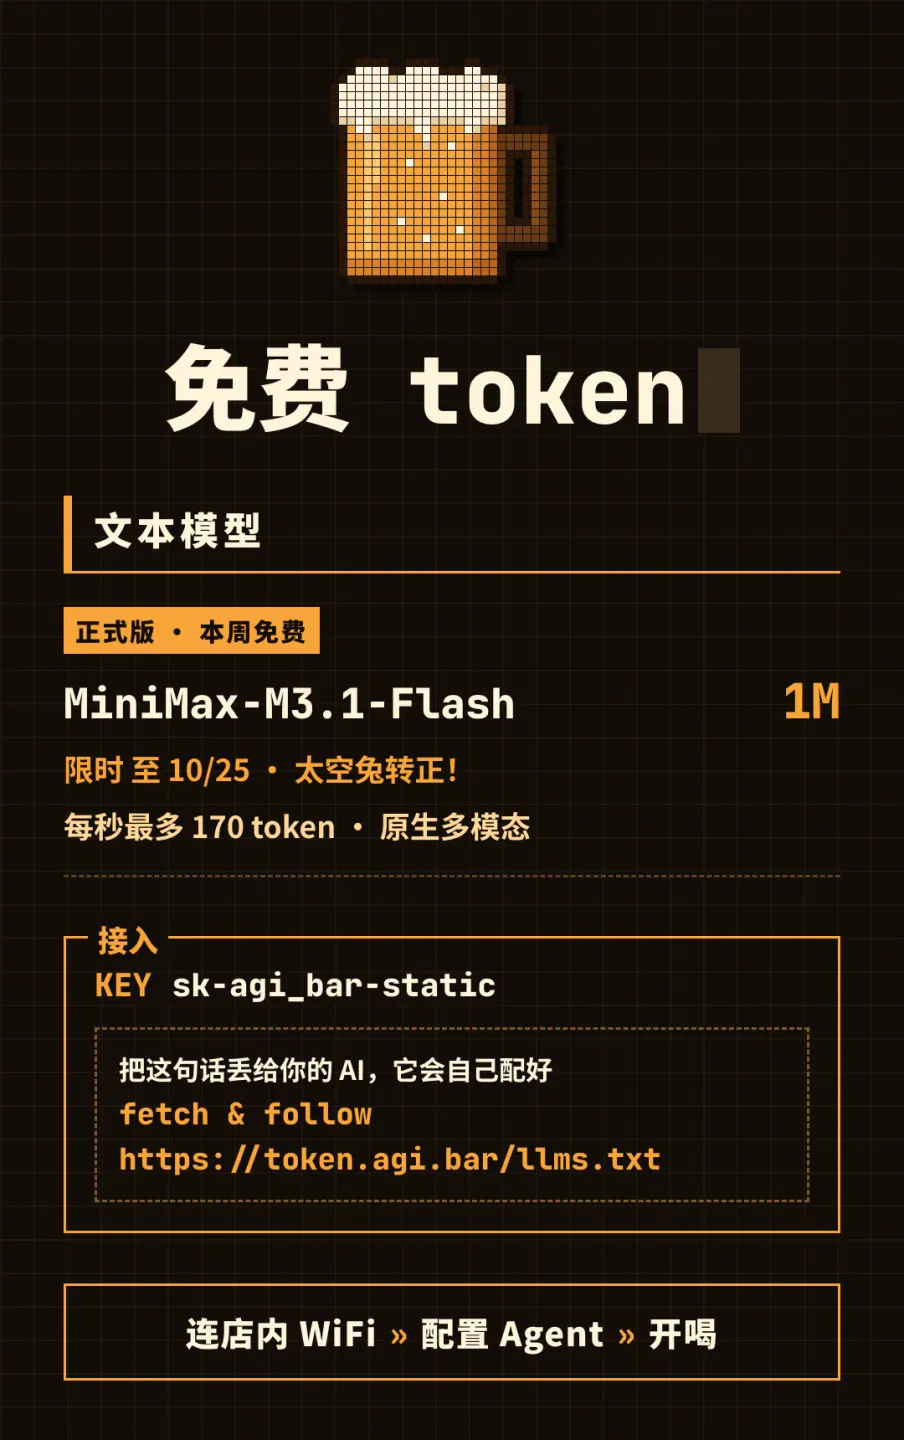
老规矩,这周 M3.1 Flash 在我的 AGI Bar 敞开用,token 免费,开到 10 月 25 日,想上手的朋友直接来酒吧
Benchmark
直接上表格吧
跨系统干活
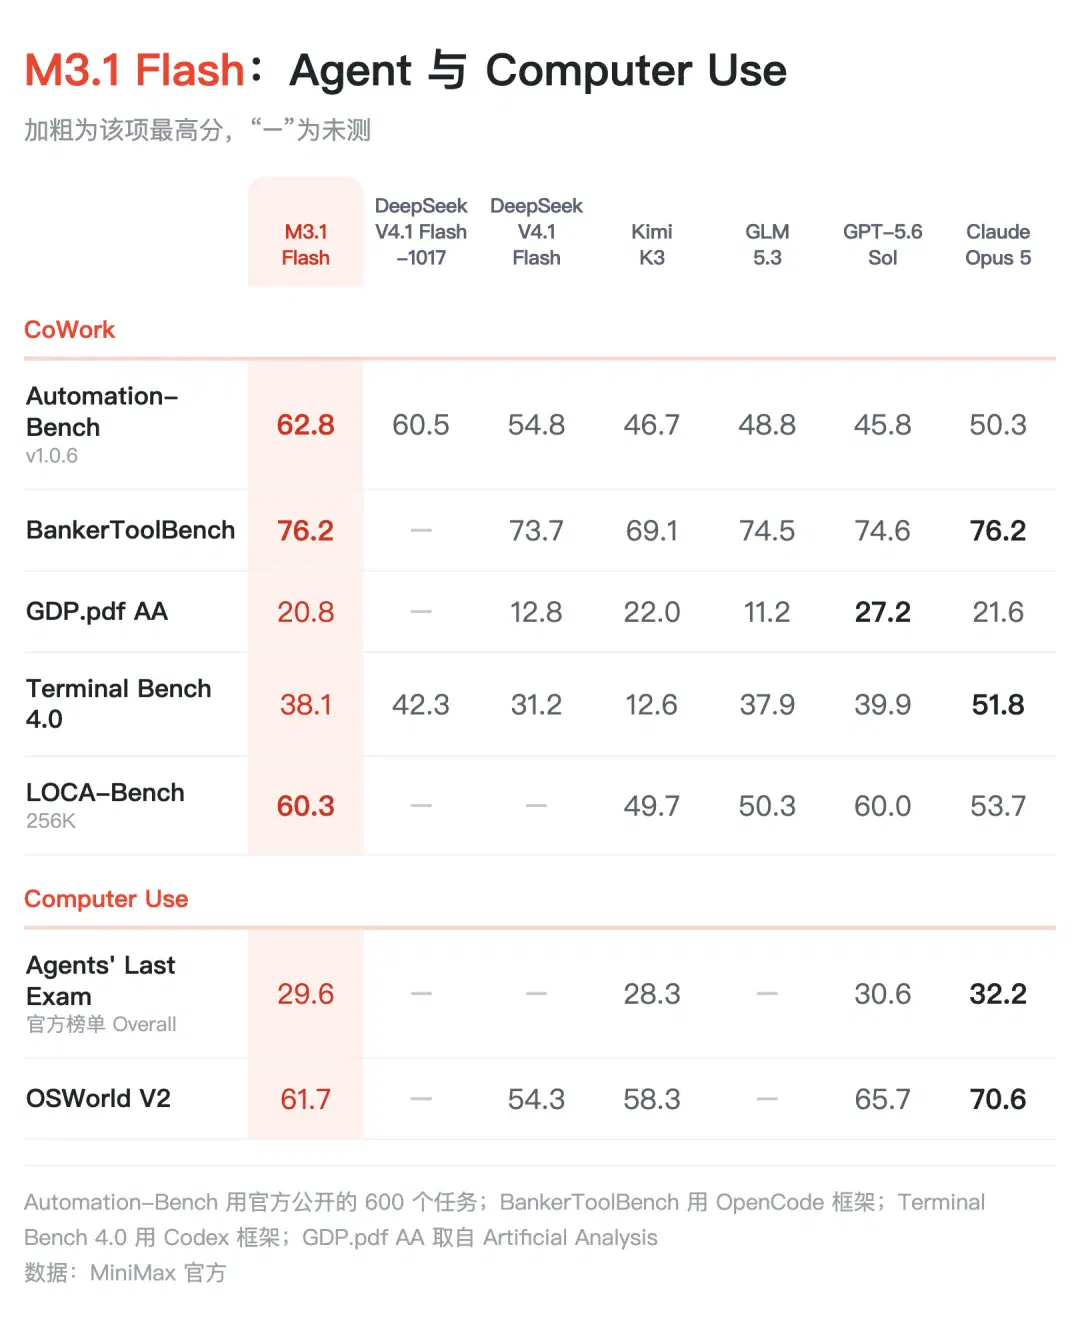
Automation-Bench 是 Zapier 开源的评测,任务取自真实的企业流程,包括销售、营销、运营、客服、财务、HR 等等,模型需要要在好几个 SaaS 系统之间,把一件事从头做到尾
在这个任务里面,M3.1 Flash 拿了62.8,DeepSeek V4.1 Flash-1017 是 60.5,Claude Opus 5 是 50.3
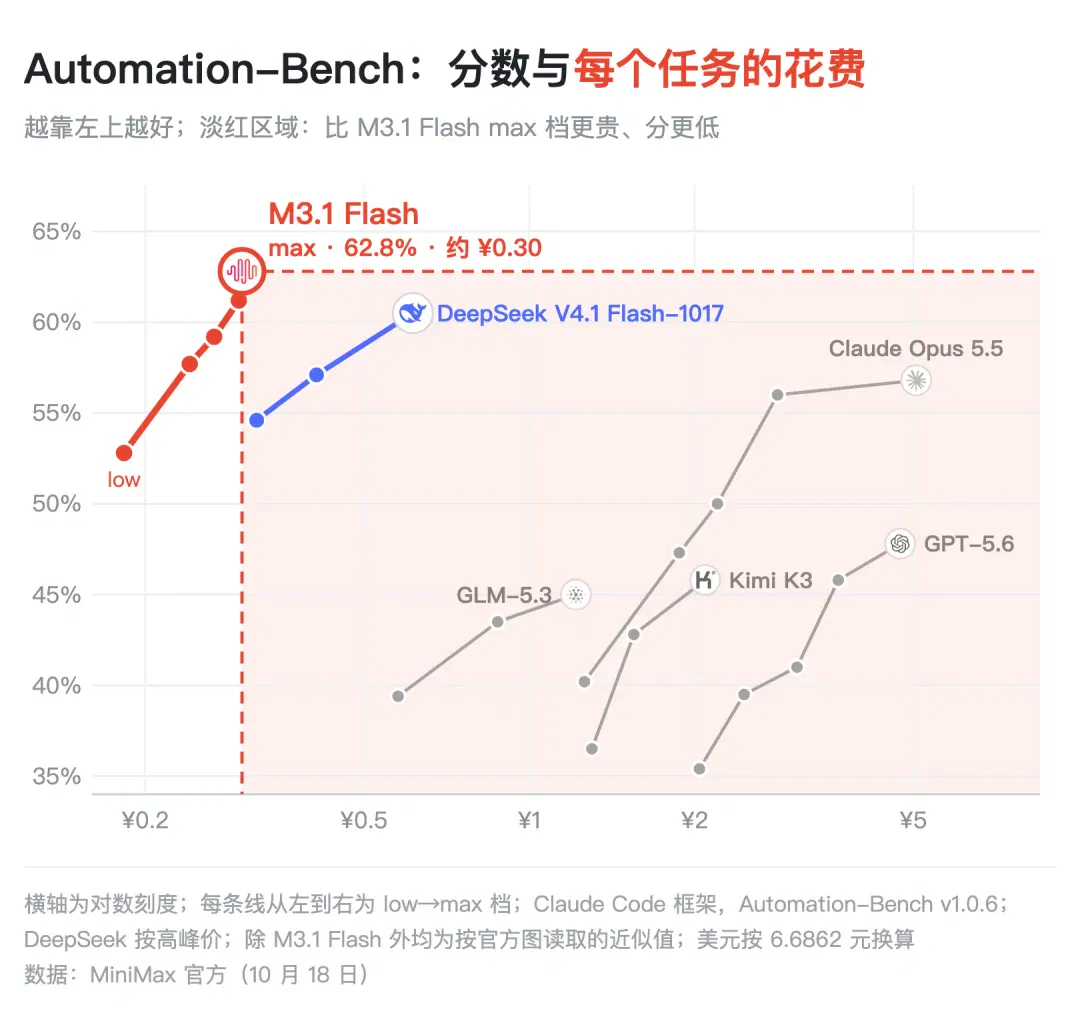
如果把模型开到最高的 max 档,M3.1 Flash 做一个任务平均大约 3 毛钱,最便宜的 low 档不到 2 毛
作为对比,DeepSeek V4.1 Flash-1017 按高峰价算,max 档每个任务大约 6 毛,Claude Opus 5.5 的 max 档大约 5 块
操作电脑
这次新加了两个 Computer Use 的榜:
- OSWorld V2:香港大学 XLANG Lab 牵头,108 个长流程任务,覆盖 7 大领域,熟练的人做完一个,中位数要 1.6 小时左右
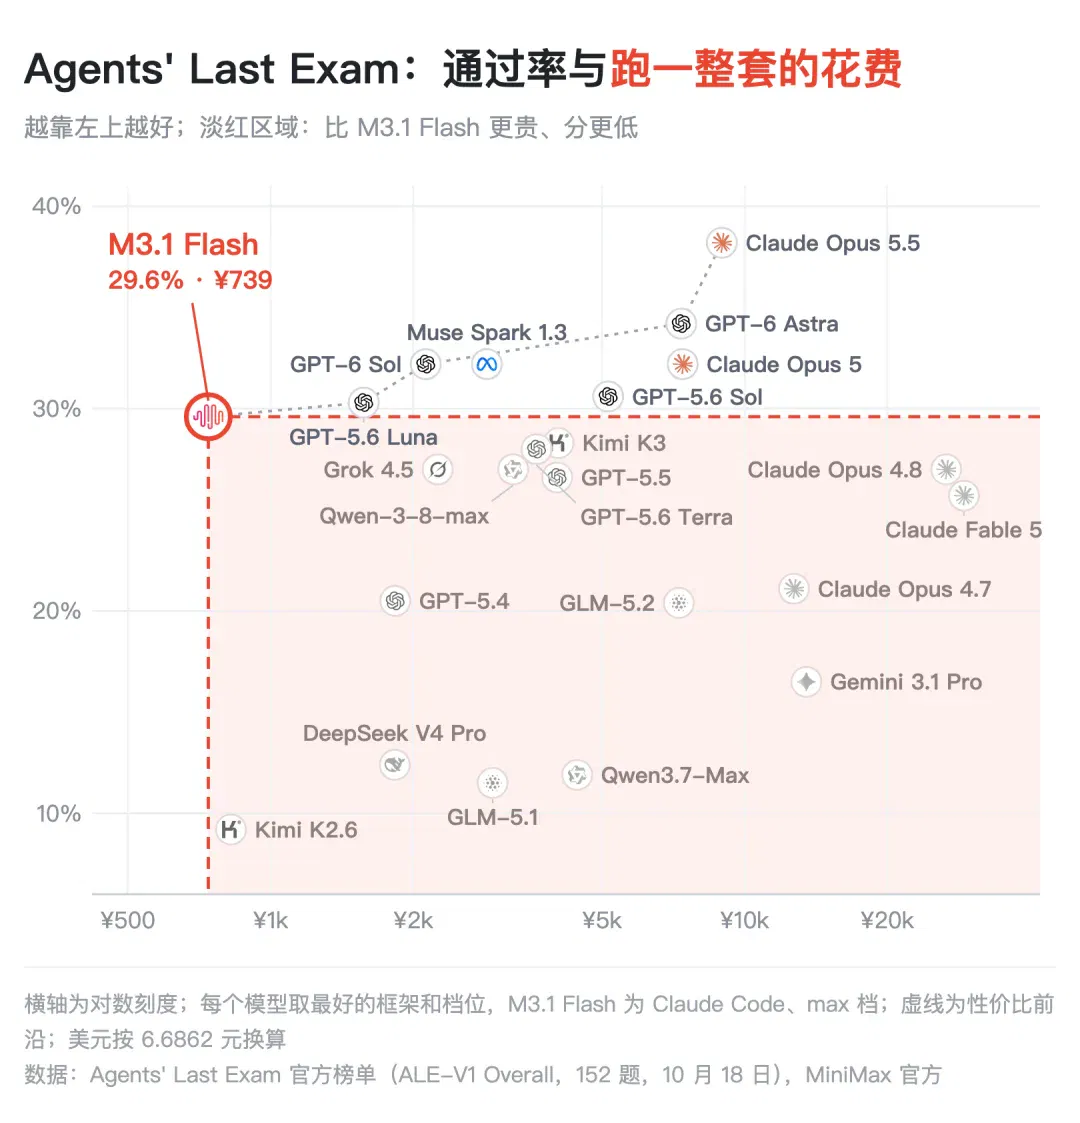
- Agents' Last Exam(ALE):伯克利 RDI 牵头,几百名行业专家一起出题,覆盖 13 大行业、55 个细分领域
M3.1 Flash 在 OSWorld V2 上是 61.7,ALE 上是 29.6,两项都是国产模型第一;跑完整套 ALE 的话,Claude Opus 大约需要 7400 元,是 M3.1 Flash 的 10 倍
写代码
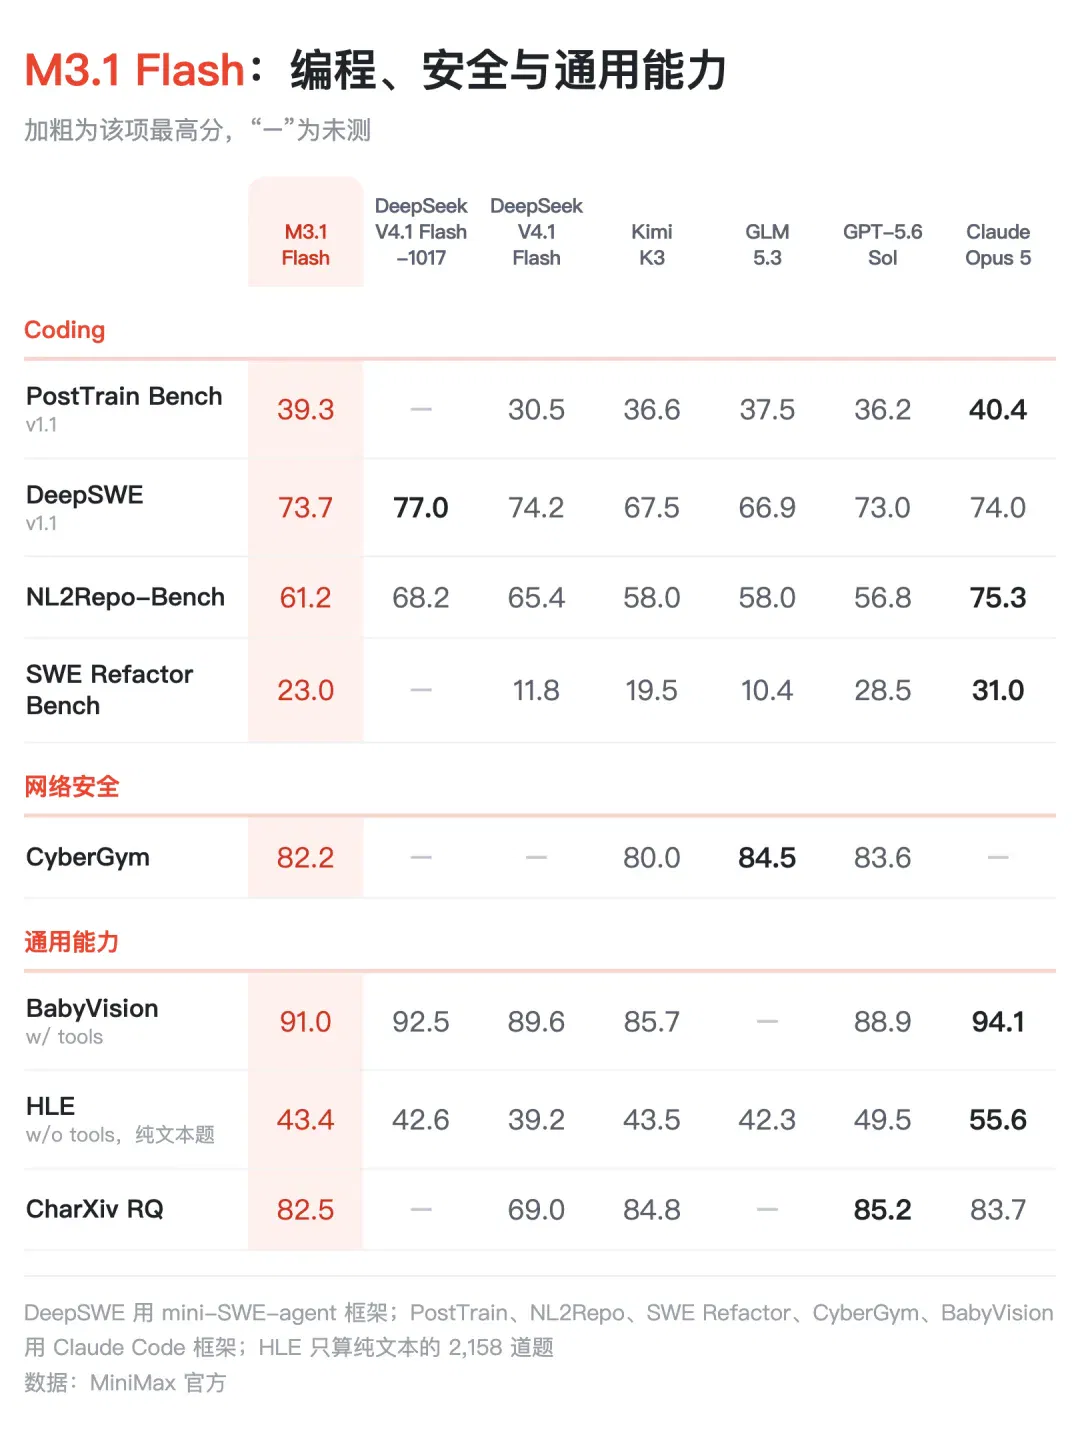
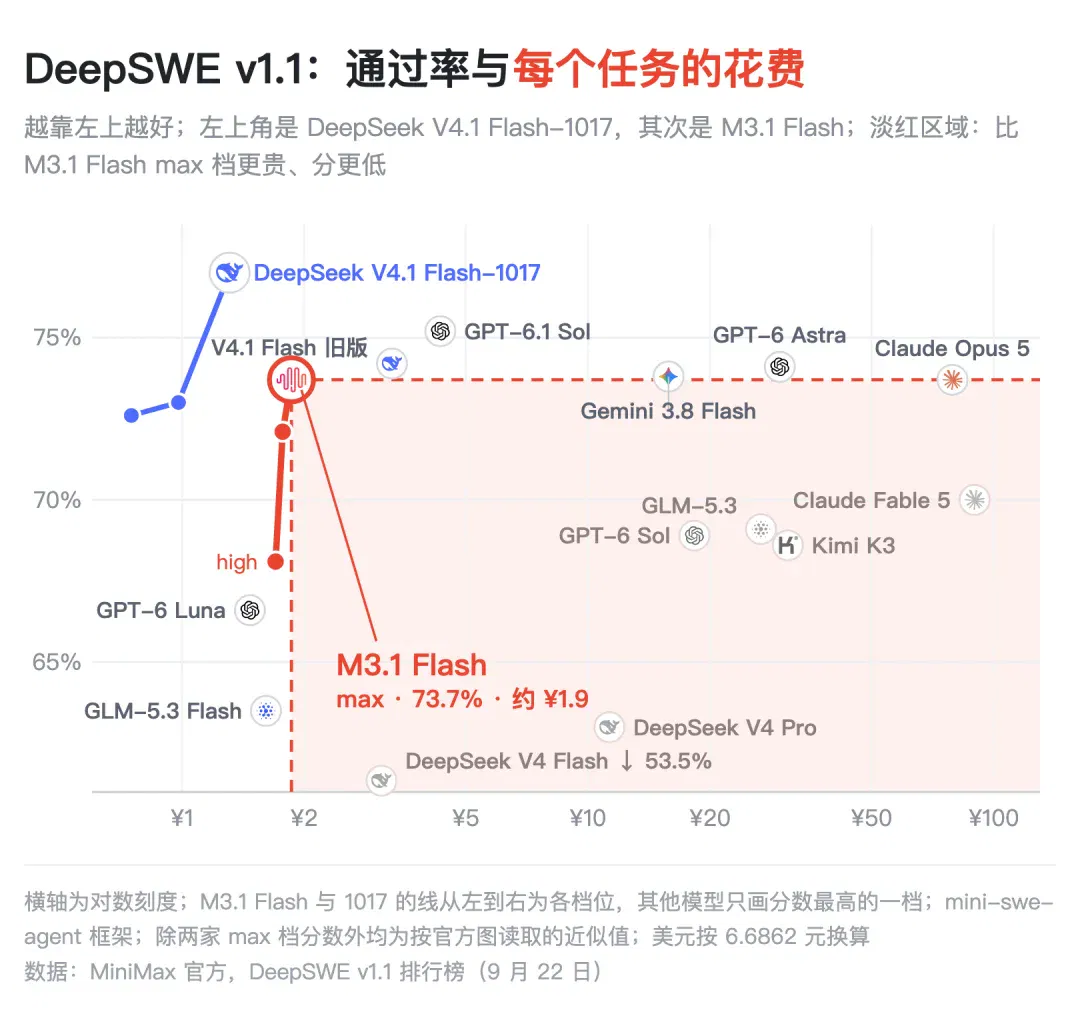
DeepSWE v1.1 上,M3.1 Flash 是 73.7,DeepSeek V4.1 Flash-1017 是 77.0,Claude Opus 5 是 74.0,GPT-5.6 Sol 是 73.0
M3.1 Flash 开到 max 档,每个任务大约 1.9 元;DeepSeek V4.1 Flash-1017 的 max 档大约 1.3 元
写代码的性价比,DeepSeek 第一,M3.1 Flash 第二
安全方面,CyberGym 由伯克利团队构建,收了 188 个真实软件项目里的 1507 个历史漏洞,让模型去分析。M3.1 Flash 拿了 82.2,GLM-5.3 是 84.5,GPT-5.6 Sol 是 83.6
价格
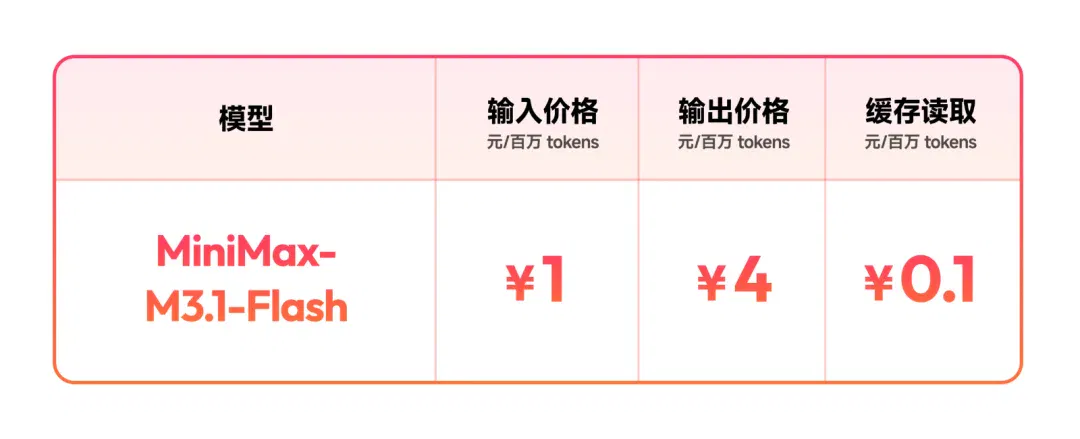
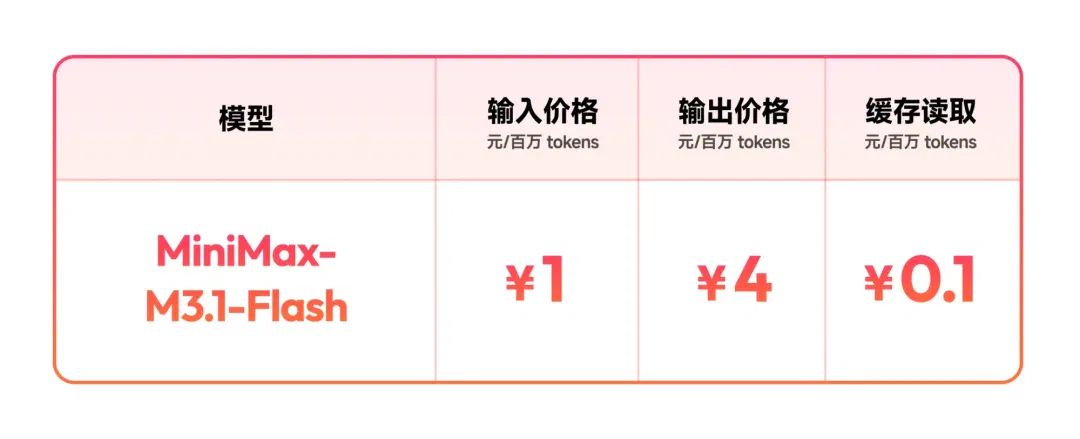
M3.1 Flash 每百万 token:输入 1 元,输出 4 元,缓存读取 0.1 元(折合美元 0.15、0.6、0.015)
再和 DeepSeek V4.1 Flash-1017 比,不命中缓存时,M3.1 Flash 的价格是 DeepSeek 高峰时段的一半,和它闲时一样。DeepSeek 的高峰,是北京时间工作日 9–12 点、14–18 点
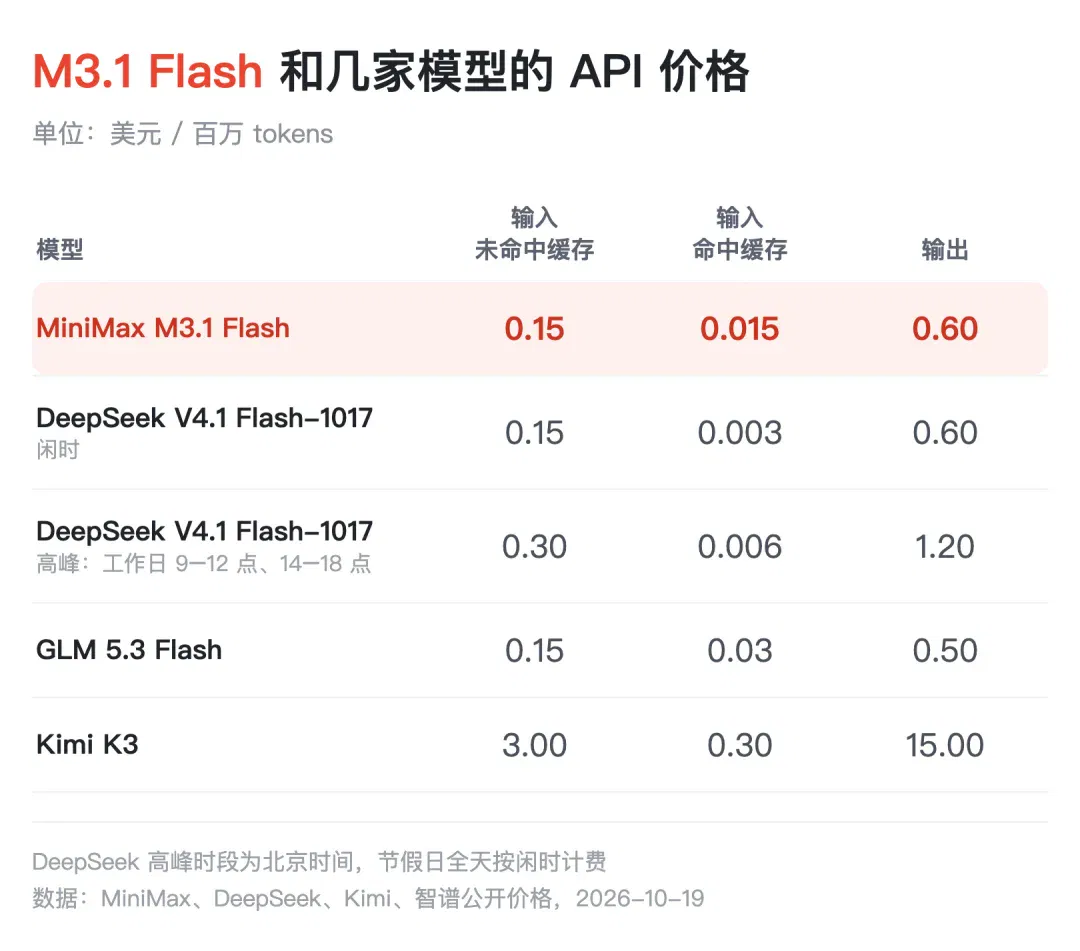
命中缓存的部分,DeepSeek 更便宜。缓存命中率 95% 时,每 10 亿输入 token,M3.1 Flash 大约 21.75 美元,DeepSeek 高峰时段大约 20.7 美元,闲时大约 10.35 美元
最后
还得说一下,作为 Flash 模型,这个模型的速度是相当快的。
正式版用了更激进的稀疏注意力,日常使用时每秒能输出 200 多个 token,中位数稳定在170以上,大概就是下面这个速度对比
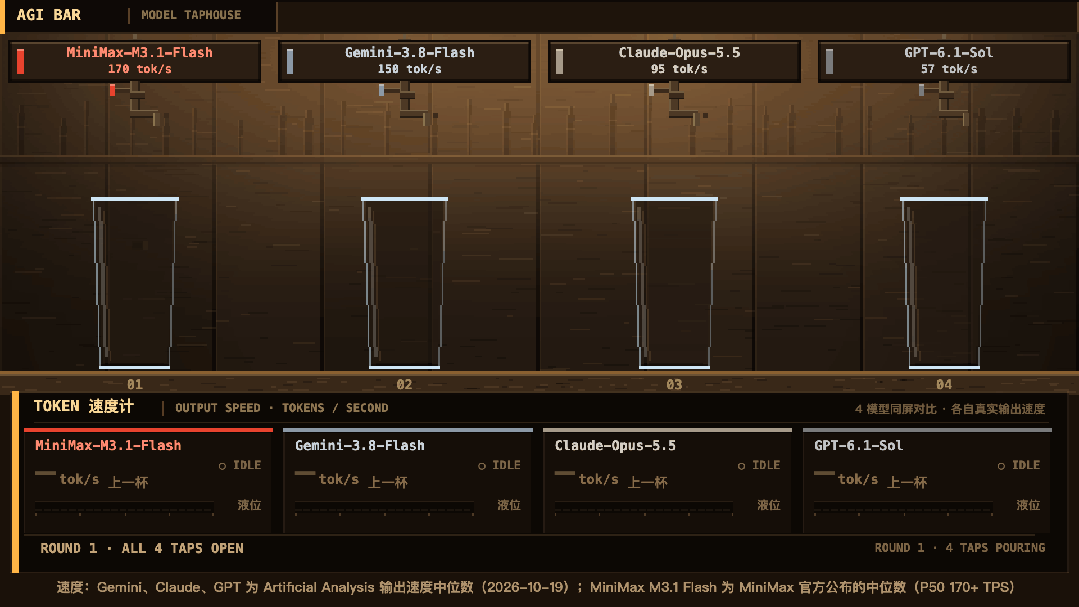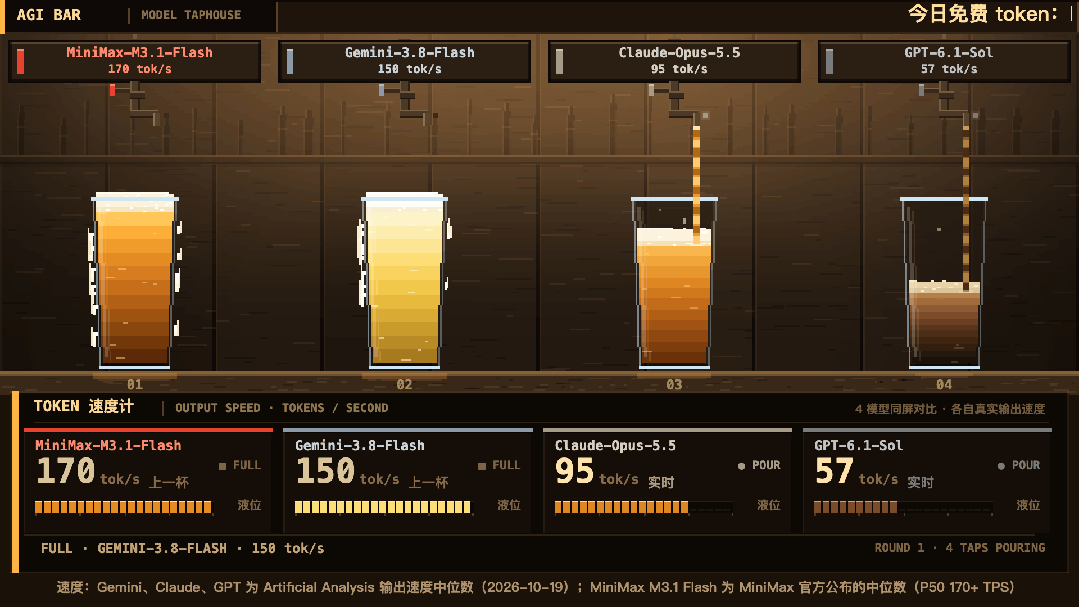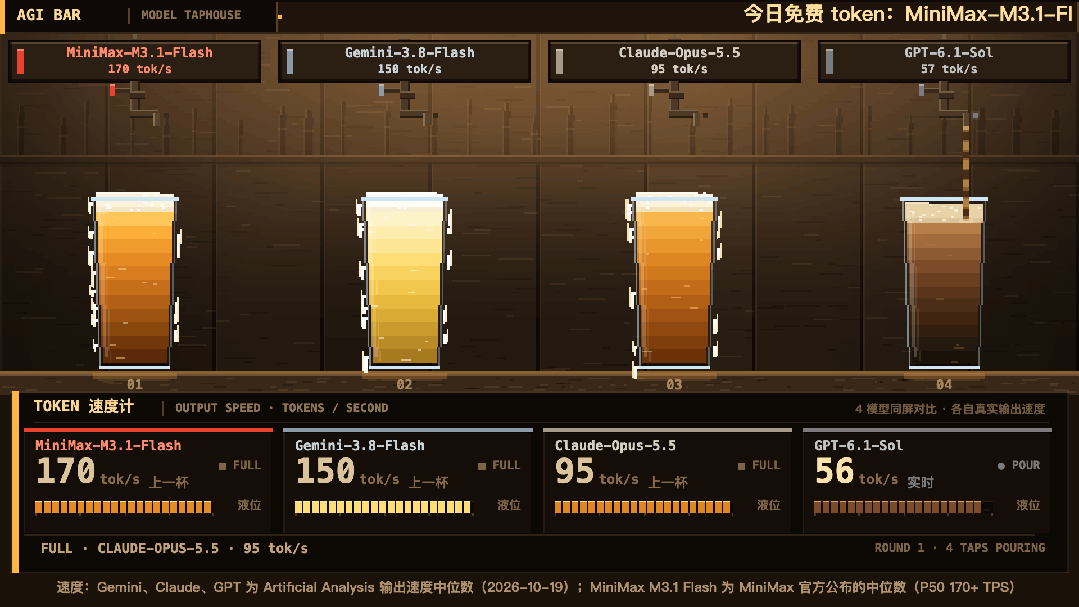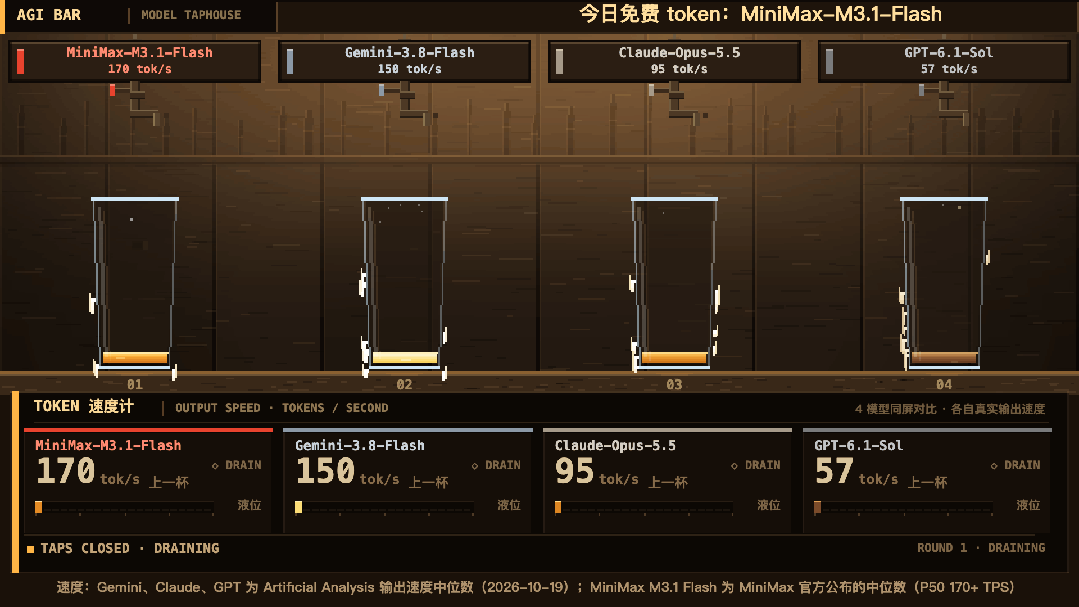
这个速度图,是我用 M3.1 Flash 在 MiniMax Code 里做的
目前,这个款模型已经上线 MiniMax API、M Plan 和 MiniMax Code,可以通过MiniMax-M3.1-Flash进行调用,上下文 100 万 token
权重稍后开放,追求智能上限的 Pro 版也很快会来
文章来自于"赛博禅心",作者 "金色传说大聪明"。
相关主题
读完之后
加入 AINRK 交流群
了解加入交流群的方式,与更多 AI 从业者交流。
相关文章
继续阅读AI资讯栏目中的内容。
清华系AI创企熵简科技完成C轮融资,蚂蚁领投(在新窗口打开)
将联合研发AI金融智能体。 智东西10月19日消息,今日下午,北京AI金融创企熵简科技宣布完成C轮融资,由蚂蚁集团领投,东方国信与乔贝资本跟投。本轮融资后,蚂蚁集团将与熵简科技在AI金融智能体研发、AI金融垂域模型训练等领域展开深度合作。 熵简科技成立于2017年,主要业务为依托大数据、云计算、人工智能等先进技术,打造全资产、全流程的端到端智能资产管理平台。其公司名称的由来是热力学第二定律中对系统混沌程度的度量“熵”,“熵简”寓意通过AI降低金融投研的复杂度。 根据官方披露,该公司核心管理层均毕业自清华大学。其创始人、CEO费斌杰本科就读于清华大学工业工程系,硕士毕业于五道口金融学院,曾担任嘉
DeepSeek刚把搜索卷起来,另一种玩法开始全网「捞人」(在新窗口打开)
让全网信息变成合作机会。 近日,DeepSeek开放了自研网页搜索接口,它还披露,这套引擎每天处理全球数亿次请求,已经收录千亿级网页。 它正在把自己积累的搜索能力交给更多开发者,让其他产品也能借助这套引擎获取最新的网络信息。 不过,搜索引擎每天要处理的资料里,还有一类信息很特殊,那就是人。 而在这个过程里,最费时间的往往是把零散线索拼到同一个人身上。最近看到一家名叫Simplex AI的创业公司,它的创始人张博,曾担任DeepSeek-VL项目负责人。 如今,他带领团队做的Lev8,简单来说主要面向GTM,人物搜索是整个流程的起点,也是它最容易让人理解的一项能力。 你只要用平常说话的方式描述目
Demo|离开字节剪映,获千万美元融资,他用vibe coding的方式帮你做视频(在新窗口打开)
视频Agent赛道又来新玩家,但这次有点不一样。
再访Dyna Robotics:被部署教训了300天后,找到机器人Scaling Law(在新窗口打开)
“全世界最无聊的机器人。”这是最近《纽约邮报》的一篇报道标题,而这家公司的创始人们却认为,这是“对一家机器人公司最高的赞美”,这家公司叫Dyna Robotics。
Jeff Dean投的模拟果蝇+世界模型,估值破百亿(在新窗口打开)
不er,为什么要化身一只果蝇在世界模型里飞啊啊啊?!