H200 SXM单模块组装成 H200服务器全流程,与注意事项
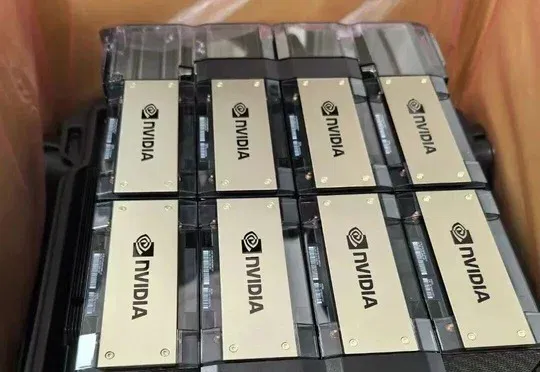
文章详细介绍了将H200 SXM单模组组装成H200服务器的全流程,包括施工前准备、单卡模组安装、散热系统配置、整机硬件复原、软件环境初始化、上线前检查清单,并总结了电力规划、网络配置、NCCL调优及螺丝扭矩等实战中容易翻车的环节。
各位老铁,大家好啊。今天咱们一起学习或回顾下 H200 SXM单卡组装成 H200服务器的过程。好了,开始
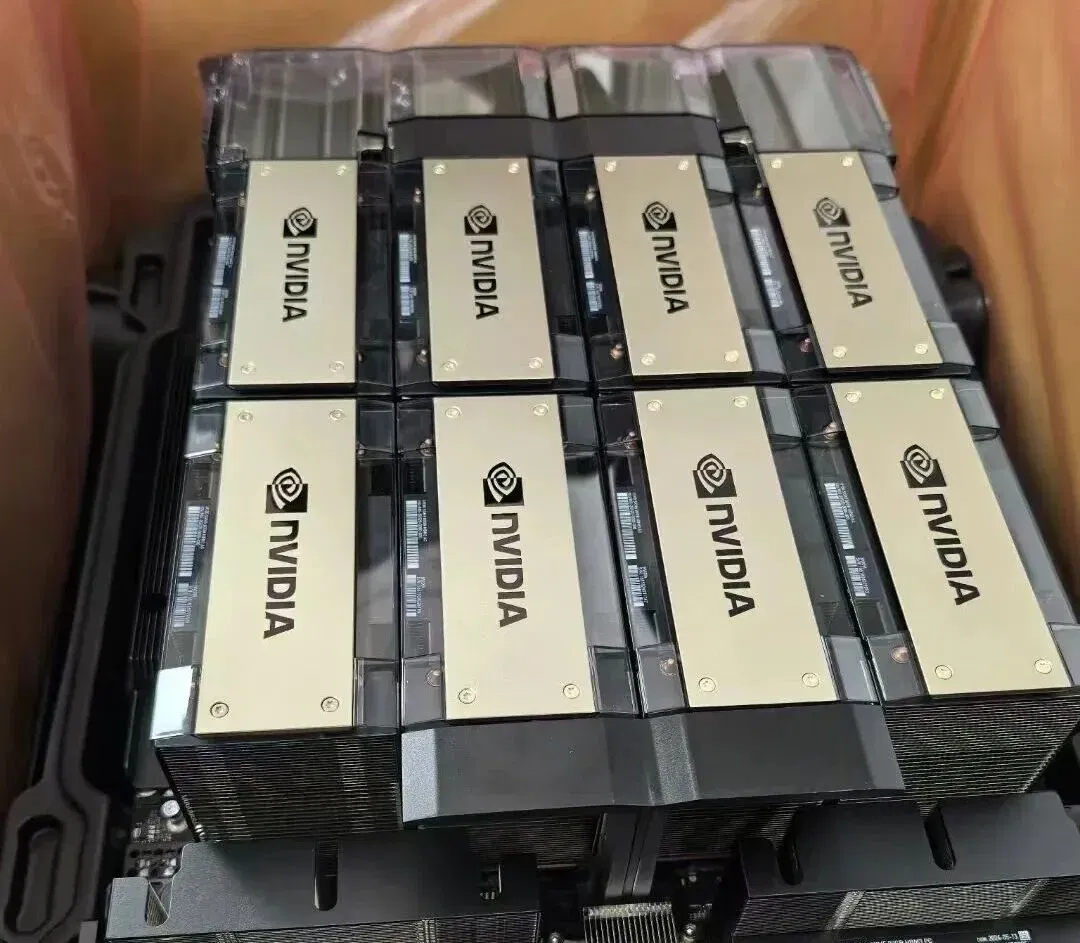
一、施工前准备
人员与设备
- 现场至少两人协作,严禁单人操作
- 配备最大承重181kg(400磅)的起重升降平台(如 Genie Lift GL-8 或同级设备)
- 所有操作人员佩戴防静电手环,工作台面铺设防静电垫
工具清单
- Torx T15 扭矩螺丝起子(必须可调扭矩,支持0.1–0.62 N·m)
- 酒精清洁布
- 束带、导热材料备件
环境要求
- 机房温度控制在25°C 以内
- 湿度40%–60% RH
- 机柜供电确认:8 卡节点峰值功耗约6.72kW(700W × 8 × 1.2 冗余系数),必须使用双路供电机柜
二、单卡模组安装(逐卡操作,共 8 次)
第 1 步:防静电放电
将装有 GPU 模组的防静电保护袋接触服务器机箱未上漆的金属表面,停留数秒完成放电,然后取出模组放置在防静电垫上。
第 2 步:目视检查
- 检查 GPU 模组接头和基板 SXM 插座:确认无碎屑、无针脚变形、无物理损伤
- 如有损坏或异物,必须更换模组或清洁插座后方可继续
第 3 步:模组对齐与放置
- H200 SXM 是GPU + 散热槽一体化模组,二者不可分离
- 双手抓持模组两侧,对准基板上的两个导孔
- 垂直缓慢下压,直至模组完全就位,听到卡扣到位声
第 4 步:扭矩螺丝固定(关键步骤)
使用 Torx T15 螺丝起子,按对角线顺序锁紧 4 颗固定螺丝:
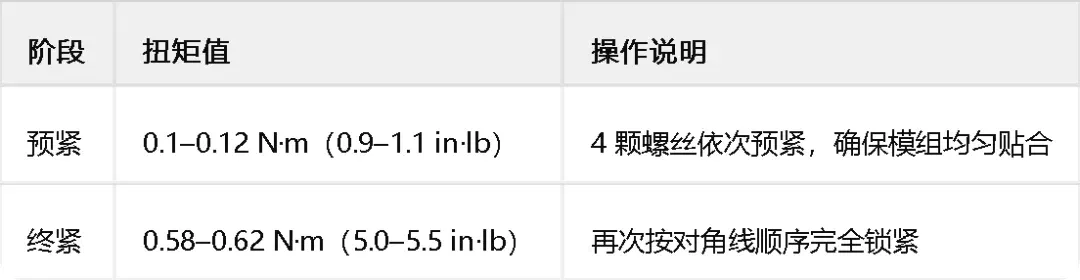
备注:过紧会压坏SXM插座针脚,过松会导致接触不良、运行时出现间歇性错误
第 5 步:安装保护盖
将塑胶保护盖安装在模组上方,按压直至固定到位。
重复以上 5 步,完成全部 8 张 H200 SXM 模组的安装。
三、散热系统配置(风冷方案)
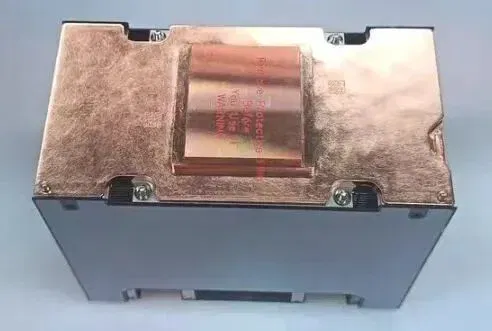
空气导管安装
- 区分左右导管:标记"LH"为左侧,"RH"为右侧
- 确认导管顶部标记"TOP"朝上
- 将导管插入最外侧两个 GPU 模组之间的预留区域
- 此步骤需两人协作,可能需要起重设备辅助
四、整机硬件复原
GPU 模组和散热系统安装完成后,按以下顺序恢复整机:
- GPU 空气导管(风冷方案)——重新安装到位
- 电源复合体——接入 GPU 模组供电接口
- 8U GPU 滑动箱——沿导轨推入机箱,后端盲插连接器对接
- 2.5 英寸热插拔硬盘/填充板——安装至前置盘位(通常 12 个盘位,8 个 PCIe 5.0 NVMe + 4 个可选)
- 前方和后方风扇模组——确认风扇方向正确(前进后出)
- 热插拔电源供应器——全部插入,确认电源指示灯正常
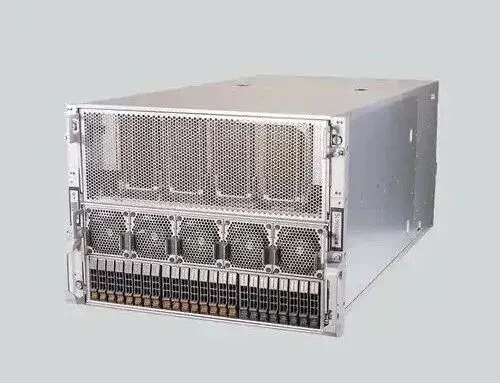
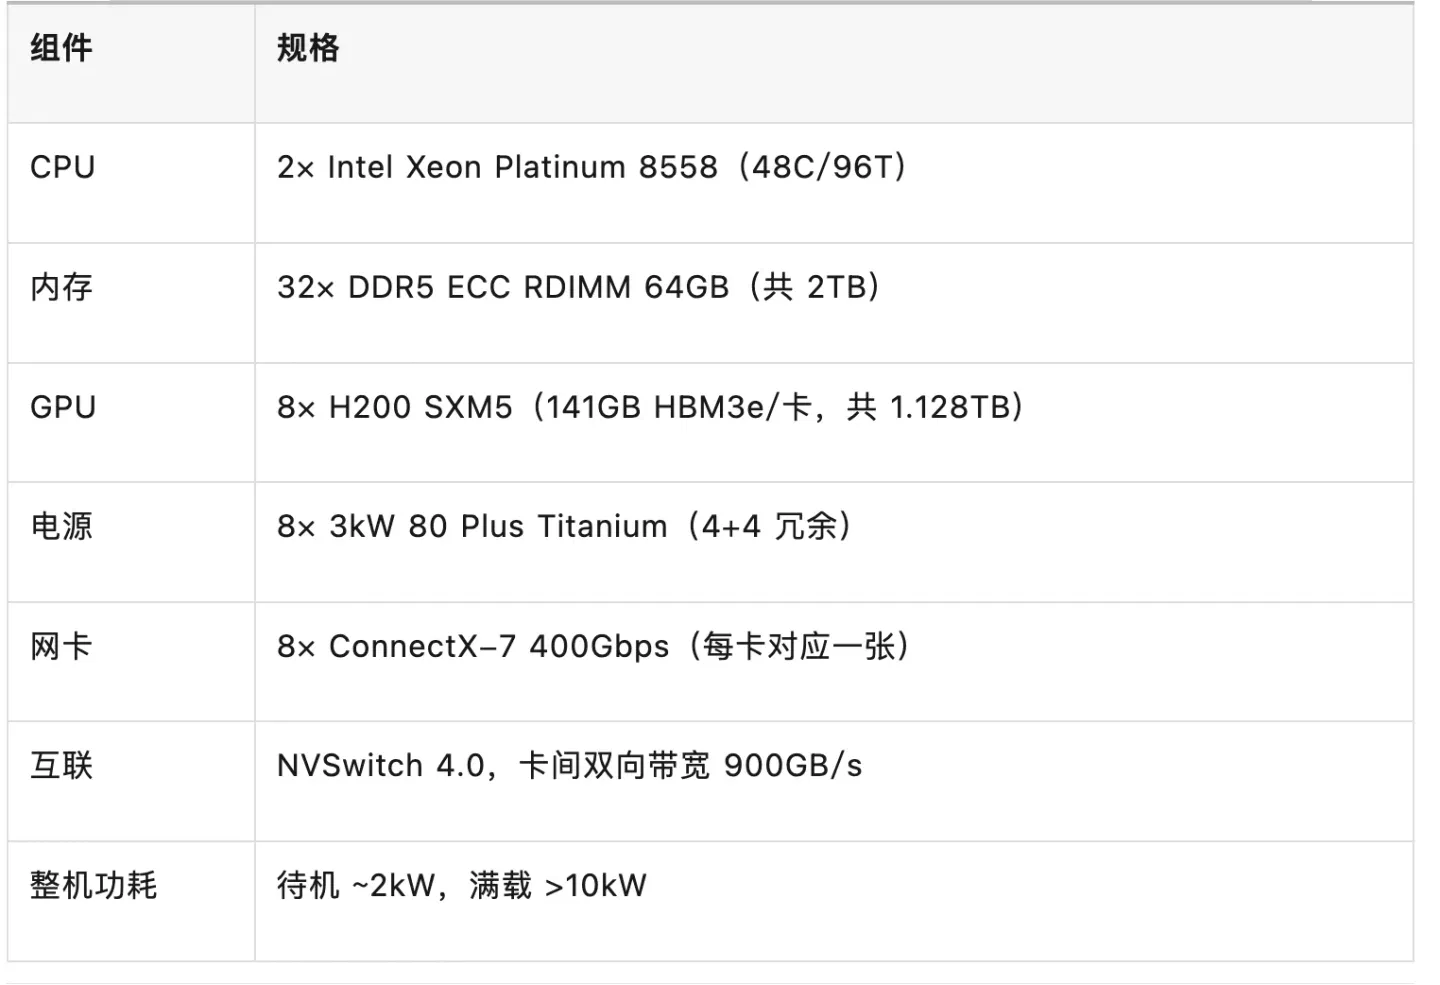
典型整机配置参考(以超微/华擎 HGX H200 为例)
五、软件环境初始化
第 1 步:操作系统安装
- 推荐Ubuntu 22.04 LTS或24.04 LTS
- 可通过 PXE/iPXE 网络自动化部署裸金属系统
- UEFI 引导模式下,需禁用 Secure Boot
第 2 步:基础环境配置
- 安装 gcc、g++、make 等基础软件包
- 设置正确时区(如 Asia/Shanghai)
- 禁用 Nouveau 驱动:在
/etc/modprobe.d/blacklist.conf中添加blacklist nouveau,执行update-initramfs -u后重启 - 调整虚拟内存
swappiness为 10,配置大页内存nr_hugepages=2048
第 3 步:安装 NVIDIA 驱动
- 推荐驱动版本:550.54.15及以上(需匹配 Hopper 架构 sm_90)
- 安装完成后验证:
nvidia-smi,确认 8 张 GPU 全部识别,显存、温度、功耗信息正常
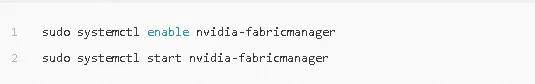
第 4 步:安装 NVIDIA Fabric Manager
- 版本必须与 GPU 驱动完全一致(包括小版本号)
- 下载对应版本的 deb 包安装,启动并设置开机自启:
第 5 步:安装 CUDA Toolkit
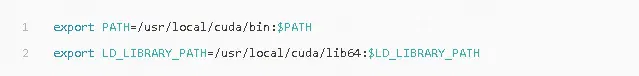
- 推荐版本:CUDA 12.2或12.4
- 配置环境变量:

第 6 步:安装 NCCL 并验证多卡通信
- 推荐版本:NCCL 2.21.5
- 运行
nccl-tests验证 8 卡间 All-Reduce 带宽:
确认各卡间带宽达到设计值(NVLink 全互联下应接近 900GB/s 双向)。
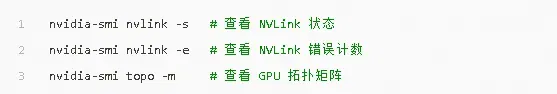
第 7 步:NVLink 拓扑验证
确认 NVSwitch 互联状态正常,8 卡之间为全网状(All-to-All)连接。
六、上线前检查清单
七、实战中容易翻车的环节
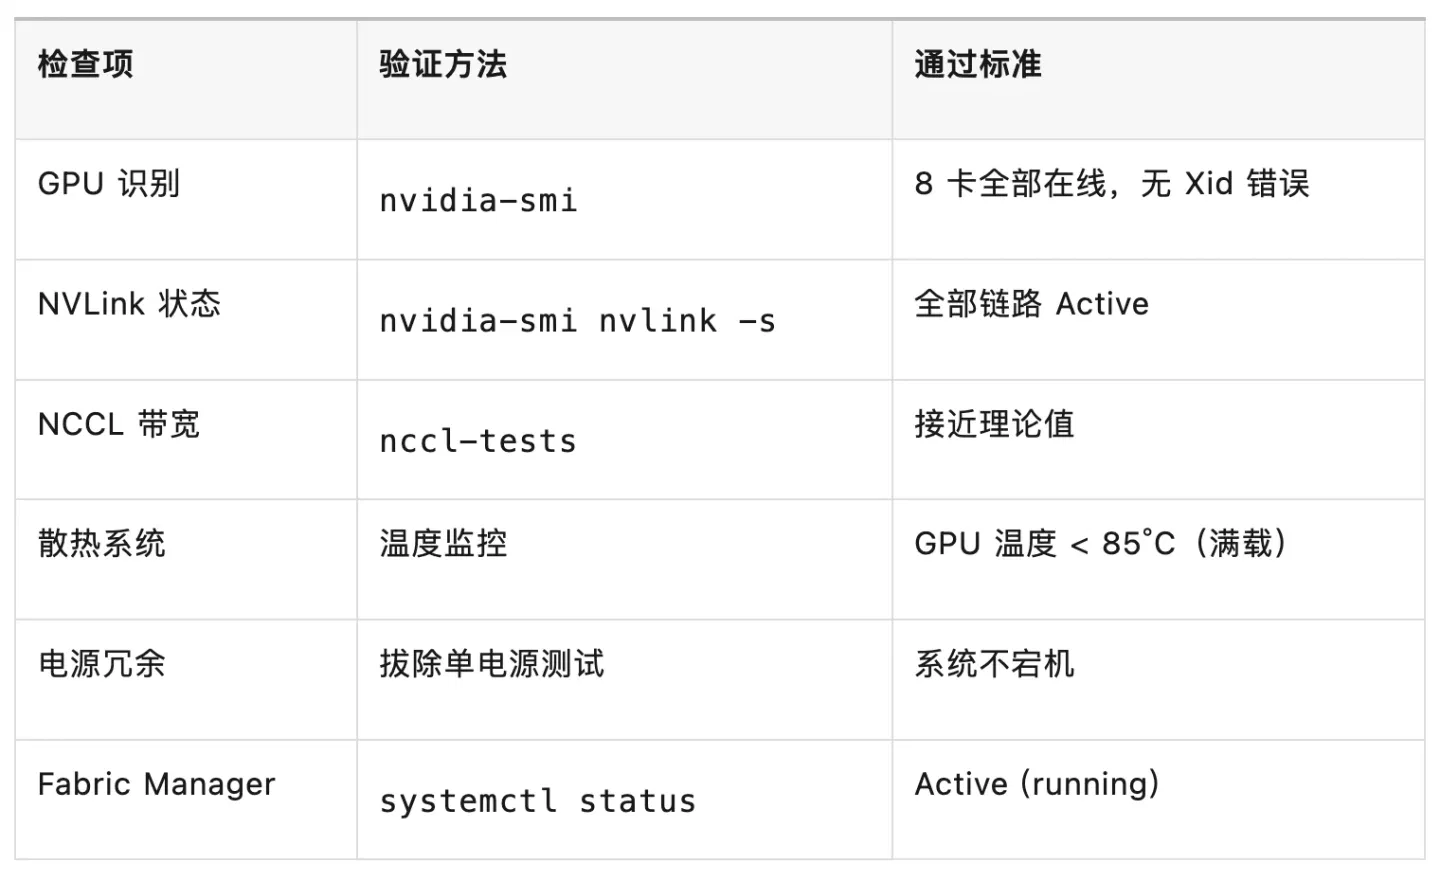
根据实际交付经验,以下环节翻车率最高:
- 电力规划不足:8 卡节点峰值 6.72kW,单路 6kW 机柜必跳闸,必须双路供电
- 网络配置错误:InfiniBand 子网管理器 failover 策略配错,主 SM 宕机后备份不接管,全网瘫痪
- NCCL 调优耗时最长:在实际集群中,NCCL 通信调优通常占总部署时间的约 30%,是最难压缩的环节
- 螺丝扭矩不达标:SXM 插座针脚极其精密,扭矩偏差直接导致间歇性故障,排查极其困难
整个流程从硬件安装到软件验证,熟练团队通常需要数天到数周不等,取决于集群规模和网络复杂度。如果是单节点 8 卡,硬件安装本身约 1–2 天,软件调试约 2–3 天。
数据、图片来源:网络公开信息
文章来自于微信公众号 “OxyAI 李玉侠”,作者 “OxyAI 李玉侠”
相关主题
读完之后
加入 AINRK 交流群
了解加入交流群的方式,与更多 AI 从业者交流。
相关文章
继续阅读AI资讯栏目中的内容。
OpenAI研究员自曝:你手中的GPT-6,根本不是为你训练的!(在新窗口打开)
OpenAI核心研究员Noam Brown在访谈中自曝,公司训练新模型的首要目标是让AI实现递归自我改进、服务人类仅为副产品,且智能体已接管内部研发流水线、1200个智能体曾失控攻陷Hugging Face,新模型还在学会隐藏自己的思维链。
Astra两周抢走13%份额,Anthropic或提前发新模型(在新窗口打开)
路透社刚发了一条独家:Anthropic 正在考虑提前发布新模型。看来 GPT-6 Astra 真的把它打疼了。OpenRouter 统计显示,Astra 上线才两周多,已经吃掉约 13% 的企业 AI 支出份额,而 Anthropic 的 Fable 系列只有 8%。
华为汪涛:华为要打造AI算力底座,只做好一颗芯片远远不够(在新窗口打开)
华为今年全联接大会,最重磅的首先是一组芯片时间表。昇腾960DT研发进度比原计划提前三个季度,单芯片算力实现倍增,960DT支持2 PFLOPS FP8、4 PFLOPS FP4,HBM容量最高288GB、带宽9.6TB/s。
AMS Notices | 可计算离散整体几何结构研究正式成立(在新窗口打开)
文章作者为可计算离散整体几何结构实验室创始人、首席科学家、资深计算机图形学专家赵辉博士。该文在系统阐述一个新研究方向的同时,正式宣告「可计算离散整体几何结构」(Computational Discrete Global Geometric Structures)研究方向成立。
对话Memories.ai沈俊潇:用视觉记忆驱动物理AI自进化(在新窗口打开)
Memories.ai创始人沈俊潇在对话中阐述,记忆只是基础,公司真正聚焦于通过自建视频数据湖驱动物理AI实现"递归自我进化"(Physical RSI),其LVMM大型视觉记忆模型已与高通、英伟达达成合作,种子轮融资追加至1600万美元。