Kimi 新模型 K2.8 Preview 全量上线!综合性能逼近 K3!
Kimi K2.8 Preview 编程模型全量上线 Kimi Code,支持 1M 超长上下文并向所有会员档位开放,综合性能接近 K3,默认采用 Max 思考档位,编码和智能体能力较 K2.7 Code 有所提升。
好家伙,Kimi 又给编程模型加了一把火。
就在刚刚,Kimi K2.8 Preview 全量上线 Kimi Code,支持 1M 上下文,而且全部会员档位都能用。
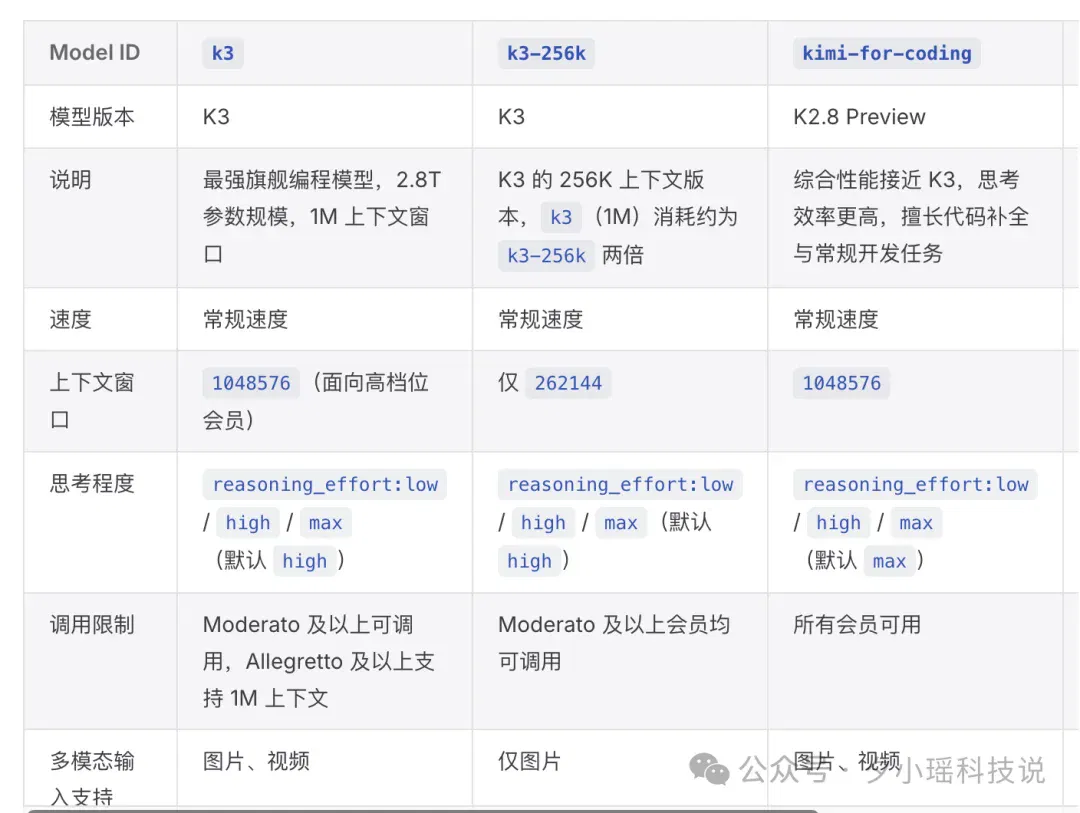
官方给它的定位也很明确:综合性能接近 K3,思考更省,支持 1M 超长上下文。
对已经在用 Kimi Code 的人来说,这次连 Model ID 都不用改,原来的入口已经指向新模型。
◈全员 1M 超长上下文
平日我们写代码时,让 AI 修改一个按钮,和让它排查整个登录流程,需要的材料完全不同。
后者可能要同时对照前端页面、后端接口、报错日志,再加上之前反复强调的几条需求。聊着聊着,文件越来越多,历史对话也越来越长。
这些内容,都要占用上下文空间。
K2.8 Preview 这次把窗口拉到了约 100 万 token。
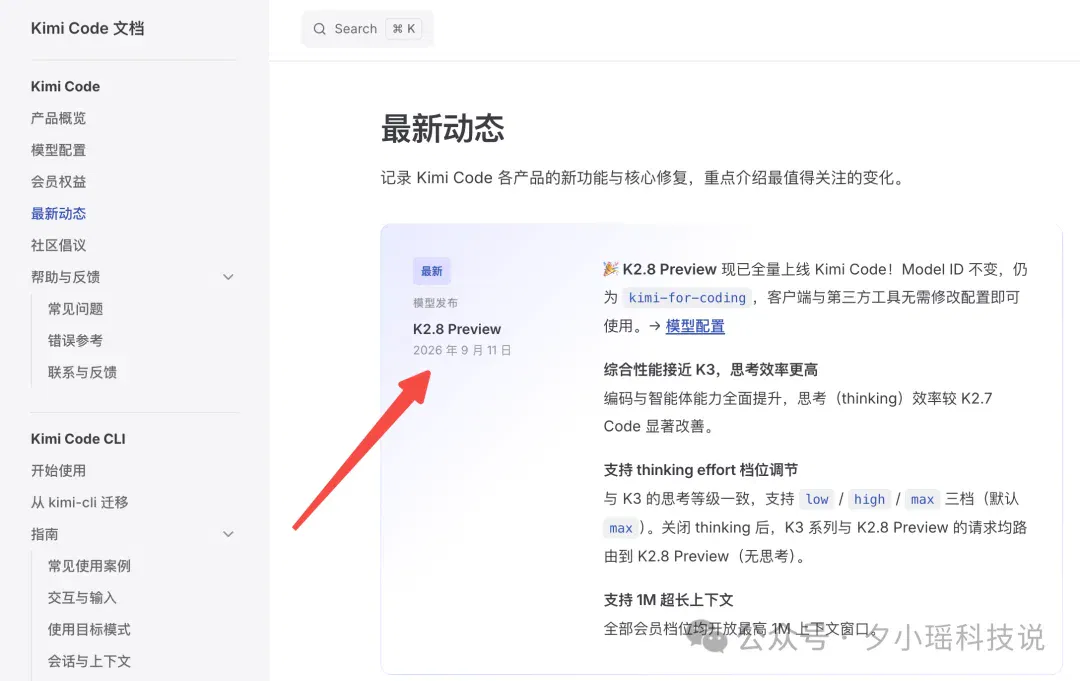
窗口变大,多文件修改、长对话和复杂任务就有了更大的周转空间。
重点是:这次还把使用门槛往下放了一步:K2.8 Preview 的 1M 上下文向所有会员档位开放。相比之下,K3 的 1M 上下文还得需要高档会员。
登月计划由此奏响。。。
不过 1M 上下文 窗口给得大,我们也得留意消耗。
每次请求不一定会用满 1M,但如果把大量文件和无关历史不断带进后续对话,token 消耗还是会往上走。
官方给的建议:先明确任务范围,让模型定位相关部分,再深入分析。
比如,只想修登录报错,就先给报错日志、相关接口和登录页面;等模型发现还缺什么,再继续补。没必要一上来就让它通读整个项目。
◈性能向 K3 靠近
名字还在 K2 系列,官方已经把它拉到 K3 旁边作比较了。
按照发布说明,K2.8 Preview 的编码和智能体能力有所提升,综合性能接近 K3。
思考效率的比较对象则是K2.7 Code,更擅长代码补全和常规开发。
不过,发布说明暂未给出具体的成绩差距和效率提升比例,还需要我们实测。
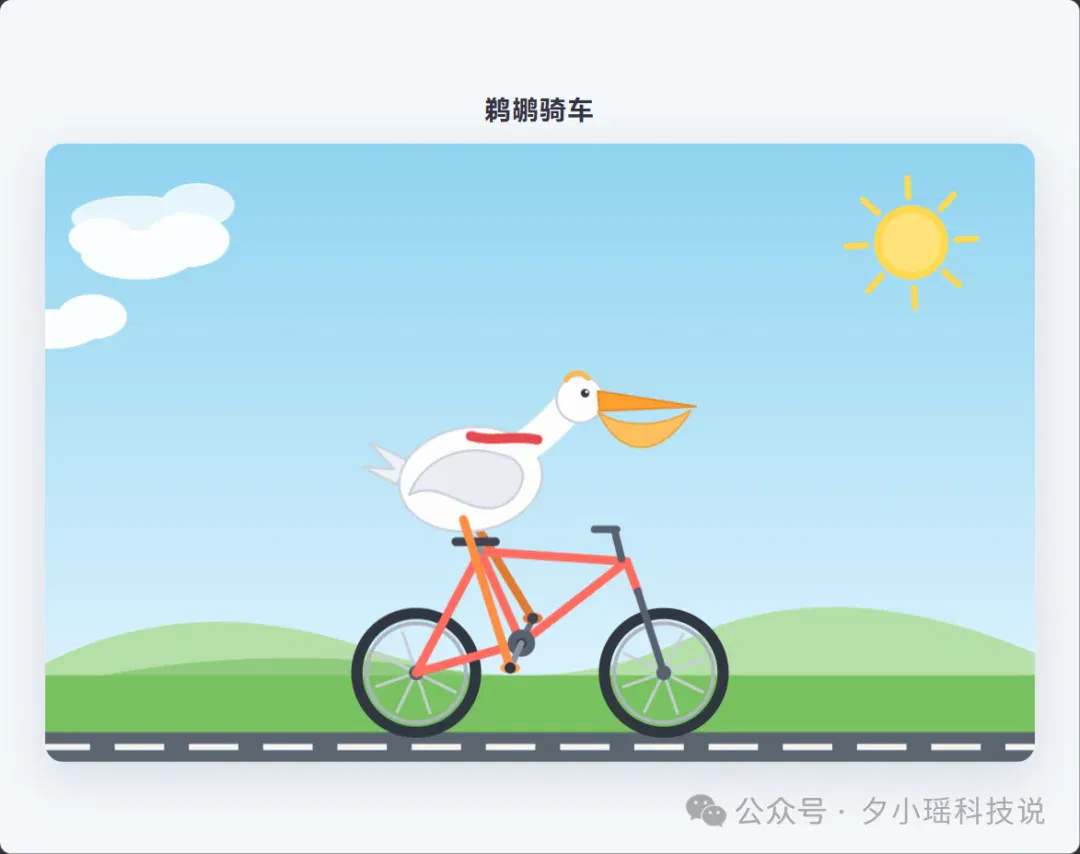
目前社区已经有人开始试用了。用户xeri_chen使用 Kimi Code CLI,将思考强度设为 Max,让它生成一个“鹈鹕骑自行车”的 HTML 动画,并给出了结果:鹈鹕、自行车、道路和背景都画出来了。
三档思考在这次也同步跟上了:Low、High、Max,与 K3 一致。
有意思的是这次的默认设置:K3 默认 High,K2.8 Preview 默认 Max。
按档位看,新模型一上来就更“大胆”。
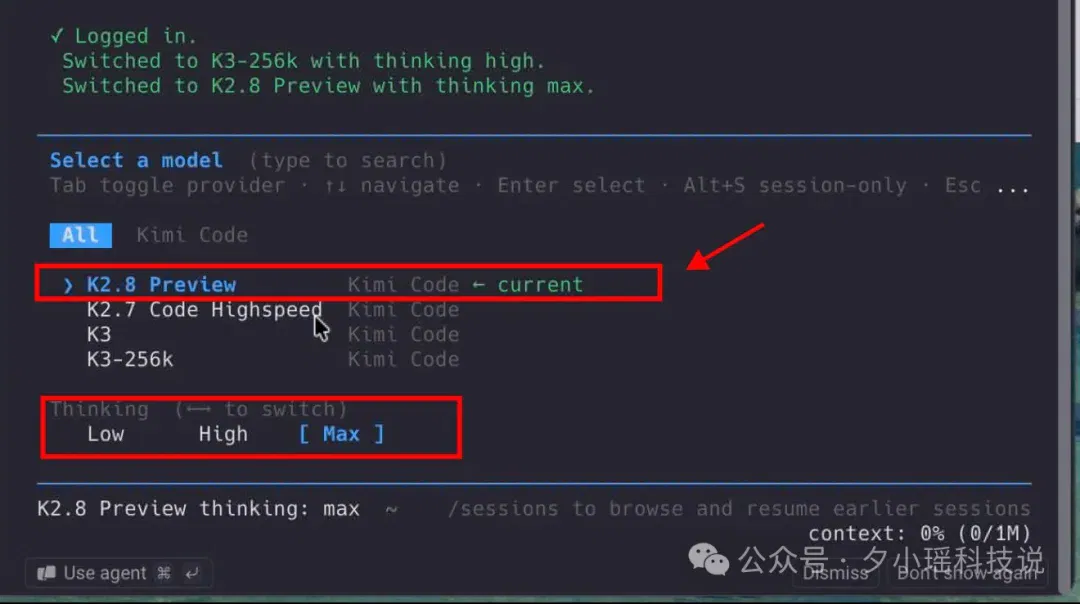
当然需要我们稍稍留意下,默认的 Max 档位需要更高的思考强度,可能增加思考 token 和等待时间。
官方建议:像补全函数、修改接口这类日常工作,可以先用 K2.8 Preview ;
想挑战更复杂的任务、冲能力上限,再选旗舰 K3。
◈丝滑升级,直接用上 K2.8
这次升级,入口倒是省事。
如果原本调用的就是kimi-for-coding,配置可以照旧。
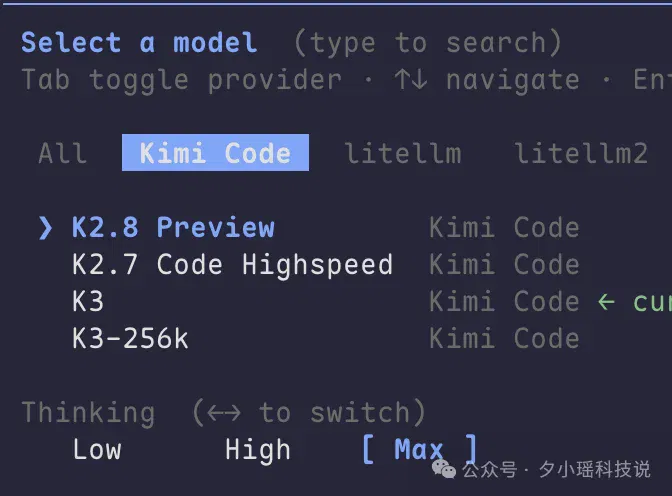
使用官方 CLI 的用户,可以输入/model查看和选择模型;如果列表里暂时没有新模型,官方建议退出登录后重新登录。
但升级之后,要留意一下额度消耗可能会变多。
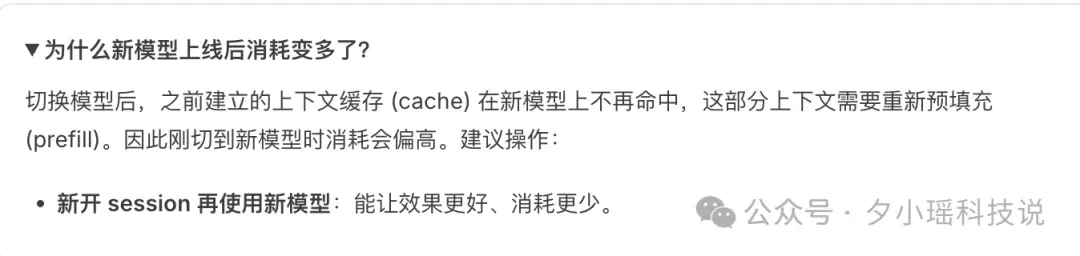
官方专门解释了“为什么新模型上线后消耗变多”:
切换模型后,旧模型建立的上下文缓存无法继续命中,已有材料需要重新处理,所以刚切换时的消耗会偏高。
这不只是数字“看起来”变大,原本能复用的计算都需要重做。
因此,官方建议新开会话再使用新模型。切换思考档位也会影响缓存,长会话里尽量不要反复拨动 Low、High、Max。
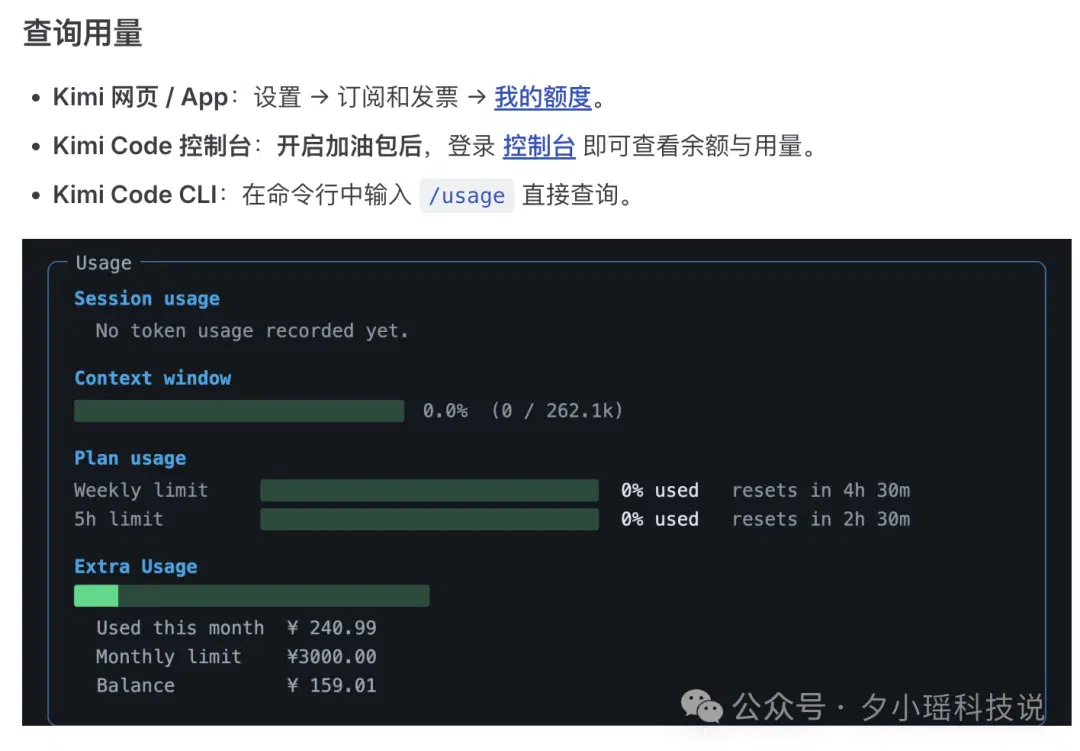
想观察额度变化,可以在 CLI 输入/usage。Kimi Code 与 Kimi 会员共享额度。
说到这里,还有一个让人忍不住吐槽的细节:这个新模型名字K2.8Preview。
K3 都出了,版本号怎么还开始倒退了?
看来以后追 Kimi 新模型,光看数字还不够,得再看一眼发布日期。
参考文献
[1] Kimi Code:https://www.kimi.com/code/docs/kimi-code/whats-new.html
文章来自于微信公众号 “夕小瑶科技说”,作者 “夕小瑶科技说”
相关主题
读完之后
加入 AINRK 交流群
了解加入交流群的方式,与更多 AI 从业者交流。
相关文章
继续阅读AI资讯栏目中的内容。
攀爬AGI的南北坡:语言模型之外,生数从世界模型出发(在新窗口打开)
中国AGI两条上山路径:一条让机器理解、运用语言,另一条让机器认知、推演并改造世界,二者终会交汇。
梅涛的视频AI创业,最新产品来了(在新窗口打开)
AI视频Agent已经告别大抽卡时代了?
Anthropic推演2030年美国经济:AI时代,钱继续流向有钱人(在新窗口打开)
到 2030 年,如果 AI 已经能够自主完成大量工作,美国经济会发生什么?AI 会让我们变得更富有?还是带来更多失业?
108亿天价薪酬留不住!Meta又失亿元AI先生(在新窗口打开)
Muse刚发布,把它造出来的Meta TBD实验室,却又有人开始离场。
OpenAI把「末日论者」请进董事会!刚上任就开炮:AI可能杀死多数人(在新窗口打开)
刚刚,OpenAI把一位「AI末日论」者,请进了自己的董事会。