Search

Results for “embedding”

Total 26 articles

Embedding黑箱成为历史!这个新框架让模型“先解释,再学Embedding”

Embedding黑箱成为历史!这个新框架让模型“先解释,再学Embedding” (opens in a new tab)

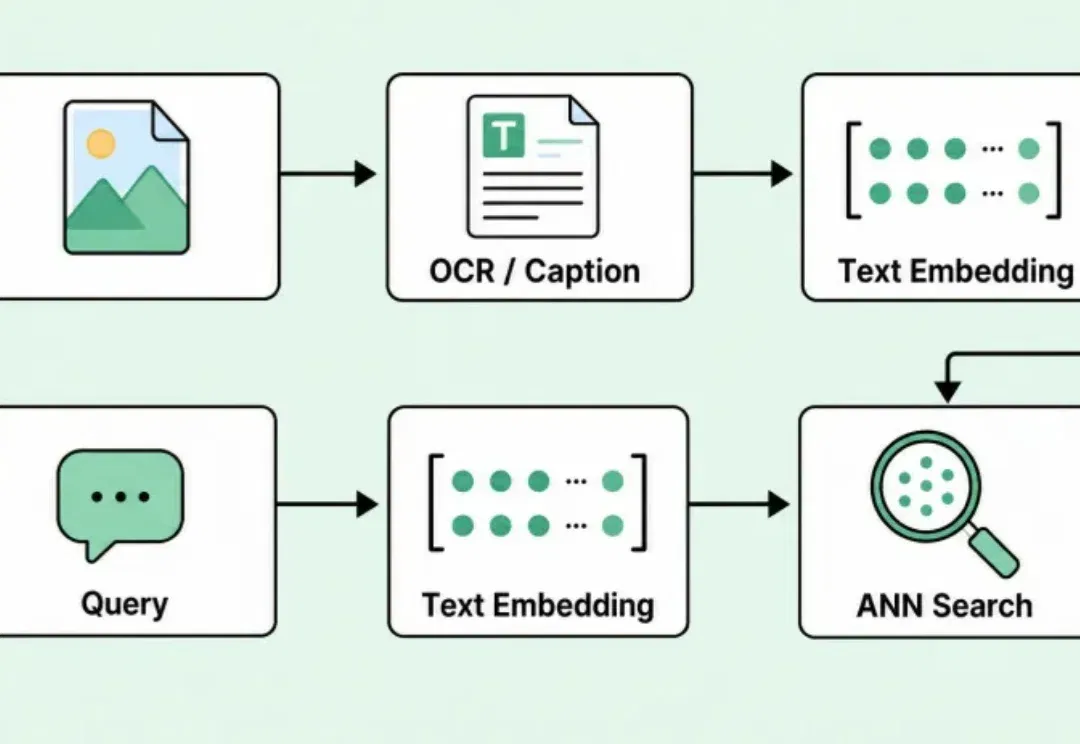
让模型先解释,再学Embedding! 来自UIUC、ANU、港科大、UW、TAMU等多所高校的研究人员,最新推出可解释的生成式Embedding框架——GRACE。过去几年,文本表征(Text Embedding)模型经历了从BERT到E5、GTE、LLM2Vec,Qwen-Embedding等不断演进的浪潮。这些模型将文本映射为向量空间,用于语义检索、聚类、问答匹配等任务。
AI guides
0
从多模态大模型中「拆」出音频向量模型

从多模态大模型中「拆」出音频向量模型 (opens in a new tab)

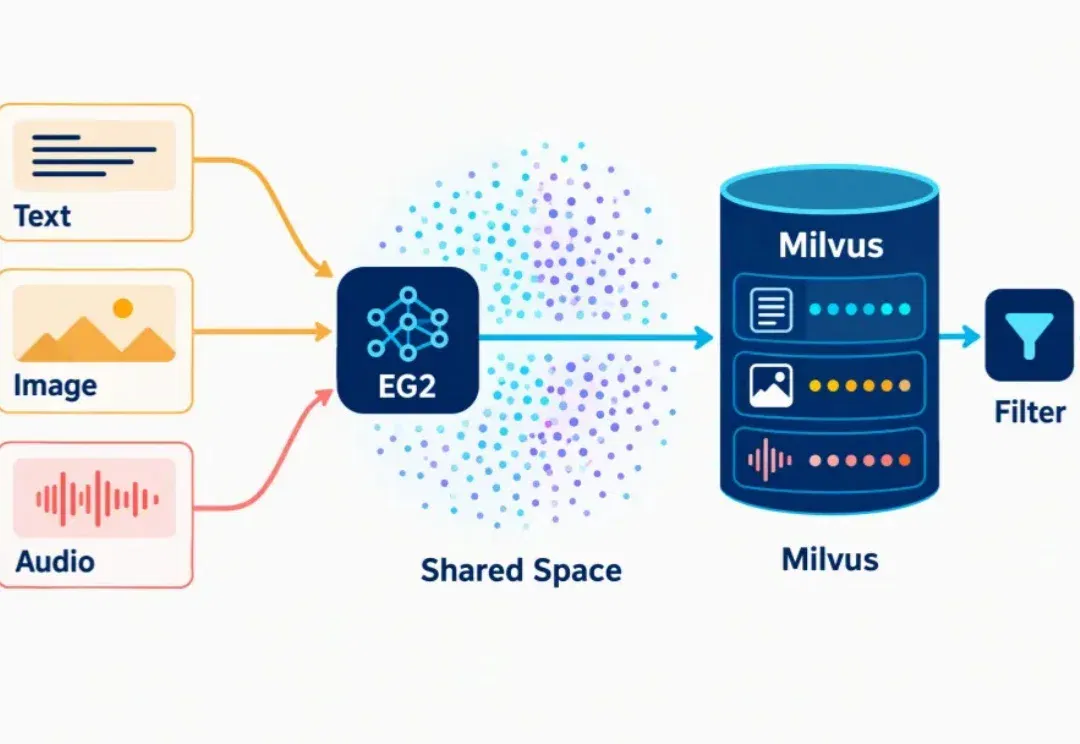
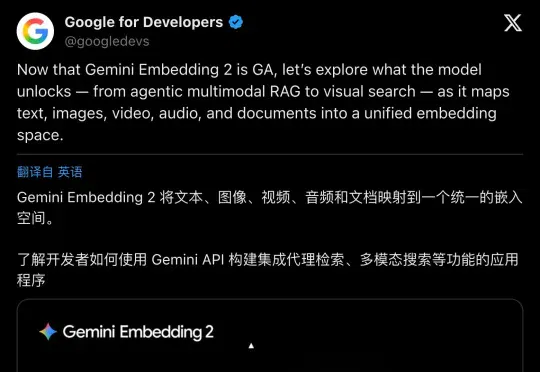
Google 最近发了 Gemini Embedding 2,他们第一个原生多模态向量模型。文本、图像、视频、音频、文档,全部映射到同一个 3072 维向量空间。这是 Omni Embedding(全模态向量模型)的大趋势:一个架构吃下所有模态,从 jina-embeddings-v4 到 Omni-Embed-Nemotron 再到 Omni-5,大家都在往这个方向收敛。

AI guides
0
何恺明首个语言模型:105M参数,不走GPT自回归老路

何恺明首个语言模型:105M参数,不走GPT自回归老路 (opens in a new tab)

何恺明,也下场做语言模型了。 只不过,这次他带队做的不是大家熟悉的、像ChatGPT背后那套“预测下一个词元”(next token prediction)的自回归范式。 而是另一条过去几年在图像领域大火、如今正被越来越多人搬进文本生成的新路线:扩散语言模型(Diffusion Language Model,DLM)。 在最新的论文中,何恺明团队放出全新连续扩散语言模型:ELF:Embedded Language Flows。 与不少还停留在token层面做扩散的语言模型不同,ELF把整个生成过程都留在了连续的embedding空间里,直到最后一步,才重新离散化,将表示变回token。 靠着这

AI guides
0