谷歌第八代TPU双舰齐发,终结AI推理延迟,让智能体真正实现随叫随到 (opens in a new tab)
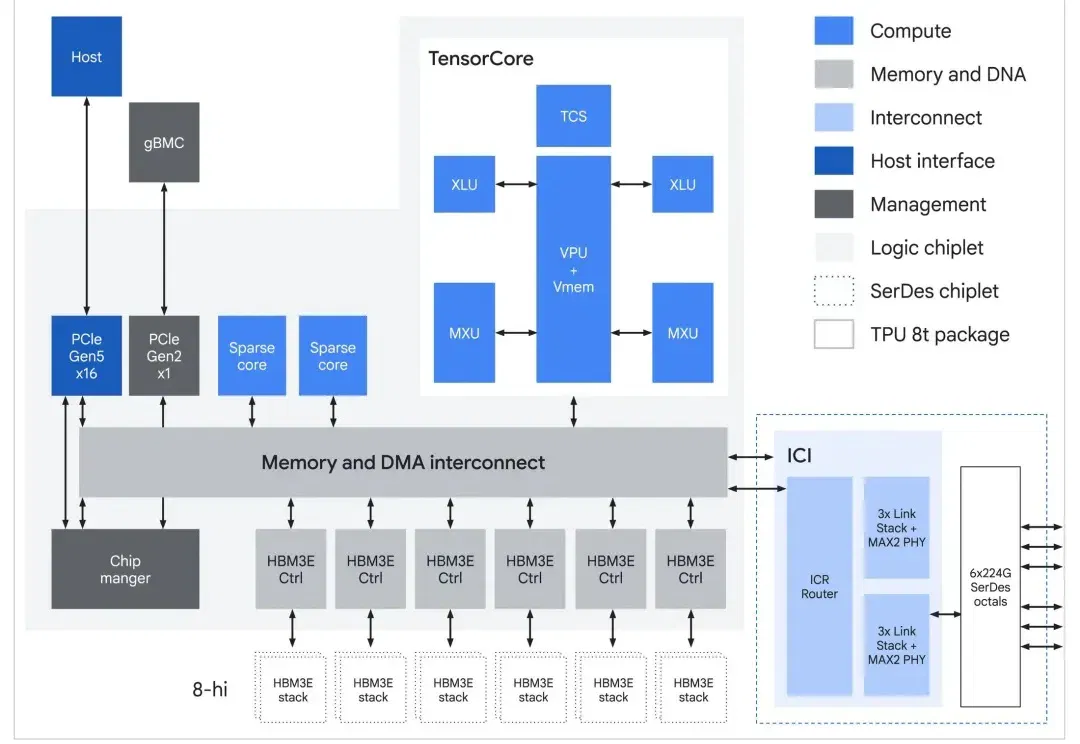
今天,谷歌在 Cloud Next '26 峰会上发布了其第八代 TPU 架构(TPU 8t 与 TPU 8i),TPU 8t 主攻训练,TPU 8i 主攻推理,将在 2026 年晚些时候上市。第八代 TPU 采用申请制,Google Cloud 用户如需使用,需要在官网提交登记需求。
Total 41 articles
今天,谷歌在 Cloud Next '26 峰会上发布了其第八代 TPU 架构(TPU 8t 与 TPU 8i),TPU 8t 主攻训练,TPU 8i 主攻推理,将在 2026 年晚些时候上市。第八代 TPU 采用申请制,Google Cloud 用户如需使用,需要在官网提交登记需求。
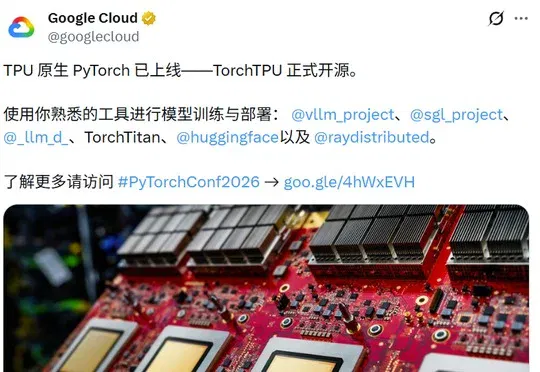
谷歌与Meta联合开源TorchTPU,使TPU成为PyTorch原生设备,并完成vLLM、SGLang、Hugging Face、Ray、TorchTitan等主流项目接入,CUDA的软件生态护城河开始松动。

英伟达死守的推理性价比神话,碎了。 就在刚刚,SemiAnalysis发布了谷歌第七代TPU Ironwood的首份第三方推理性能测算。 在完全对等的模型负载下,TPU的每美元性能最高领先英伟达B200达50%,对B300的领先幅度更是逼近翻倍的96%! 外部TCO口径下每百万token成本 vs 交互速度 换算成业界最敏感的每百万Token成本,差距触目惊心。 TPU仅需0.181美元,B200为0.222美元,B300则高达0.276美元。 更戏剧性的,是时间。 今年4月,黄仁勋在Dwarkesh播客上宣称TPU与Trainium都不敢来跑分。他甚至公开鼓励挑战者使用InferenceMA
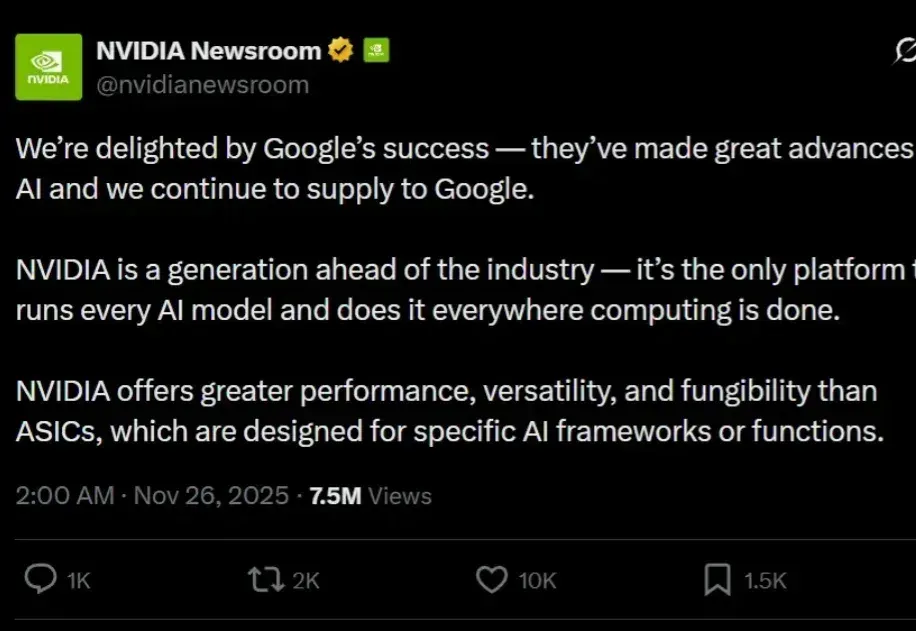
学术界看不下去了,直接戳破:华尔街在尬吹谷歌TPU!起因是Meta被曝要和谷歌签订数十亿美元的TPU订单,消息曝出后英伟达盘中最大跌幅达到了7%,按照现在的市值计算,一举蒸发了超3000亿美元。反观谷歌,在盘中情绪最热烈时涨幅一度达4%,换算成市值相当于增加了约1500亿美元,合人民币超1万亿。
昨天,苹果一篇新论文在 arXiv 上公开然后又匆匆撤稿。原因不明。论文中,苹果揭示了他们开发的一个基于 TPU 的可扩展 RL 框架 RLAX。是的,你没有看错,不是 GPU,也不是苹果自家的 M 系列芯片,而是谷歌的 TPU!还不止如此,这篇论文的研究中还用到了亚马逊的云和中国的 Qwen 模型。
谷歌正在推进一项代号为「TorchTPU」的战略行动,核心是让全球最主流的 AI 框架 PyTorch 在自家 TPU 芯片上跑得更顺畅。这项行动不仅是技术补课,更是一场商业围剿。作为 PyTorch 的掌控者,Meta 也深度参与其中,两家巨头试图联手松动英伟达的垄断地位。
谷歌不再甘当「云房东」,启动激进的TPU@Premises计划,直接要把算力军火卖进Meta等巨头的自家后院,剑指英伟达10%的营收。旗舰TPU v7在算力与显存上彻底追平英伟达 B200,谷歌用「像素级」的参数对标证明:在尖端硬件上,黄仁勋不再寂寞。通过拥抱PyTorch拆解CUDA壁垒,谷歌正在用「私有化部署+同级性能」的组合拳,凿开万亿芯片帝国的坚固城墙。
10月24日消息,今日,谷歌Anthropic发布声明,宣布谷歌将向Anthropic供应至多100万块专用AI芯片TPU以及附加的谷歌云服务,这笔交易价值数百亿美元。谷歌在声明中称,这是Anthropic迄今为止规模最大的TPU扩容计划。至此,Anthropic已与谷歌、亚马逊与英伟达三大芯片提供商达成合作。
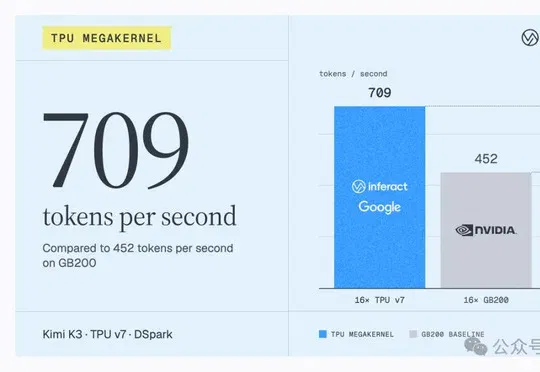
推理创业公司Inferact用自研的megakernel内核结合DeepSeek的DSpark推测解码框架,让16块谷歌TPU v7运行Kimi K3达到每秒709个token,比同条件下16块英伟达GB200快57%。