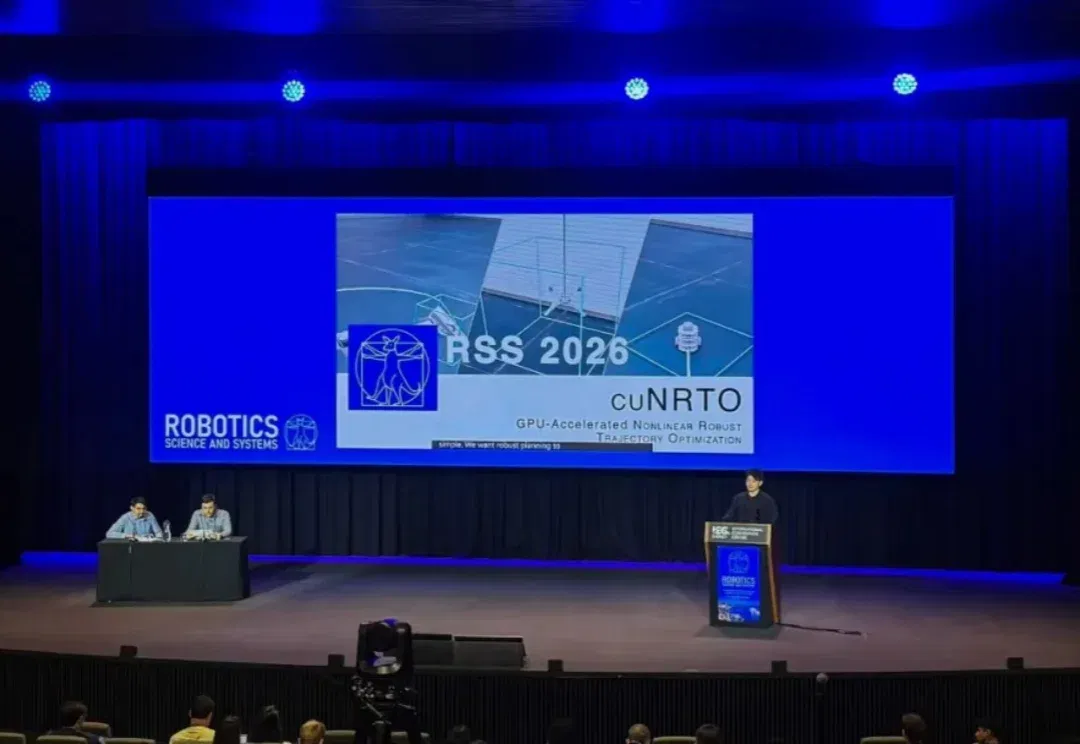
139.6倍加速、100%安全约束:影眸科技提名具身顶会RSS最佳论文 (opens in a new tab)
在近日的具身智能顶会 RSS(Robotics: Science and Systems)2026 上,最高奖项 Outstanding Paper Award 提名名单里,出现了一个不太 “机器人” 的名字 —— 影眸科技,一家头部 3D 生成大模型公司。
Total 9 articles
在近日的具身智能顶会 RSS(Robotics: Science and Systems)2026 上,最高奖项 Outstanding Paper Award 提名名单里,出现了一个不太 “机器人” 的名字 —— 影眸科技,一家头部 3D 生成大模型公司。
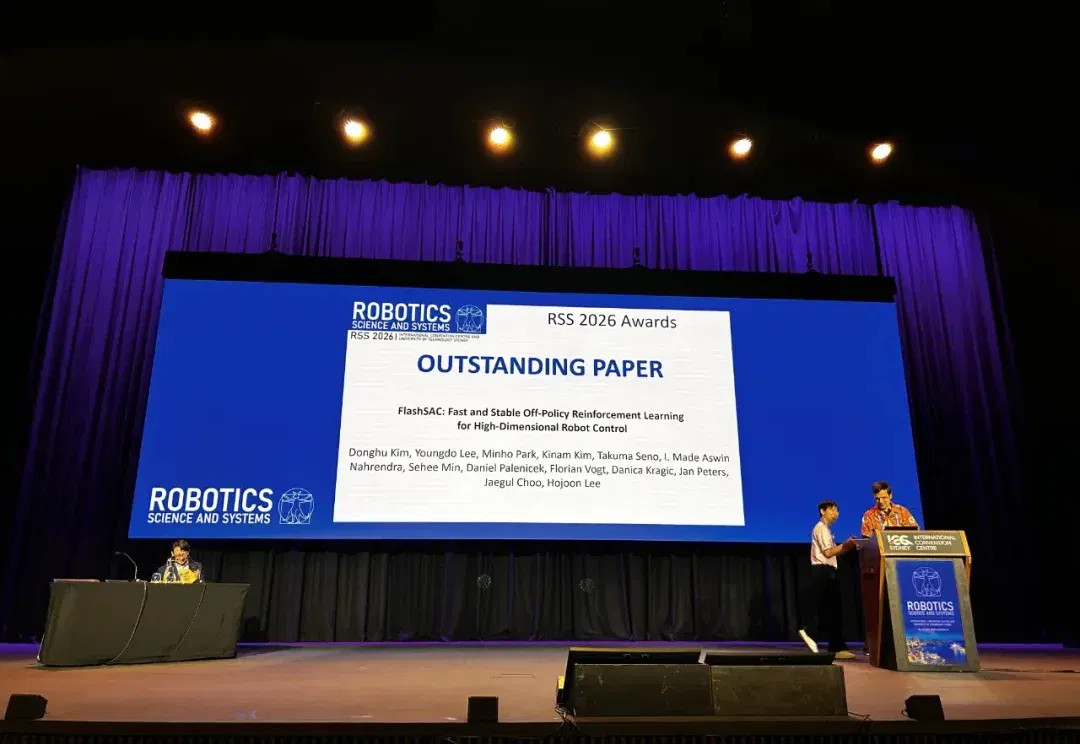
刚刚,机器人顶会RSS 2026论文奖项出炉!
近日,千寻智能高阳团队的研究成果 《Learning Native Continuation for Action Chunking Flow Policies》 被机器人顶会 RSS 2026 接收!这项工作从训练机制出发,让机器人动作天然具有连续性,实现了 "连音" 般的流畅执行,在五个真实世界操作任务上超越了现有方法,为具身智能领域的动作生成研究提供了新的思路。
近日,清华大学智能产业研究院(AIR)DISCOVER Lab 联合谋先飞技术、原力灵机、求之科技和地瓜机器人,提出了新一代高通量视觉高保真仿真器 GS-Playground。该成果已被机器人领域国际顶级学术会议 RSS 2026(Robotics: Science and Systems)录用,标志着国内具身智能仿真基础设施在视觉保真度与训练吞吐量两个维度上同时取得了国际领先水平的突破。
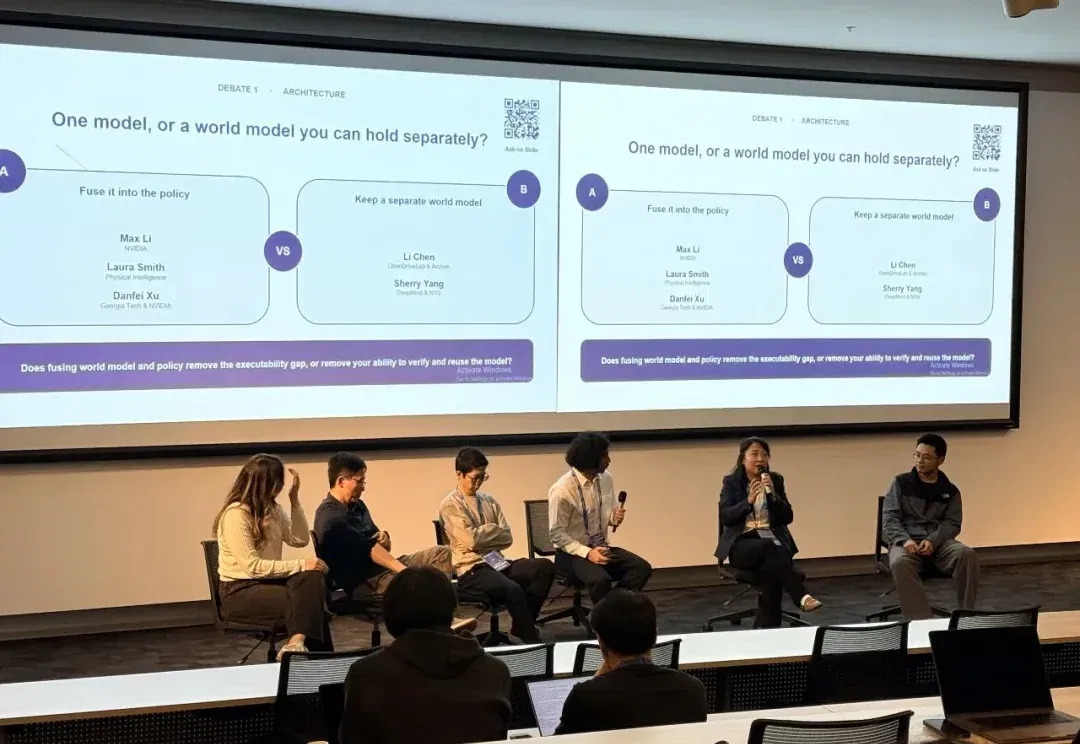
数据从哪来?控制靠像素还是动作? 在具身智能与机器人领域迅速演进的今天,一个问题正在浮出水面: 要想让机器人真正走进千家万户,我们到底该靠特定硬件采集的“具身数据”,还是该拥抱浩瀚如海的“互联网与人类行为数据”? 2026年RSS大会最后一天的workshop圆桌讨论,现场火药味十足。五位专家围绕世界模型的实际落地展开激烈交锋。 来自Georgia Tech和Nvidia的徐丹飞,以组合世界模型的研究闻名;Google与NYU的Sherry Yang,专注物理代理的世界模型评估与改进;Physical Intelligence的Laura Smith,强调具身智能的实践落地;NVIDIA的Ma
“包括Physical Intelligence在内,如今的北美头部具身智能公司离成熟都还有不短的距离。整个领域,也还没出现真正的奠基性工作。”“中国真正领先的,恰恰是机器人硬件。美国同样没有成熟答案,中国公司又何必急着把自己称为‘中国版XX’?”
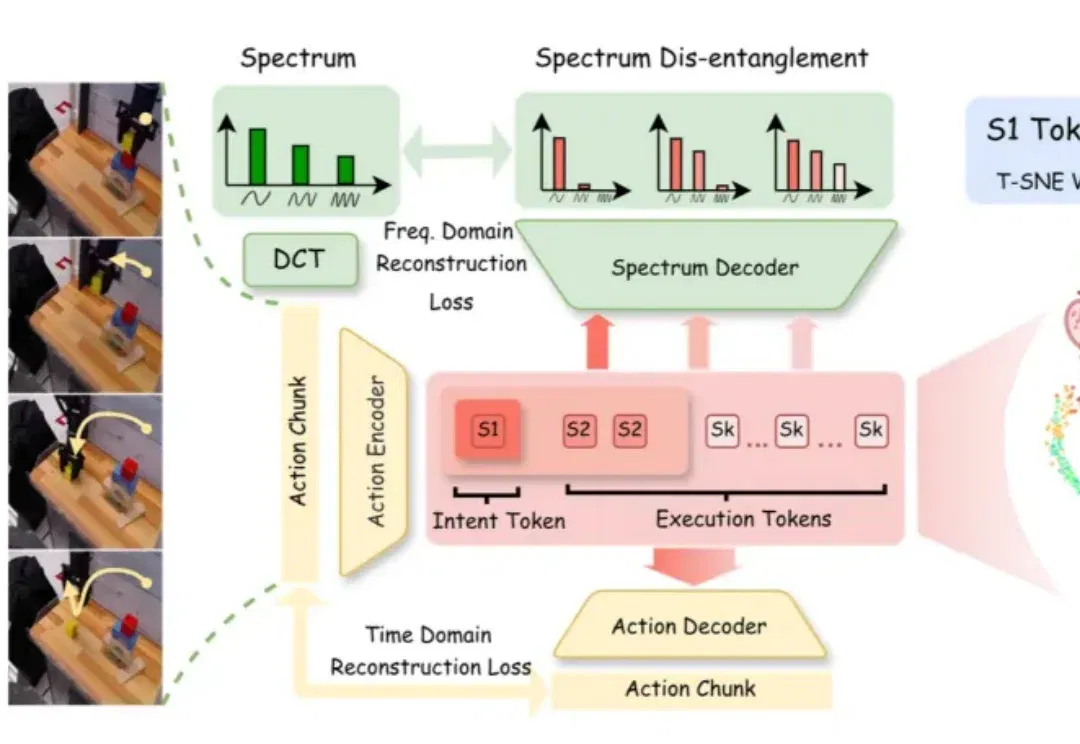
机器人视觉语言动作(Vision-Language-Action, VLA)模型越来越多地开始展示叠衣服、倒茶、做咖啡等复杂操作。但是,今天的大多数 VLA 更像 “展台机器人”。
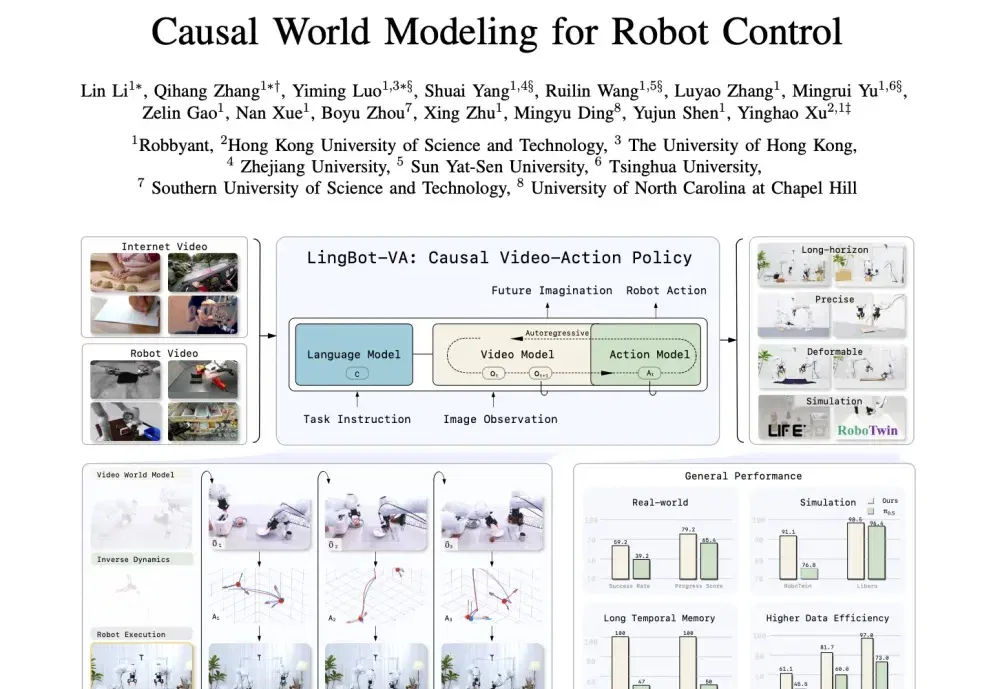
赋予机器人物理理解和预测能力是通用操作的关键。蚂蚁灵波等机构提出的 LingBot-VA 试图将视频帧预测与动作推理统一起来,让机器人通过自回归扩散框架学会“一边思考一边行动”。
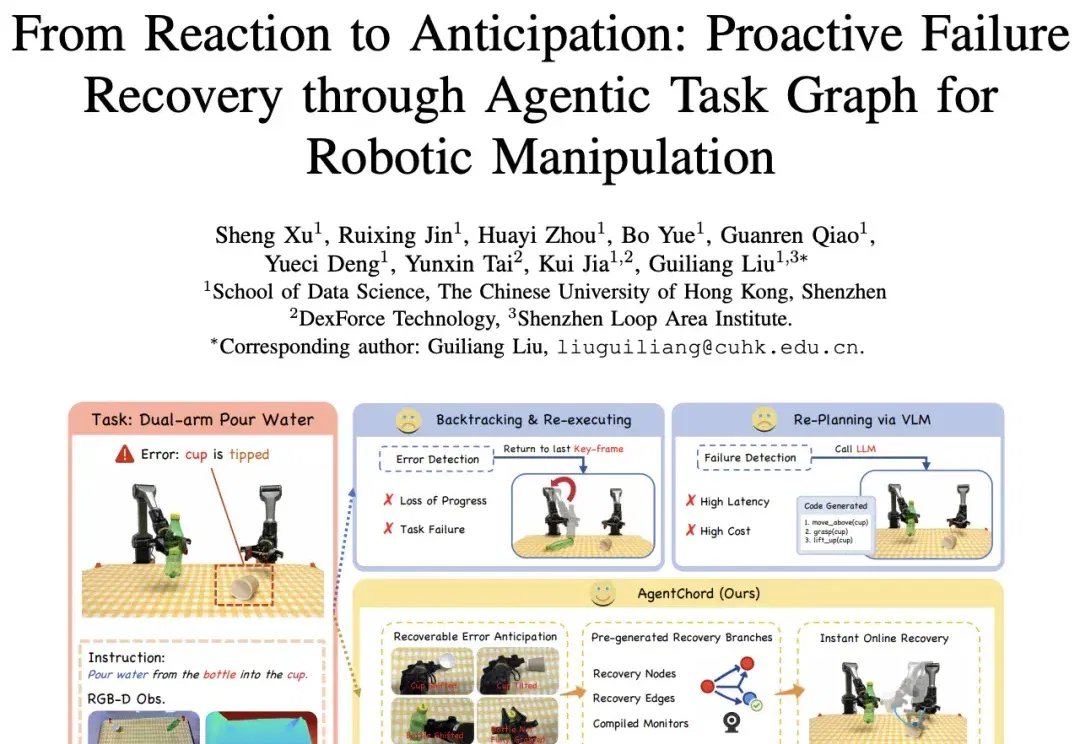
机器人操作正在从结构化工业场景走向更开放的真实环境。相比完成单个预设动作,真实任务往往包含更长的执行链条、更复杂的物体交互,以及更多不可控的外部扰动。一次抓取没有完全夹稳、目标物体被轻微碰偏、双臂交接时姿态出现偏差,都可能让后续步骤偏离原本计划。