Search

Results for “FP4”

Total 13 articles

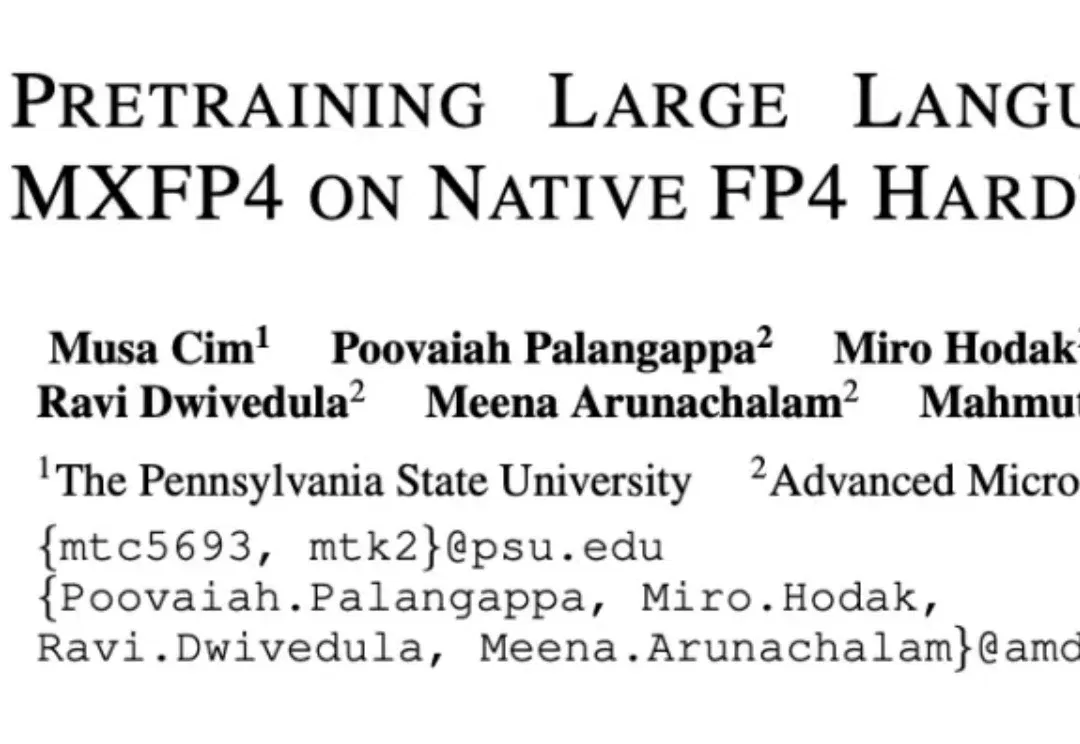
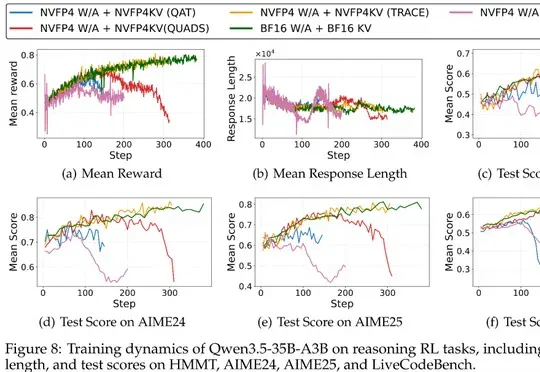
AMD新论文颠覆认知:FP4训练不稳定,原因不是随机性不足

AMD新论文颠覆认知:FP4训练不稳定,原因不是随机性不足 (opens in a new tab)

众所周知,大模型训练成本极高。 但大家又知道,降低训练精度能够显著降低训练成本。DeepSeek-V3 用 FP8 训练把成本打到了 560 万美元,已经让全行业侧目。 在 FP8 成功后,行业仍然在不断探索低精度的边界:从 FP8 降到 FP4,训练成本还能再降多少? 理论上,FP4 的计算吞吐可以是 FP8 的两倍。NVIDIA Blackwell 和 AMD MI350 系列都已经在硬件层面原生支持了 FP4 运算,前者在 B200 上标称 FP4 算力可达 4500 TOPS(稀疏)。硬件已经准备好了,但软件和算法那一侧,一直卡在一个问题上: 用 FP4 从头训练大模型,训练过程非常不
AI guides
0
训练提速4.6倍!FP4+BF16双轨并行,NVIDIA×港大×MIT联手重新定义扩散模型训练速度上限

训练提速4.6倍!FP4+BF16双轨并行,NVIDIA×港大×MIT联手重新定义扩散模型训练速度上限 (opens in a new tab)

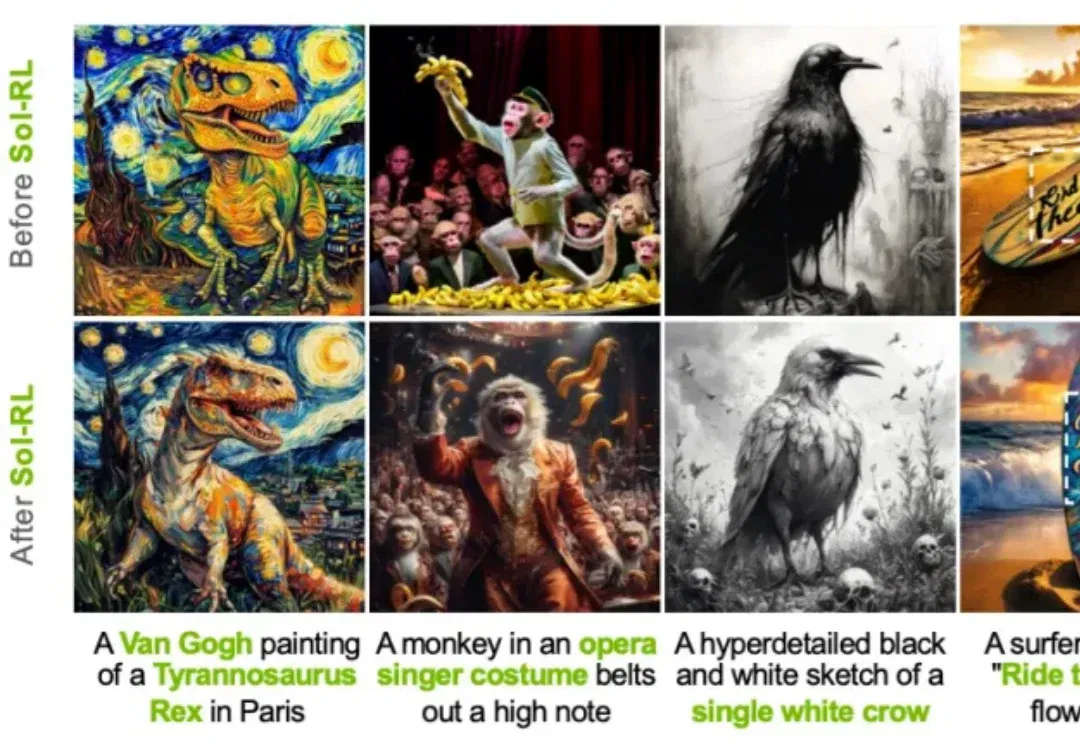
当强化学习后训练的大规模 rollout 已经被证明能够提升图像生成模型的偏好对齐能力,推理负担就成了制约训练速度的核心瓶颈。来自 NVIDIA、港大和 MIT 的团队提出的 Sol-RL,通过「FP4 先探索、BF16 再训练」的后训练框架,将达到等效 reward 水平的收敛速度最高提升到 4.64x,在训练速度与对齐效果之间给出了一条更具工程可行性的解法。

AI guides
0
5.5B激活参数!又一国产多模态模型开源,能自己看网页改代码,免费可用

5.5B激活参数!又一国产多模态模型开源,能自己看网页改代码,免费可用 (opens in a new tab)

视觉编程成绩超GPT-5.4。 智东西9月9日报道,今日,蚂蚁百灵正式开源其首个原生多模态大模型Ling-3.0-flash-VL。Ling-3.0-flash-VL是一款1240亿总参数的MoE模型,单次推理激活5.5亿参数,原生支持图像、文本和视频输入,上下文窗口达到256K Tokens。 此次蚂蚁同步开放了模型的BF16和FP8版本,开发者已经可以在Hugging Face和ModelScope下载模型权重,FP4和INT4版本也将在近期上线。 ▲Ling-3.0-flash-VL开源主页(图源:Hugging Face) 这款模型基于此前的Ling-3.0-flash拓展而来。相比纯

AI news
0