37万次真实会话实测Agent榜单:GPT-5.5High第一,Claude最稳,真实干活能力看这五项核心指标 (opens in a new tab)
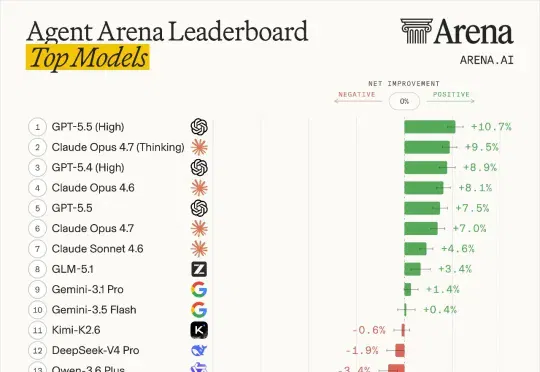
6月4日,Arena.ai发布Agent Arena排行榜,用373,431次真实会话的数据,给18个主流模型的Agent能力排了个座次。先看总榜。Agent Arena的排名依据是“净改进”(Net Improvement),用因果推断方法算出每个模型相对于随机基线的性能提升幅度。正值代表比随机选择更好,负值说明不如随机。
Total 5 articles
6月4日,Arena.ai发布Agent Arena排行榜,用373,431次真实会话的数据,给18个主流模型的Agent能力排了个座次。先看总榜。Agent Arena的排名依据是“净改进”(Net Improvement),用因果推断方法算出每个模型相对于随机基线的性能提升幅度。正值代表比随机选择更好,负值说明不如随机。
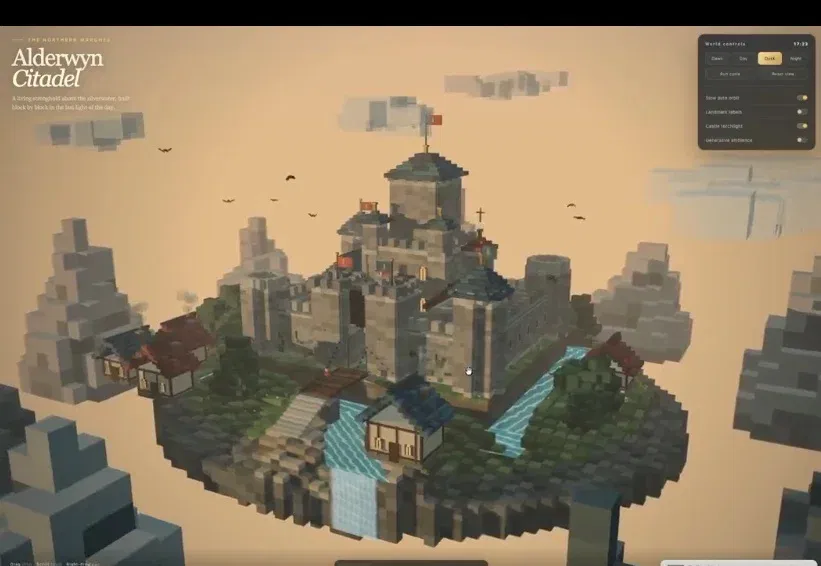
大的要来了,而且一下来了俩。 最近两天,人们在 Arena.ai(原 LMArena)的编程对战 Code Arena 中发现了两个陌生的名字:Kibitz、Kalmia。厂商在正式发布前,经常会把新模型以匿名代号放进盲测,让真实用户在不知情的情况下投票。经过仔细分析,很多人把它们与国产新模型联系在了一块。人们认为 Kibitz 疑似是月之暗面的 Kimi K3.1,Kalmia 疑似阿里的 Qwen 4。 先来看看效果,X 上有人不停「抽卡」,用刷到的新模型制作出了不少 SVG、网页和可交互的 3D 场景。 「build what you think you look like in Min
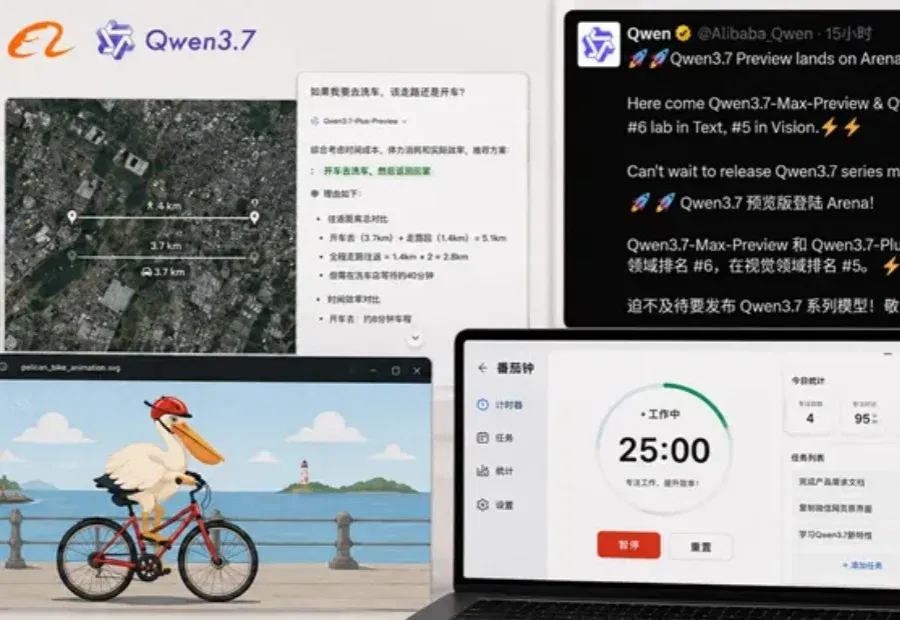
阿里正加速Qwen主模型的迭代节奏。 智东西5月19日报道,今天,阿里的Qwen3.7系列预览版模型已上线,共有Max和Plus两个版本。大模型竞技场也放出了Qwen3.7-Max-Preview的评测结果。在大模型竞技场覆盖主流基座大模型的总榜上,Qwen3.7-Max-Preview排名第13,介于GPT 5.5和Grok 4.2之间,是这一榜单上排名最高的国产模型。 在具体的细分榜单上,Qwen3.7-Max-Preview在数学领域排名第7、在专家任务中排名第9、在软件与信息技术任务中排名第9、在编程任务中排名第10。 ▲Arena.ai公布Qwen3.7-Max-Preview的成绩
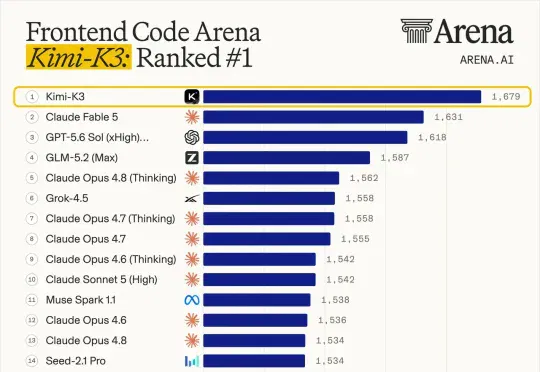
今天凌晨看到 Arena AI 更新 Code Arena 榜单时,我第一反应是有点意外。刚刚发布的 Kimi K3 拿到了 1679 分,排在全球第一,压过了 Claude Fable 5 的 1631 分和 GPT-5.6 Sol 的 1618 分。
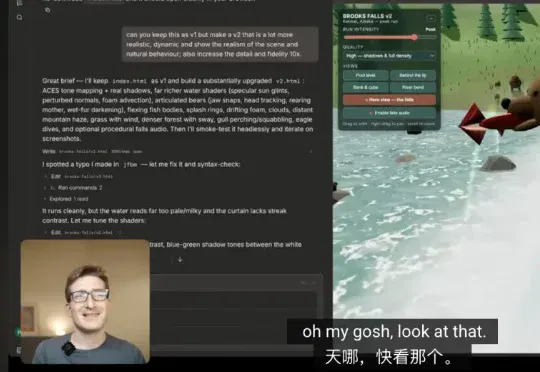
Fable 5重新上线,Arena.ai的Gostev在一段视频中甩出63个3D世界,几乎都是一次成型。看了视频,就连刚加盟Anthropic预训练团队的Karpathy,也直呼没想到。