连夜实测 Kimi K3,建议改名 Kable
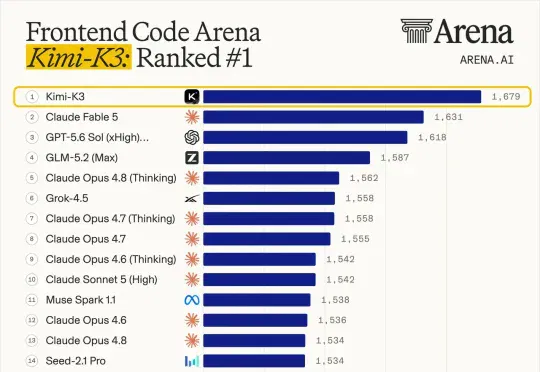
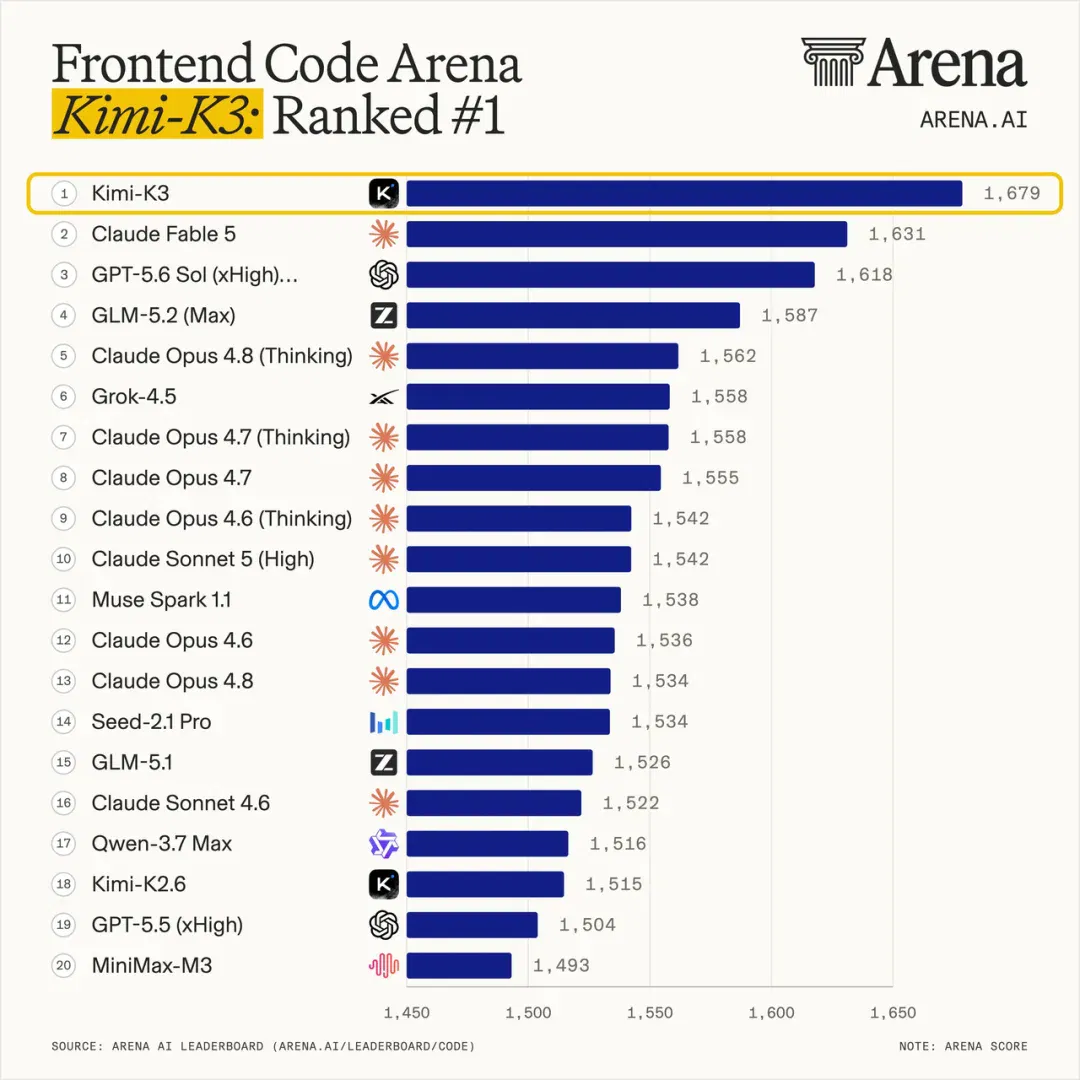
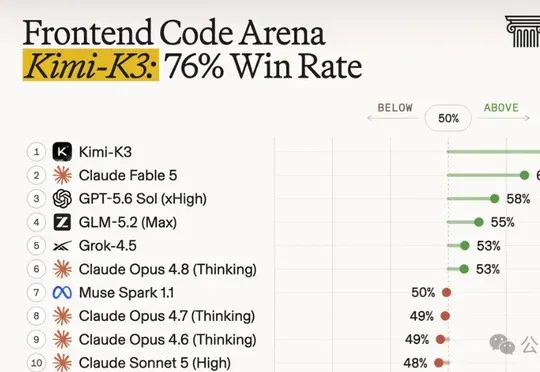
今天凌晨看到 Arena AI 更新 Code Arena 榜单时,我第一反应是有点意外。刚刚发布的 Kimi K3 拿到了 1679 分,排在全球第一,压过了 Claude Fable 5 的 1631 分和 GPT-5.6 Sol 的 1618 分。
今天凌晨看到 Arena AI 更新 Code Arena 榜单时,我第一反应是有点意外。
刚刚发布的 Kimi K3 拿到了 1679 分,排在全球第一,压过了 Claude Fable 5 的 1631 分和 GPT-5.6 Sol 的 1618 分。
Code Arena 测的主要是前端编程。模型需要根据用户要求生成网页,完成视觉还原、交互设计和功能实现。
榜单结果来自百万级用户参与的公开盲测。同一道任务会交给两个匿名模型,用户实际体验两个结果后投票,投票完成才会公布模型身份。
在结果揭晓前,用户并不知道自己选的是哪家模型,品牌影响被削弱,结果更具含金量。换句话说,至少在强调视觉呈现和交互实现的前端编程场景里,K3 已经坐到了目前最靠前的位置。
一个刚发布的开源模型,轻松就超过多款闭源旗舰,让人很难相信,too good to be true。于是我们趁着热乎劲,连夜测试了 Kimi K3,来检验检验它的成色?
冷知识,下面这段视频并非 Kimi 官方发布的宣传短片,而是 APPSO 把原预告片交给 K3 参考,让它重新生成的一段动画。
从理解原视频、重建网页画面,到处理镜头、动效和交互,整个过程都由 K3 完成。让模型亲手做一支介绍自己的动画,也算是最直观的开场测试。
尤其考虑到最近 Fable 5 和 GPT-5.6 打得热闹,能力越来越强,Token 消耗也一路上涨。很多人还在等 Claude Opus 5,没想到 Kimi 先端出了一个参数规模达到 2.8 万亿的开源模型。
你没看错,2.8 万亿,而且开源。
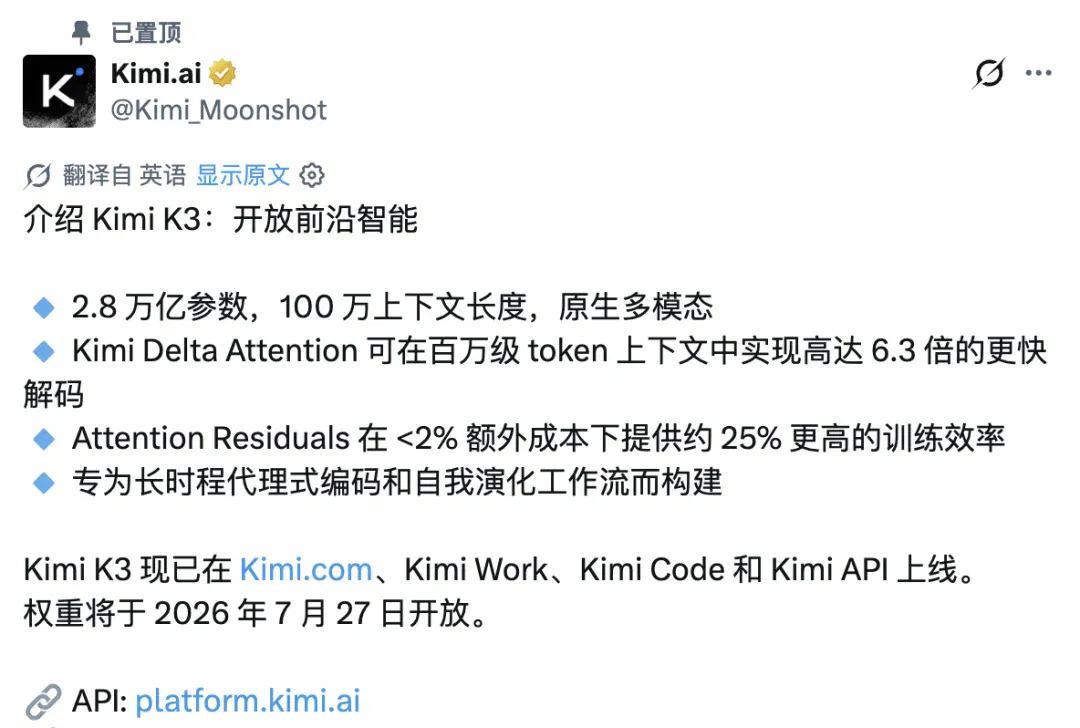
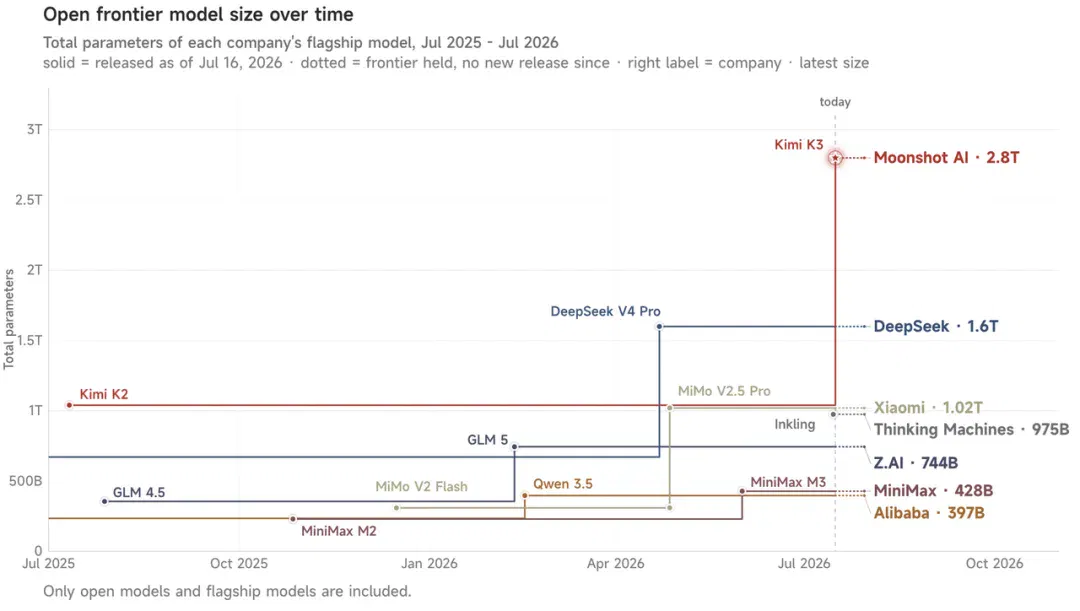
Kimi K3 拥有巨无霸版本的 2.8 万亿参数, 全球首个开源的 3 万亿级别模型。100 万 token 上下文, 原生支持视觉理解, 主打长程编程、知识工作和推理。
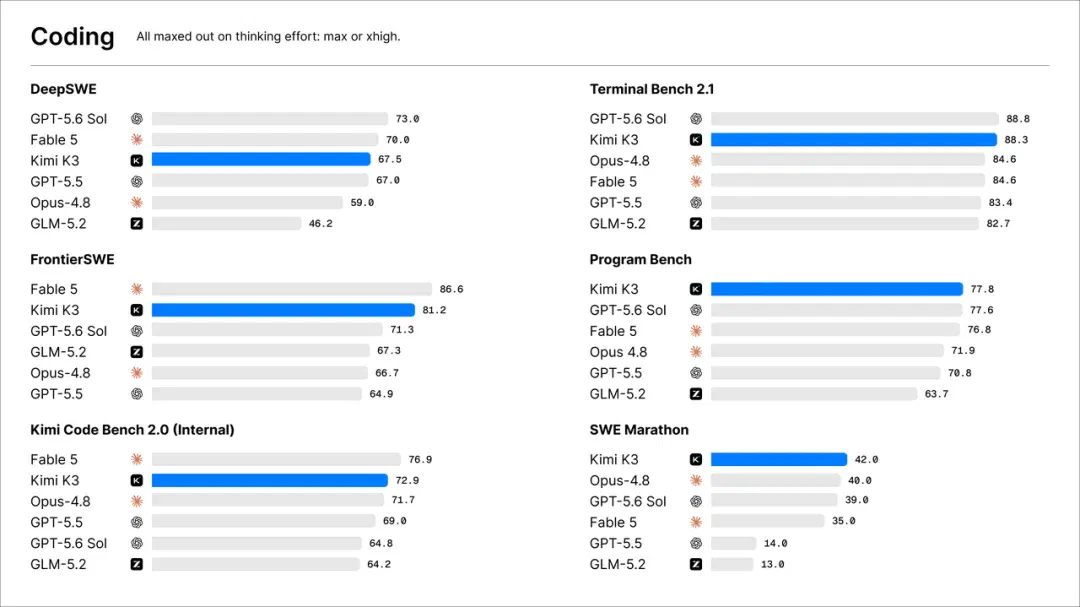
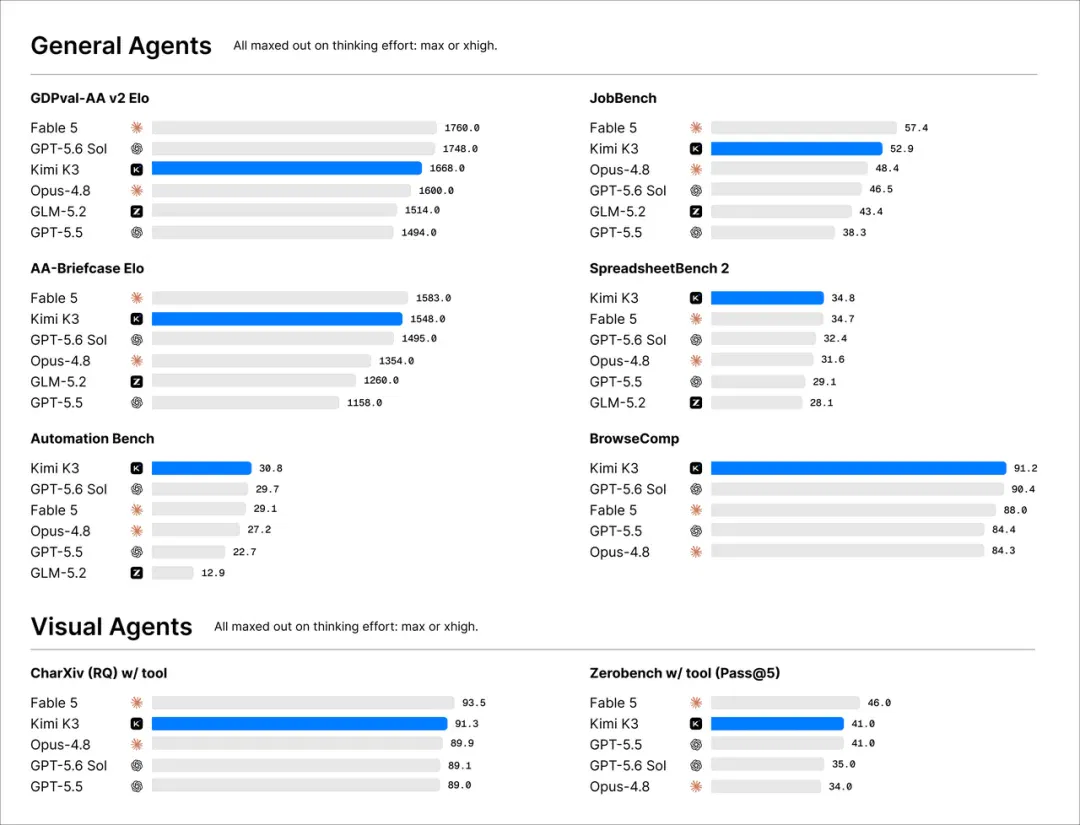
好家伙, 闭源旗舰们还在挤牙膏, 开源这边直接把参数规模顶到了新天花板。
更有意思的是官方博客里的这句话:「虽然 Kimi K3 的整体表现仍落后于最强的闭源模型 Claude Fable 5 和 GPT-5.6 Sol, 但它在我们的整套评测中展现出前沿水平的能力, 并稳定超过了其他所有模型。」
如此坦诚, 这在国产大模型的发布博客里, 属实是股清流了 (doge)。但谦虚归谦虚,K3 这次端上桌的能力,分量一点不轻。
靠这两个东西驯服 2.8 万亿巨兽
先看看, 这个 2.8 万亿参数的模型是如何炼成的?
过去 12 个月里, 有 9 个月开源模型的规模上限都是 Kimi 家保持的。K3 算是这条路线的最新一步。架构上,K3 有两个新东西:混合线性注意力 (Kimi Delta Attention) 和注意力残差 (Attention Residuals)。
比较通俗的理解是,前者让模型处理超长序列时不至于被计算量拖死, 后者让信息在几百层的深度网络里传递时不「失真」。一个管技术长度, 一个管技术深度, 合起来撑住了万亿级以上的参数规模。
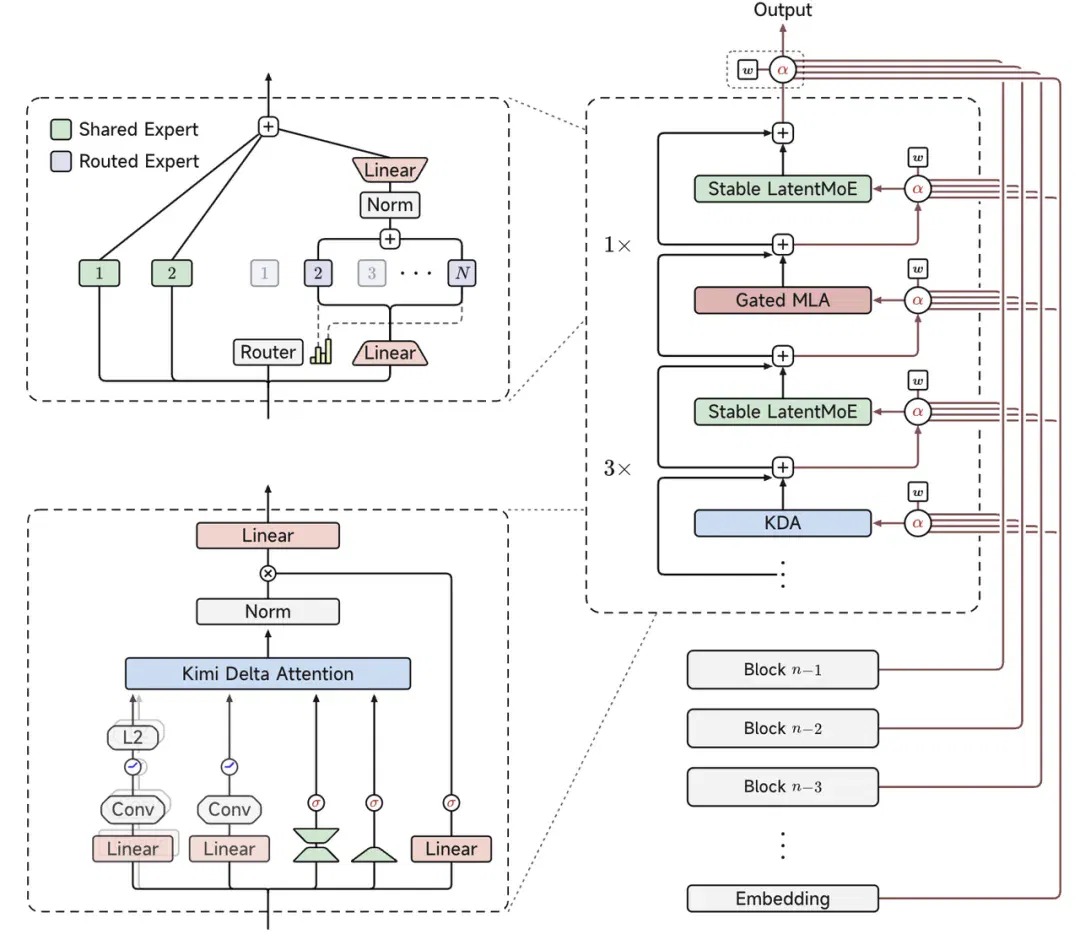
MoE 稀疏度也进一步扩大了优势:896 个专家, 每次只激活 16 个。配上训练方法和数据配方的优化, 官方说 K3 相比 K2 的整体扩展效率提升了约 2.5 倍。
同样的算力, 能换回更多的能力。
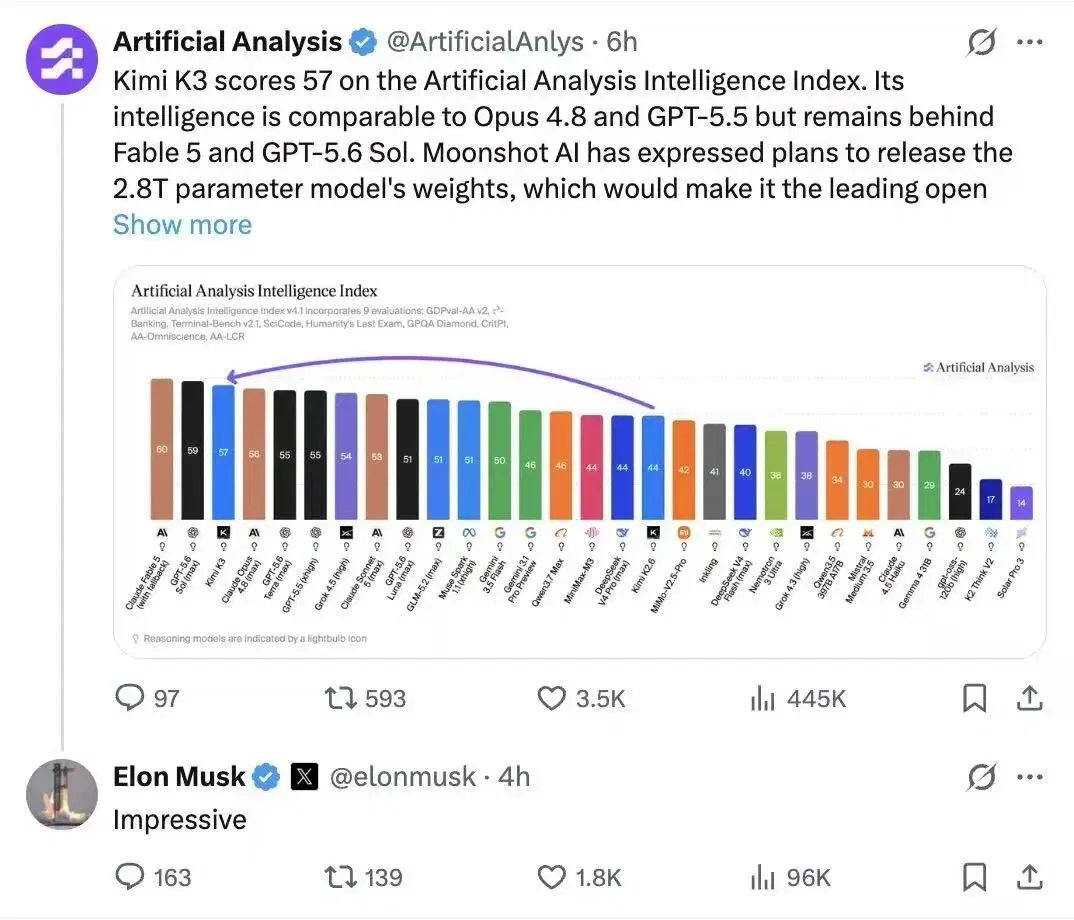
放到覆盖推理、编程、知识等能力的 Artificial Analysis Intelligence Index 中,K3 又以 57 分排在第三,仅次于 Claude Fable 5 和 GPT-5.6 Sol,同时领先 Claude Opus 4.8、GPT-5.5 等模型。
这份成绩单也引来了马斯克的注意。他现身评论区,留下赞美之词:「Impressive(令人印象深刻)」。
两张榜单放在一起看,K3 距离综合能力最强的闭源模型还有差距,但在编程这一主战场上已经相当能打。
看到如此强大的模型, 相信你的的第一反应估计也是:这玩意跑起来得多贵?
Kimi 显然预判了你的预判。
K3 从 SFT 阶段就开始做量化感知训练, 用 MXFP4 权重和 MXFP8 激活, 天生适配低精度硬件。专家并行训练做了完全均衡, 静态形状, 关键路径不需要主机同步。
KDA 对传统 prefix caching 有新挑战,Kimi 干脆把对应实现贡献给了 vLLM 社区, 随模型一起开源发布。
落到价格上,其实我们觉得中国模型并不应该总是比拼低价,不仅要有公司负责「量大管饱」,也要有公司能挑战 Anthropic 和 OpenAI 的定价权。
这次 K3 在性能上对标甚至超过 Opus,偶尔够一够 Fable,官方 API 的输入和输出价格是 Fable 的 20%,Opus 的 40%,这是要把 Anthropic 价格打下来的意思。
考虑到这个模型 10 天之后就会开源,有实力的公司可以自己部署模型,以及中国 AI 公司普遍缺卡的现实,这个定价就更值得玩味了。
不过 API 价格跟普通用户关系不大,大家用的包月套餐在用满的情况下,通常要比 API 价格便宜 5 到 10 倍。
实测 K3 ,你的名字应该叫 Kable
参数规模和价格都聊完了, 接下来是最关键的问题:它到底能干多难的活?
我们给 K3 准备了五个跨度很大的任务,既有物理模拟、程序化建模和复杂经营系统,也有更依赖审美判断的东方奇幻场景。画面做得漂亮只能算及格,背后的数值变化、状态演进和交互逻辑同样要成立。
今年世界杯,点球成了很多比赛的胜负手,强如梅西也会罚失点球,我想用 AI 计算出一个进球概率最高的点球角度。
K3 把球员脚感、射门角度、球速、门将反应等变量转化为一套可信的计算模型,再基于公开数据进行大规模蒙特卡洛模拟,反复比较不同策略的成功率,最终回答那个所有主罚者都想知道的问题:
在不突破职业球员真实能力上限的前提下,球该怎么踢,才最难被门将扑出。
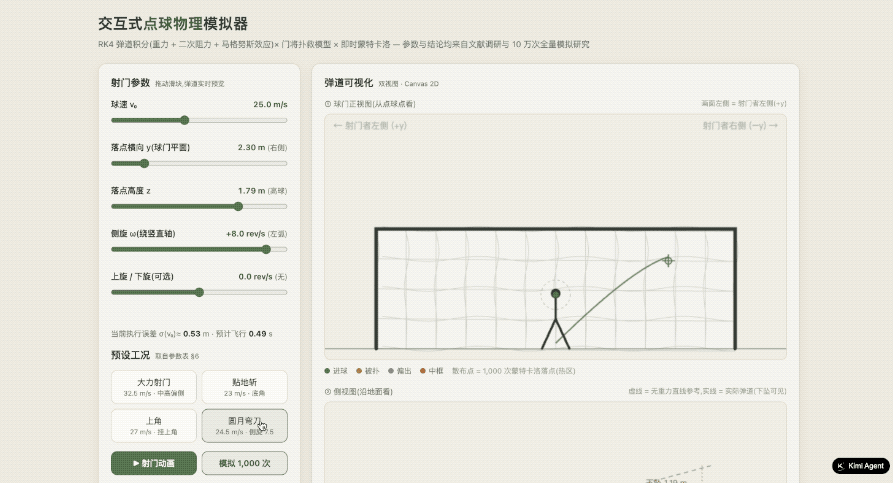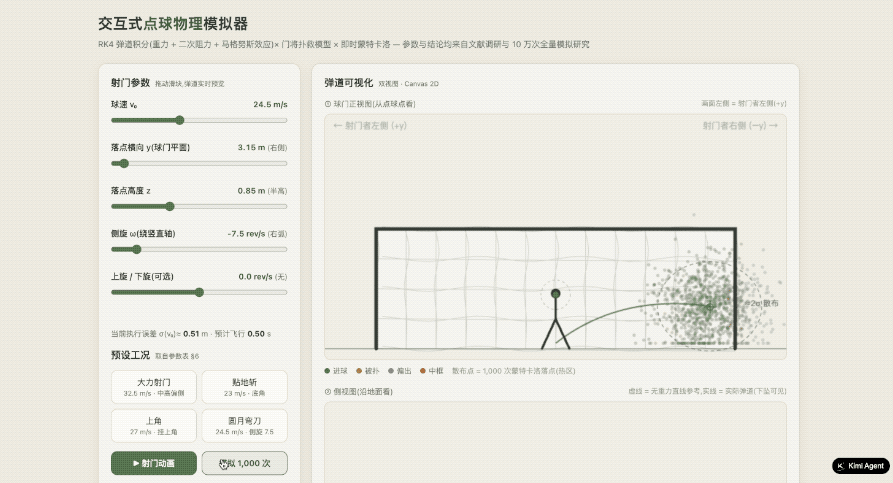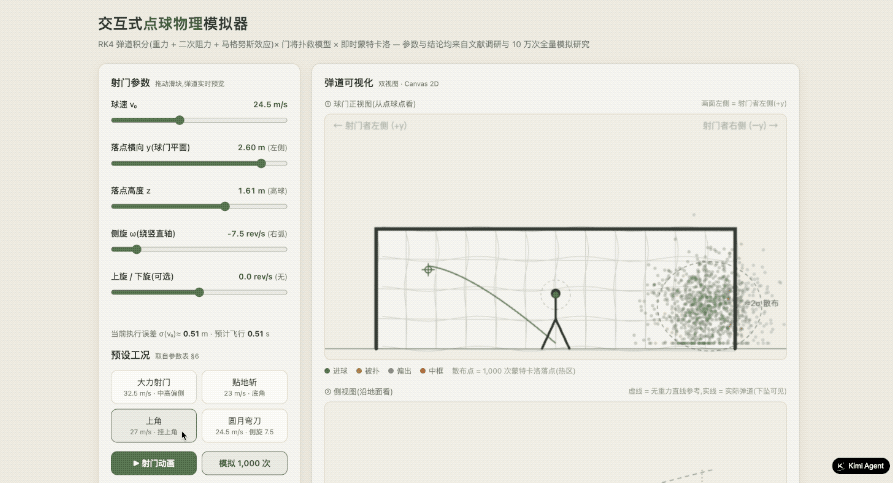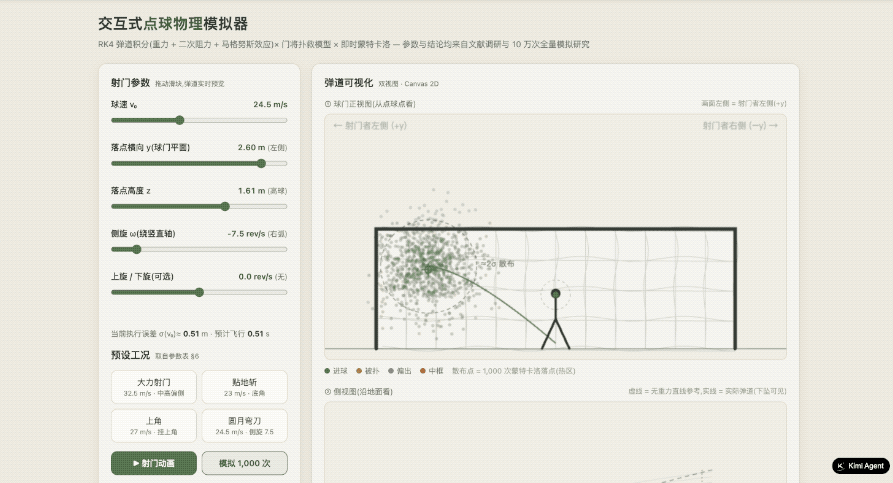
体验链接:https://doxsa4fwmxag2.ok.kimi.link/
K3 计算出理论上最难扑的一脚:v₀≈25 m/s + 侧旋≈8 rev/s + 半高偏侧落点,进球概率 ≈89%,强烈建议梅西决赛前先看看这篇文章。
第二道是用 Three.js 从零造一个巧克力工厂花园世界:巧克力河、焦糖瀑布、糖果园、铜制大锅、传送带、微缩工人, 全部程序化生成, 不许用外部素材, 还要求工人有真实的任务队列和路径网络, 而非原地摆拍。

体验链接: https://d7gfoy6v7et5e.ok.kimi.link/
同样是程序化建模,《Emberhold:熔火矿城》进一步加入了经营和风险系统:多层矿井、轨道矿车、熔炉锻造、通风与塌方系统全部联动, 挖得越深矿越稀有, 但温度和塌方风险同步上升, 矿车必须沿真实轨道行驶。
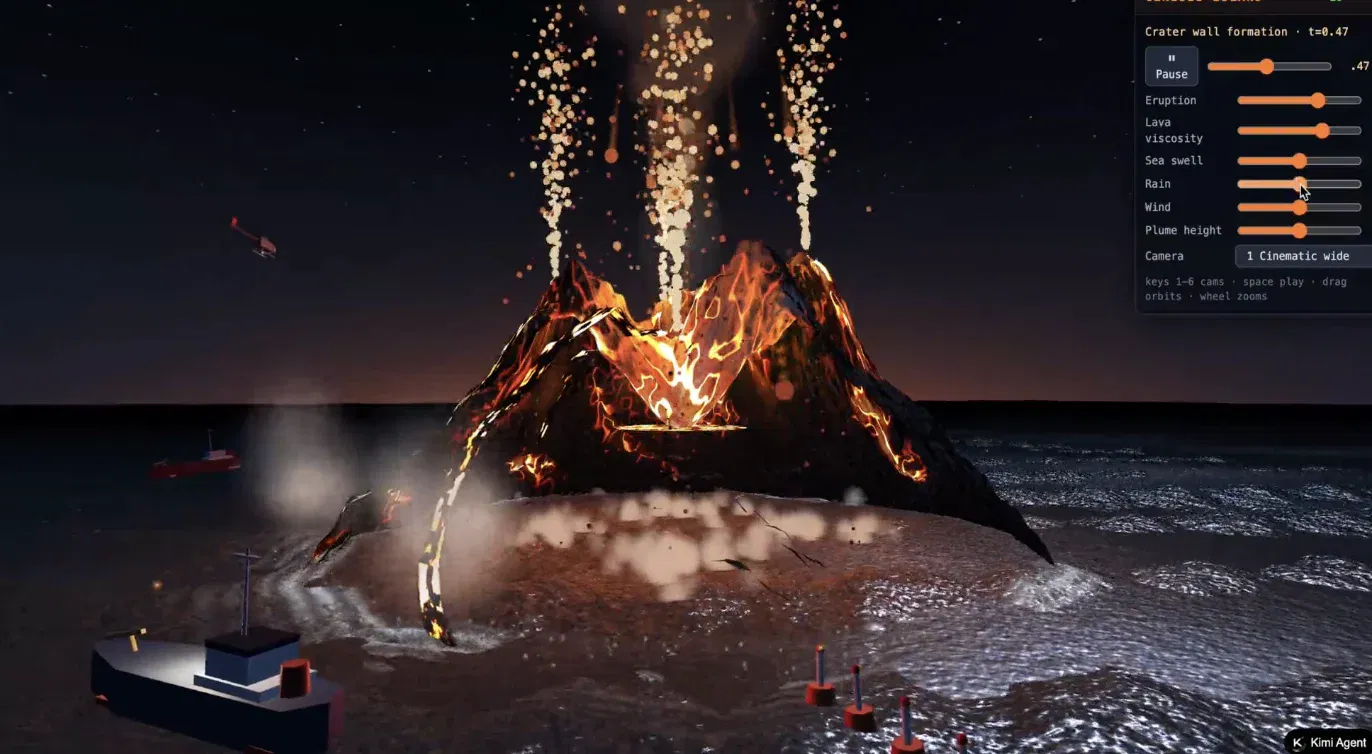
体验链接:https://uvj7y4fnuomew.ok.kimi.link/
难度较高的一题,把场面推向了海底火山喷发。K3 需要用 Three.js 实时呈现一座岛屿从海中诞生的全过程:熔岩喷泉撕开海面,蒸汽、火山灰、闪电、巨浪和科研船同时运动,海岸线还会随着熔岩冷却、坍塌和海浪侵蚀不断生长。
难点在于,它需要同时维持多套动态系统,并提供从海底冒泡、火山爆发到岛屿稳定和生命萌芽的时间轴,以及船上、直升机、海岸线和火山口等多种观察视角。画面规模、物理变化、交互控制和运行性能,缺一项都会让这个案例变成普通的火山演示。
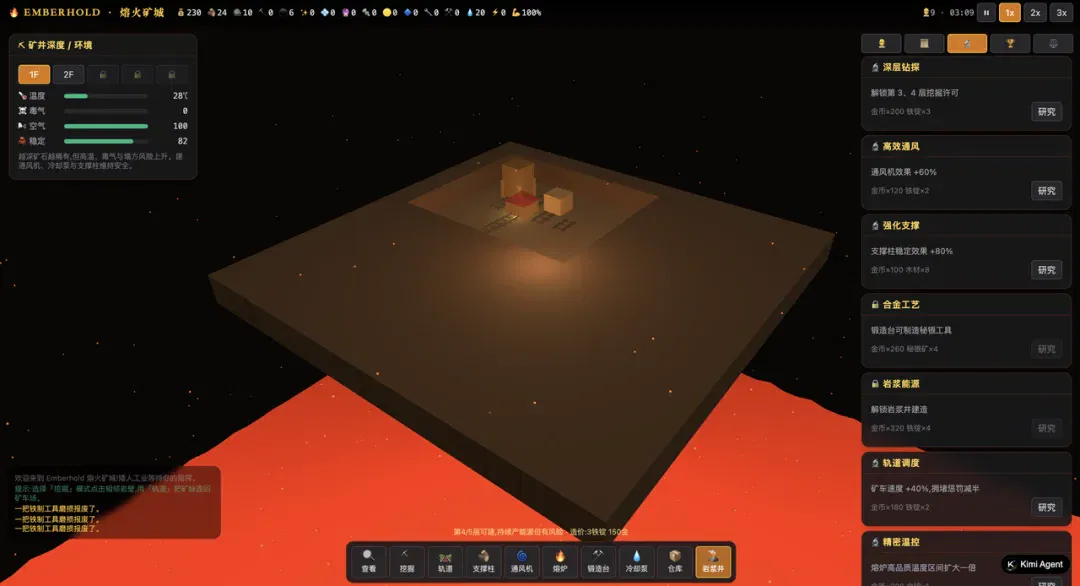
体验链接:https://miuqtzgbqin72.ok.kimi.link/
硬功夫考完,最后看看它的审美。在这个东方奇幻水墨风油纸伞场景中,细雨青石水面上悬浮着层层油纸伞,透光投影、伞面流动图案与可操控人物跳跃互动共同营造出灵动梦幻的效果。
体验链接:https://zprg5ulr2dxom.ok.kimi.link
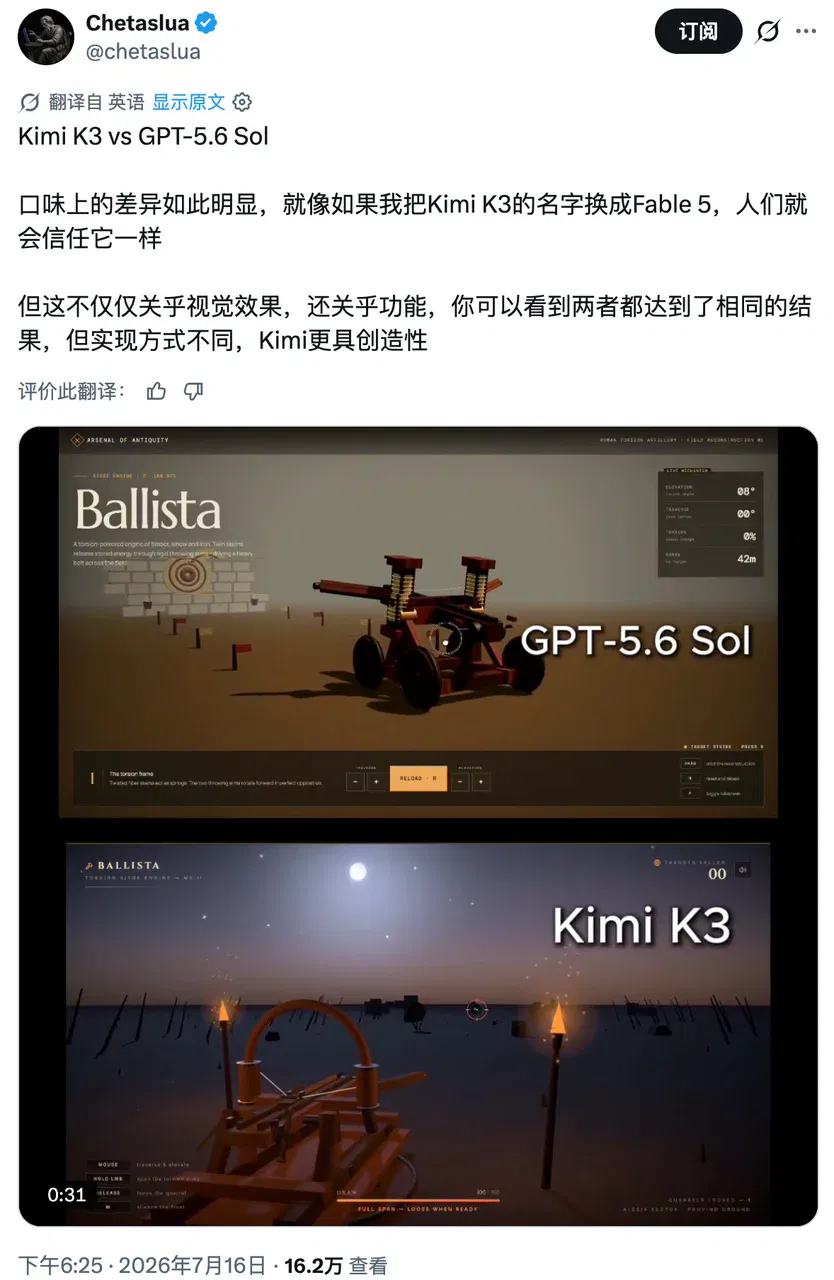
而 X 网友 @chetaslua 的这个案例,在他看来,虽然 K3 和 GPT-5.6 Sol 达到了相同的结果,但实现方式不同,K3 更具设计品味和创造力。
光视觉惊艳的 demo 当然不够,我还用 Kimi K3 开发了一个专注 App,提示词就一句话:复刻 Forest,但界面更精美,动效像 Focus Flight。
几个小时后它就真的做出来了,甚至达到可玩的产品原型水准,这活儿以前一个前端可能要干两三周。
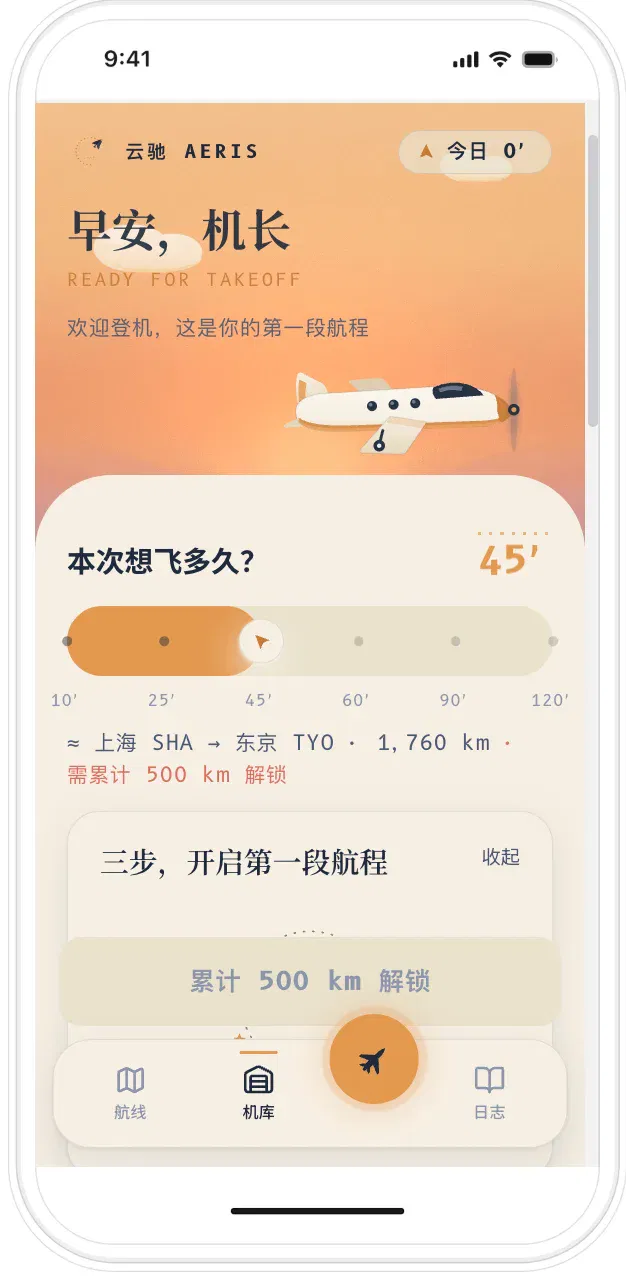
这个 App 叫「云驰 Aeris」,点开是一片黄昏色的机库,一架飞机在跑道上等我选航线。
它把 Forest 的种树专注玩法换成了航班飞行,但也并非简单换皮:专注时长等于飞行时间,还能选择不同的白噪音,登机后进入动态巡航,中途退出会触发返航,完成航程则能积累里程、解锁新目的地,从品牌命名、视觉风格到交互和成长体系都非常完整。
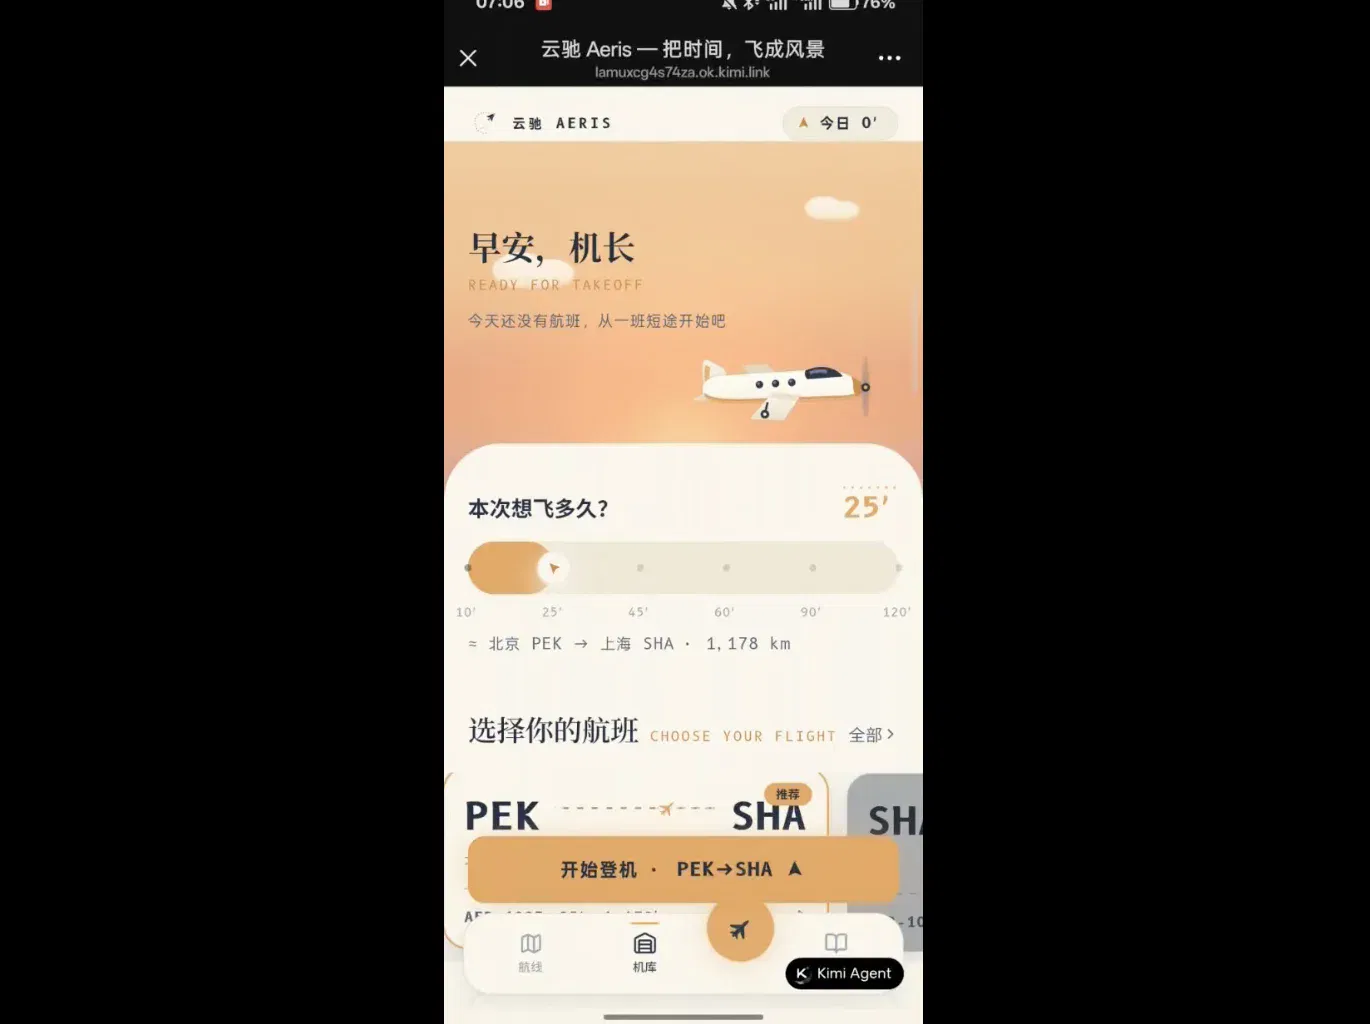
写这篇文章的时候,我又飞了几趟了。APPSO 也附上链接,大家可以尝试飞一飞 ✈️
https://lamuxcg4s74za.ok.kimi.link/#/
开源模型的 K3 时刻
更难得的是,官方博客也愿意分享他们积累的反思。
K3 对历史思考内容很敏感。它在后训练全程使用思考历史保留模式, 如果 Agent 框架没按要求回传全部历史思考内容, 或者你从其他模型的会话中途切换过来, 生成质量可能不稳定。
官方建议用 Kimi Code 这类验证过兼容性的框架, 别在会话中途换模型。
它还有点过于主动。由于训练重点在长程高难任务, 遇到小问题或者用户意图模糊时, 它可能替你做出非预期的决定。想让它老实一点, 得在 system prompt 或 AGENTS.md 里给它立规矩。
而就冲这个坦诚劲儿, 先给个好评。
说到这里,不妨再聊点更实际的。全球最大开源模型, 目前并不等于全球最强。2.8 万亿参数也不能直接证明 K3 已经超过顶级闭源模型。模型能不能真正干复杂工程, 最终还是要看使用成本、任务稳定性和真实交付结果。
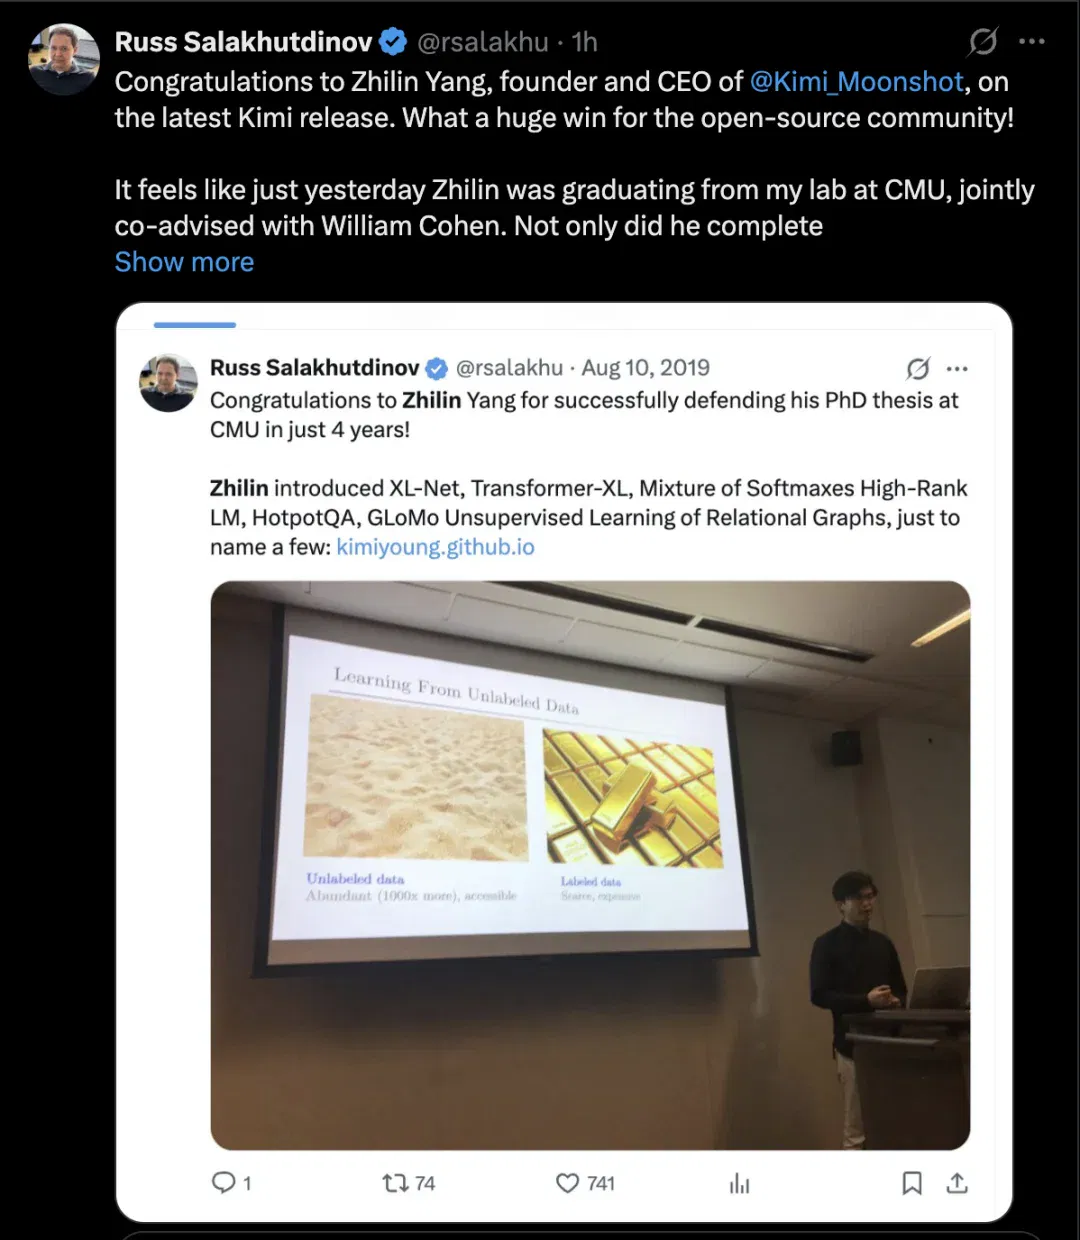
彩蛋:月之暗面(Kimi)创始人杨植麟的 CMU 导师 Russ Salakhutdinov 发帖祝贺,而 Russ Salakhutdinov 也正是 Hinton 亲传弟子、苹果第一任 AI 总监
但 K3 的出现至少改变了一件事。
过去开源模型的策略, 是跟在闭源旗舰身后, 用更低的价格复现已有能力。现在它开始主动把规模推向新上限, 去碰百万上下文、长程编程和复杂 Agent 任务, 直接参与下一代模型能力边界的竞争。
在 X 上一些网友把 Kimi K3 称为又一个 DeepSeek R1 时刻,但 APPSO 连夜体验下来,倒是认为在开源模型里,K3 完全能拥有自己名字。
2.8 万亿只是一张入场券。Opus 5 还没到, 开源模型已经重新洗牌了,我愿称之为 K3 时刻。
文章来自于微信公众号 “APPSO”,作者 “APPSO”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
第三方机构实测:Agent 场景下,Kimi K3 反超 GPT-5.6 Sol (opens in a new tab)
Kimi K3 发布十天后,AI 原生云服务商 Together AI 公布了一份独立评测报告。
TCSExam 测试研究级数学任务,Kimi 构造出 630 条边的图 (opens in a new tab)
姚期智、杨植麟等人的团队提出包含 100 项任务的 TCSExam。Kimi K3 在特定无短环图构造任务中将参考结果从 629 条边推进到 630 条边。
Kimi突发K2.8:性能逼近K3,百万上下文全员开放 (opens in a new tab)
Kimi于9月11日上线K2.8 Preview模型,综合性能接近旗舰K3并将1M上下文开放至全部会员档位,作为低成本主力模型承接月之暗面快速增长的商业化需求。
Kimi Hosted Agents 正式发布:Harness as a Service (opens in a new tab)
Kimi Hosted Agents 正式发布,以 Harness as a Service 提供7×24小时托管环境,支持长程任务、多智能体协作、安全控制、审计及140+ Skills、30+插件和8个金融Agent模板。
Kimi 发布游戏开发方案,连接专业引擎、建模与运营工具 (opens in a new tab)
Kimi 介绍基于K3.1 Pro、Kimi Code和Kimi Work的游戏开发方案,连接Unity、Unreal、Blender等工具,展示原型、工程修改与试玩验证。官方演示的耗时与完成度依赖任务及环境,不代表任意用户都能在一两天完成商业游戏。