手机就能指挥AI干活:谷歌Smith Agent叫板OpenClaw的5个杀招 (opens in a new tab)
你正在地铁上,突然想起有个API文档还没写完。以前你只能忍着到公司再弄,现在——你掏出手机,给AI发了一条指令,20分钟后代码自动跑完了。 这不是科幻,是Google员工已经用上的真东西。 它的名字叫
Total 119 articles
你正在地铁上,突然想起有个API文档还没写完。以前你只能忍着到公司再弄,现在——你掏出手机,给AI发了一条指令,20分钟后代码自动跑完了。 这不是科幻,是Google员工已经用上的真东西。 它的名字叫
在当前的 LLM 开发中,后训练阶段通常被视为赋予模型特定能力的关键环节。传统的观点认为,模型必须通过强化学习(如 PPO、GRPO 或 RLHF)和进化策略(ES)等算法,在反复的迭代和梯度优化过程中调整权重,才能在特定任务上达到理想的性能。
过去,科学家观察研究细胞的工具很有限。 随着技术进步,科学家能同时拿到这些关于细胞的分子信息,例如DNA、转录组、蛋白质丰度等。 然而,生物学数据的难点不仅在于获取,还在于如何分析与解读。 我们虽然看到了更全更多的信息,科学家却经常分不清哪些信息决定了细胞的功能。 近期,来自麻省理工、哈佛布罗德研究所及苏黎世联邦理工学院的研究团队,推出了一款名为APOLLO的AI新框架。 这项研究为科学家提供了全新的视角:细胞行为的导航地图,而不是一堆互不关联的细胞数据。 这项研究于近日发表于《Nature Computational Science》上。 它有望为疾病诊断、药物研发乃至合成生物学打开一扇新的
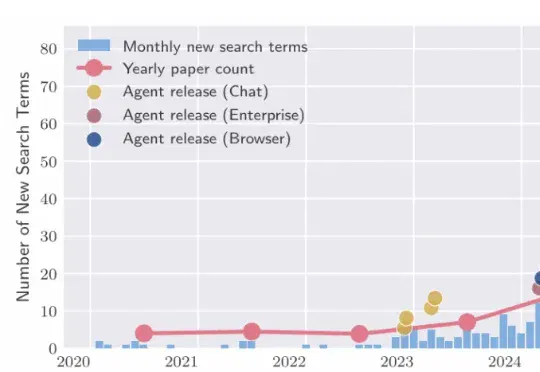
这两周,Claude Code 上了个 COBOL 现代化功能,IBM 当天暴跌 13%;又上了个安全扫描功能,一口气翻出 500 多个此前藏了几十年的高危漏洞,网安股集体跳水。彭博社甚至专门做了一期播客讨论“哪些 SaaS 公司能活下来”。
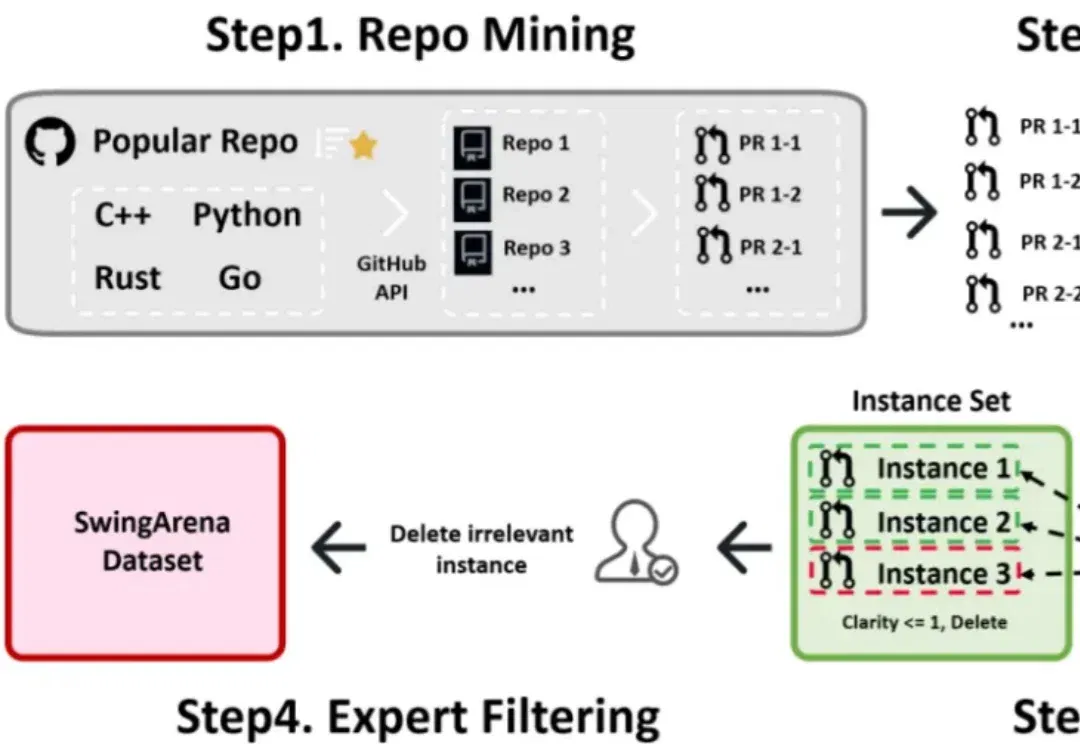
过去一年,大模型写代码的能力几乎以肉眼可见的速度提升。从简单脚本到完整功能模块,GPT、Claude、DeepSeek 等模型已经能够在几秒钟内生成看起来相当 “专业” 的代码。
"我最初装上Codex时说,绝不会让它完全控制我的电脑。这句话大概坚持了两小时。"OpenAI CEO Sam Altman在Cisco AI Summit上坦承,自己现在用两台笔记本电脑工作——一台
来自上海交通大学、清华大学、微软研究院、麻省理工学院(MIT)、上海 AI Lab、小红书、阿里巴巴、港科大(广州)等机构的研究团队,系统梳理了近年来大语言模型在数据准备流程中的角色变化,试图回答一个业界关心的问题:LLM 能否成为下一代数据管道的「智能语义中枢」,彻底重构数据准备的范式?
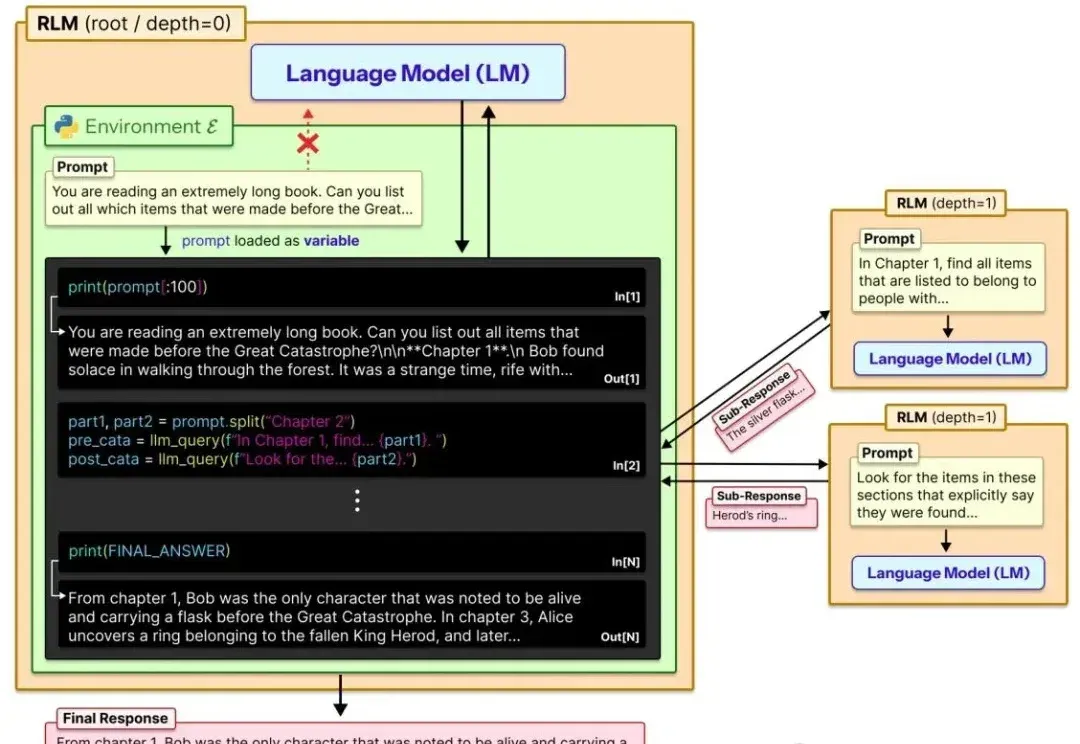
让大模型轻松处理比自身上下文窗口长两个数量级的超长文本!
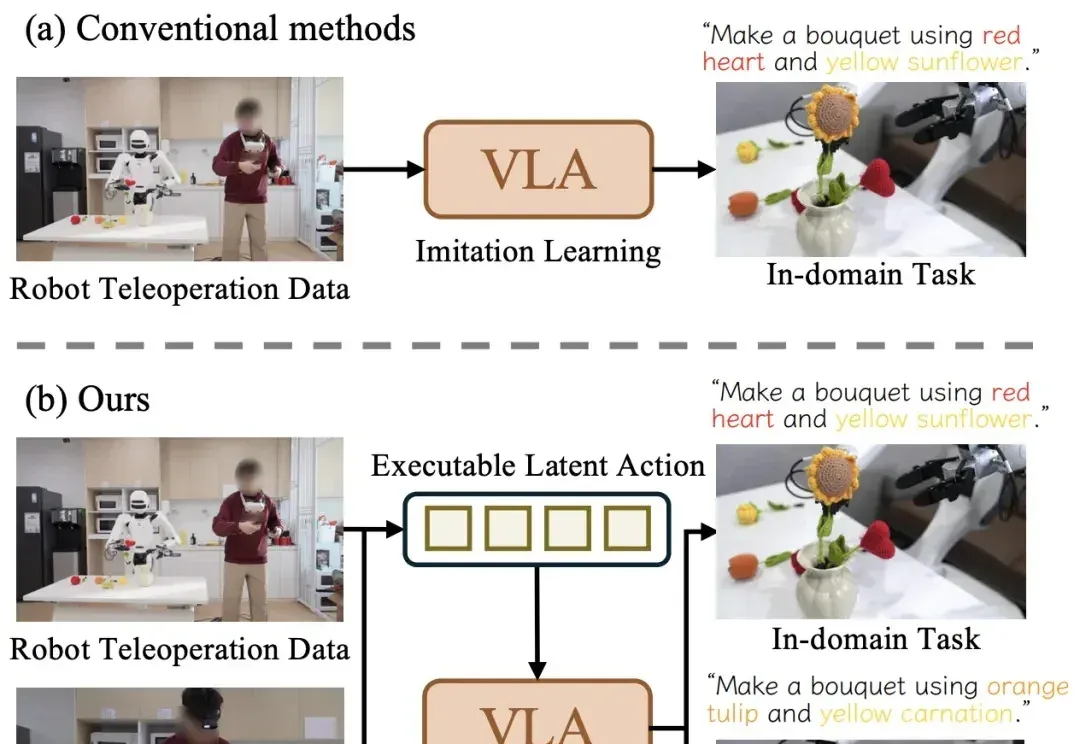
近日,清华大学与星尘智能、港大、MIT 联合提出基于对比学习的隐空间动作预训练(Contrastive Latent Action Pretraining, CLAP)框架。这个框架能够将视频中提纯的运动空间与机器人的动作空间进行对齐,也就是说,机器人能够直接从视频中学习技能!
你有没有发现,你让AI读一篇长文章,结果它读着读着就忘了前面的内容? 你让它处理一份超长的文档,结果它给出来的答案,牛头不对马嘴? 这个现象,学术界有个专门的名词,叫做上下文腐化。 这也是目前AI的通病:大模型的记忆力太差了,文章越长,模型越傻!