阿里投资Kimi始末 (opens in a new tab)
之前「elsewhere」写过 Kimi 的C轮融资,那笔由 IDG 领投的交易,堪称VC在黎明前的惊鸿一注。但回顾 Kimi 的融资故事,真正将杨植麟送上大模型牌桌的,是更早、也更大的一笔来自阿里的钱。
Total 162 articles
之前「elsewhere」写过 Kimi 的C轮融资,那笔由 IDG 领投的交易,堪称VC在黎明前的惊鸿一注。但回顾 Kimi 的融资故事,真正将杨植麟送上大模型牌桌的,是更早、也更大的一笔来自阿里的钱。
Anthropic正式宣布:Claude Chat和云端Claude Cowork,从今天起共用同一套记忆。Claude记忆从此无处不在,而且,你能决定它记住什么。Claude Code之父Boris Cherny转发了这条公告,称它是一个小改进:记忆现在更简单也更强了。
这次,AI开始给自己写软件。 让AI定时干活不算新鲜事了。开源的OpenClaw带火的个人Agent,可以简单理解成一位常驻电脑或服务器的AI助手。 它接入聊天软件,记住用户交代过的事情,并按计划在后台工作;接着,又有团队开始让这类助手自己总结经验。 比如Nous Research推出的Hermes Agent,直接将自我改进写进产品核心。 它会在复杂任务结束后生成Skill,也会在使用过程中修改已有Skill,还能借助持久记忆找回过去解决问题的方法。 个人Agent已经开始积累经验,而Rome进入的,正是一个已经十分拥挤的市场。 Rome更值得注意的地方在于Agent学到一套方法后,还会将方
“你以为你买的是 DeepSeek Flash,实际上可能是个 1.5 bit 的 DeepSeek,或者里面掺了 Opus 用于训练。”这是 Pi 核心贡献者 Armin Ronacher 的一个比喻。他形容现在的 token 市场像一种成分不明的商品——量化程度、实际版本、是否掺了别的东西、计费方式,全是黑洞。
2024 年,Boris Cherny 加入 Anthropic 时,AI 编程产品大多还停留在代码补全和对话问答阶段。模型已经能够写出完整的函数和文件,但产品通常只允许它在编辑器里提出建议,很少真正赋予它读取代码库、修改文件和调用终端的能力。
这期节目的嘉宾黄东旭,就是Token Maxing热潮的亲历者。他曾经只用最前沿的模型,每天账单三四百美元。让他转变的,是前沿模型的智力碾压和中国开源模型们的崛起——Fable 5可以一句话终结Agent群的讨论,同时大量的日常任务可以做到“只烧电费,不烧Token”。他的结论是:不是前沿模型用不起,而是本地开源模型底座+前沿模型的搭配,成本可控,更具性价比。
AI4S(AI for Science)正在为生命科学行业,掀起一场工业革命!
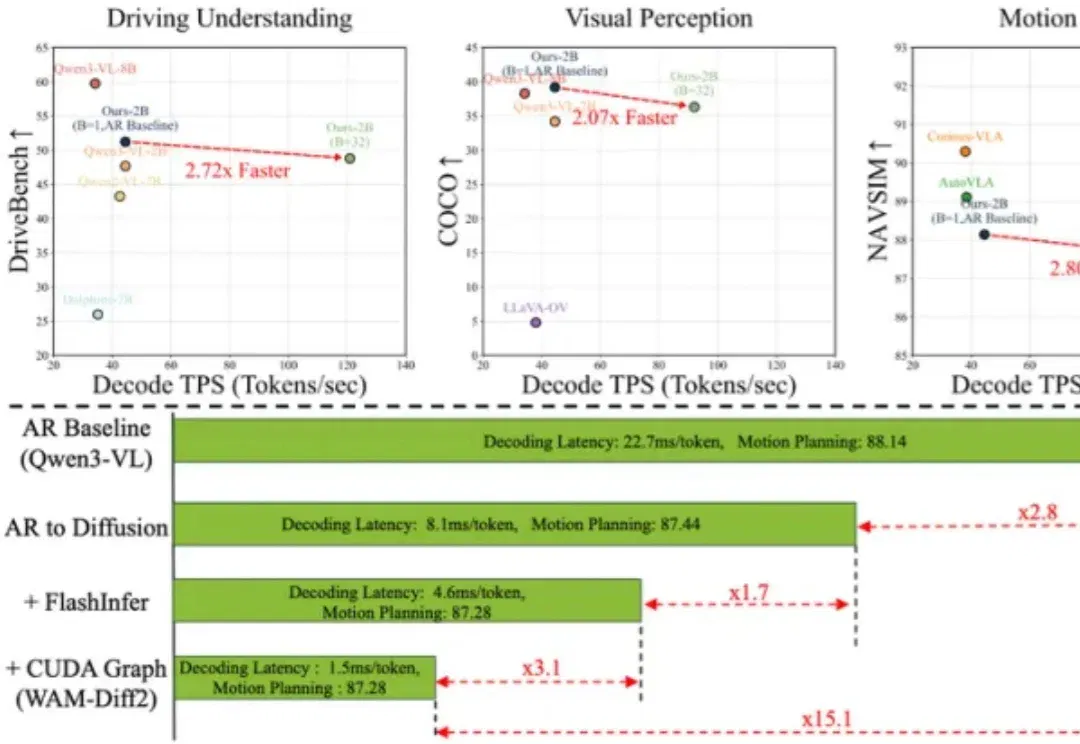
视觉 - 语言 - 动作(VLA)模型已成为端到端自动驾驶的主流技术路线,但基于自回归(AR)解码的现有架构面临双重结构性瓶颈:其一,逐 Token 串行生成导致推理延迟随序列长度线性增长,严重制约实时部署;其二,训练阶段依赖真实前缀的 teacher forcing 机制,使模型在推理时暴露于自身生成的误差之上,引发长时序累积的曝光偏差(exposure bias)。
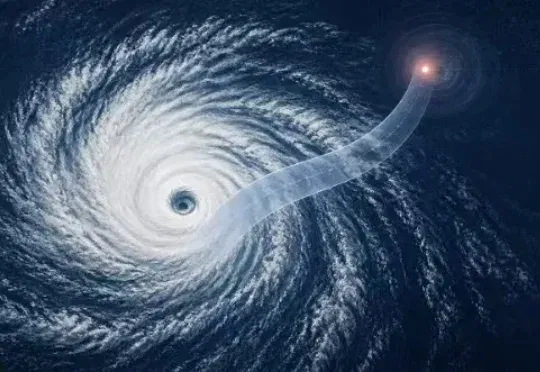
8 月 6 日,谷歌 DeepMind、Google Research 与美国国家飓风中心等机构的研究人员在 Nature 发表论文,公布面向热带气旋业务预报的 AI 模型 WeatherNext Cyclones。论文显示,该模型可针对全球热带气旋生成最长 15 天的天气和气旋情景,并预测路径、强度及风圈半径。
本文主要介绍来自该团队的最新论文 Teaching Vision-Language-Action Models What to See and Where to Look,目前该论文已经被 ECCV 2026 正式接收,相关代码和模型已全部开源。