Search

Results for “多模态”

Total 438 articles

让大模型多模态检索全面超越SOTA!ReCALL框架化解生成式与判别式的范式冲突|CVPR'26

让大模型多模态检索全面超越SOTA!ReCALL框架化解生成式与判别式的范式冲突|CVPR'26 (opens in a new tab)

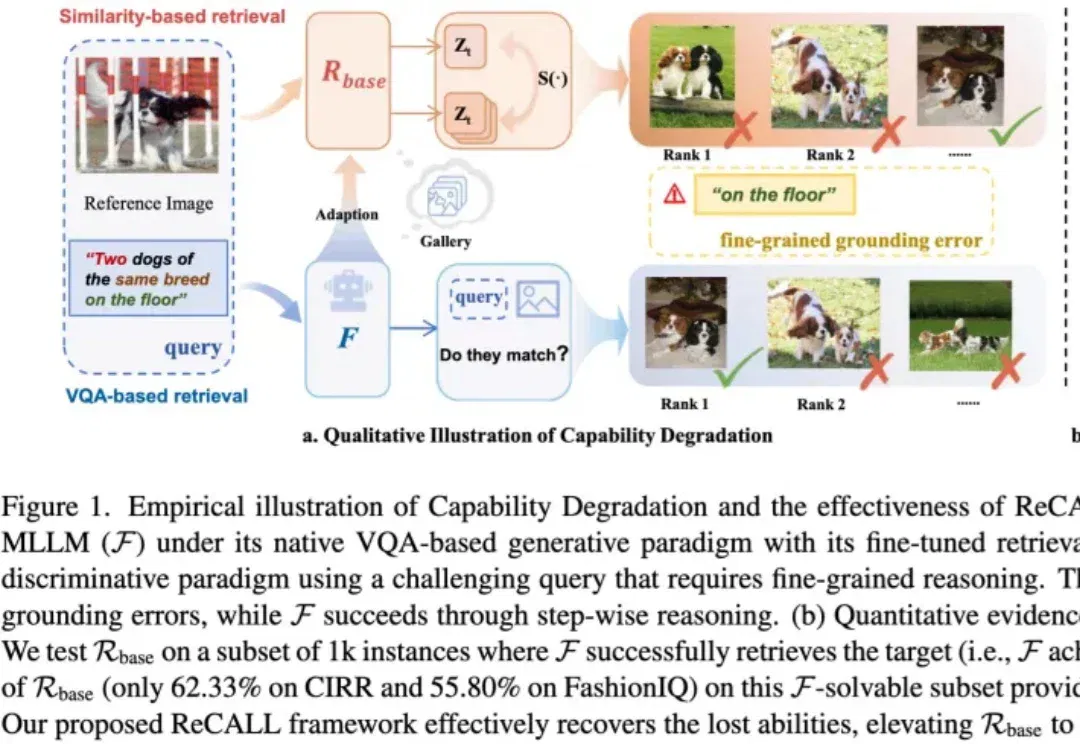
生成式模型当检索器大材小用效果还不好? 当多模态大模型(MLLM)凭借强大的图文理解与逻辑推理能力成为AI领域的核心抓手,将其应用于图像检索尤其是组合图像检索(CIR)任务,本应是降维打击的最优解。 然而现实却相悖:把生成式大模型强行改造为判别式检索器后,模型会出现严重的能力退化,连原本100%能精准解决的问题都频频出错,生成式与判别式的范式冲突,成为大模型向检索领域落地的核心壁垒。 如今,这一行业难题被AI国家队紫东太初团队联合新加坡国立大学成功攻克。其最新研究成果ReCALL框架,凭借独创的“诊断-生成-校准”闭环体系,从根本上解决了大模型从生成式到判别式的范式冲突问题,让大模型在保留原生
AI guides
0
ICLR 2026 | 让多模态模型学会主动说话:主动交互从训练到评估的完整方案

ICLR 2026 | 让多模态模型学会主动说话:主动交互从训练到评估的完整方案 (opens in a new tab)

本文综合北京大学王选计算机研究所发布的 ProactiveVideoQA 和 MMDuet2 两篇论文,介绍视频多模态大模型如何实现 “主动交互”—— 在视频播放过程中自主决定何时发起回复,而非等待用户提问。ProactiveVideoQA 提出评估指标和 benchmark,MMDuet2 则通过强化学习训练方法实现了 SOTA 性能,无需精确的回复时间标注即可训练出及时、准确的主动交互模型。

AI guides
0
腾讯纯文本LLM训视觉encoder,拿捏图表长视频,达到开源小模型SOTA!

腾讯纯文本LLM训视觉encoder,拿捏图表长视频,达到开源小模型SOTA! (opens in a new tab)

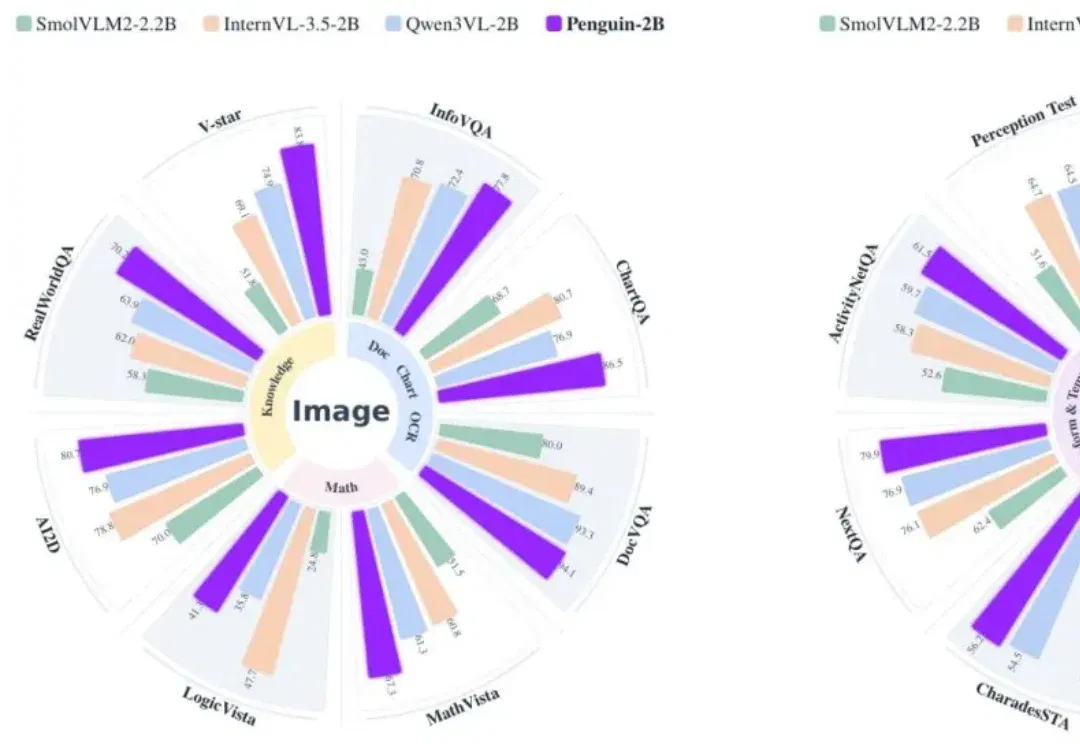
打破多模态视觉+语言拼接套路! 腾讯开源Penguin-VL,直接用纯文本LLM训视觉编码器。 这项研究跳出了先有传统视觉 backbone,再接语言模型的常规路径,直接从text-only LLM初始化vision encoder。 并在2B/8B紧凑参数规模下的文档理解、长视频时序定位等复杂任务中表现出极强竞争力。 从LLM出发的视觉编码器重构 如果把这两年的多模态模型拆开看,一个很有意思的现象是: 大家在语言模型上卷得很凶,但到了vision encoder这一层,路线却出奇一致。 很多VLM最后都会回到那套熟悉配方,先拿CLIP、SigLIP这类通过对比学习训出来的视觉模型做encod

AI guides
0
复旦等推出「第一人称视听基准」,补齐多模态模型「听觉拼图」

复旦等推出「第一人称视听基准」,补齐多模态模型「听觉拼图」 (opens in a new tab)

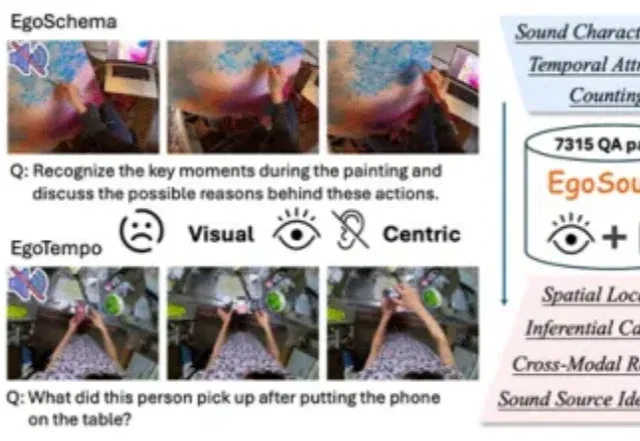
多模态大模型掉进真实世界,会“失聪”。 你把它放在厨房:背后有人说话、金属碰撞、蒸汽嘶嘶——画面里啥也没有,但声音已经把关键信息全透露了。此时最强模型也开始“失灵”:看得懂动作,听不懂发生了什么;能描述现象,推不出原因。 问题不是模型不会“看”,而是还不会真正“听”。 声音,从来不是配角 而在人类的日常认知里,声音从来不是配角: 它提供空间线索(声源左/右、远/近、是否移动)它揭示画面外事件(镜头外的对话、敲门、摔落、报警)它承载因果与意图(某个动作触发了某个声音;某个声音提示下一步行为) 但长期以来,第一人称视频理解基准高度“视觉中心化”:音频存在,但缺乏系统评测;听觉重要,却很少被认真考察

AI guides
0