全解读|智谱 GLM-5V-Turbo 发布,多模态 Coding 基模
今天,智谱发布 GLM-5V-Turbo,定位「面向视觉编程的多模态 Coding 基座模型」。一句话概括:在 GLM-5-Turbo 的编程和龙虾能力基座上,加入了原生的视觉理解和推理能力
MODEL
今天,智谱发布 GLM-5V-Turbo,定位「面向视觉编程的多模态 Coding 基座模型」
一句话概括:在 GLM-5-Turbo 的编程和龙虾能力基座上,加入了原生的视觉理解和推理能力
模型能看懂设计稿、截图、网页界面,据此生成完整可运行的代码
GLM-5V-Turbo Playground:左边是手绘草图,右边是生成的完整前端页面
从 GLM-5 到 GLM-5V-Turbo
先理一下产品线关系
2 月 11 日,智谱发布GLM-5,744B 参数的开源旗舰,主打编程和 Agentic Engineering。3 月 16 日,GLM-5-Turbo跟进,专门针对龙虾(OpenClaw/AutoClaw)场景做了优化,强化工具调用、指令遵循、长链路执行
今天的 GLM-5V-Turbo 是这条线的第三步:在 GLM-5-Turbo 的全部能力基础上,从预训练阶段就融入了视觉能力
具体多了什么:
→原生理解图片、视频、设计稿、文档版面等多模态输入
→支持画框、截图、读网页等多模态工具调用
→上下文窗口200K
→与 Claude Code、OpenClaw/AutoClaw 深度适配
关键词是「原生」。这里的视觉能力是从预训练阶段就开始训的,后训练阶段再做多模态协同优化,和在文本模型上面接一个视觉编码器的做法不一样
Benchmark
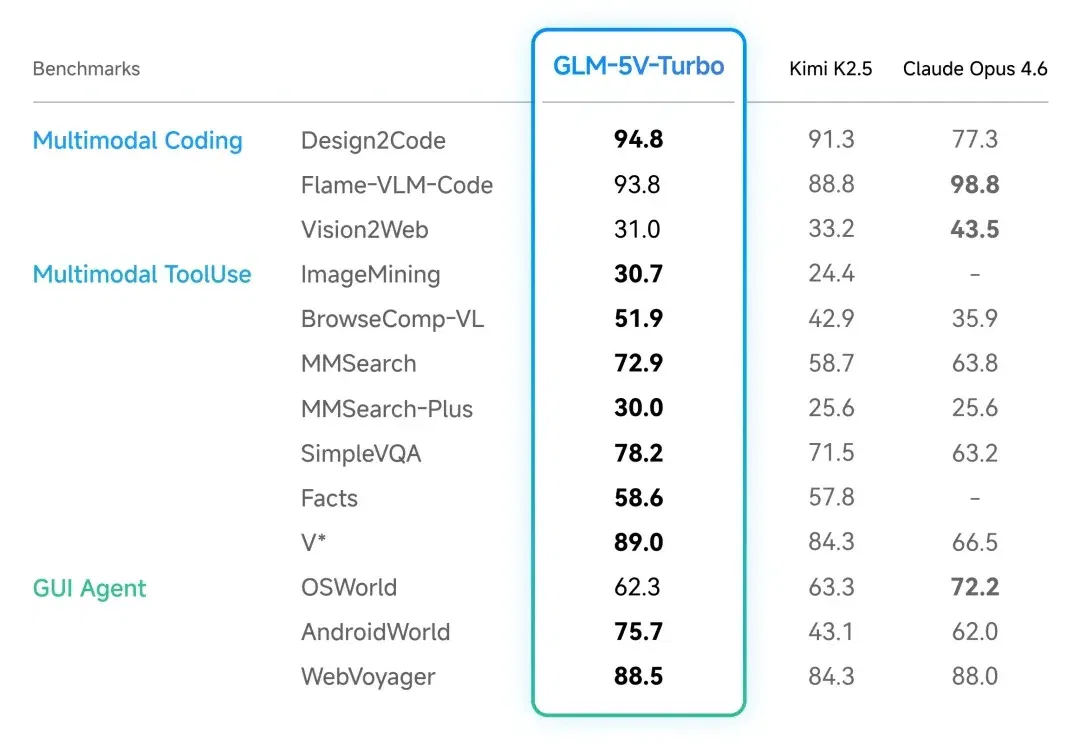
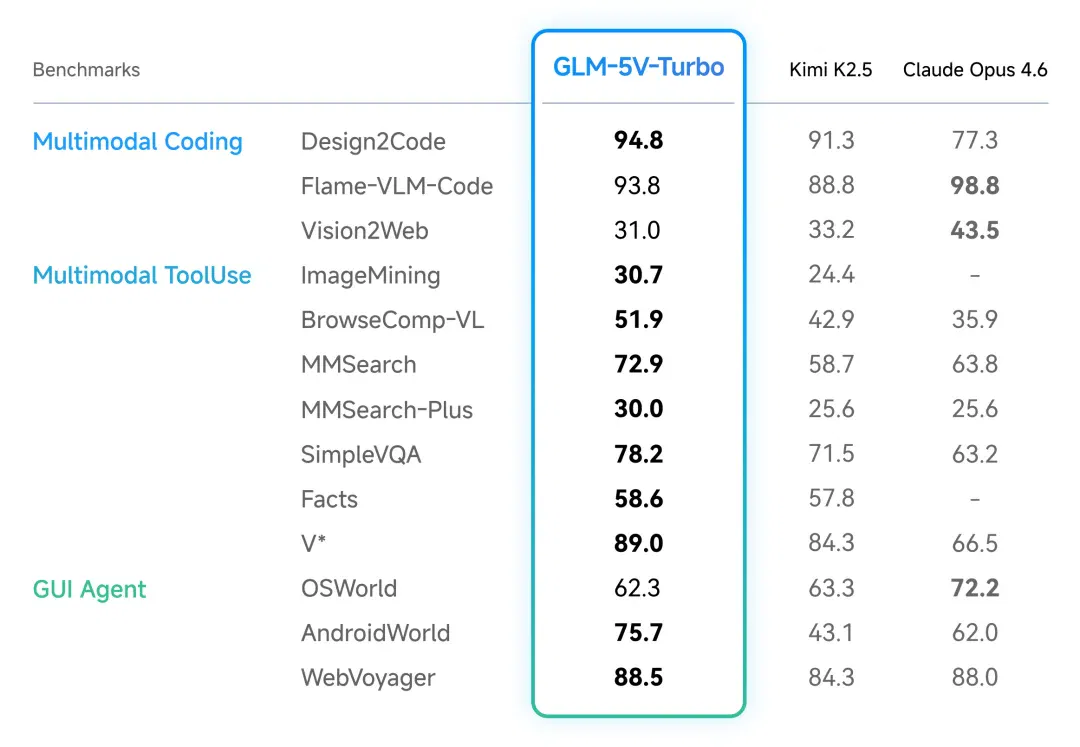
先看多模态相关的指标。对比对象是 Kimi K2.5 和 Claude Opus 4.6
多模态 Benchmark:Multimodal Coding / Tool Use / GUI Agent
在 Design2Code、ImageMining、BrowseComp-VL、MMSearch、AndroidWorld 这几项上,GLM-5V-Turbo 均为三者最高。Opus 4.6 在 Flame-VLM-Code(98.8)和 Vision2Web(43.5)上领先
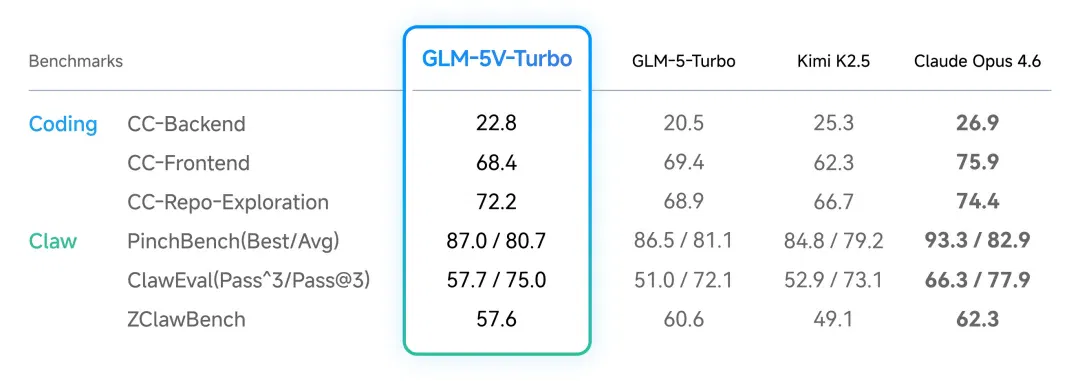
再看纯文本 Coding 和龙虾任务的指标。这张表多了一列 GLM-5-Turbo(纯文本版),可以看视觉能力引入后纯文本能力有没有退化
纯文本 Coding 和 Claw Benchmark
CC-Backend:GLM-5V-Turbo 22.8 vs GLM-5-Turbo 20.5,视觉版反而略高
CC-Frontend:68.4 vs 69.4,基本持平
CC-Repo-Exploration:72.2 vs 68.9,视觉版略高
官方的结论是:视觉能力引入后,纯文本编程与推理能力保持了同等水准。从数据看,个别项还有小幅提升。Opus 4.6 在纯文本 Coding 三项上均领先(CC-Backend 26.9,CC-Frontend 75.9,CC-Repo-Exploration 74.4),在 PinchBench 和 ClawEval 上也占优,这个差距客观存在
内测合作伙伴反馈
内测阶段,字节 TRAE 模型测评团队、美团和快手万擎模型测评团队分别给出了评价:
GLM-5V-Turbo 实现了从设计稿到代码的完整还原,作为一款视觉理解模型,能够很好地满足开发者的前端开发场景
TRAE 模型测评团队
原生多模态能力的引入并未削弱其编程逻辑,其编程能力仍属于国内第一梯队
美团
它为 Agent 安上了「眼睛」,同时在编程领域展现出优于同类多模态模型的能力,在视觉编程场景中更具竞争力
快手万擎模型测评团队
四项技术升级
GLM-5V-Turbo 的能力来自模型架构、训练方法、数据构造、工具链四个层面的系统性改动
原生多模态融合
GLM-5V-Turbo 从预训练阶段开始做文本与视觉的深度融合。智谱研发了新一代CogViT视觉编码器,官方称在通用物体识别、细粒度理解、几何与空间感知上均达最优。同时设计了兼容多模态输入的MTP(Multi-Token Prediction)结构,在多模态场景下保持较高的推理效率
30+ 任务协同强化学习
强化学习阶段同时优化30 多个任务类型,覆盖 STEM、grounding、video、GUI Agent 等子领域。官方称这种多任务协同的方式有效缓解了单领域训练的不稳定性,模型在感知、推理、Agentic 执行上均有提升
Agentic 数据与任务构造
Agent 数据一直是行业痛点:数据稀缺,验证困难。智谱的做法是构建从元素感知到序列级动作预测的多层级体系,用合成环境大规模生成可控、可验证的训练数据
一个有意思的细节:他们从预训练阶段就注入 Agentic 元能力,比如把 GUI Agent PRM 数据加入预训练来降低幻觉
多模态工具链扩展
在文本工具之外,GLM-5V-Turbo 新增支持多模态搜索、画框、截图、读网页等多模态 tools。这让 Agent 的感知链路从纯文本扩展到视觉交互,可以「看懂环境 → 规划动作 → 执行任务」形成完整闭环
典型场景
下面用实际案例展开,信息量比较大
图像即代码
GLM-5V-Turbo 最核心的能力场景。你可以发送草图、设计稿、参考网站的截图或录屏,模型直接理解布局、配色、组件层级与交互逻辑,生成完整可运行的前端工程

前端复刻:发截图或录屏,模型还原版式、配色、动效等视觉细节,生成可运行代码
GUI 自主探索复刻:结合 Claude Code,模型自主探索目标网站,浏览页面结构、梳理跳转关系、采集素材,然后直接生成代码复现整个站点
交互式编辑:支持按需求增删页面模块、修改文案样式、调整布局、补充交互功能
文档解读与写作
给模型一份 PDF 文档,它读完之后可以按照你的要求撰写特定格式的文章
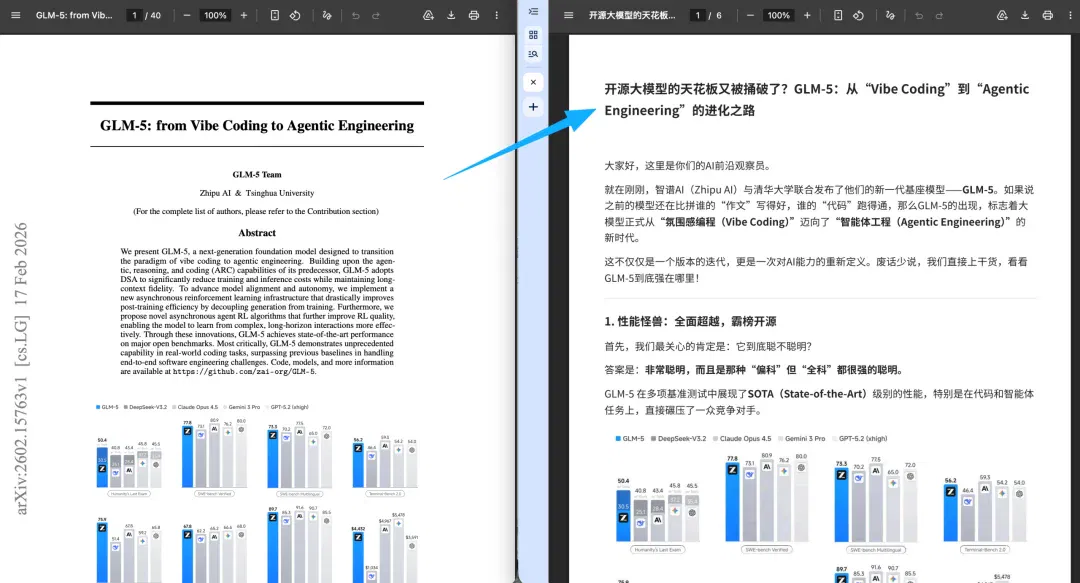
NVIDIA 10-Q 财报 → 中文财务简报
比如把 NVIDIA 2026 财年第一季度 10-Q 表格扔给 AutoClaw,提示词是「阅读文档,汇总关键数据,撰写一份简报,保存到 result.md」,模型输出了包含营收、利润、毛利率、EPS 等关键数据和业务板块分析的中文财务简报
另一个案例是给一篇 40 页的 GLM-5 论文 PDF,让模型按微信公众号风格撰写宣传文案。模型自动从原文中定位和截取关键图表,嵌入到合适的位置,输出图文并茂的文章
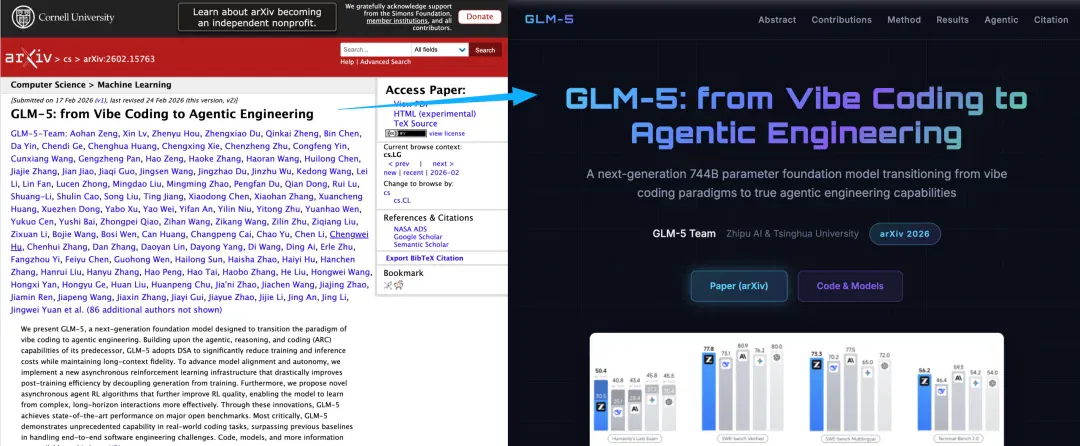
论文 PDF → 公众号风格图文文案
PDF-to-WEB / PDF-to-PPT
这两个能力做成了官方 Skill。PDF-to-WEB 是把论文或报告转成精美的单页学术网站。用 BERT 论文和 GLM-5 论文做的实测,渲染结果的完成度很高,接近手工做的学术项目主页
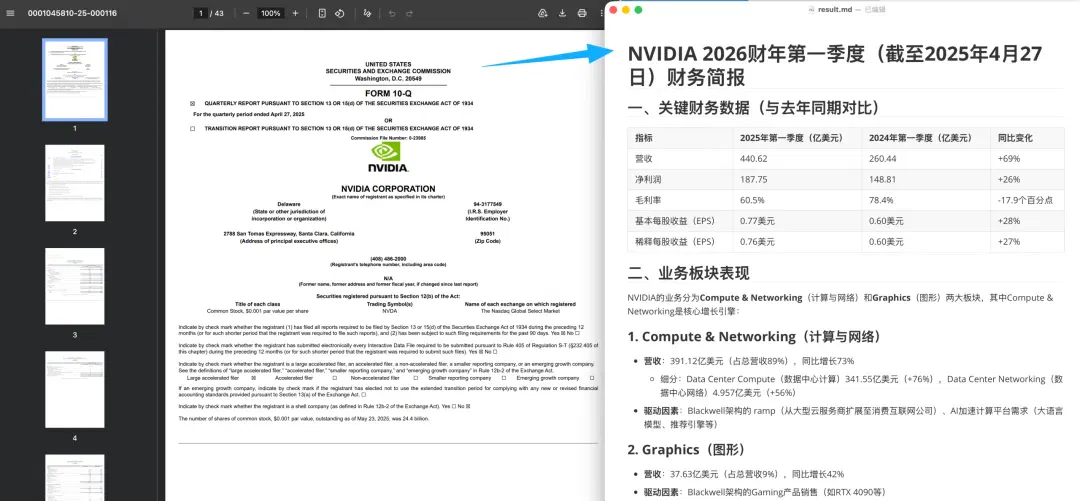
PDF-to-WEB 渲染结果
PDF-to-PPT 则是把文档转成多页 HTML 演示文稿。比如用阿里巴巴的近期动态做了一个 14 页的分析 PPT,模型自主搜索了季度财报、业务板块数据和竞争格局,配了图表
多模态 Deep Research
这里展示两个深度调研的案例
第一个是「搜集小米汽车相关图片,输出图文交错的专题报告」。模型通过约 50 轮网络搜索,从各个渠道获取了包括新一代 SU7、YU7/YU7 GT、YU9 等车型的图片和产线、工厂照片,输出了一份结构化分析报告
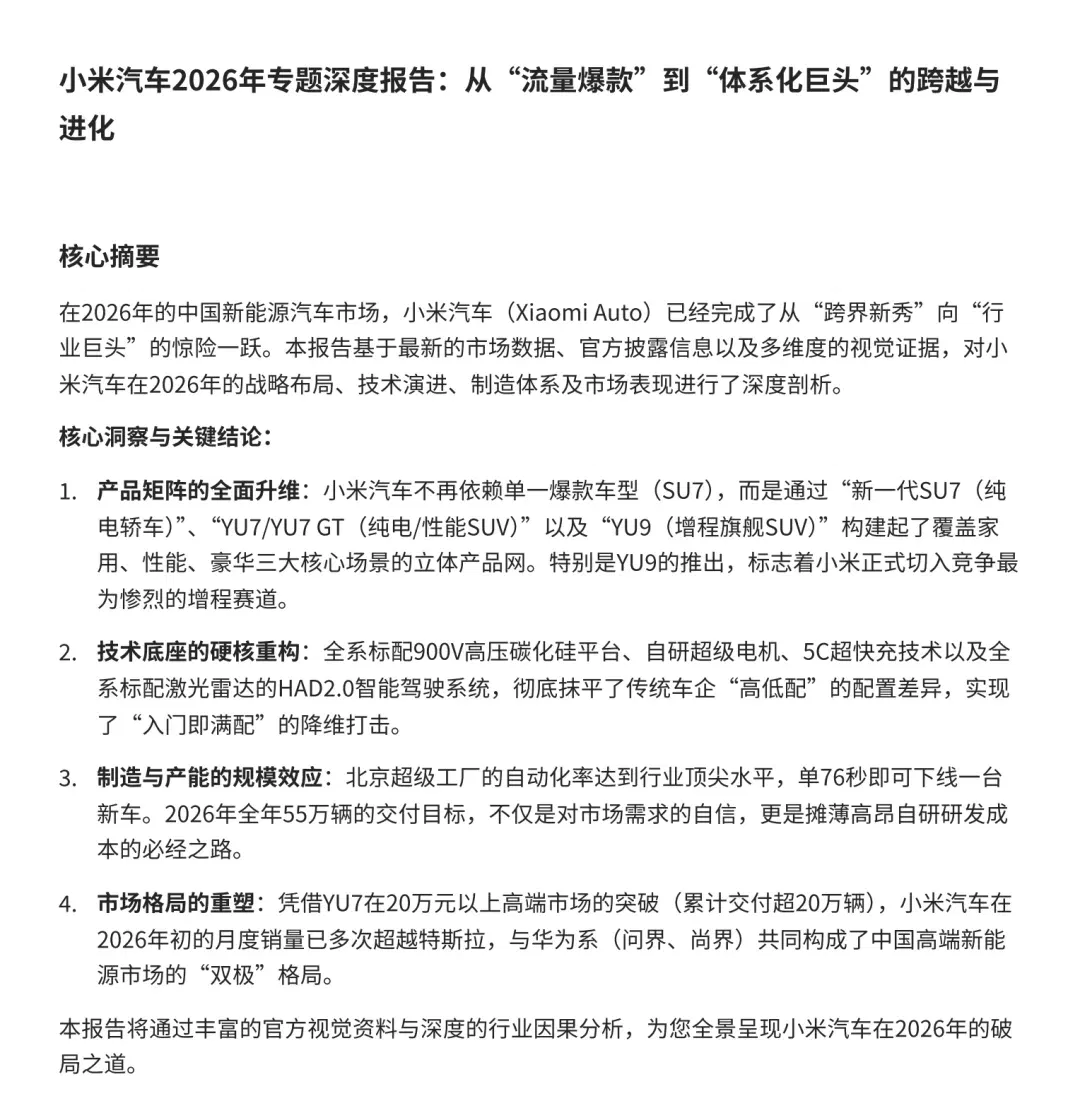
小米汽车 Deep Research 报告
第二个是「结合阿里巴巴的近期动态和季度财报,仿照麦肯锡风格,生成专业 PPT」。模型同样自主完成了信息搜集、数据整理和可视化呈现
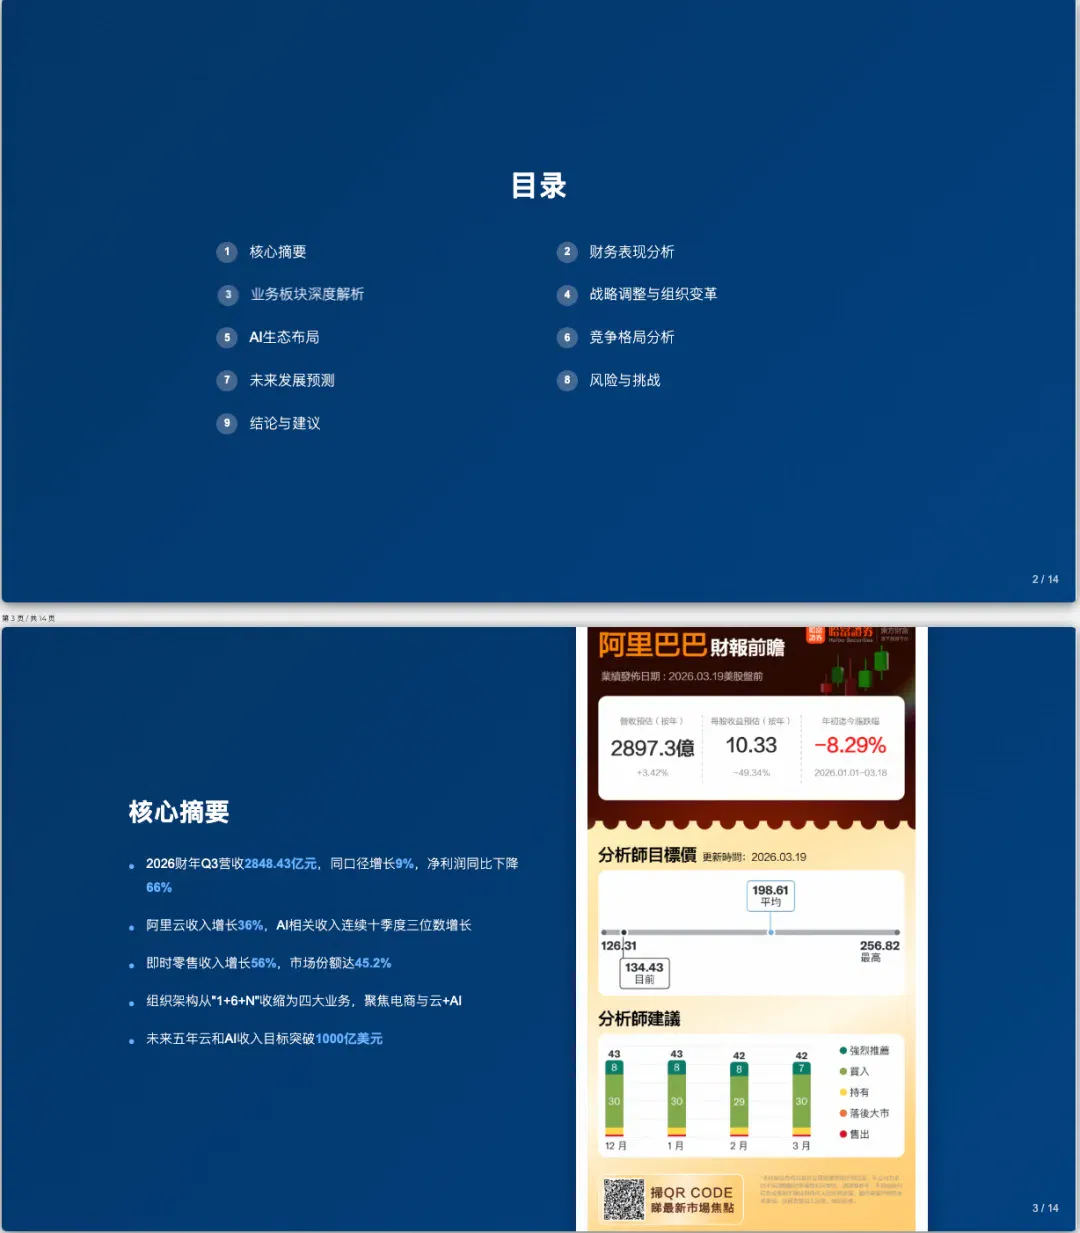
阿里巴巴麦肯锡风格 PPT
视觉 Grounding
模型能在图片中精准定位目标物体。几个有意思的例子:
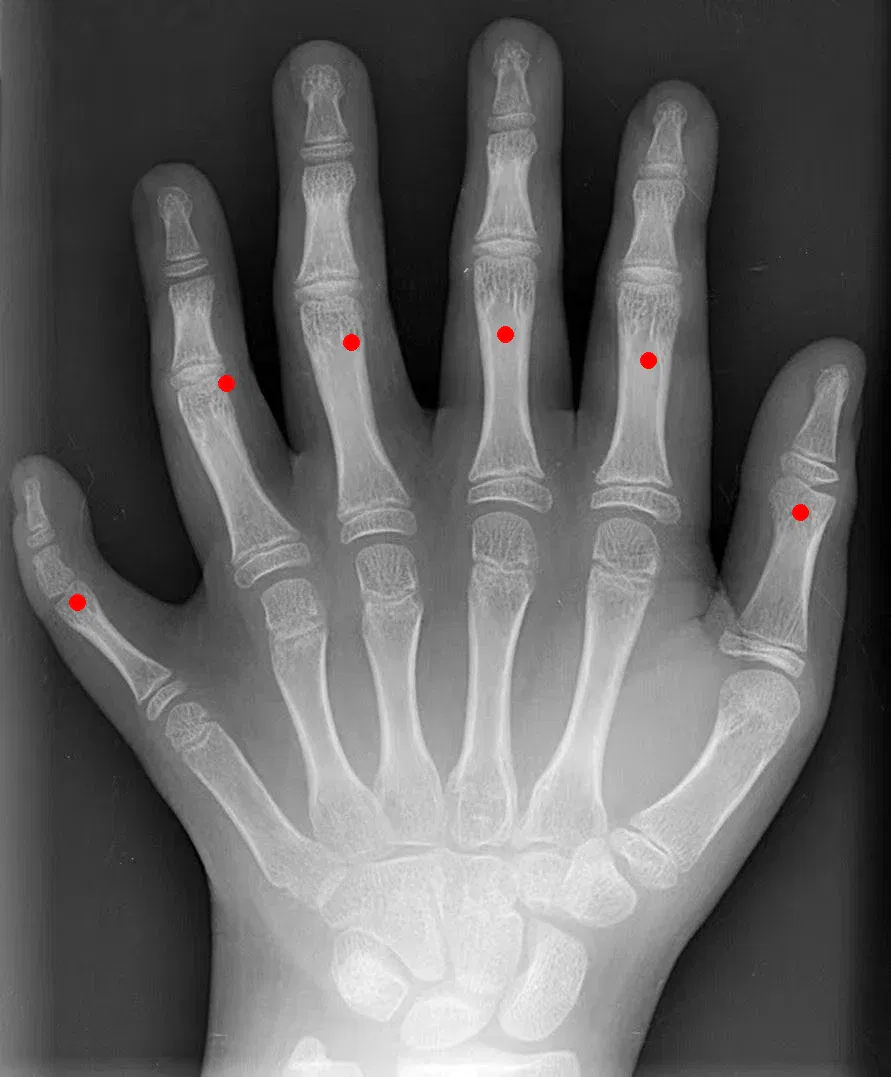
数手指:给一张手部 X 光片,让模型用坐标标出所有手指的位置。模型准确识别并标注了 6 个手指(包括左右两侧拇指和中间 4 个手指)
多模态搜索 + 识别:给了一张 1927 年第五届索尔维会议的合影照片,提示词是「框出图中全部人物以及他们的名字」。模型成功识别并框出了全部 29 位人物,从第三排的奥古斯特·皮卡尔德到第一排的爱因斯坦
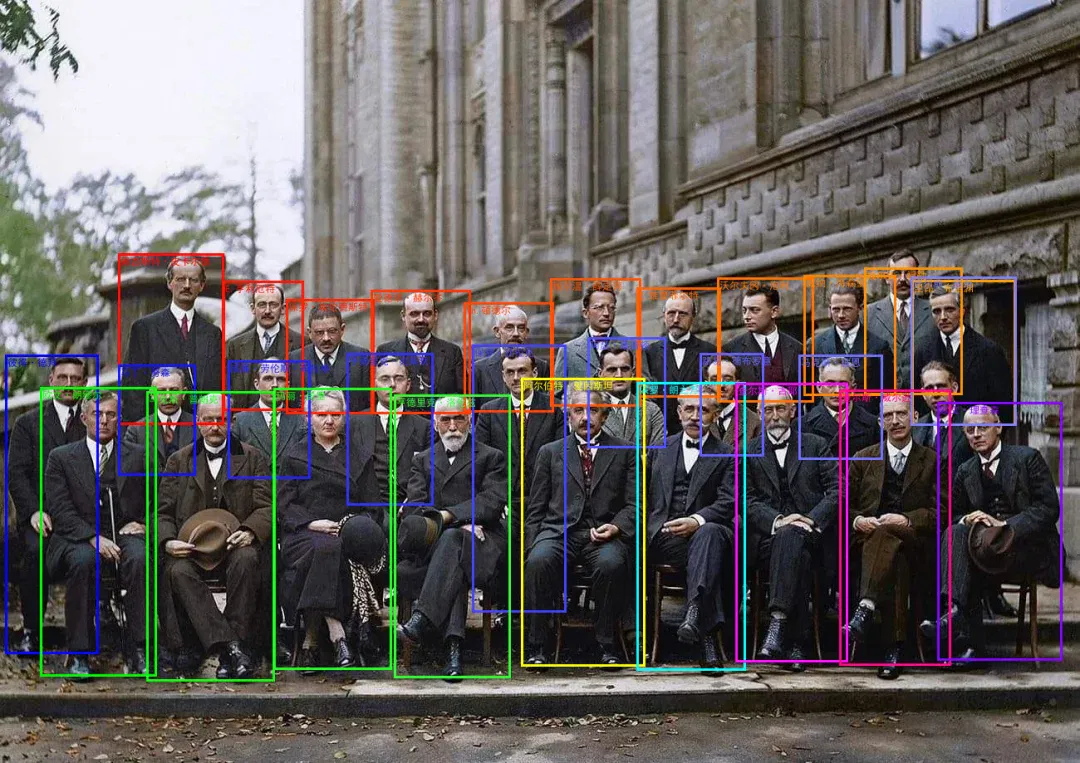
索尔维会议 29 人全部识别并框出
空间推理
模型在空间理解上的能力可以和具身机器人结合。一个实测案例是一张厨房场景照片,提示词是「我想切火腿肠,请问我的手应该操作哪个位置?请在图中点出对应的位置」。模型标注出了菜刀刀柄的位置,并给出了操作指导
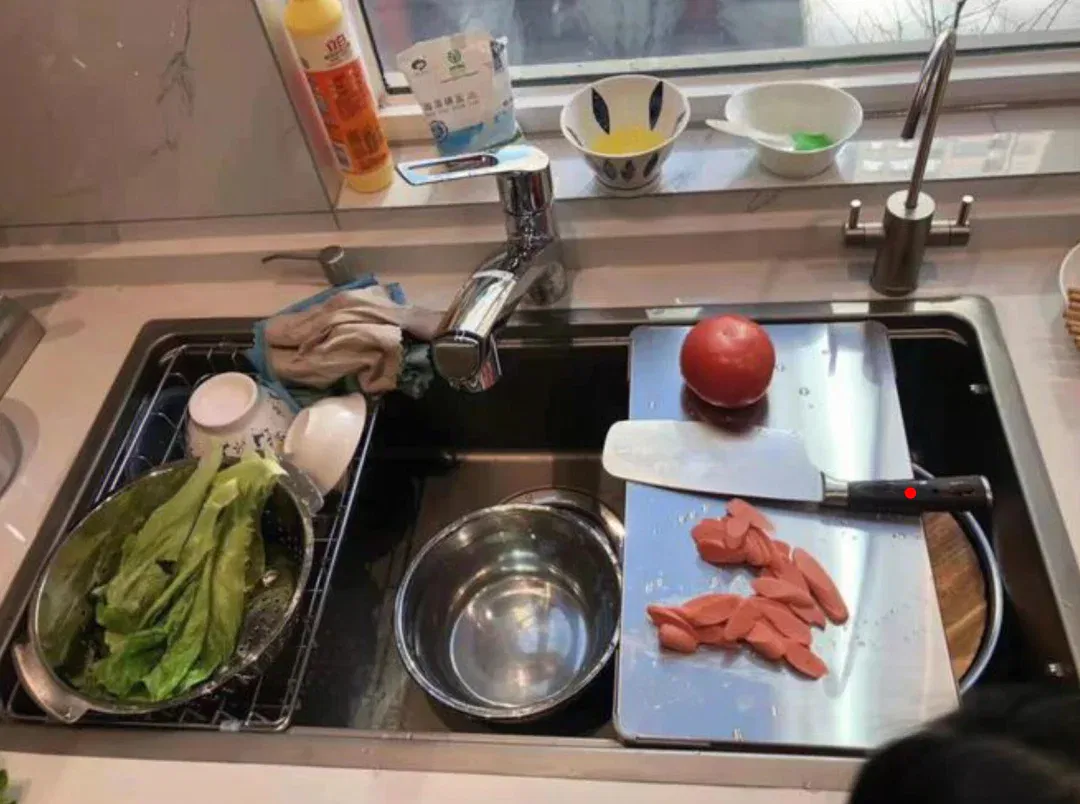
空间推理 - 标注菜刀刀柄位置
为龙虾装上眼睛
接入 GLM-5V-Turbo 之后,龙虾(AutoClaw/OpenClaw)的任务边界大幅拓宽。以前只能处理纯文本任务,现在可以浏览网页和文档、生成图文并茂的报告和 PPT、查询并解读 K 线图
官方已上线「股票分析师」Skill,利用视觉能力让龙虾直接看懂 K 线走势、估值区间图和券商研报图表,四路数据源 60 秒并行采集,输出图文交错的研报
14 个官方 Skills
智谱为 GLM-5V-Turbo 准备了 14 个官方 Skills,分三类
基于主模型原生能力(4 个)
→PDF-to-WEB:论文/报告转单页学术网站
→PDF-to-PPT:文档转多页 HTML 演示文稿
→Web-Replication:给 URL,模型自主探索并复刻整个网站
→PRD-to-App:产品需求文档 + 原型图转全栈 Web 应用
作为外部工具调用(5 个)
→图像 Captioning:自动分析图像内容,生成自然语言描述
→视觉 Grounding:根据文字描述在图像中精准定位目标
→基于文档的写作:读文档、提关键信息、生成特定格式文本
→简历筛选:读简历,和职位要求智能比对
→提示词生成:根据参考图/视频,自动构建文生图/视频的 Prompt
基于专用模型 GLM-OCR / GLM-Image(5 个)
→通用文字识别:印刷体、手写体、多语言文本
→表格识别:还原行列结构和合并单元格
→手写体识别:适应连笔、潦草等复杂书写
→公式识别:复杂公式转 LaTeX
→文生图:自然语言生成图像
全部 Skills 已上线 ClawHub:一键安装
GitHub:zai-org/GLM-skills
接入方式
产品体验
→AutoClaw(澳龙):autoglm.zhipuai.cn/autoclaw
→Z.ai:chat.z.ai
z.ai
API 接入
→BigModel 开放平台:docs.bigmodel.cn
→Z.ai:docs.z.ai
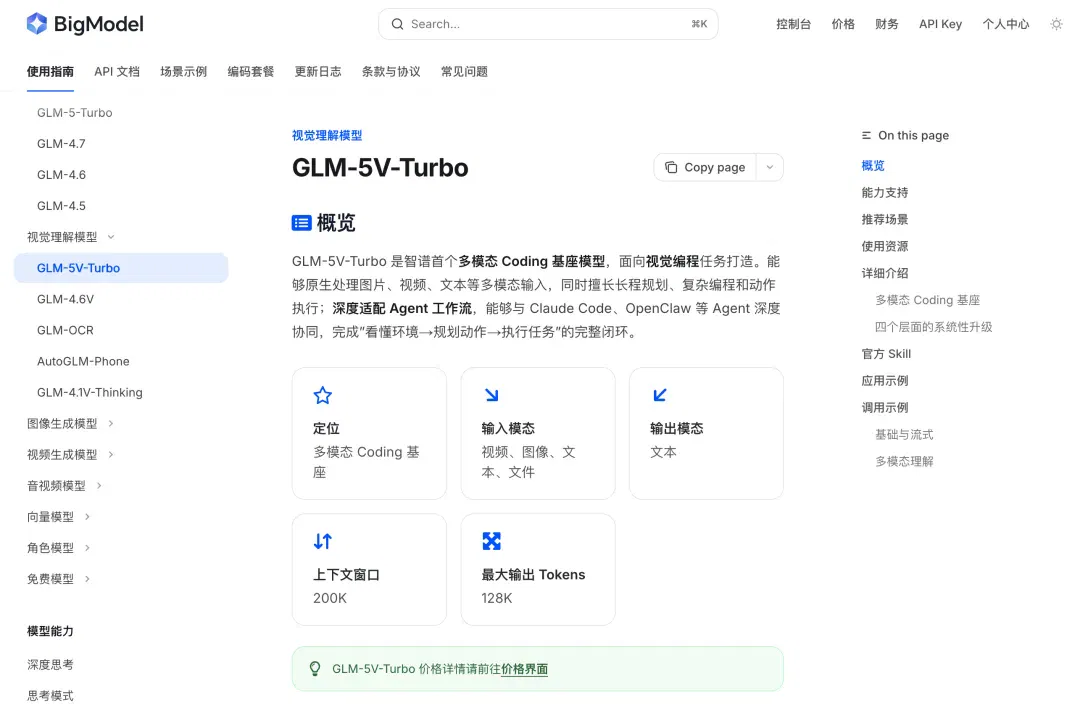
https://docs.bigmodel.cn/cn/guide/models/vlm/glm-5v-turbo
Claude Code
在~/.claude/settings.json中配置:
→ANTHROPIC_BASE_URL设为https://open.bigmodel.cn/api/anthropic
→模型 ID 填glm-5v-turbo
或在会话中直接/model glm-5v-turbo切换
AutoClaw / OpenClaw 接入
设置里添加自定义模型:
→服务商选「智谱」
→模型 ID 填glm-5v-turbo
→Base URL 填https://open.bigmodel.cn/api/paas/v4
→填入 API Key 即可
Coding Plan:现面向 Coding Plan 用户开放申请,后续 GLM Coding Plan 也会纳入 GLM-5V-Turbo
申请问卷:zhipu-ai.feishu.cn/share/base/form/shrcn...
GLM-5,2 月 11 日
GLM-5-Turbo,3 月 16 日
GLM-5V-Turbo,4 月 2 日
大约每两到三周一个版本。这次补上的是视觉能力,龙虾和 Claude Code 的感知链路从纯文本扩展到了视觉交互
文章来自于"赛博禅心",作者 "金色传说大聪明"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
GLM-5.5最新曝光!「降智」问题3张重置卡已到位 (opens in a new tab)
GLM-5.5,真的马上就来了?! 这不嘛,网上有GLM Coding Plan用户收到官方补偿通知,原因是此前部分用户遭遇了模型「降智」问题。 但比补偿本身更有看头的,是智谱在公告里留下的一句话—— 新模型发布后,还会额外赠送一次额度重置机会哈! 好啊好啊,一份补偿通知,竟然顺手把下一代模型给剧透了。(doge) 而且巧了,最近关于GLM-5.5的爆料,也开始一波接一波冒出来了。 有小道消息称,GLM-5.5的参数规模可能达到2.5万亿—3.5万亿,比此前传闻的1.6万亿还要大上一截! 还有友友猜测,智谱此前初步验证的循环Transformer架构,会不会也用在下一代GLM上??? 这...
智谱新模型,懂法方面全球第一了 (opens in a new tab)
智谱推出法律专用开源模型GLM-Legal,可处理合同审查、证据分析和跨境合规,并在Vals AI法律测评中以19.2%的任务全通过率和86.23%的准确率位居Harvey LAB与LegalBench双榜开放权重模型榜首。
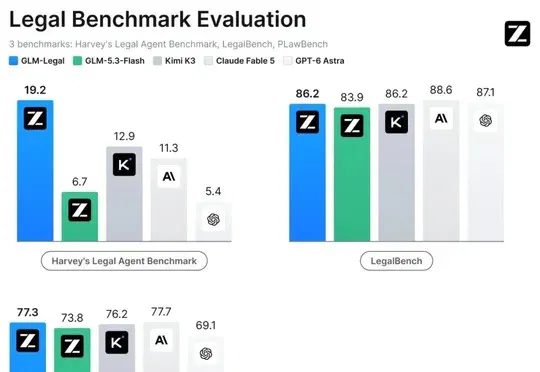
智谱发布 GLM-Legal:专攻法律的大模型,合同审查、证据梳理都能干 (opens in a new tab)
智谱旗下Z.ai发布基于GLM-5.3-Flash的法律专用模型GLM-Legal,面向合同审查、证据分析和合规研究,官方评测显示其在Harvey LAB明显领先、其余两项接近一线,目前需申请API权限且未开源。
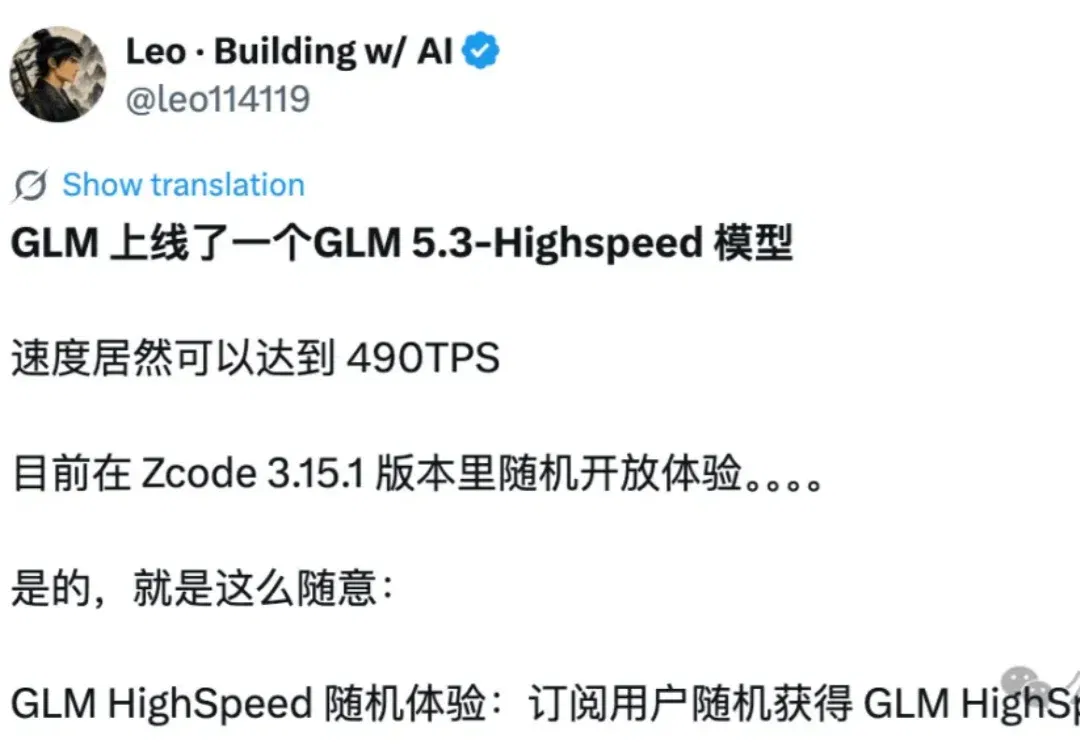
智谱新模型GLM-5.3-Highspeed,490 tokens/s! (opens in a new tab)
智谱上新了一个GLM-5.3-Highspeed模型,就在Zcode里。
开源之后再补偿,智谱 ZCode 能否重建信任? (opens in a new tab)
智谱针对ZCode数据上传争议事件公布补偿方案并将产品以Apache 2.0协议整体开源,但因开源仓库未保留事故前Git history、第三方核查覆盖范围披露有限,外界对其能否真正重建信任仍存疑问。