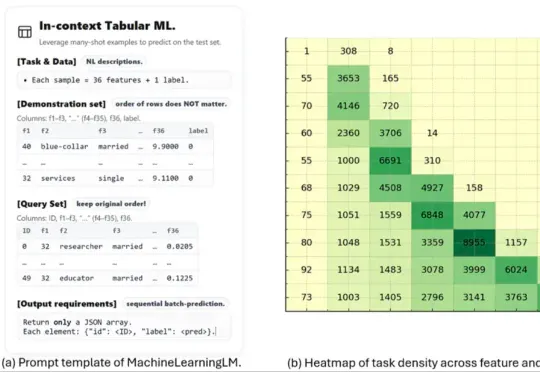
从少样本到千样本!MachineLearningLM给大模型上下文学习装上「机器学习引擎」 (opens in a new tab)
这项名为 MachineLearningLM 的新研究突破了这一瓶颈。该研究提出了一种轻量且可移植的「继续预训练」框架,无需下游微调即可直接通过上下文学习上千条示例,在金融、健康、生物信息、物理等等多个领域的二分类 / 多分类任务中的准确率显著超越基准模型(Qwen-2.5-7B-Instruct)以及最新发布的 GPT-5-mini。
Total 176 articles
这项名为 MachineLearningLM 的新研究突破了这一瓶颈。该研究提出了一种轻量且可移植的「继续预训练」框架,无需下游微调即可直接通过上下文学习上千条示例,在金融、健康、生物信息、物理等等多个领域的二分类 / 多分类任务中的准确率显著超越基准模型(Qwen-2.5-7B-Instruct)以及最新发布的 GPT-5-mini。
Thinking Machines Lab成立7个月,估值120亿美元,首次公开研究成果:LLM每次回答不一样的真凶——kernel缺乏批处理不变性。Lilian Weng更是爆猛料:首代旗舰叫 Connection Machine,还有更多在路上。
Inkling 2 Small 为 594B 参数的混合专家模型,每次推理激活 17B。技术博客说明后期训练使用 Kimi K3 和自有模型的部分轨迹,开放权重仍在计划中。
Clawdbot火爆全球,国产算力却不能用?AI Agent迎来高光时刻:Ollama只支持CUDA,中国团队直接把国产版开源了!正面硬刚Ollama,5分钟让国产芯片跑通OpenClaw!
我们只是觉得,Anthropic 发布的 Cowork 和我们想做、在做的接近, 但 $100/月 (Max订阅用户)且 仅限 macOS 这件事,一点都不酷。所以,我们和 MiniMax '一拍即合',搞了这个开源了 OpenCowork。让你现在、立刻、低至 9.9 拥有一个能真正“干活”的数字同事,体验 cowork
致力于成为金融界“DeepSeek”。金融垂域大模型公司Grace Investment Machine(简称GIM)宣布一连完成过亿元天使轮和天使+轮融资。成立于2025年7月,GIM正在做一件事:为金融行业打造一个垂直领域的DeepSeek——专为投资决策而生的推理大模型。
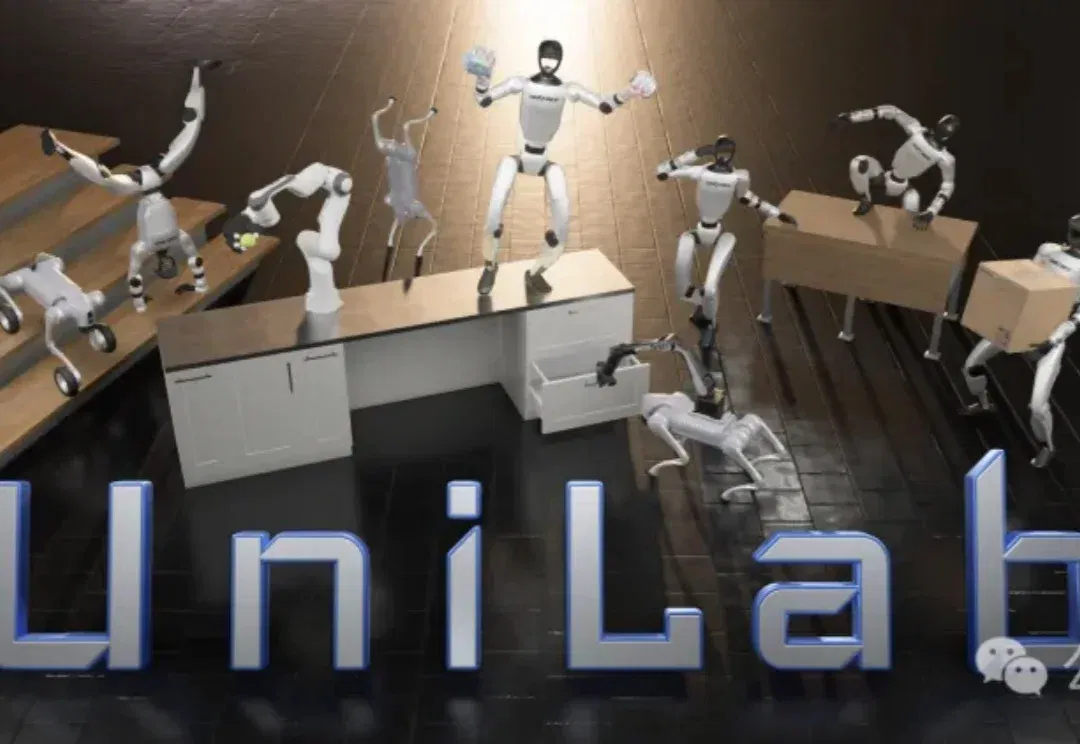
在具身智能训练中,“把计算全部塞进GPU”似乎成了唯一的提速密码,机器人运控并行训练的框架,IsaacLab、MuJoCoPlayground、mjlab都默认遵循这一范式,这些系统都牢牢绑定在NVIDIA生态中。
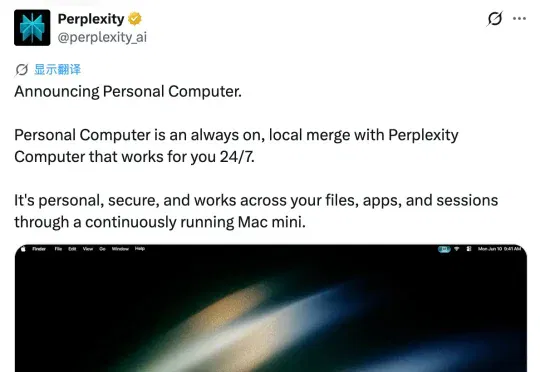
3 月 12 日凌晨,Perplexity 在旧金山 North Beach 一座改建自教堂的场地里,开了首届 Ask 2026 开发者大会,发布了 Personal Computer(个人电脑)。Personal Computer 是在此基础上往前迈了一大步。它运行在你自备的 Mac mini 上,24 小时不间断地访问本地文件、应用和会话记录,把云端的推理能力和本地数据的访问权限真正打通。
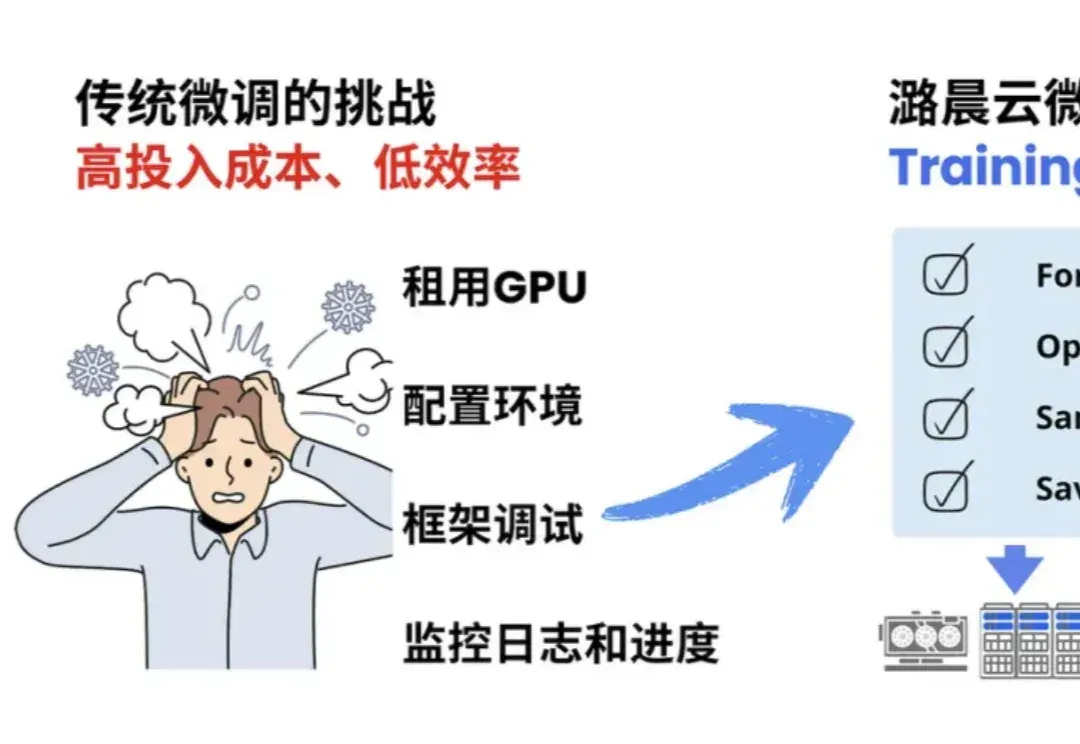
当 OpenAI 前 CTO Mira Murati 创立的 Thinking Machines Lab (TML) 用 Tinker 创新性的将大模型训练抽象成 forward backward,optimizer step 等⼀系列基本原语,分离了算法设计等部分与分布式训练基础设施关联,
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。