Meta最强模型跑分超越Opus 5.5?实测大翻车,作弊刷榜实锤了 (opens in a new tab)
就在今天深夜,Meta自豪宣布:自家的王炸大模型——Muse Wonder和Muse Wonder Full发布!
Total 1519 articles
就在今天深夜,Meta自豪宣布:自家的王炸大模型——Muse Wonder和Muse Wonder Full发布!
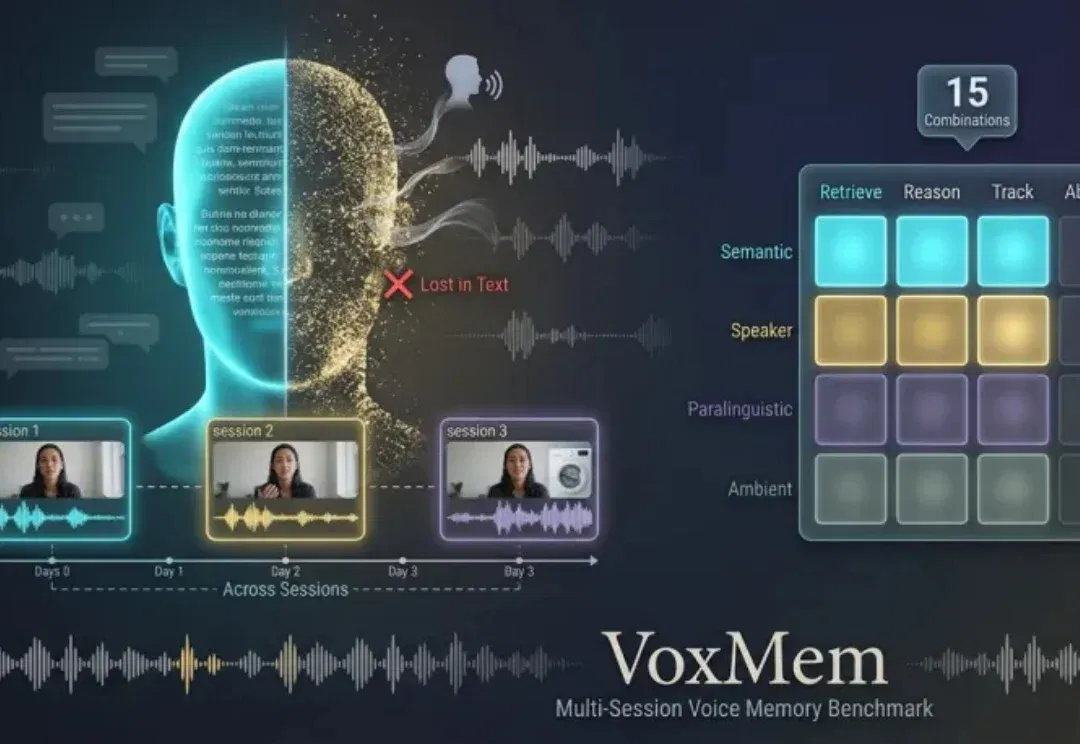
在语音助手、多用户共享的家庭助理等长期对话场景中,模型需要跨越多次会话记住用户的信息,但现有评测常遭遇两大难题:
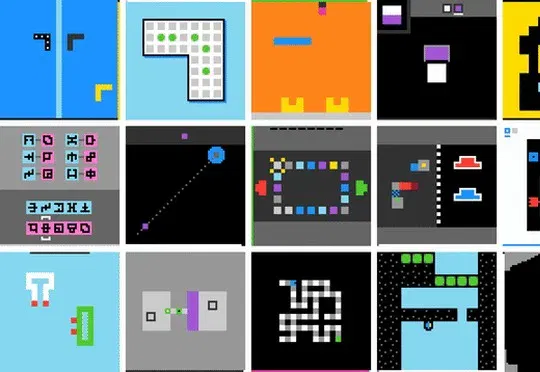
何恺明团队提出VISTA方法,将ARC-AGI-3的数字表换回图像并配备可随时翻看的视觉记忆相册,使Claude Opus 5拿下满分100分、GPT-5.6 Sol获得99分,证明卡住大模型的是眼睛和记性而非模型能力本身。
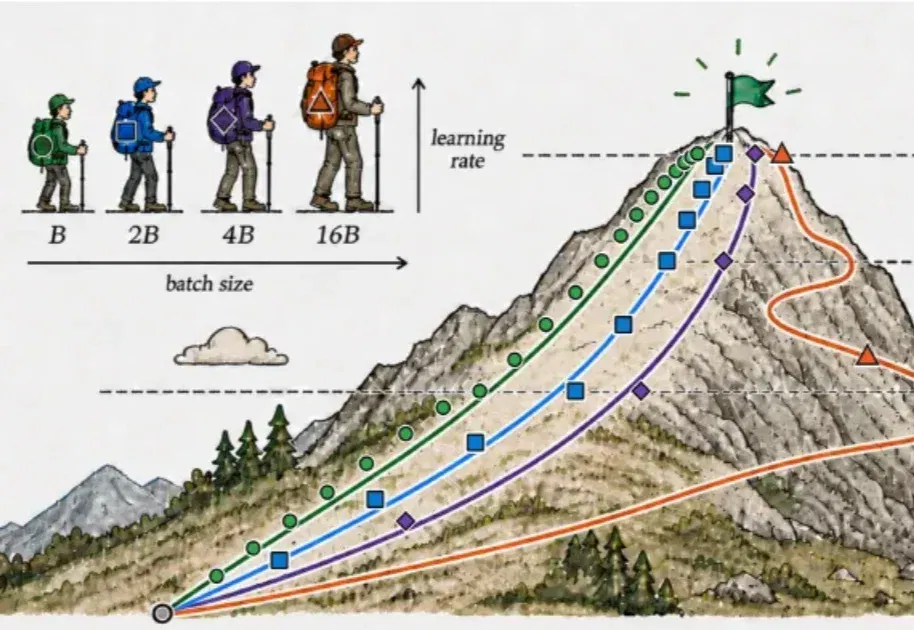
当预训练将大模型带到新的能力起点,强化学习则通过持续的探索与反馈,不断激发模型在新环境、新任务中的推理与行动能力,决定它们还能走多远。
BAI资本成员企业Humanlaya(原壤智能)宣布完成由鼎晖香港基金领投的数亿元Pre-A轮融资,公司聚焦大模型后训练数据与评测,通过专家网络、高质量数据生产与Benchmark体系帮助模型提升在金融、法律、医疗等复杂专业任务中的能力。
Z Potentials获悉,Physical AI公司息壤开物近日连续完成数亿元种子轮及天使轮融资,目前估值达5亿美元。本轮融资由敦鸿资产领投,华控基金、三花控股、银杏谷资本、泽然资本、本坚基金、天使基石、标朴投资等机构跟投。募集资金将主要用于原生物理AI模型的规模预训练、真实物理交互数据建设、核心研发人才引入及场景验证。
Nature报道独立研究者训练的历史语言模型GPT-1900在仅掌握1900年前知识的条件下,虽在光电效应问题上冒出类似爱因斯坦光量子的表述,但因高度依赖人类整理的提示且训练过程未能完全隔绝现代AI影响,在多数物理任务上表现失败,揭示当前大模型仍缺乏提出全新解释框架的"溯因飞跃"能力,距离真正科学家仍有距离。
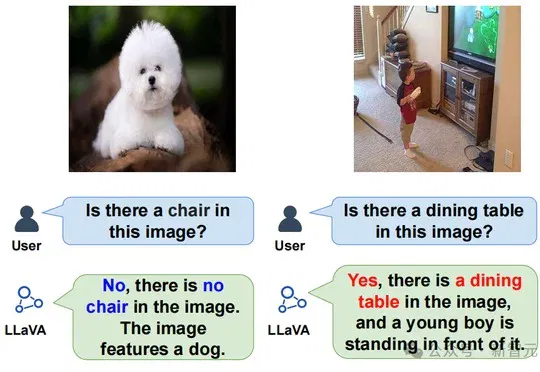
新智元报道 多模态大模型的物体幻觉,长期被归因于语言先验。 先看下面两组对话。 第一组,一张只有小狗的照片,问模型「图中有椅子吗」,它答「没有,图中是一只狗」,完全正确; 第二组,另一张照片,问「图中
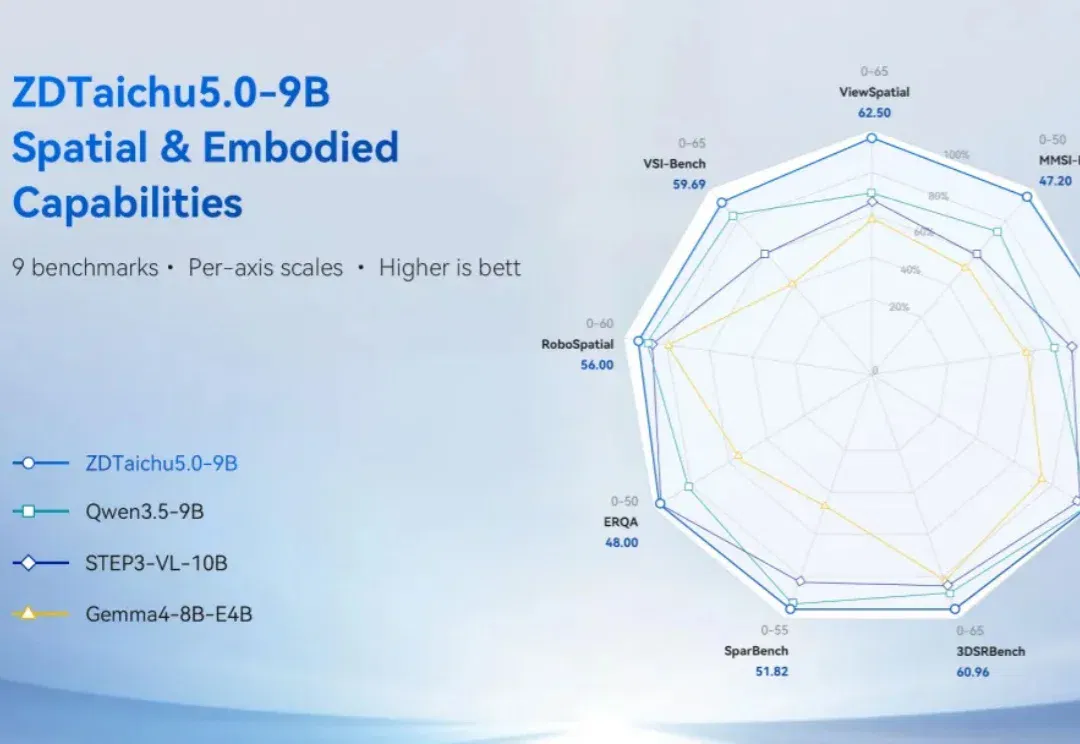
紫东太初开源的这个通用多模态大模型 ZDTaichu5.0-9B,简直夯爆了!
豆包爱学2.0依托豆包多模态大模型与Seedance系列模型,将AI嵌入语数英等学科的问答、板书讲解、定制课程、听写和错题整理等学习全流程,同一对话入口即可围绕知识点不断生成完整学习内容,展现字节在AI教育场景的工程化能力。