BAI 资本成员企业 Humanlaya 完成数亿元 Pre-A 轮融资,AI 后训练进入“专家数据”时代
BAI资本成员企业Humanlaya(原壤智能)宣布完成由鼎晖香港基金领投的数亿元Pre-A轮融资,公司聚焦大模型后训练数据与评测,通过专家网络、高质量数据生产与Benchmark体系帮助模型提升在金融、法律、医疗等复杂专业任务中的能力。
近期,BAI 资本成员企业Humanlaya(原壤智能)宣布完成由鼎晖香港基金领投的数亿元 Pre-A 轮融资,老股东 BAI 资本、红杉中国、今日资本等继续追投。Humanlaya 聚焦大模型后训练数据与评测,通过专家网络、高质量数据生产与 Benchmark 体系,帮助模型提升在复杂专业任务中的能力。这已经是 BAI 资本连续第三轮加注 Humanlaya。
AI 数据行业正在经历一轮结构性迁移。过去几年,基础模型竞争主要围绕预训练(pre-training)展开,参数规模、算力投入和通用语料持续扩张。随着模型开始进入真实工作流,竞争重心逐步转向后训练(post-training),RLHF、RLVR、复杂推理、Agent、GUI 等数据需求快速增加,数据需求也从大规模通用供给转向更专业、更复杂且可验证的任务。
美国市场已经率先验证了这一趋势。Scale AI 从传统数据标注逐步延伸至前沿模型的数据生产与评测,Surge AI 长期聚焦高质量后训练数据,Mercor、Micro1 则围绕工程、医疗、法律、金融和科研等专业领域建立专家供给网络,为模型训练提供更高复杂度的数据支持。截至今年 6 月,Mercor 的年化总收入已达到数十亿美元规模。
中国市场也正在进入相似阶段。随着基础模型能力提升,国内数据需求正从通用标注向专家数据、模型评测和复杂任务训练延伸。中国拥有规模庞大的工程、医疗、科研、金融和法律人才供给,而模型进入 Agent、Deep Research 和专业垂直场景后,对中文语境、本土制度和真实行业流程的理解也越来越重要,这为本土专家数据平台提供了新的市场空间。
Humanlaya 正处在这轮变化中。面向模型侧,公司围绕后训练构建高质量数据、Benchmark 和评测能力;在专家供给侧,则通过TalentsAI组织和管理专业人才,将分散在不同领域的知识与经验转化为可用于模型训练和评测的数据。
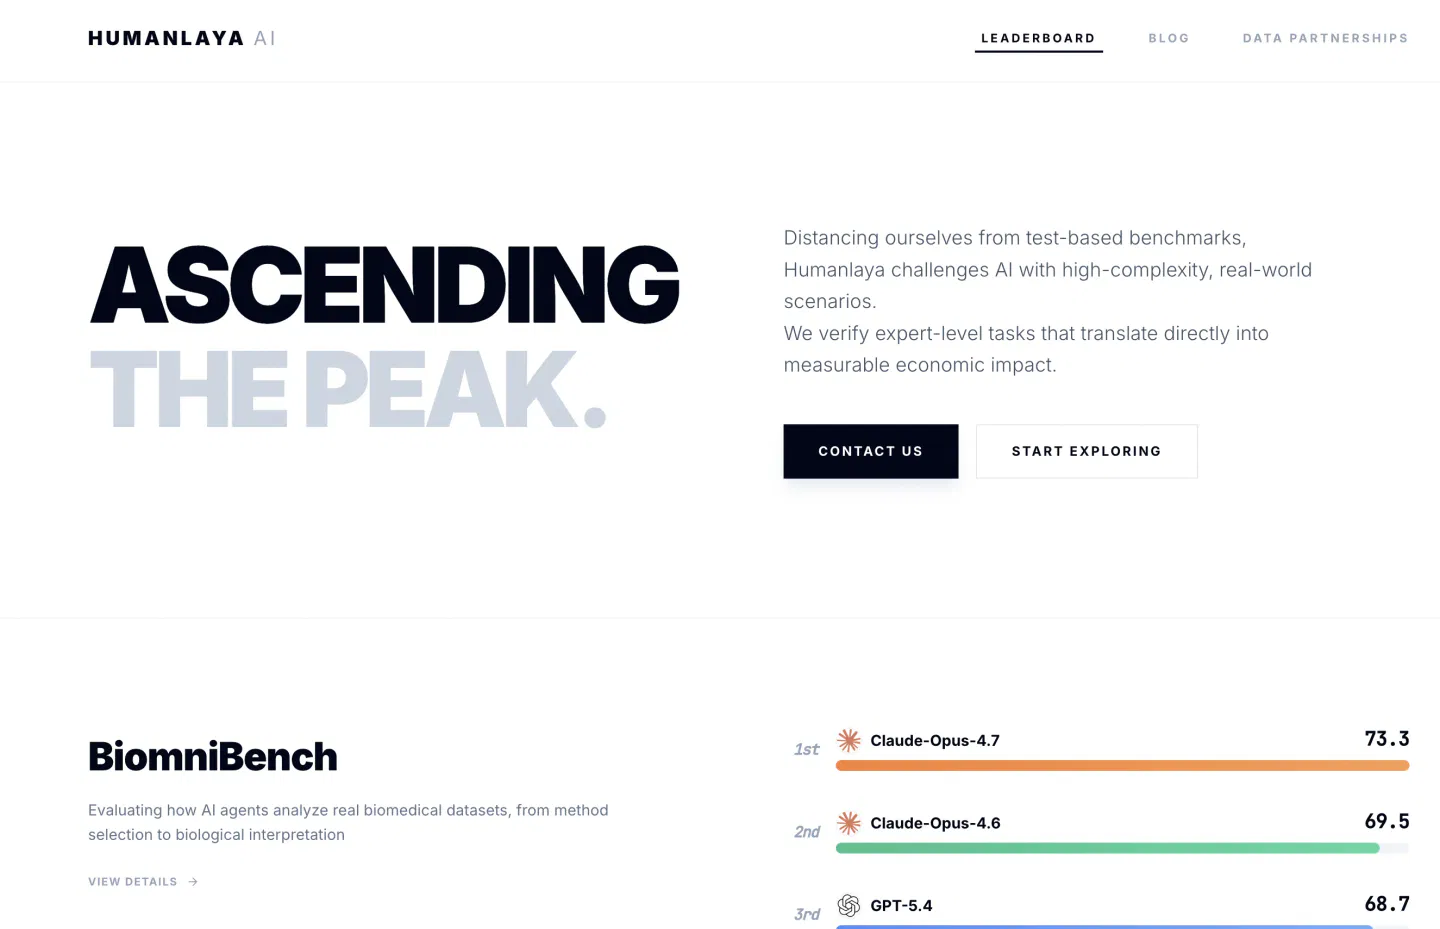
过去一年,Humanlaya 围绕真实专业工作陆续推出 $OneMillion-Bench、BiomniBench、ExcelBench 和 WorldTravel 等 Benchmark,覆盖专业知识工作、生物医学分析、表格操作和多模态任务。以 $OneMillion-Bench 为例,其包含 400 个中英文专家级任务,涉及金融、法律、医疗、自然科学和工业等领域,每项任务再由多个带权重的评分维度组成,用于评估事实完整性、分析推理、指令遵循和最终交付质量。相比传统知识型测试,这类 Benchmark 更强调模型在复杂约束和真实工作流程中的实际完成能力。
另一端,TalentsAI 正在持续扩大专家供给。目前,平台专家社区已经超过 10 万人,覆盖 300 多个细分学科,其中包括 5000 多名博士级人才。平台任务已经扩展至复杂指令、评价规则设计与评测、高难度推理、RLHF、VLM、长文本与专业文档,以及金融、法律、医疗、软件工程和自然科学等领域。TalentsAI 现已服务国内绝大多数主要模型公司。
对于专家数据平台而言,人数只是供给的起点。高质量后训练数据更依赖平台能否持续判断不同专家适合什么任务,并将专业能力从静态履历转化为长期、可追踪的真实履约记录。TalentsAI 已推出 T1 至 T4 专家成长体系,根据实际交付质量、专业贡献和稳定性动态更新专家等级,任务匹配、反作弊、复审、质量控制和激励机制则共同构成更底层的运营体系。
这些持续积累的履约记录,会反过来提高后续专家筛选和任务匹配的准确性。随着参与任务的专家和数据类型不断增加,平台积累的不只是一张人才名单,也包括不同专业能力在具体训练任务中的实际表现,这让专家网络本身逐渐形成可复用的数据资产。
两端能力结合之后,Humanlaya 可以把专家供给、数据生产与模型评测放进同一条反馈链。Benchmark 识别模型在哪些任务上存在能力缺口,由此产生新的数据需求;专家网络完成数据生产后,再通过评测验证训练效果。对于一家后训练数据公司而言,这种循环比单独拥有专家网络或单独开发 Benchmark 更具复用价值。
这也是 Humanlaya 相较单一环节玩家更值得关注的地方。数据行业里并不缺人才众包平台,也有专门设计 Benchmark 和评测体系的团队,但如果专家供给、任务定义和训练效果验证能够彼此反馈,Benchmark 就不再只是对外展示模型能力的测试集,还可以成为发现下一批数据需求的入口;专家网络则不仅承担交付,也持续反哺任务设计和质量标准。
在金融、法律、医疗、研究和办公等场景中,模型输出往往很难用单一标准答案判断。信息来源是否可靠、推理链条是否完整、关键步骤有没有遗漏,以及最终结果是否满足任务要求,都需要被拆解成更具体的评价标准。随着模型承担越来越长的任务链条,评价本身正在成为后训练的重要组成部分。
专家的作用因此也从内容生产进一步延伸到评价标准设计。Humanlaya 将依赖专业经验的判断拆解成可重复使用的任务规则和评测方法,再用于训练与模型能力验证。相比一次性交付的数据,经过反复验证的任务设计、评价体系和生产方法具有更高的复用价值,也使数据公司的竞争重心从单纯扩张人力,逐渐转向发现模型能力缺口、组织专业供给和验证训练效果。
大型模型公司通常都会保留自己的数据团队,但专家需求具有很强的跨学科和阶段性,一轮训练可能需要金融和法律专家,下一阶段又迅速转向编程、生物医学或复杂办公,长期在内部维持覆盖所有领域的专家队伍并不经济。第三方平台能够汇总不同客户和不同周期的需求,提高专家网络的利用率,同时让已经建立的数据产线、质检体系和评价方法在更多项目中复用。随着服务的模型和任务增加,平台还能持续积累不同模型的失败模式和数据需求,这些跨项目经验进一步反哺任务设计与数据生产,也构成了单一内部团队较难获得的横向认知。
第三方平台的独立性也变得更加重要。Meta 大额入股 Scale AI 后,部分头部模型公司开始重新审视与 Scale 的合作,高端后训练数据涉及模型当前的能力短板、重点训练方向和下一阶段研发计划,供应商能否保持独立,并妥善隔离不同客户的信息,正在成为模型公司选择外部数据合作伙伴时的重要考量。对中国市场而言,这一需求同样存在。基础模型公司竞争充分,而评测方法、Agent 环境和专业数据标准仍在快速演化,能够同时服务不同模型、连接不同专家群体的第三方平台,有机会积累更广泛的行业反馈,并更早参与新一代训练和评测体系的形成。
模型能力提升并没有削弱对高质量人类数据的需求,反而在推动数据需求向更高专业门槛的任务迁移。通用内容可以越来越多地由模型生成,标准化任务也会持续自动化,但越接近模型能力边界,专业知识、复杂任务设计和可靠评价越难完全依赖模型自身完成。
未来的数据竞争,也将越来越取决于谁能够更早发现模型的能力缺口,组织合适的专家,并把这些专业判断转化为稳定、可验证、可复用的数据体系。Humanlaya 一端通过 TalentsAI 建立专家网络,另一端持续向数据生产、Benchmark 和模型评测深入,这条从专家供给到任务定义、再到训练与验证的链路,也正在成为 AI 后训练基础设施中越来越重要的一部分。
文章来自于微信公众号 “BAI Capital”,作者 “BAI Capital”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.

姜宇辉的AI分身:知识助手与“另一个自己”之间 (opens in a new tab)
南方周末通过学者、用户与Second Me创始人的访谈及记者试用,观察AI分身的学术辅助、情感连接和商业化尝试,也呈现知识可靠性、人格边界、版权与隐私方面的疑虑。

智动未来据报完成亿元级Pre-A+融资,资金用于产线与服务机器人部署 (opens in a new tab)
机甲觉醒报道,智动未来宣布完成亿元级Pre-A+轮融资,由中美绿色基金领投、南曦创投联合领投,资金拟用于广州产线、服务场景部署和世界模型研发。“智子世界”仍属技术预览,商业化效果待更多应用数据检验。

范式智能介绍Phai-A1与Phai-M1,强调国产算力后训练优化 (opens in a new tab)
范式智能介绍面向代码与Agent场景的Phai-A1,以及面向真人影视的音画同步模型Phai-M1。公司展示了单卡运行和视频生成能力,并称模型在昇腾平台完成专项后训练优化。

腾讯Q3资本开支814亿元,称WorkBuddy日Token用量居国内首位 (opens in a new tab)
腾讯三季报显示营收2073.36亿元、资本开支814.33亿元。公司称WorkBuddy日活超1000万,按用户每日大语言模型Token消耗总量居国内首位;报道还讨论云业务增收与AI投入对盈利、现金流的影响。

黄仁勋离任后:硅谷101访谈英伟达的技术、供应链与组织挑战 (opens in a new tab)
硅谷101采访半导体、科技与投资人士,讨论黄仁勋离任后CUDA生态、系统整合、供应链、开源投入和组织传承的潜在变化。产业放缓、估值折扣及人才流失判断属于受访者观点。