对话香港理工秦浩桐:把AI大模型压到极限之后 (opens in a new tab)
DeepTech 与秦浩桐讨论模型极限压缩、训练后量化与真实设备上的推理延迟,回顾 BiLLM 的研究思路,并谈到如何用硬件测试、代码核对和实验反馈判断效率研究的价值。
Total 1519 articles
DeepTech 与秦浩桐讨论模型极限压缩、训练后量化与真实设备上的推理延迟,回顾 BiLLM 的研究思路,并谈到如何用硬件测试、代码核对和实验反馈判断效率研究的价值。
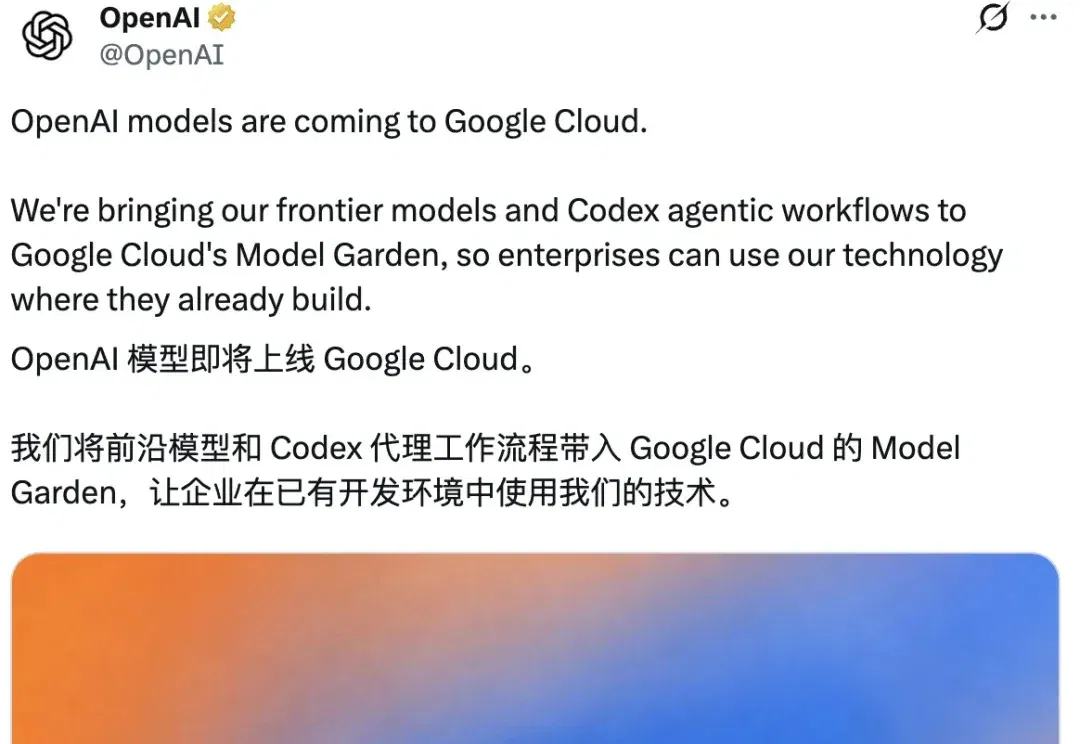
嚯,GPT要住进Gemini家了! 就在今天,OpenAI和Google Cloud正式官宣了合作: GPT-6 Astra、GPT-6.1 Sol、GPT-6 Luna以及Codex,将正式上线Google Cloud。 首批模型目前已经开始向部分企业客户开放,接下来还会被塞进Google Antigravity和Gemini Agent。 △官宣帖,详见Blog 不er,这俩不是还在大模型、搜索和编程Agent战场上狠狠干架吗?! 怎么转眼间,死对头就秒变渠道合作方,还做起了彼此的生意? 更关键的是,继Azure和AWS之后,OpenAI如今已正式集齐美国三大云厂商。 曾经牢牢锁在Azur
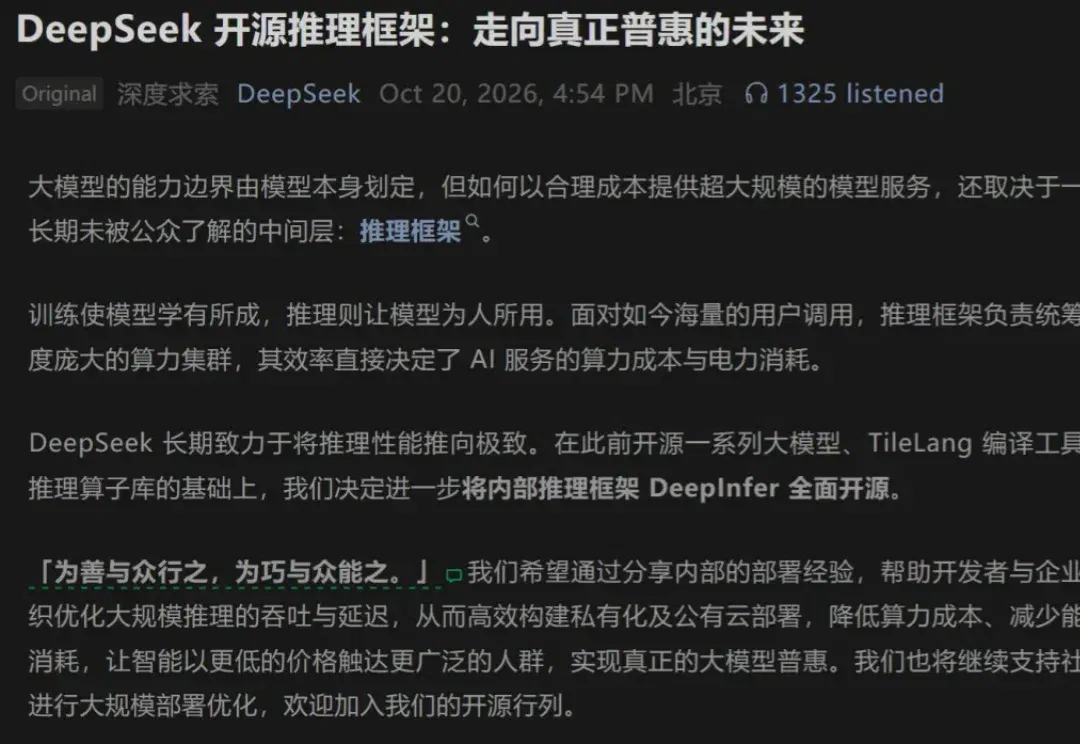
没想到这也开源了。 10 月 20 日下午,DeepSeek 开源了内部使用的推理框架 DeepInfer,以及配套的 token 编解码组件 deepseek-recipe。 DeepInfer 是目前支撑 DeepSeek 大规模推理服务的基础,本次以 Apache 2.0 许可证发布,当前支持 DeepSeek-V4.1-Flash。 这次发布迅速引起了关注,昨天大家讨论的都是 DeepSeek 现在让大家都可以快速部署自己的 AI 模型了,今天转念一想,不对,大模型推理怎么这么赚钱啊? DeepSeek 披露,基于这套系统,单个集群每天服务的吞吐量达到 155 万亿 token,按 A
元宝搜索,要做AI行业的水电煤。 把一个AI时代很常见的问题输进搜索框——查查腾讯最近的股价、产品和成员变动。这是谷歌的非AI搜索结果: ▲谷歌搜索结果 在谷歌的传统搜索中,用户得到的是一系列网页链接;而在元宝搜索中,同样的问题呈现出的结果却大不相同。 ▲接入元宝搜索的WorkBuddy 两种搜索结果的差别,恰好折射出搜索正在经历的变化。 过去,搜索引擎返回网页链接,用户需要自己筛选、比对和整理信息,进入AI时代,搜索则开始直接整合多方资料、生成答案。 AI时代对于搜索的更高要求,刚好对应着大模型落地的两大痛点——幻觉和知识滞后,即模型能力再强,也可能产生幻觉,或者因知识更新不及时而给出过时信
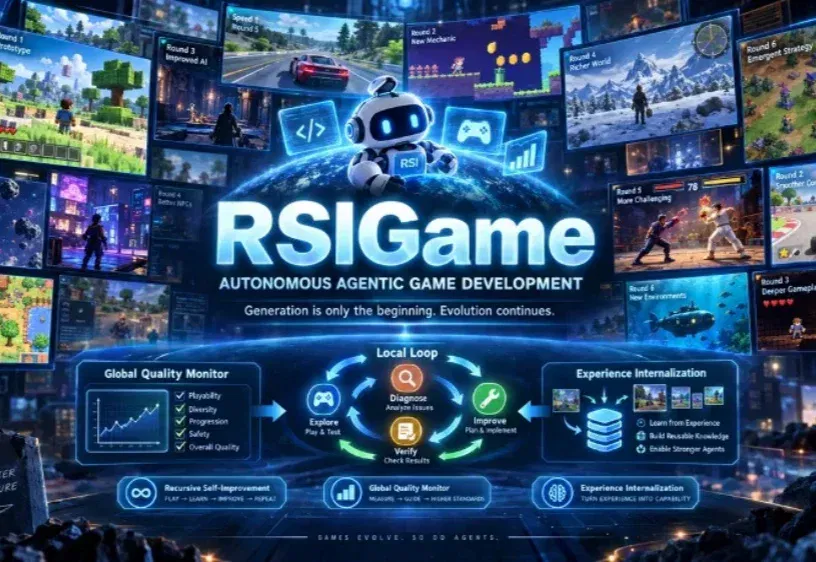
现在的大模型,已经越来越擅长从自然语言直接生成一个可以运行的游戏。
上月发布 GPT-6-Astra 时,OpenAI 称它为「全球智能程度最高且最符合人类意图的模型」。具身社区则是惊讶的发现,VLA vs WAM 的路线之争,被通用大模型用文字模态「降维打击」了,大家不禁想问:
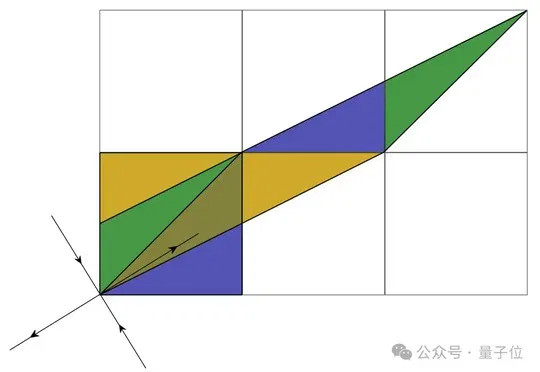
大湾区大学许地生教授团队与上海AI实验室借助书生-S2科学基础模型证明Ghys猜想在复余维一情形下成立,北京大学董彬教授、刘若川院士团队随后完成形式化验证。
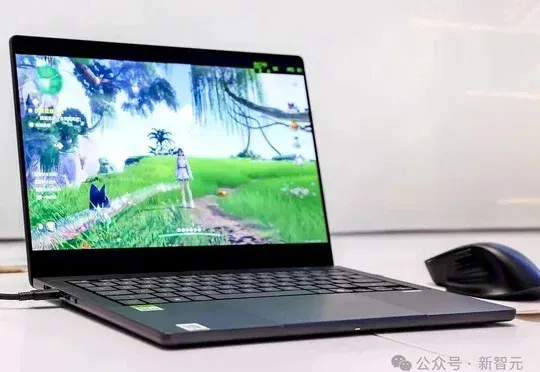
英伟达开放Nemotron 3.5 Bolt模型权重,将740亿参数版本从约148GB压缩至22.1GB以支持笔记本本地Agent任务,搭载RTX Spark的联想、微软等笔记本也于10月16日全球发售。
香港科技大学周子杰团队与华为 2012 实验室理论部提出 BalanceRoute,通过建模与短期负载预测减少 MoE 模型解码的跨组同步等待,其已部署于 MathBot-Pie,并在 96 张昇腾 910C NPU 实验中使解码吞吐提升约 15%。
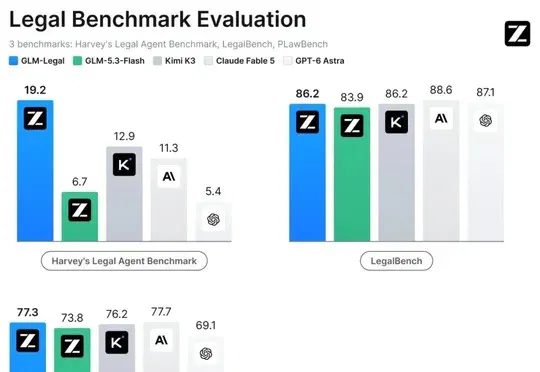
智谱旗下Z.ai发布基于GLM-5.3-Flash的法律专用模型GLM-Legal,面向合同审查、证据分析和合规研究,官方评测显示其在Harvey LAB明显领先、其余两项接近一线,目前需申请API权限且未开源。