RSI离我们有多远?这家中国团队给出了第一梯队的工程解 (opens in a new tab)
EvoMap团队提出了一套不更新基模参数的RSI工程解法:由EvoX智能体、Evolver进化引擎和EvoMap经验流转网络构成的自进化体系,将Agent执行轨迹蒸馏为结构化控制对象Gene,通过GEP协议在35.7万智能体间流转481万项经验资产,使其在多款主流大模型上将长流程任务通过率提升8.7至15.5个百分点。
Total 86 articles
EvoMap团队提出了一套不更新基模参数的RSI工程解法:由EvoX智能体、Evolver进化引擎和EvoMap经验流转网络构成的自进化体系,将Agent执行轨迹蒸馏为结构化控制对象Gene,通过GEP协议在35.7万智能体间流转481万项经验资产,使其在多款主流大模型上将长流程任务通过率提升8.7至15.5个百分点。
阿里AI办公领域,再落一子。 智东西8月17日报道,近日,千问办公开源了个人工作上下文基础设施MyContext,项目上线一周多,在GitHub上已收获超1k星,这也是千问办公的首个开源项目。 MyContext做的不是传统意义上的知识库,而是把飞书、钉钉里的聊天、文档、会议记录等工作痕迹收拢起来,持续整理成一份个人工作档案,让Agent逐渐知道你是谁、在做什么,以及平时怎么处理事情。 如果找一个熟悉的参照物,它有点像给Agent装上本地个人知识库Obsidian:同样强调本地优先、知识组织和数据主权,不同的是,Obsidian里的内容主要靠用户自己写,MyContext则试图从日常工作记录里
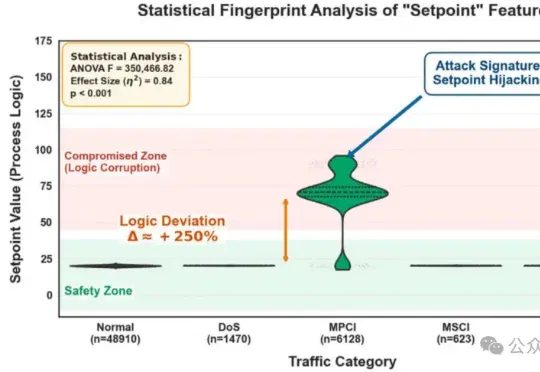
近日,北京航空航天大学洪晟教授团队在信息处理领域顶级期刊Information Processing&Management(IPM)上发表了最新成果。他们提出了一套名为BGA的噪声免疫神经蒸馏框架。实验显示,该框架在面对复杂的工业互联网(IIoT)加密流量时,不仅能精准识别隐藏深度极高的恶意指令,且推理延迟低至0.28毫秒,达到了“免疫级”的防干扰能力。
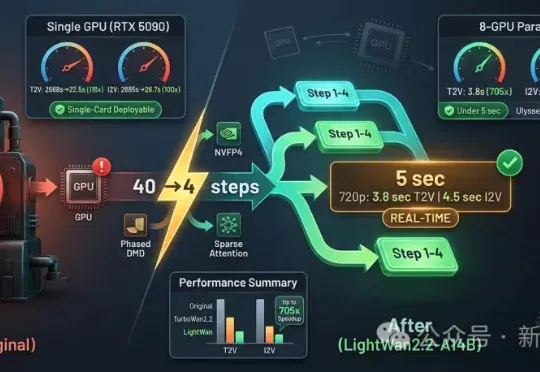
LightX2V团队面向Wan2.2-A14B推出LightWan2.2-A14B,以步数蒸馏、NVFP4量化感知训练和动态稀疏注意力压缩计算量,再用高效算子、细粒度卸载和多卡通信优化打通整条推理链路。
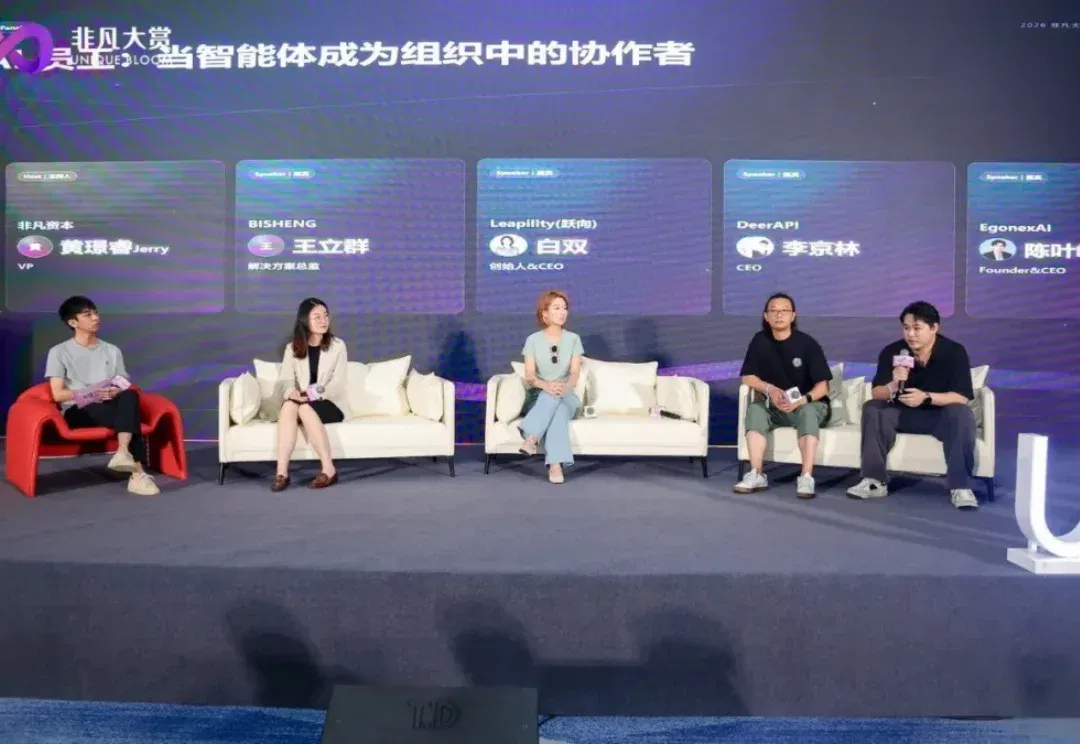
一个10人团队的产研全自动化实验:AI够聪明,人不够诚实 "AI转型表面是技术问题,底层是管理问题,最底层是人性问题。" 白双的公司里没有前端工程师。 不是招不到,是不需要。UI设计师在Figma里画完原型图,AI直接出页面。还原不了的细节,设计师在Notion里丢个comment,AI自己认领、自己改。前端搞完,Codex写后端。测试环节,自动化agent基于个性化skill跑一遍,工程师做final check。反复改不对的,CTO兜底。 整个产研链路,人只做判断,AI做交付。 这事儿说出来有点像吹牛。但白双的底气在于,这不是demo,是日常。AI犯过一次错,第二次就不会再犯,因为错误会被
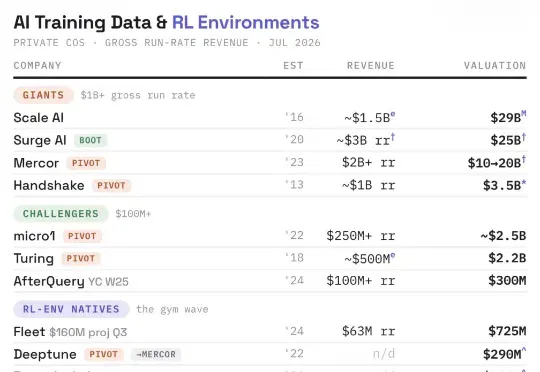
在模型层之外,2026 年上半年在硅谷增长最快的赛道之一是数据:Mercor 的 run rate 从去年下半年的 5 亿美元涨到今年年中的 20 亿美元;Handshake 转型 human data 后,run rate 在年初三个月内从 5.5 亿美元冲到 10 亿美元;RL 环境公司 Fleet 则在半年内从百万美元级别做到 6000 万美元 run rate,
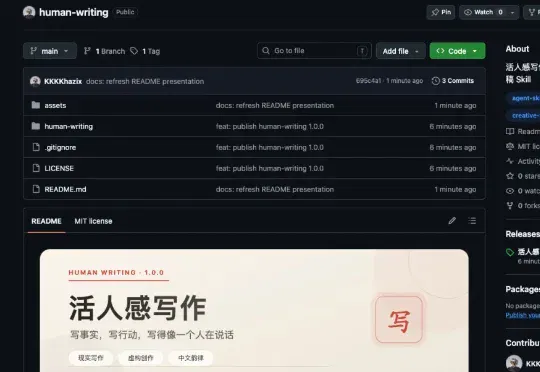
在折腾了一段时间、跟一些中文系的朋友讨教,又把我们内部的写作skill蒸馏出来了通用的规则,最后甚至手写了一部分的skill文档之后。我觉得,我终于可以,来给大家汇报一下这段时间的成果了。活人感写作.skill,英文名叫human Writing.skill
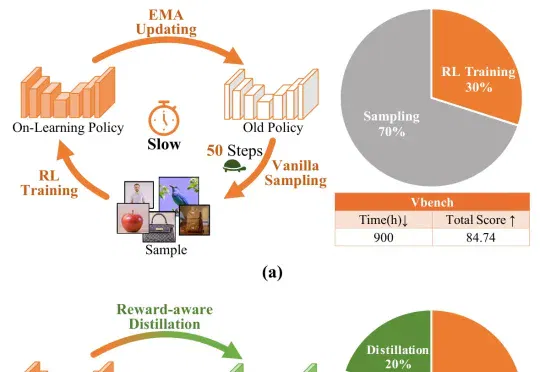
过去的 Diffusion RL 多聚焦于奖励设计与优化算法,训练时的采样成本被忽视。DMSampler 指出:在在线 RL 中,限制规模化的不只是奖励信号或优化器,很多时候是 rollout 本身太贵。
大家好,我是袋鼠帝 几天前我尝试做了一个相对粗糙的视频,是关于我开源的仓颉Skill的 没想到居然爆火了!(全网将近50万播放)。
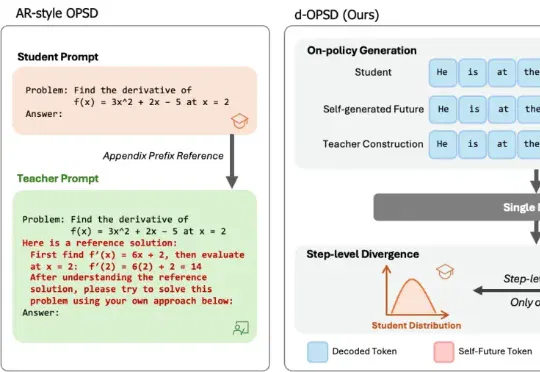
有没有一种更为合适的 OPSD 范式?近期,清华大学和马普所等机构的研究者们联合推出的 d-OPSD,给这一问题提供了完美的答案。这是第一个针对扩散大语言模型的 OPSD 范式,无需参考解,无需额外的教师模型,只需要 RL 十分之一的训练步数,便可以达到或超出 RL 的后训练效果。