无法蒸馏的美国市场,谁在分食 Frontier Labs 百亿美金数据预算?
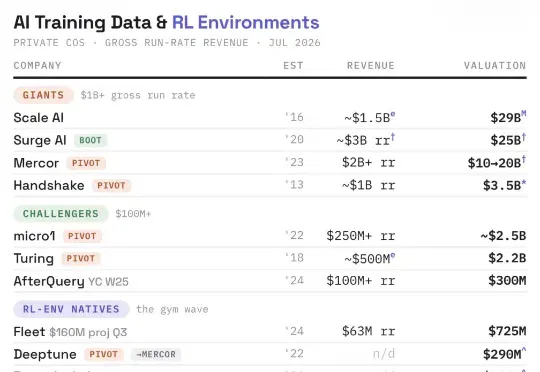
在模型层之外,2026 年上半年在硅谷增长最快的赛道之一是数据:Mercor 的 run rate 从去年下半年的 5 亿美元涨到今年年中的 20 亿美元;Handshake 转型 human data 后,run rate 在年初三个月内从 5.5 亿美元冲到 10 亿美元;RL 环境公司 Fleet 则在半年内从百万美元级别做到 6000 万美元 run rate,
在模型层之外,2026 年上半年在硅谷增长最快的赛道之一是数据:Mercor 的 run rate 从去年下半年的 5 亿美元涨到今年年中的 20 亿美元;Handshake 转型 human data 后,run rate 在年初三个月内从 5.5 亿美元冲到 10 亿美元;RL 环境公司 Fleet 则在半年内从百万美元级别做到 6000 万美元 run rate,并且已再次翻倍。在成长期公司里,数据是极少数增速能接近 frontier labs 的赛道。一定程度上,数据就是模型层竞争烈度的体现。
但这门生意的另一面同样刺眼:买家集中在几家 frontier lab,收入缺少 recurring 属性,品类每两三年就轮换一次,静态交付的数据资产贬值极快。数据生意对想构建传奇公司的创始人来说更像“甜蜜的毒药”:它非常适合冷启动一家公司,但能长期独立存活的数据公司,终局商业模式一定不会是卖数据。
过去几个月,我们在硅谷密集访谈了这个赛道的从业者,把 human data、RL 环境、RLaaS 和真实世界数据放在同一条 post-training 供应链里做了一次系统梳理。本文试图回答几个关键问题:
•头部 labs 每年数十亿美元量级的外部数据预算到底在买什么?为什么当前市场“缺高质量供给不缺预算”?
•Long-horizon agentic 时代,为什么“演”出来的数据会系统性失效,真实世界数据成为最新的争夺点?
•Human data 巨头、RL 环境、RLaaS、真实世界数据四个细分方向,各自的格局和投资判断是什么?
•品类快速轮换之下,什么样的团队能穿越周期?数据公司的终局和退出路径在哪里?
01.
核心投资判断
我们对广义的 human data 与 training signal 赛道(下文简称为“数据”)的 TAM 和增长有很深的 conviction,但当前这个行业 beta 的确定性高于单家公司 alpha。这是一门总量确定增长、但每家公司单点位置极不稳定的生意。展开来讲,我们有以下判断:
1.数据已经成为 Inputs of ASI 的一个长期重要元素。如果 Flapping Airplanes、SSI 等探索 sample efficiency 方向的 neolab 没有重大突破,行业沿着当前 Transformer 架构继续发展,模型要进步,SFT、RLHF、专家数据、agentic RL 环境、真实世界数据等数据需求就会持续存在和扩大。但这里需要区分 training signal 的 TAM 与外部数据供应商的可获取市场。模型需要更多训练信号,不代表 labs 会以同样速度增加外部采购。上一代模型生成下一代训练数据、self-play / synthetic data、内部 production traces,以及 labs 自建 environment harness,都可能在扩大训练信号总量的同时压低 vendor take rate。我们对“数据长期重要”的 conviction,严格来说是对 training signal 的 conviction,而不是对当前外部数据公司收入份额的线性外推。
2.数据是一个持续有新机会的创业赛道,背后机制是模型的存量 failure modes 和 N+1 进步。只要有模型能力边缘之外的任务(模型还做不到、用户不会去试、labs 自己的使用数据里根本不存在),就有新的数据品类和供应商机会。过去 3 年来看,模型能力边界往前移,就会催生新品类,最新的品类是真实世界数据。
3.最新的机会在真实世界数据和行业的质检基础设施。随着 RL 环境供应商生态的成熟和 frontier lab 对于 agentic long-horizon 进步的持续追求,非人造的真实过程数据因为其结果自带答案、分布天然真实而越来越被重视。此外,基于整个硅谷生态对于 verifier 和 grader 的基础设施以及人类专家标注行为质量的集体反思,行业的质检基础设施价值也在增长。
4.当前的数据公司、RLaaS 乃至 neolab 将在未来一两年迎来大量 M&A 整合。随着头部的数据平台、neolab 和 neocloud 玩家开始进行 TAM Expansion,当前数据和 RLaaS 各自有几十上百家公司的分散局面将迎来整合,例如 Mercor 已在近期收购 Deeptune。因为客户集中度和订单可持续性问题,小玩家也的确有动力出售自己。
5.能长期独立存活的数据公司终局商业模式不会是卖数据。数据生意对于想构建传奇公司的创始人来说是甜蜜的毒药,它适合冷启动一家公司,但有人力产能瓶颈、数据资产贬值周期短、客户仅限于几家 frontier lab 等问题。有野心的创始人往往在早期就尝试拓展企业客户、储备资源向 neolab 转型、或者将内部 infra 产品化。
02.
数据公司的增长与难题
在拾象,我们持续押注 foundation model 层公司,同时持续寻找增速能超过它们的成长期新方向 —— 数据是少数接近达成这个目标的赛道,这也是吸引我们关注这个方向的原因之一。一定程度上,数据是模型层竞争烈度的体现。
以这些头部玩家为例(以下数据均来自媒体公开报道):
•从 AI 招聘成长为 human data 平台的 Mercor Run Rate 从去年下半年的 5 亿美元,提升至 26 年年中的 20 亿美元
•Handshake 从校园招聘转型 human data 后 Run Rate 在 26 年 1 月达到 5.5 亿美元,在 4 月提升至 10 亿美元
•领先的 RL 环境公司 Fleet Run Rate 从 25 年 10 月的 100 万美元迅速在 26 年 4 月突破 6000 万美元,并且目前已经再次翻倍
这些头部玩家在 26 年第一季度都大体持平或跑过了 frontier labs 的加总 ARR 增速。但考虑到 frontier labs 在第二季度 Net New ARR 继续加速,数据的大公司们在上半年增长略输于 frontier labs。不过它们仍然是成长期少数能接近 frontier labs 增速的公司。
和数据公司处于相近增速水平的是 Fireworks、Baseten、Together 等推理服务商。按照 Fireworks 公开披露的数据,它的 ARR 在上半年从 3 亿美元出头增长到了 10 亿美元以上。
由于在 TAM 潜力、客户集中度、收入的可预测性等方向的担忧,目前美国投资市场给数据公司的定价低于 frontier labs 以及推理服务商。这些头部成长期数据公司都在面临相似的题目:如何与市场沟通并说服大家自己的终局商业模式不仅仅是给 frontier labs 卖数据。
03.
需求拆解:买家结构与采购行为
Labs 侧
买家分层:
•根据我们的访谈,不同 lab 的 sophistication 程度排序:Anthropic >= OpenAI > GDM > 其他。Anthropic 及 OpenAI 需要强定制和服务,而其他 lab 购买 OTS 供给的可能性显著更高
•Anthropic 是市场话语权最高的买家,对于研究型服务的程度和独家供给的要求显著更高
•头部 frontier lab 买什么,如果没有独家限制,同样的 OTS 供给可以在数个月后进入其他追赶型 lab 的采购清单
•此外,一些人力和研究资源有限的 lab 及 neolab 更愿意购买 environment、recipe、rollout 和 compute 的整套交付
采购形态演进:
•大的形态 1-2 年有明显演进,比如从 RLHF 到专家 SFT 再到 RL 环境,同时小的主题每数月就会转换,比如从 computer use、coding 到 auto research 等
•垂类主题也有类似的演进,比如 Anthropic 今年 1 月大量采购网络安全数据,3 月和 4 月大量采购生物相关数据
•目前美国的数据加工中间环节已经实现 Infra 和知识的相对公开化,比如大家跑 rollout 都通过 Harbor Framework,因此缺乏研究闭环的低质量加工环节价值贬值很快
我们判断虽然 Labs 侧的买家相对集中,但需求会持续存在并且持续出现新机会。每个阶段新的外部数据增量需求对应模型 N+1 要进步的能力。除了能否跟上 N+1 的新需求,要判断一家公司的长期价值,还要看:信号能否持续更新,rights 是否允许训练和跨客户复用,质量判断是否可积累,以及边界移动后该公司能否从一次性 dataset 迁移为 evergreen pipeline。
企业侧
采购现状及挑战:
•主流企业的 eval/数据采购单笔通常不到 100 万美元,且 ROI 很难计算清楚,外部 eval 和数据预算随时被砍,离稳态还很远
•对于数据公司来说,目前企业客户的订单还不能很好地 scale,根因是每单都要进行咨询和定制,无法产品化复制或者进行非独家销售
•企业销售侧还有一层结构性摩擦,即企业内部对于 build vs buy 的持续辩论。比如大量企业都有自己的 applied ML 负责人,他们还没有建立起对小型 RLaaS 创业公司的深度信任
买家分层:
•AI 应用公司,Decagon、Sierra、Ramp 这类内设 Labs 团队的应用层玩家是数据和 post-training 市场上重要的企业买家。在今年 model routing 降本的大趋势下,它们买垂直数据、自训小模型(Ramp 用 frontier 模型做规划 + 自训小模型做检索)、做公开 post-training 实验,有中短期内大量的 eval 和数据需求
•高单位人力成本的受监管行业(金融、法律、医疗)。只有这里的白领工作单价高到能覆盖 FDE 驻场交付的成本,所以目前 RLaaS 的高价值合同集中在这类客户
•极少数有清晰 KPI 的运营型公司。比如 DoorDash,配送费优化目标明确,但它同时是所有供应商的客户,逐家做小额 pilot,而且已经收购了 RLaaS 公司 Metis,也在探索自建
企业侧需求的动机和走向推演:
•企业的动机是“拥有自己的 specific intelligence”,对冲被 frontier labs 蒸馏(企业用 Claude/Codex 越深,流程和经验被吸走越多,反向就有动机把 frontier 能力沉淀成自己的模型和 SOP),叠加成本与延迟(在固定智能水平下要便宜得多的模型)
•走向有三个变量在同时推进:a) post-training 自助工具(Tinker、Prime Intellect、CGFT 等服务)在快速压低边际成本;b)Frontier labs 自己进军企业服务反而在帮整个 RLaaS 品类做市场教育;c)Labs 之间的持续竞争保证了企业不会被单一生态锁死,同时企业本身有很强的 model-agnostic 需求
我们判断企业今天不是数据/eval 的高成熟度好买家,但随着开源模型进步和 post-training 各方面成本继续下降,中端市场可能会在 12–24 个月内从“高度咨询和定制、FDE 不经济”变为一个可服务的赛道。
04.
最新需求侧趋势:真实世界数据
真实世界数据的定义:它是指真实经济活动中自然产生(而非为训练专门生产)的完整过程数据,最好记录了从最开始任务意向到最终创建完成交付物的全套轨迹,载体包括企业私有代码库、真实员工的 browser-use 轨迹、Slack/ERP 操作记录、医疗诊断的全程记录等。
Standard Data 的创始人 Sean Cai 是最早关注到真实世界数据的意见领袖之一,他将这个需求的兴起总结为两点:
•互联网天然只沉淀 State(代码、报告、文档等最终产物),不沉淀 Process(如何理解模糊的 intent、寻找 context、犯错和恢复)。Coding 是唯一例外,因为 GitHub 通过 commit/PR/issue 恰好完整记录了程序员的工作过程,这直接解释了为什么 coding 最先被攻克;其他领域没有 GitHub,真实过程数据的采集权因此成了新的争夺点
•long-horizon agentic 时代人造数据有明显局限,这让 Real-world data 越来越重要:
行业里把训练数据分成两类:
1.Type 2 是“演”出来的数据:雇专家按照 spec,在人为搭建的场景里生产任务、示范和答案。过去三代数据品类(专家标注、RLHF、RL Environment)本质都是 Type 2,区别只是演得越来越像;
2.Type 1 是“记录”下来的数据:直接观测真实工作中自然发生的过程,从行为里推断什么算做得好。最纯粹的形态是精确到每次点击的 session replay
任务短或好验证的时候,两类数据差别不大(比如 Coding、Math 这类容易验证的领域),Type 2 至今好用。但任务一长,Type 2 会在三个环节上系统性失效:
1.Reward 造不出来:长任务的最终 reward 稀疏,设计者只能人为插入中间 reward。而每一个人为设计的中间 reward 都是模型的攻击面,reward hacking 防不胜防。真实工作里不需要设计 reward:客户签没签、bug 修没修、报告被不被采纳,结果自带答案
2.任务分布造不像:专家“演”任务时,演的是他想象中的工作,不是工作本身。真实工作里的信息残缺、工具卡顿、中途改需求、错了再返工,这些恰恰是模型最需要学的部分,也恰恰是人造场景最先省略的部分
3.边界任务造不出来:当模型逐渐超过普通从业者后,人类越来越难持续生产位于模型能力边缘之外、同时又有可靠答案的任务。Coding 已经开始出现这一问题:普通程序员能够设计的任务迅速被模型吃掉,剩余需求向数据库工程、Kubernetes、复杂分布式系统等更窄、更高专家门槛的领域迁移。
不过真实过程数据不等于低噪声 reward:最终结果可能受大量外生变量影响,也未必能够准确归因到中间的某一次行动。真实世界数据解决的是 fidelity 问题,仍然需要专家、grader 和训练验证把原始轨迹转化为可用的 training signal。Type 1 与 Type 2 更像数据来源的光谱,而不是非此即彼的替代关系。Type 2 适合把模型从“不会”带到“初步会做”,Type 1 则帮助模型接近真实工作分布。近期最可行的产品形态可能是 Type 1.5:从真实工作中获取任务、失败模式和过程结构,再由专家进行意图补全、reward shaping、分层质检和反 reward-hacking 设计。
根据我们在硅谷的调研,Real-world data 获取路径已经跑出四种具体做法:
•买死公司:收购破产或停运科技创业公司的数据资产。完整的 Slack / Email / Drive / Workflow 数据可以被整体买断,放入复刻环境后成为高保真的 RL gym;已经有专门从事清算撮合的渠道批量供给这类资产
•向应用公司采购:一般向 AI 应用公司购买其拥有的 Agent 对话 trace 和 failure mode
•购买企业 post-training 的数据冗余:部分企业会自行采集数据做 post-training,但只能消化很小一部分,同时也希望收回成本,因此也会考虑将数据出售给外部 Lab
•共建:Frontier Lab 与垂直应用公司做 revenue sharing 或共建 eval,换取真实用户任务的持续接入
05.
供给侧 Mapping:玩家地图与细分判断
美国的投资同行们做了很好的 mapping 工作,我们就不重复造轮子了,在此引用他们的成果。
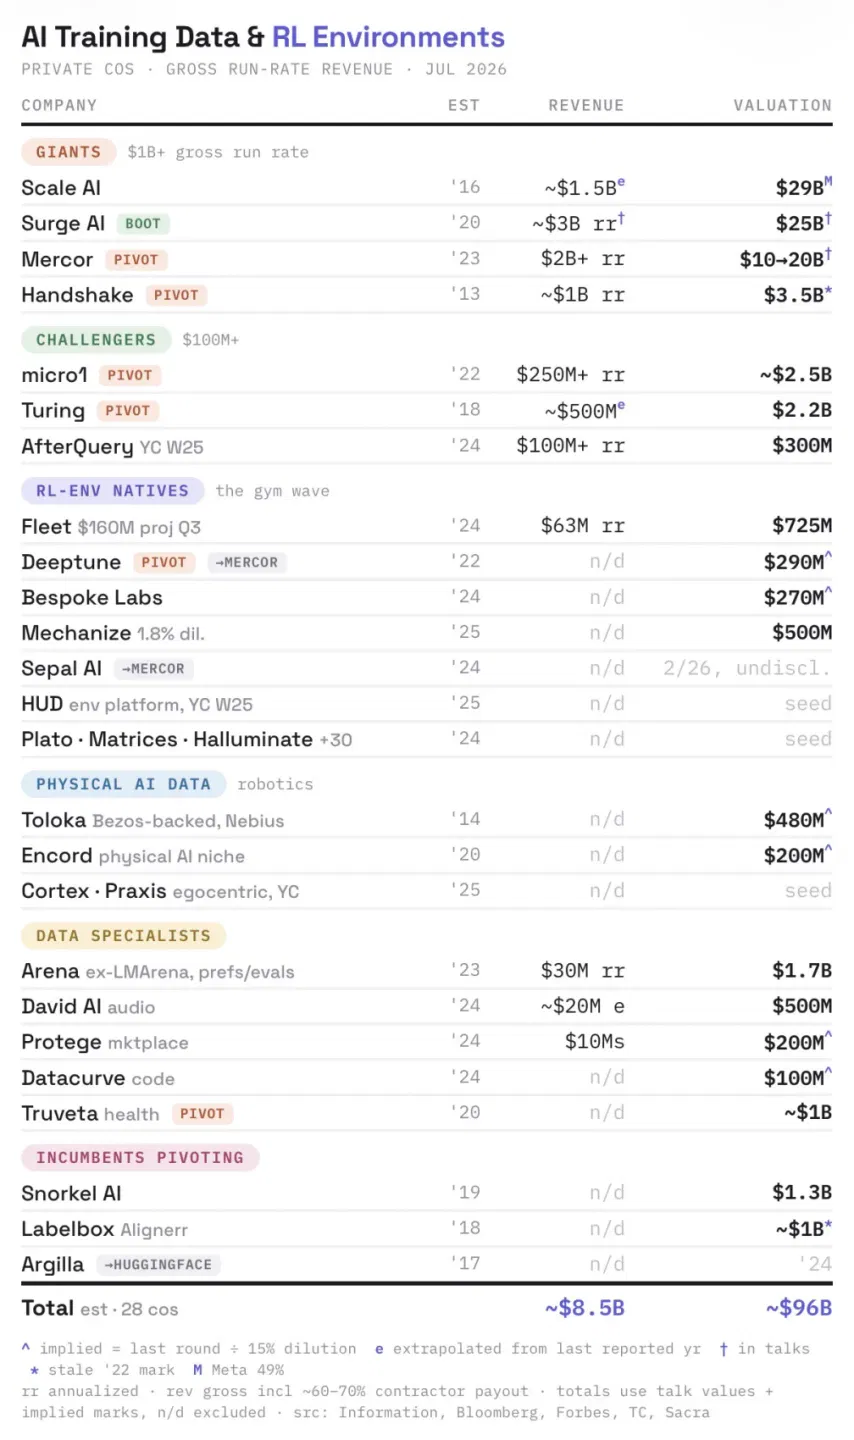
下图是 Menlo Ventures 的 Deedy 按 ARR 规模分层总结的玩家列表:
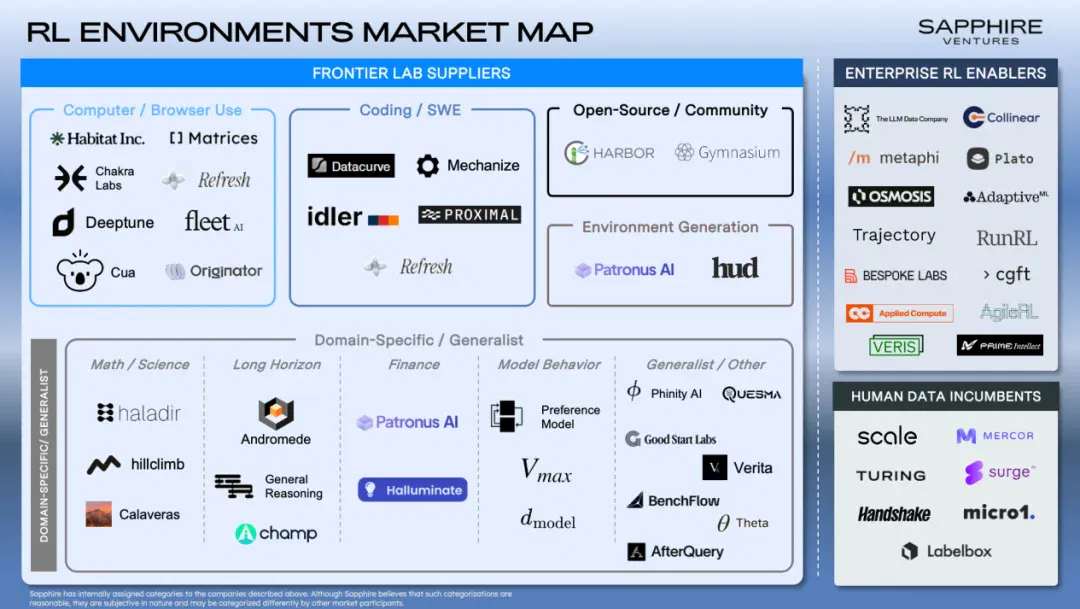
Sapphire Ventures 此前有很细致的工作,总结了按专长分类的 RL 环境公司列表:
以下是我们对各个细分方向的具体洞见与判断:
Human data 巨头
格局上第一梯队是 Surge、Mercor、Scale(下滑趋势)、Handshake,均突破 10 亿美元 run rate 且都有交付中大型规模、中高质量要求项目的能力。Micro1 和 AfterQuery 是目前第二梯队中的 emerging 玩家。
这些 human data 玩家加总拿走了目前 Labs 外部数据预算的 60% 以上。在大型项目上管理成千上万人同时工作是 lab 相当长时间都不会想自己干的脏活。尽管业界普遍认为它们缺少“让数据质量随交付规模提升而加强”的规模魔力,它们在运营侧还是体现出了一定的规模效应。以 Mercor 为例,它有约 500 万实际做过 AI 访谈的专家,并且可以通过 referral 实现专家供给的持续增长。它们的规模还带来了在专家水平的判断和 research-first 的项目上选定 reviewer 的质量优势。
目前对这类玩家的主要担忧是客户集中于 frontier labs、收入缺少 recurring 属性、毛利扩展空间有限。但它们都在探索真实世界数据和企业客户以多元化其业务。根据我们对波音等公司的访谈,传统大型企业要成长为它们的第二增长曲线客户仍需要相当长时间的教育和探索。
拾象投资判断:
•这个子类需求旺盛而且 winner 格局清晰
•目前头部玩家估值都按 10x Run Rate 定价,price-in 了在后续数据需求趋势以及企业客户侧的 perfect execution
•按照目前的估值水平进行成长期投资的话,downside 有一定保护(来源于 Labs 及 compute 公司的收购兴趣),但 upside 3-5x 的机会不是很清晰,特别是随着退出估值转换到 2-3x RR 定价的话。
RL 环境
RL 环境是什么:一个装着“仿真工作场景 + grader”的软件包,比如一个功能完整的假 Salesforce、假 SAP 或假邮箱系统,里面预置了任务(“从这堆邮件和文档里整理出季度报告”)、模型可调用的工具,以及自动判断做没做对的验证机制。Lab 客户拿到手是一个 Docker 容器,插上自己的 agent 就能跑评测、跑几万次 RL rollout,本质上是给模型练手的“驾校模拟器”,练的不是知识,是在软件系统里干活。
随着 agent 的任务长度从十几步拉长到数百步,RL 环境的难点也不再只是把软件系统和工具调用复刻出来。一个容易被低估的 bottleneck 是 context writing 和 memory attribution:模型需要在任务中途判断哪些信息应该写入长期 context、如何压缩,以及什么时候重新调用;但最终成败可能在数百次行动之后才发生,因此很难判断某一次保存、删除或调用信息的动作究竟贡献了多少 reward。真实 trajectory 能暴露这个问题,但不会自动解决 credit assignment,仍然需要 trajectory-level critic 和更细致的 verifier。
格局上 Fleet 在营收 Run Rate 上一骑绝尘,上半年增长 50x 至 6300 万美元,目前预计已突破 1.5 亿美元。Fleet 以定制化贴身服务 DeepMind 的 computer-use 和 agentic coding 需求起家,目前已拓展进入其他 frontier lab。此外我们 reference 得到的好口碑玩家包括 Mechanize(软件和 coding 方向 research-first 的高毛利小团队路线)、Matrices(最好的 computer use 环境提供者之一)、Patronus(最好的 Finance 及 Healthcare 评估与环境提供者之一,程序化生成环境的领先探索者)、Irregular(最领先的网络安全评估与环境提供者之一)等一批 seed 到 B 轮之间的玩家。
这个生意的好处是离 labs 的研究前沿最近,本质上是 labs 的 forward-deployed research arm,能第一时间看到能力边界在哪、下一个采购品类是什么,research-first 小团队的毛利也可以很高。此外,大多数 RL 环境公司都把自己定位为 Research Lab,希望最终开发自己的模型或垂类应用。
但这个赛道也有同样令人担忧的地方:竞争激烈、买家跟 human data 一样集中在 labs;环境是一锤子交付,半衰期约 6 个月、没有复购(同一批环境客户不会买第二次)、人力产能约束单量;此外整体的行业趋势是不利于 RL 环境公司的长期价值的:lab 在加码探索自建(最 sophisticated 的买家已有自己的环境 harness,vendor 只需按 spec 交 Docker 容器)、开源收敛接口(Harbor/BrowserGym/OpenEnv)、买家转向直接买 raw traces、程序化生成正在被探索。
拾象投资判断:
•单纯手搓环境的公司 pass,因为生意是高度定制化服务属性,资本市场愿意给出的估值倍数会非常低,投资价值不大。领先的 RL 环境公司已经认知到这一点,因此大多定位自己是 research lab,在向三个方向转型:a)做 QC/QA 的数据 infra,成为 verifier 和 grader leader,可以自动生成和维护 envs;b) 做具体场景的 model 和应用;c)做沙盒等方向的模型或 agent infra
•Fleet 和 Patronus 等领先的 RL 环境公司在探索 simulation 来更大规模地生产环境和跑 rollout,是可以解决产能问题的 bet,有一定的想象空间
•此外 Irregular 这类网络安全方向的 envs 供应商值得单独关注,因为安全问题和 day-0 漏洞本身是一个持续的 stream,可以抵消掉赛道的一些结构性问题
RLaaS
格局上 Applied Compute 是品类旗手(OpenAI 系团队,三个月估值从 5 亿美元上涨至 13 亿美元),第二梯队是 Veris、The LLM Data Company、Plato、Theta 等 enabler。以上玩家咨询属性更重。Trajectory 走自助平台路线(客户 Harvey、Clay 等),但目前体量不大。相邻的自助工具层(Tinker、Prime Intellect、CGFT)在快速把训练侧商品化,其中 Prime Intellect 有算力资源且有一定的 Post-training 人才,值得关注。
RLaaS 的赛道亮点有三个:
•这是唯一不依赖 frontier labs,且和 human data 是镜像对称的同一门生意(labs 是 MLE rich / data poor,企业是 data rich / MLE poor),天然有双向渗透空间。有 RLaaS 公司把客户侧产生的数据改造后卖给 lab,形成第二收入
•企业的 production agent loop 是一个独立于 lab training loop 的预算池,持续运行的 agent 需要评测、监控、数据回流,不一定每次都更新模型权重,但可以形成稳定的软件加用量收入,这是品类里唯一可能长出 recurring 属性的地方
•数据效率在进步(Applied Compute 与 Mercor 的案例:少于 1,000 条高质量数据训出线性提升的模型),交付成本在降
但赛道同样有不少 concern:RL 是品牌、咨询是本体(大多数团队约 10% 时间做 RL、90% 做外包 MLE 和系统搭建),每单定制、无法产品化复制;部分客户被教育后更倾向于长期转向自建而不是对外持续采购;训练侧被自助工具商品化后,很难积累技术差异化优势;同时“卖客户数据”是埋在整个品类里的信任地雷。
拾象投资判断:
•我们判断 RLaaS 最出人意料的 leader 将是 Thinking Machines Lab,它有非常好的产品线布局,有开源模型、RLaaS 产品 Tinker、人才,如果能更激进租用算力和拓展至 inference 业务则可以完成对企业服务的产品整合
•此外 Fireworks、Baseten、Together 等玩家也有机会通过收购进行更深一步的垂直整合吃掉 RLaaS 的中高端市场
•单独的 RLaaS 玩家目前还没有绝对的 winner,从 reference 来看,Trajectory 和 Prime Intellect 在 Infra 建设和人才质量上值得关注
真实世界数据
真实世界数据是最新一波的数据需求,已经诞生了一条分工清晰的供应链,各自有代表性的玩家:
•清算收购方,比如 Sunset 等公司,从清盘的公司处买断数据,同时和还在运营的企业建立数据提取合作
•垂类加工管道,把独家锁定的原始数据清洗、链接、合规化后销售向 Labs
•Asset-light broker:转销上游数据及撮合企业冗余数据变现抽佣
真实世界数据比 RL envs 玩家在多方面都更具吸引力:
•具备 scalability,“做一次卖多次”:真实世界数据大部分是非独家合同,可以一份卖给多个买家,不需要像环境一样来单定制
•毛利结构可以做到介于 RL envs 和 Human data 公司之间
•通过供给侧的独家协议,先发优势可以转换成护城河
拾象投资判断:这个数据需求在过去 6 个月才兴起,目前数据供应商和 Labs 都还在探索行业标准、模型如何更好使用这类数据的阶段,推荐先观望以上供应链层级中的代表性玩家。此外 Mercor、Micro1 等也在大力投入 real-world data。
06.
什么样的团队能赢
我们判断数据是 flow business 不是 stock business。在品类周期快速变换的同时,赛道内的公司能长期积累的是四项资产:研究员的信任、持续的数据供给源、经过真实训练验证的质量体系,以及把快速抓住新需求、快速变成规模化交付的组织能力。
不同背景的团队的原生资源:
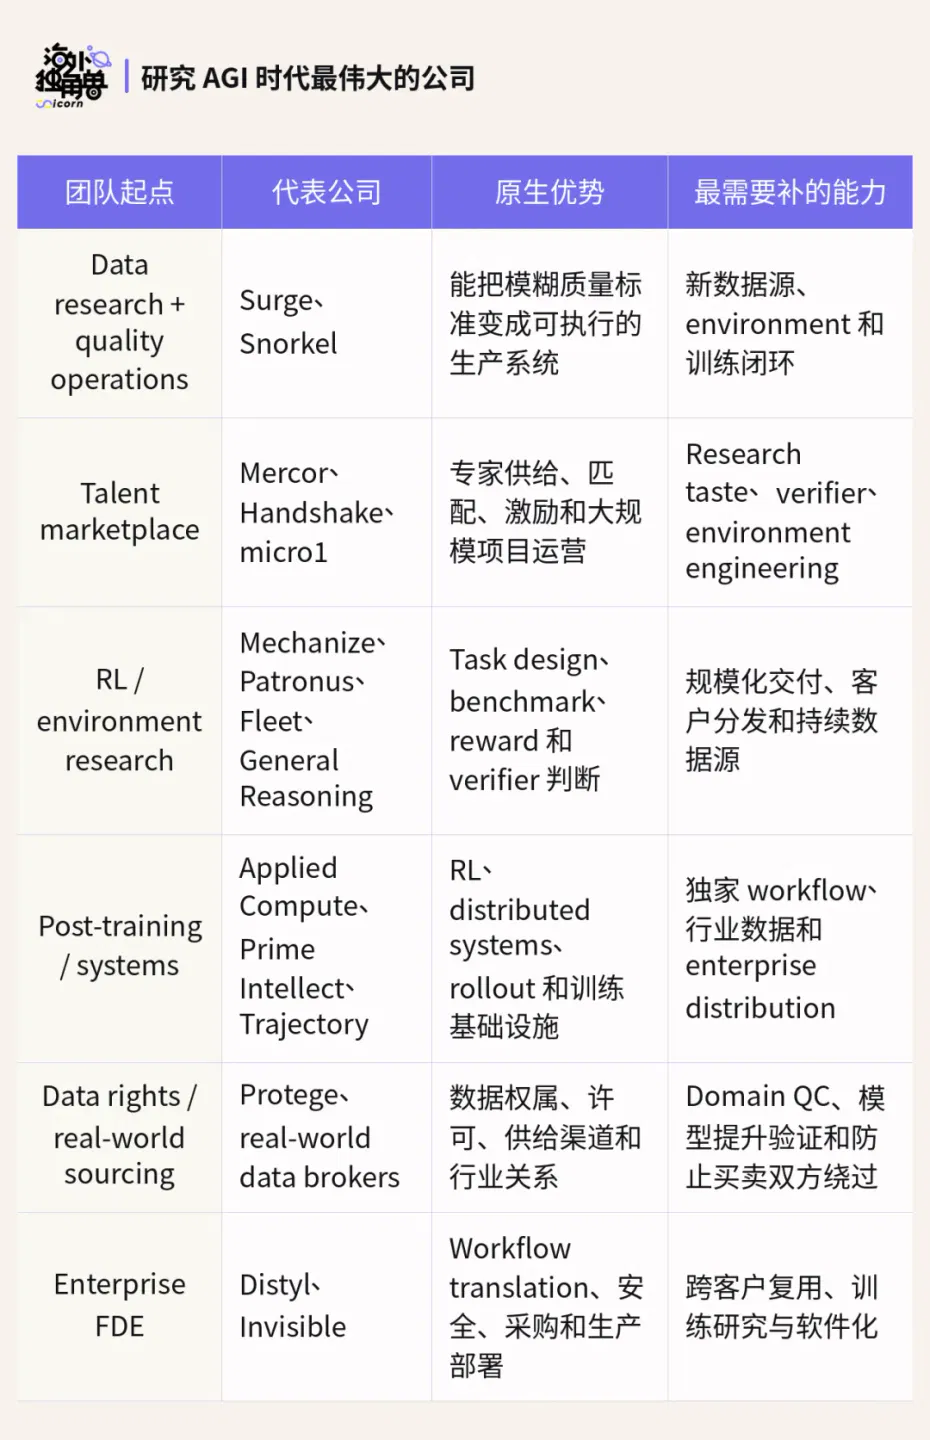
这些差异可以从团队构成中看出来:
•Surge 的创始团队同时来自机器学习、Twitter/Facebook integrity、trust & safety 和 data operations。这种 research 与 operations 从第一天就在同一组织里的结构,比后期聘请一个 research team 更难复制
•Mechanize 从 Epoch AI 出发,原生优势是对模型能力边界、benchmark 和任务设计的判断;上限取决于能否把 research taste 变成稳定的环境产能和客户交付
•Patronus 两位创始人来自 Meta Reality Labs 和 FAIR,起点是 evaluation、responsible NLP 和 alignment,因此更容易理解 grader 为什么失真,但仍需证明大规模 environment production 和商业扩张能力
•Mercor 和 Handshake 的起点都是人才网络。它们拥有供给、分发和运营规模,但需要通过并购补技术深度。Mercor 收购 Deeptune,Handshake 收购 Cleanlab 和 Taro,已经显示出这条演进路径
我们可以看出这个领域强 CEO 有五个共同特征:
1.能够直接和 researcher 讨论质量。 说得清模型缺什么能力、数据为什么有效,不把研究需求完全交给销售团队转述
2.愿意主动淘汰现有收入。 当需求从 RLHF 转向环境、再转向真实世界时,敢于停止扩张正在增长但即将贬值的业务
3.知道什么该自建、什么该收购。 Research taste、数据权利和客户信任很难靠普通招聘补齐;通用软件、算力和基础运营相对容易购买
4.能让 research 和 operations 共同对结果负责。 Research 不能只负责发表观点,operations 也不能只对交付量和毛利负责。两边需要共同承担模型提升和客户满意度
5.能维持中立性与保密。 同时服务多个 labs 时,数据权利、信息隔离和客户信任会直接决定可服务市场
所以我们 underwrite 的对象是当前品类地位 + 针对下一波需求的迁移速度。
•穿越周期的 CEO 画像:反应极快、愿意接受新事物、动手快。Surge、Mercor、Micro1 的 CEO 都是这个画像
•判断团队有两层筛选:
1.第一层是通用要求,所有数据公司都一样:有 data taste 和 research taste,对下游训练有自己的 opinion
2.第二层是本行要求,起点不同,天生要会的东西就不同:human data 首先要会 marketplace 运营和人的质量分层;真实世界数据供应商则首先要会 sourcing、数据授权和领域的 QC;环境公司首先要会 task design、verifier 和 environment engineering;continual-learning platform 首先要有 RL taste、distributed systems 和 production loop 的能力;enterprise FDE 首先要会 workflow translation、安全与采购落地
07.
赛道终局与退出判断
我们对数据终局格局目前的分段判断:
•Human data 平台可能是目前的 3 到 4 家持续扩张,同时可以阶段性地带起一批垂直供应商
•真实世界数据会按行业和数据源天然分散,金融、医疗、agentic coding 等大行业会有 1-2 名头部玩家成长到独角兽水平
•如果目前的 RL 环境头部玩家在 simulation 上的 bet 成功,agentic 相关的 RL envs 公司收敛会非常迅速
•RLaaS 受限于 FDE 服务的特点,很有可能长期分散,只有极少数能长成 system of record
单纯做数据在硅谷被认为是一个很难 IPO 的方向,因为客户集中度和订单持续性的问题无法真正被回答。因此能够 IPO 的公司最终商业模式一定需要有企业客户以及数据之外的产品。
除了 IPO 外,M&A 是数据公司非常好的退出方式。有三类买家:
•第一类是 frontier lab,比如 Meta 投资 Scale AI
•第二类是 NVIDIA、neocloud 和 inference 平台,它们的客户在算力之外还有很强的评估和数据需求
•第三类是 Datadog、Snowflake、Databricks、ServiceNow、Salesforce 这类掌握 production data 或 enterprise workflow 的公司,有动机购买 continual learning、评估、模拟和环境能力补齐自身 AI 产品线,公开市场上把 FDE 内化为产品的 Palantir 也在此列
文章来自于微信公众号 “海外独角兽”,作者 “海外独角兽”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.

姜宇辉的AI分身:知识助手与“另一个自己”之间 (opens in a new tab)
南方周末通过学者、用户与Second Me创始人的访谈及记者试用,观察AI分身的学术辅助、情感连接和商业化尝试,也呈现知识可靠性、人格边界、版权与隐私方面的疑虑。

智动未来据报完成亿元级Pre-A+融资,资金用于产线与服务机器人部署 (opens in a new tab)
机甲觉醒报道,智动未来宣布完成亿元级Pre-A+轮融资,由中美绿色基金领投、南曦创投联合领投,资金拟用于广州产线、服务场景部署和世界模型研发。“智子世界”仍属技术预览,商业化效果待更多应用数据检验。

范式智能介绍Phai-A1与Phai-M1,强调国产算力后训练优化 (opens in a new tab)
范式智能介绍面向代码与Agent场景的Phai-A1,以及面向真人影视的音画同步模型Phai-M1。公司展示了单卡运行和视频生成能力,并称模型在昇腾平台完成专项后训练优化。

腾讯Q3资本开支814亿元,称WorkBuddy日Token用量居国内首位 (opens in a new tab)
腾讯三季报显示营收2073.36亿元、资本开支814.33亿元。公司称WorkBuddy日活超1000万,按用户每日大语言模型Token消耗总量居国内首位;报道还讨论云业务增收与AI投入对盈利、现金流的影响。

黄仁勋离任后:硅谷101访谈英伟达的技术、供应链与组织挑战 (opens in a new tab)
硅谷101采访半导体、科技与投资人士,讨论黄仁勋离任后CUDA生态、系统整合、供应链、开源投入和组织传承的潜在变化。产业放缓、估值折扣及人才流失判断属于受访者观点。