对话创材深造王轩泽:真实实验数据如何支撑 AI 材料研发 (opens in a new tab)
王轩泽介绍创材深造以大模型调度、小模型与计算工具执行、自动化实验验证构建材料研发闭环,并讨论高维数据和量产交付。材料数量、性能与商业进展来自受访者口径;所谓确定性和金属材料GPT时刻是其判断,仍需持续验证。
Total 69 articles
王轩泽介绍创材深造以大模型调度、小模型与计算工具执行、自动化实验验证构建材料研发闭环,并讨论高维数据和量产交付。材料数量、性能与商业进展来自受访者口径;所谓确定性和金属材料GPT时刻是其判断,仍需持续验证。
大模型再强,也读不懂你公司那一柜子的合同、发票和扫描件。在"纸张世界"和"LLM世界"之间,缺一座桥——而百度开源的 PaddleOCR,可能就是当下最稳的那座。
jina-embeddings-v5-omni正式发布,我们把 v5-text 向量模型的能力延伸到图像、音频和视频。文本侧不变,v5-omni 产出的文本向量与 v5-text逐字节一致,无需重建任何已有索引。
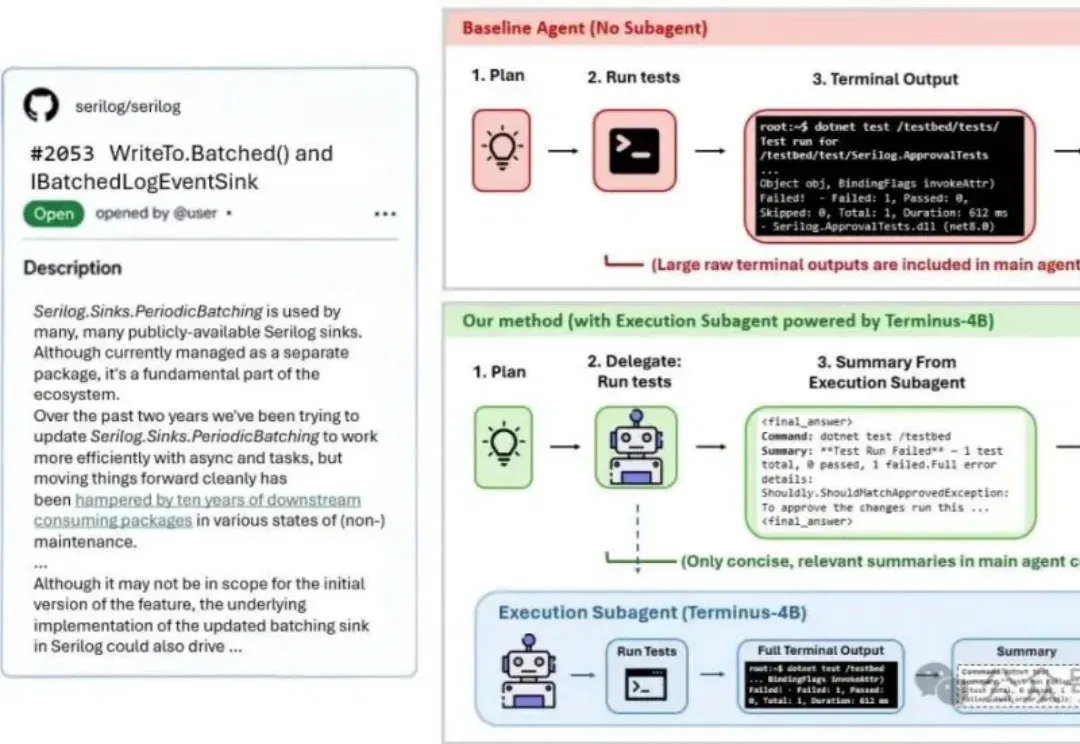
您有没有想过:在代码Agent里,执行终端命令、跑测试、读报错、总结日志这种任务,用Claude Opus、Claude Sonnet、GPT-5.3-Codex这类昂贵Token的大模型来执行,是不是有点浪费?一定要这么做吗?
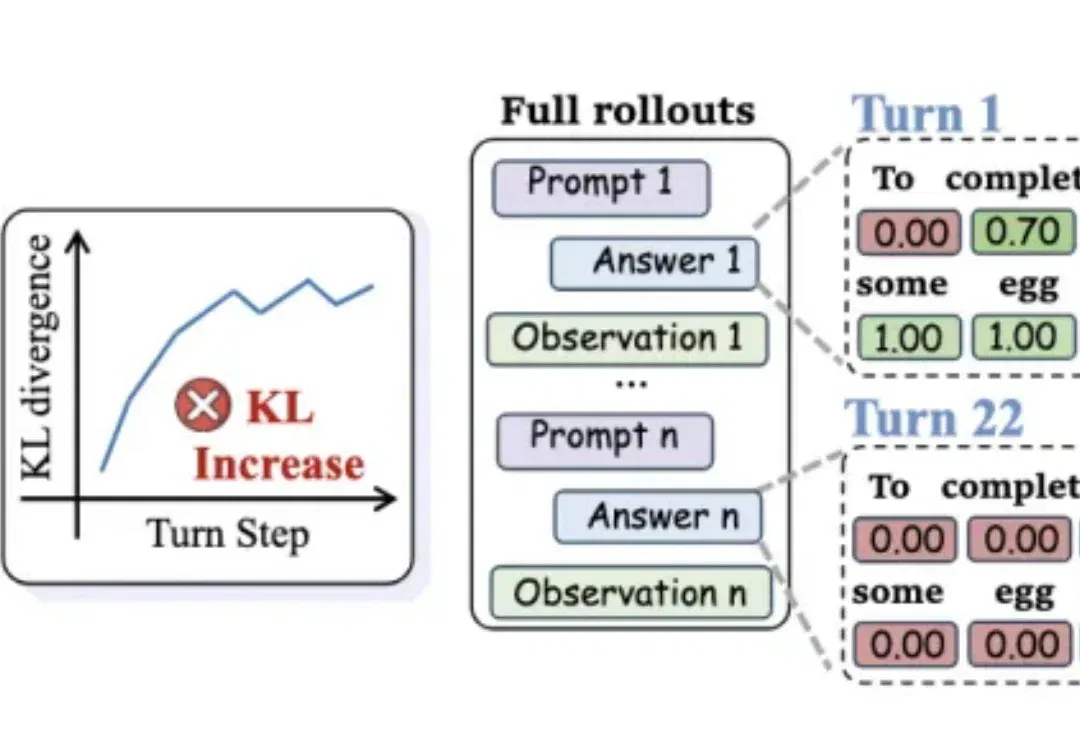
把强大模型的能力“蒸馏”给小模型,听起来很美—— 但放到多轮对话Agent场景里,效果往往一塌糊涂。
面壁智能2B小模型VoxCPM 2惊艳开源,一众外国网友疯狂了!30种语言与9大方言它是信手拈来,复刻的贺炜激昂解说与徐志胜脱口秀,相似度简直直击灵魂。这哪是工具,分明是降维打击的生产力核武器!
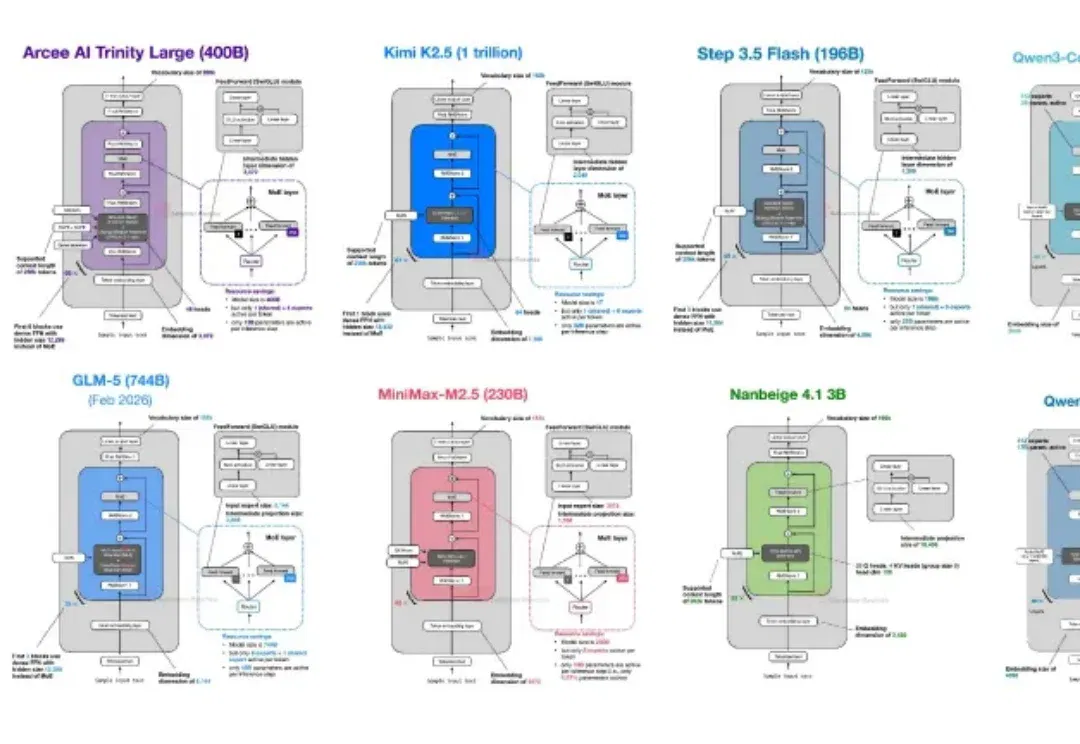
这两年,大模型大厂之间堪比军备竞赛。不论开源还是闭源阵营,为了在指标上领先对手,都在疯狂地卷 Scaling Law,卷算力,卷参数量,已经达到了近乎离谱的程度。
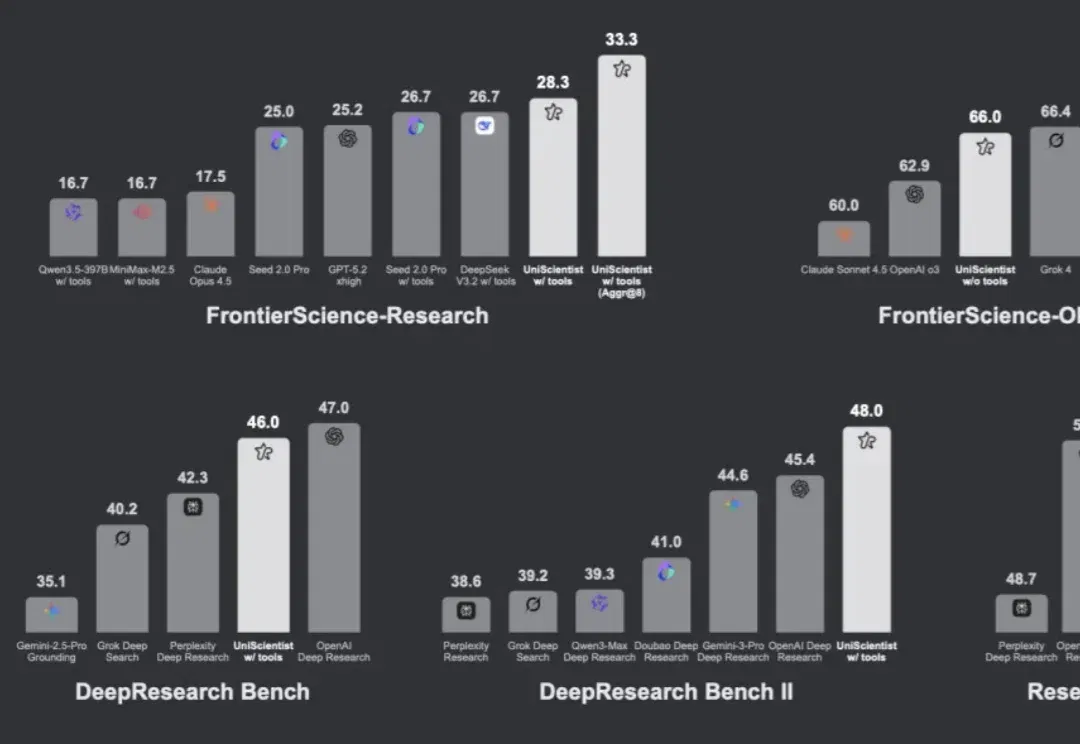
多数大模型能生成 “看起来像” 研究的文本,但极少数能真正做研究 —— 提出假设、收集证据、执行可复现的推导、迭代验证直至结论成立。
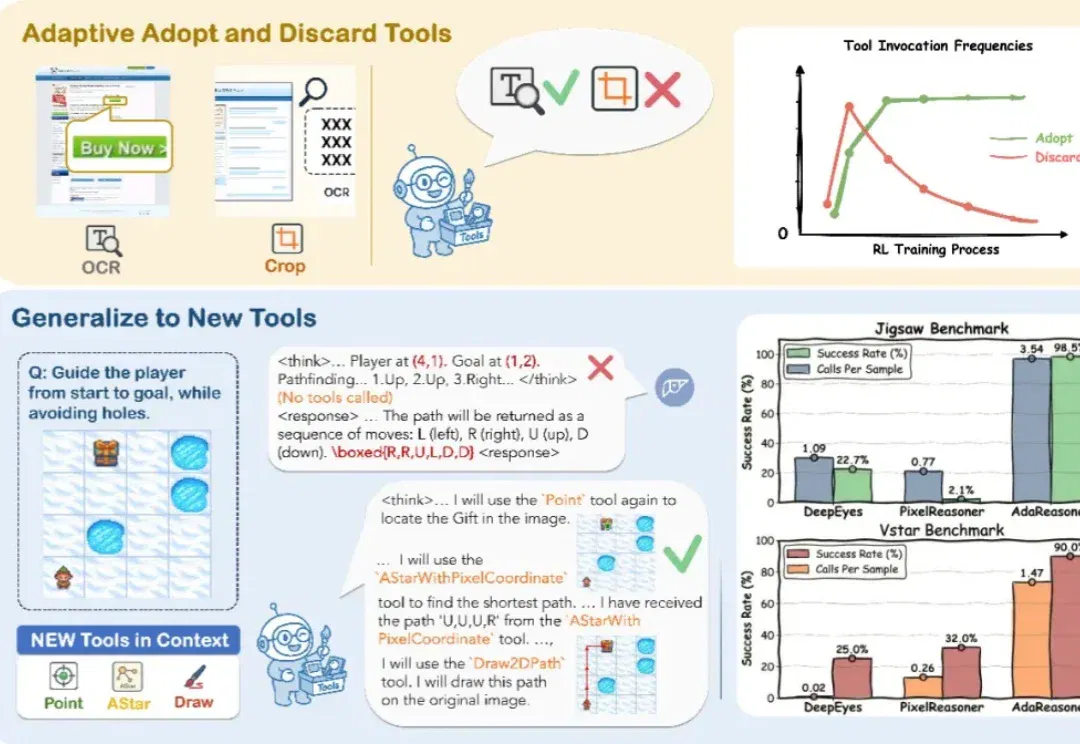
你见过 7B 模型在拼图推理上干翻 GPT-5 吗?
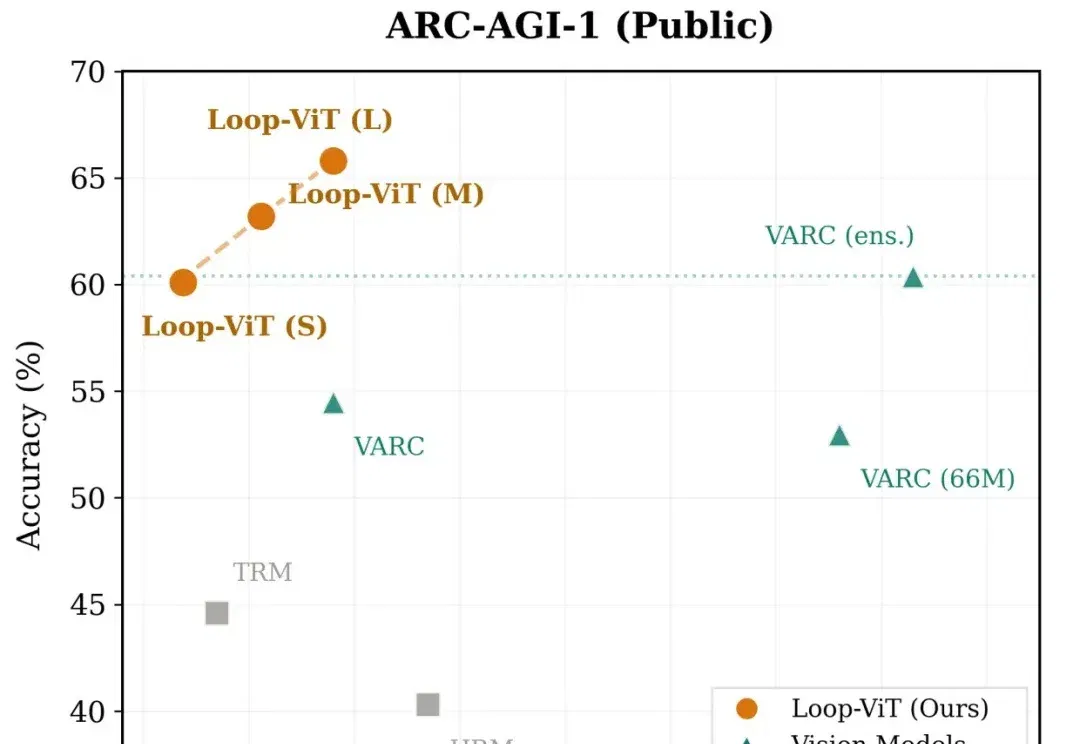
当我们解一道复杂的数学题或观察一幅抽象图案时,大脑往往需要反复思考、逐步推演。然而,当前主流的深度学习模型却走的是「一次通过」的路线——输入数据,经过固定层数的网络,直接输出答案。