DeepSeek-OCR是「长文本理解」未来方向吗?中科院新基准给出答案 (opens in a new tab)
DeepSeek-OCR的视觉文本压缩(VTC)技术通过将文本编码为视觉Token,实现高达10倍的压缩率,大幅降低大模型处理长文本的成本。但是,视觉语言模型能否理解压缩后的高密度信息?中科院自动化所等推出VTCBench基准测试,评估模型在视觉空间中的认知极限,包括信息检索、关联推理和长期记忆三大任务。
Total 619 articles
DeepSeek-OCR的视觉文本压缩(VTC)技术通过将文本编码为视觉Token,实现高达10倍的压缩率,大幅降低大模型处理长文本的成本。但是,视觉语言模型能否理解压缩后的高密度信息?中科院自动化所等推出VTCBench基准测试,评估模型在视觉空间中的认知极限,包括信息检索、关联推理和长期记忆三大任务。
今天,在 FORCE 原动力大会上,火山引擎发布豆包大模型1.8、豆包视频生成模型 Seedance 1.5 pro。经过一年多的持续升级,豆包大模型家族在多模态理解和生成能力、Agent 能力上,已位于全球第一梯队。
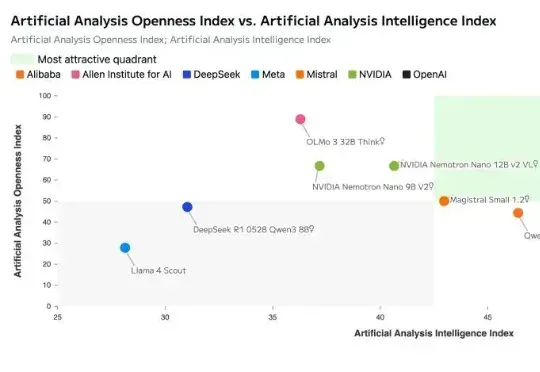
就在刚刚,英伟达正式开源发布了其新一代AI模型:NVIDIA Nemotron 3。Nemotron 3 系列由三种型号组成:Nano、Super 和 Ultra。官方介绍其具备强大的智能体、推理和对话能力。
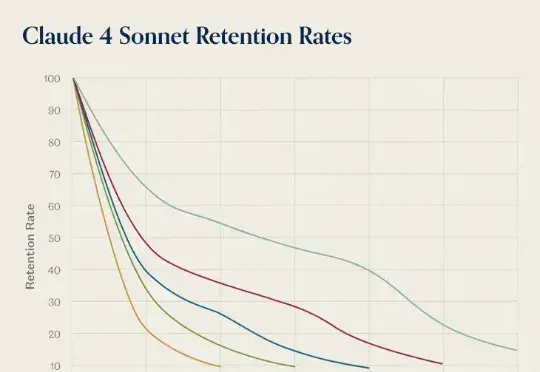
前几天,AI 推理服务供应商 OpenRouter 发布了一份报告《State of AI》,基于平台上 60 多家提供商的 300 多个模型,100 万亿个 token 的交互数据,对 LLM 的实际应用情况进行了分析。报告中,提到了一个「灰姑娘水晶鞋效应」,特别有意思。研究者在分析用户留用数据时发现一个现象:AI 模型发布第一个月进来的用户,往往比后来进来的用户留存率更高。
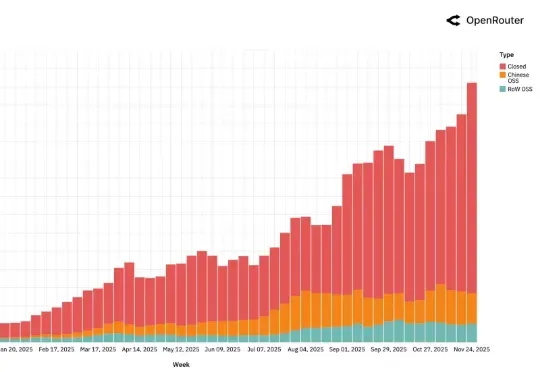
AI 领域迄今最大规模的用户行为实录,刚刚发布了。这是全球模型聚合平台 OpenRouter 联合硅谷顶级风投 a16z 发布的一份报告,基于全球 100 万亿次真实 API 调用、覆盖 300+款 AI 模型、60+家供应商、超过 50% 非美国用户 。
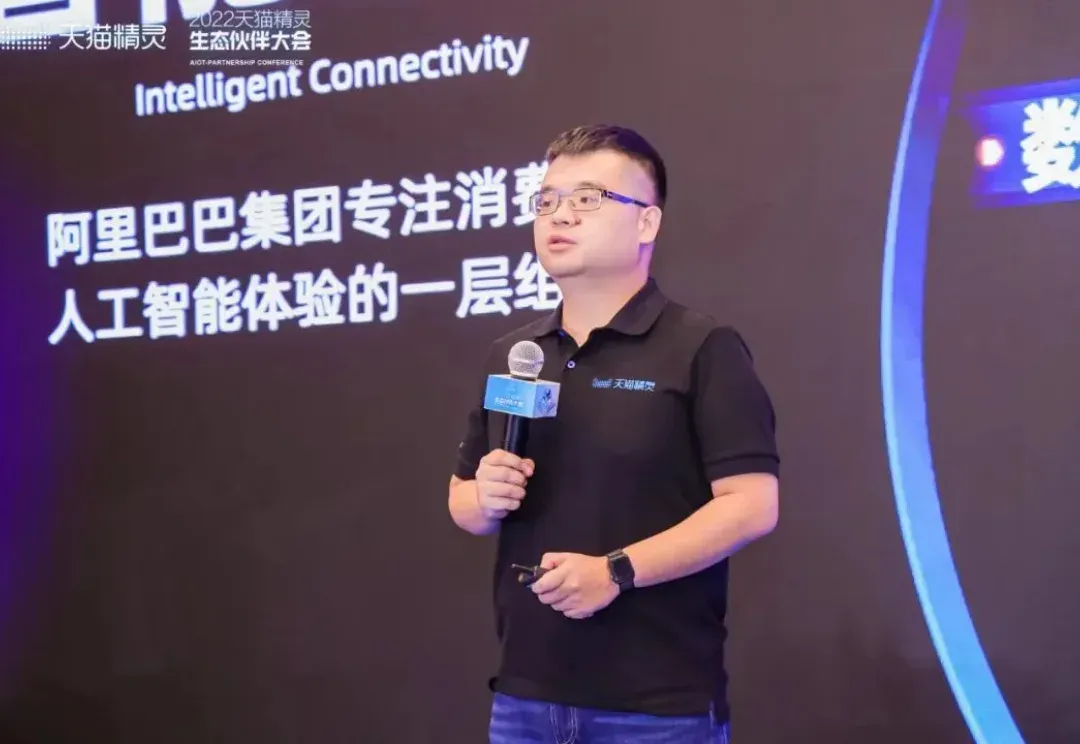
彭超曾在华为印度、阿里任消费硬件业务1号位;联合创始人齐炜祯为Multi-token架构开创学者,被Deepseek、Qwen引入预训练方法。
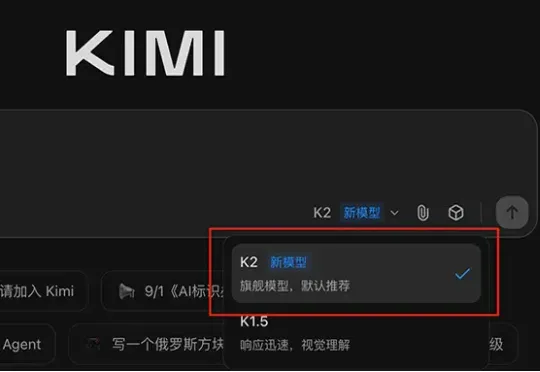
智东西9月5日消息,刚刚,大模型独角兽月之暗面发布新模型Kimi K2-0905,目前,Kimi应用和网页版中的K2模型已全量升级到Kimi K2-0905。该模型的核心升级点为Agentic Coding能力增强、支持256K上下文、API支持高达60-100Token/s的输出速度、支持Claude Code。
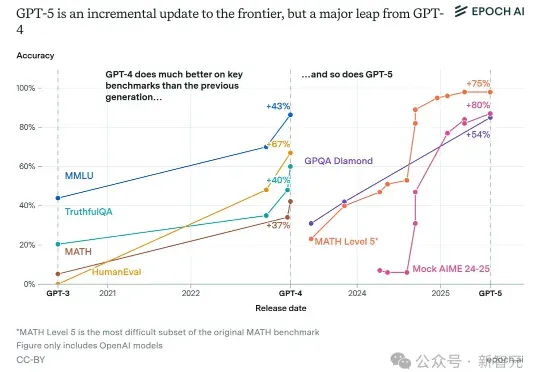
GPT-5背后的真正野心并非单纯追求性能,而是通过「自动路由」与「思考配额」开启「单位token经济学」。这一机制让高价值请求直连交易闭环,免费流量首次具备现金流。与此同时,顶级AI的普及让十亿人几乎零成本接触博士级智能,「大众智能」正在成新的历史拐点。
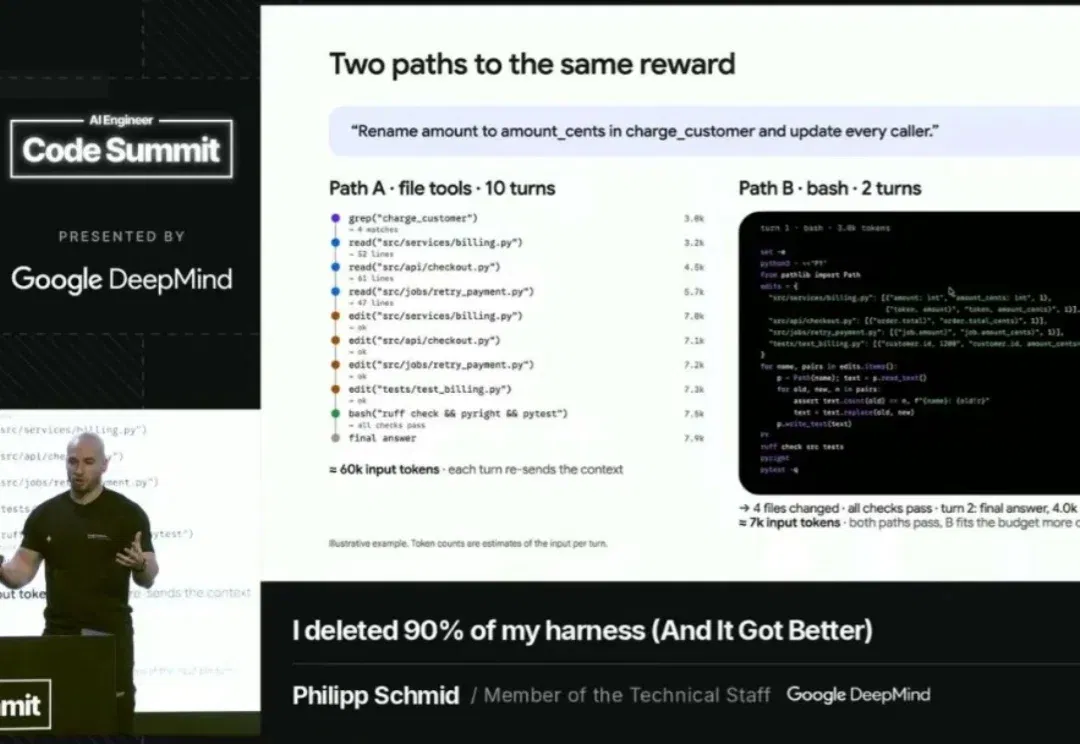
Philipp Schmid describes an agent using Bash and a media viewer. Across over 350 tasks, harness scores were close while tokens and costs differed. Each task ran once, so score differences still require repeated experiments.
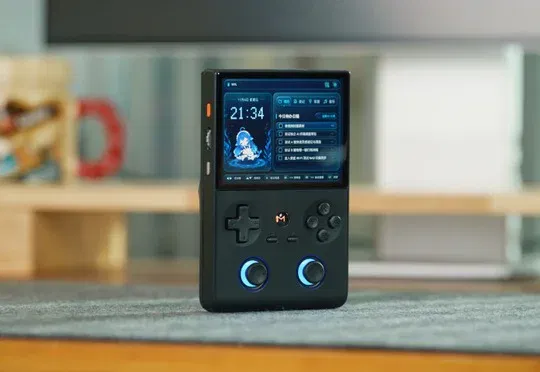
The author rebuilds a handheld around a Big Fat Fish character, voice input, meeting archives and Mijia controls. The project also exposes audio conflicts, button noise, clipped speech and excessive token use from camera polling.