百灵开源 Ling-3.1-flash-1019 与 Base,面向长上下文和智能体任务 (opens in a new tab)
蚂蚁百灵同步开放进一步后训练的 1019 版与基础权重 Base,前者聚焦复杂推理和多步骤工作流,后者供开发者继续训练。报道分别梳理两类模型的评测、混合线性 MoE 架构及部署方式,也指出更高任务成绩伴随着更多 Token 消耗。
Total 82 articles
蚂蚁百灵同步开放进一步后训练的 1019 版与基础权重 Base,前者聚焦复杂推理和多步骤工作流,后者供开发者继续训练。报道分别梳理两类模型的评测、混合线性 MoE 架构及部署方式,也指出更高任务成绩伴随着更多 Token 消耗。
无量火科技与高通联合发布移动端解决方案,Ember推理引擎让未经额外改动的30B大模型在手机运行且质量无损,并将MoE与Dense模型内存占用分别降低80%和50%。
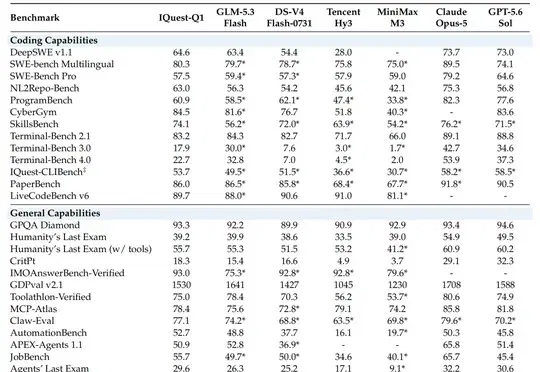
至知创新研究院公开IQuest-Q1完整技术报告,披露其采用320B总参数、15B激活参数的稀疏MoE架构,以29T Tokens和超100万个可执行任务训练,并通过三层机制防止奖励作弊,架构规模化效率达1.93倍。
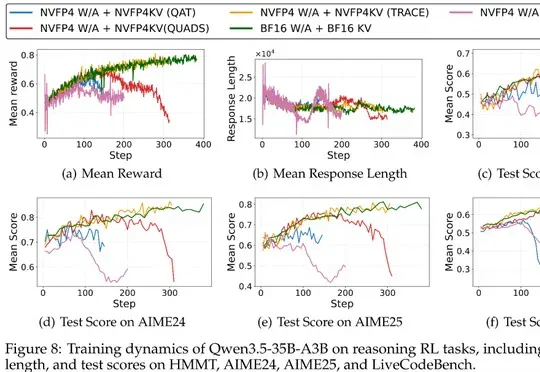
阿里千问联合俄亥俄州立大学提出TRACE,以Rollout侧FP4量化结果引导训练侧舍入,在四个Qwen MoE模型上保持接近BF16的性能,并使128K输出解码吞吐最高提升5.4倍。
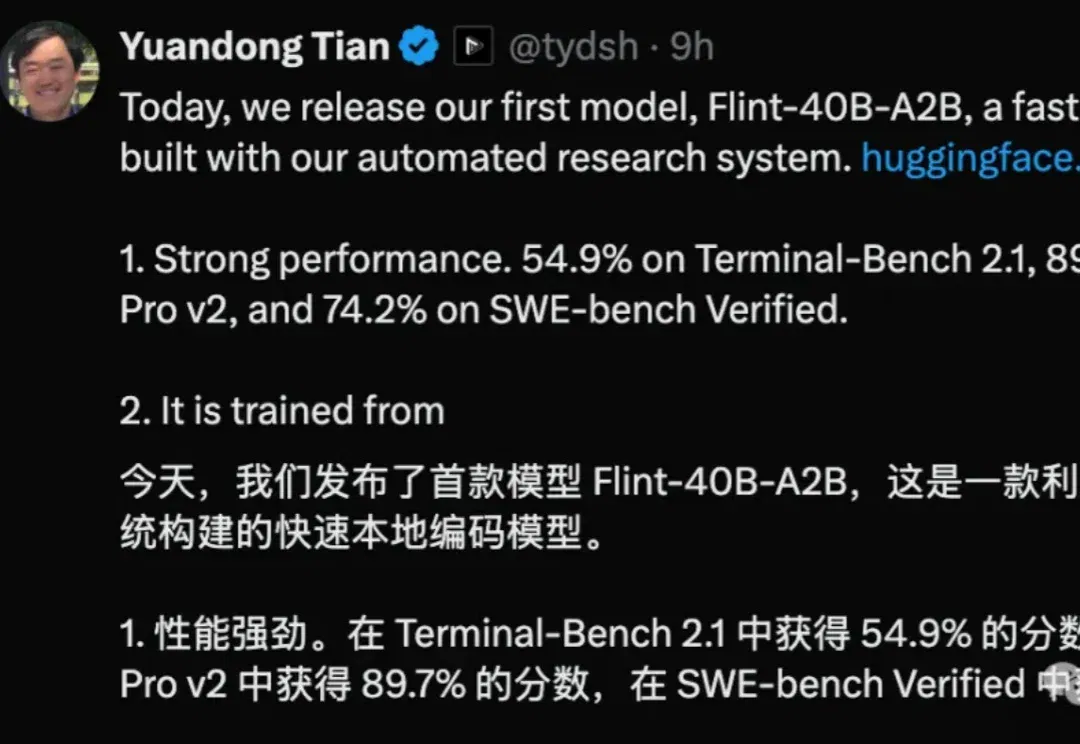
40B的MoE“程序员”,MacBook Pro就能带走了!
香港科技大学周子杰团队与华为 2012 实验室理论部提出 BalanceRoute,通过建模与短期负载预测减少 MoE 模型解码的跨组同步等待,其已部署于 MathBot-Pie,并在 96 张昇腾 910C NPU 实验中使解码吞吐提升约 15%。
什么?35B的MoE,在手机上也能跑得很丝滑?
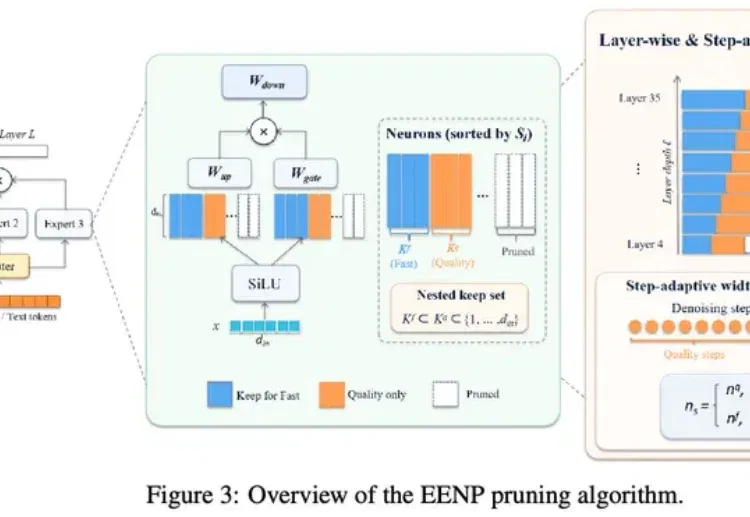
AI 视频越来越逼真,生成它的算力却并不便宜。复杂的动作、连贯的镜头和细腻的画面,背后都需要大量计算。一旦进入批量制作,反复生成、修改和重试的开销便会累积,成为创作者与视频平台必须考虑的成本。
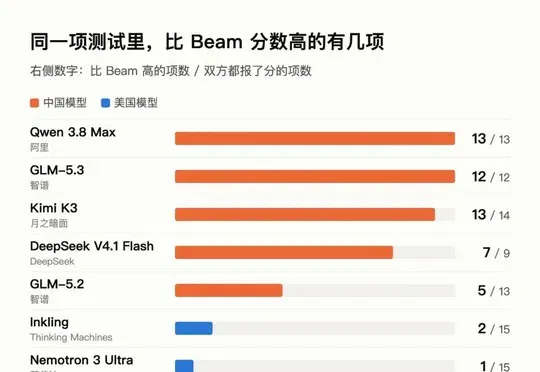
英伟达投资的Reflection发布开源模型Beam,采用MoE架构,专注代码、推理和Agent任务,官方称其以GLM-5.2三分之一至四分之一的推理算力取得相当成绩,但原始能力仍落后部分前沿开源模型,计划月底以Apache 2.0放出权重。
在2026骁龙峰会上,高通CEO安蒙发布第六代骁龙8至尊版双旗舰平台并强调行业正迈向意图驱动的智能体AI时代,联合中国企业在手机端侧部署300亿参数MoE模型,同时指出高通已拓展至PC、汽车、机器人和数据中心等业务,肯定中国企业的智能体创新速度。