美国开源的新希望,对标智谱的上一代模型
英伟达投资的Reflection发布开源模型Beam,采用MoE架构,专注代码、推理和Agent任务,官方称其以GLM-5.2三分之一至四分之一的推理算力取得相当成绩,但原始能力仍落后部分前沿开源模型,计划月底以Apache 2.0放出权重。
英伟达投资了一个叫 Reflection 的模型公司,发布了第一个开源模型 Beam,对标智谱的 GLM-5.2
官方说两者在高级推理测试上分数相当,Beam 的推理算力只要 5.2 的三分之一到四分之一
彭博和金融时报都表示:它是美国在开源模型领域,对中国的反击
但是呢,作为新选手...从目前成绩上来看,与国内头部的其他开源模型比如 qwen3.8/glm5.3/kimi k3/dsv4f 还是有一些差距的
Reflection 的背景
2024 年,谷歌 DeepMind 的两位研究员 Misha Laskin 和 Ioannis Antonoglou 出来创办了 Reflection,公司设在纽约布鲁克林
2025 年 3 月,Reflection 带着1.3 亿美元融资走出隐身,估值约 5.45 亿美元。7 个月后,它一轮融了20 亿美元,估值80 亿美元,英伟达、Eric Schmidt、红杉、光速和花旗都在投资人名单里。今年估值又涨到250 亿美元,累计融资约47 亿美元
Reflection 还签了两份算力合同:每月付 SpaceX 1.5 亿美元,租 Colossus 数据中心里的英伟达 GB300,一直租到 2029 年,合计63 亿美元;另和云厂商 Nebius 签了 10 亿美元以上
金融时报补充道:英伟达想扶起一批能和 OpenAI、Anthropic 抗衡的对手
Beam 用的是稀疏混合专家(MoE)结构:总参数 5010 亿,每生成一个词只调动其中 230 亿
它主攻写代码、推理和 Agent 任务,只处理文字。预训练用了 6144 张 GB300,不到四周;强化学习又用 1.05 万张 GB300 跑了四周,让模型做了超过 1 亿次任务尝试
BenchMark
Beam 的官方跑分表有 21 项测试、8 个开源模型。美国的另外两个:OpenAI 前 CTO Mira Murati 创办的 Thinking Machines 出的 Inkling,英伟达自家的 Nemotron 3 Ultra;中国的五个:智谱的 GLM-5.2 和 GLM-5.3、月之暗面的 Kimi K3、阿里的 Qwen 3.8 Max,以及 DeepSeek V4.1 Flash
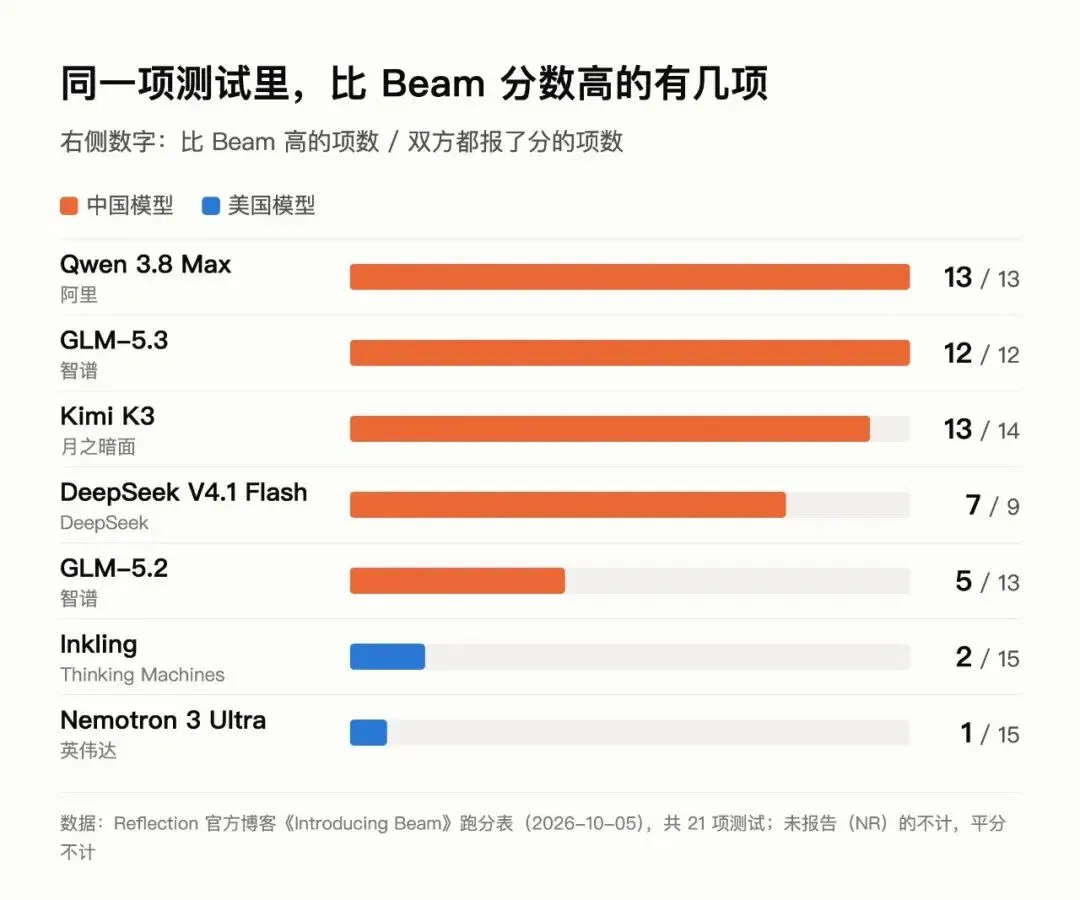
按官方跑分表统计,只计双方都报了分的项目
Reflection 自己说,Beam“推进了西方开源模型的前沿”,和 GLM-5.2 这类更大的开源模型“有竞争力”,在代码和 Agent 任务上“接近 Qwen 3.8-Max”;Kimi K3 这样的前沿开源模型“在原始能力上仍然领先”,Beam 的优势在推理时的效率
和 GLM-5.2 能对上分的 13 项里,Beam 赢 8 项、输 5 项。输掉的有推理组全部 4 项:AIME 2026、HLE、CritPt、GPQA,差距在 0.7 到 4.6 分之间
省在哪
Beam 面向企业客户和开发者,做编程和 Agent 任务。按彭博转述的公司说法,它的成本比许多竞品低
“3–4 倍”的省,按这个公式估算:生成算力 ≈ 2 × 激活参数 × 平均生成的 token 数。Beam 两个因子都低:
- 激活参数少:每个 token 只动 230 亿参数
- 话少:强化学习时加了长度惩罚,答对给奖励,多余的 token 扣分。训练前期,模型的回答越来越短,分数反而在涨
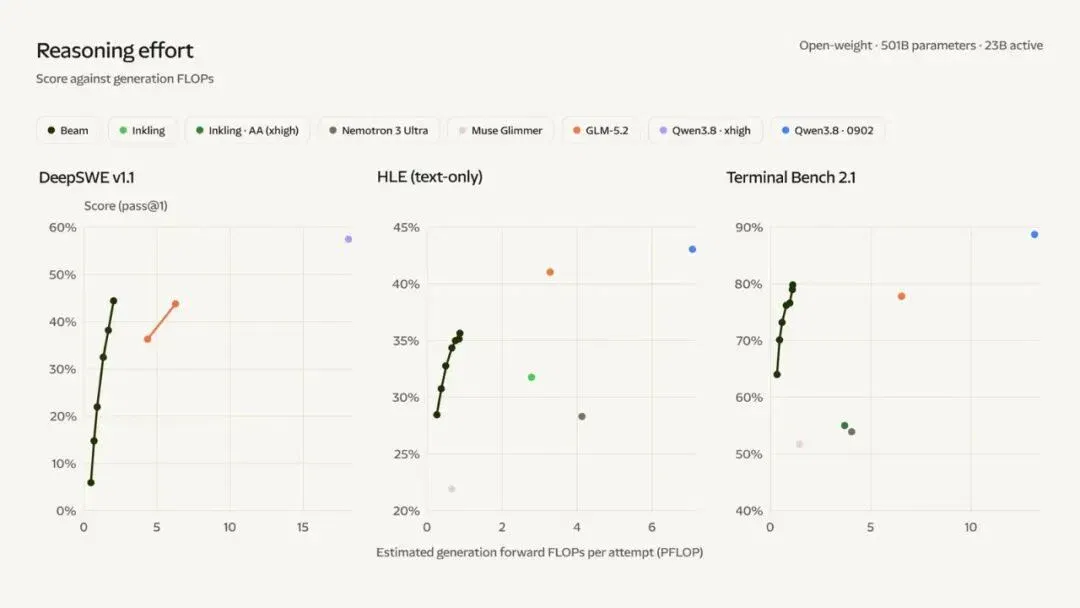
官方效率图,横轴是估算的算力
提示词预填充、注意力计算和服务开销都没算进去,按官方的说法,这“是近似的算力比较,不是实测的推理成本”。截至发文时,Beam 的 API 价格还没公布
效率图里对比的中国模型是 GLM-5.2 和 Qwen3.8
谁会买单
硅谷风投 a16z 的合伙人 Martin Casado 去年说过,来融资的创业公司“八成在用中国开源模型”。后来他自己更正了口径:两到三成的创业公司用开源模型,这里面约八成用中国的
Laskin 把用闭源模型比作租房:“想拥有智能,按定义,它就只能是开源的”
2025 年初 DeepSeek 爆火,美国海军随即要求“任何情况下”都不得使用,理由是模型“来源与使用相关的潜在安全和伦理问题”;NASA、五角大楼、商务部也先后在工作设备上屏蔽了 DeepSeek
Reflection 的客户和合作方:
- 今年 5 月起给美国能源部的“创世纪计划”供模型,做国家实验室的模型供应商
- 和美国战争部(原国防部)合作
- 目标客户还有大企业、主权国家、对冲基金和交易公司
- 在韩国和新世界集团签了 250 兆瓦数据中心的备忘录
Reflection 给这些客户搭“AI 工厂”:在客户本地建一套 AI 系统,用客户自己的私有数据训练
权重呢?
还没放,但承诺开源
Beam 还在做最后的红队测试和评估,想用得先去官网排候补名单。Reflection 计划这个月晚些时候放出权重、技术报告和模型卡,许可证用 Apache 2.0,可以商用、可以随便改
英国 AI 安全研究所(AISI)和美国的 CAISSI(原 CAISI)也在参与评估
Beam 放出了四段演示:纽约地铁实时地图、给 Gemma-4 写微调脚本、陆地海洋格点测试,还有一个 3D 小游戏,宇航员朝地球自由落体,一路躲陨石,或者用“beams”把它们打碎
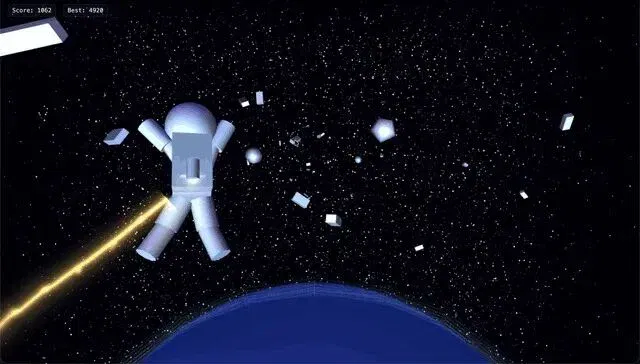
官方演示:Beam 用 p5.js 写的 3D 小游戏
Reflection 说,Beam 只是一个系列的第一个,下一个已经在训了
文章来自于微信公众号 “赛博禅心”,作者 “赛博禅心”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
老黄押宝「美版DeepSeek」!谷歌天才叛将创业,一夜吸金20亿美元 (opens in a new tab)
刚刚,DeepMind前研究员创立、成立一年多的AI初创Reflection AI,竟斩获高达20亿美元融资。估值瞬间飙升至80亿美元!从谷歌前CEO施密特到英伟达,再到红杉、花旗,顶级玩家争相入局,一场围绕开源AI主权的科技冷战,正在燃起资本最狂热的火焰。

姜宇辉的AI分身:知识助手与“另一个自己”之间 (opens in a new tab)
南方周末通过学者、用户与Second Me创始人的访谈及记者试用,观察AI分身的学术辅助、情感连接和商业化尝试,也呈现知识可靠性、人格边界、版权与隐私方面的疑虑。

智动未来据报完成亿元级Pre-A+融资,资金用于产线与服务机器人部署 (opens in a new tab)
机甲觉醒报道,智动未来宣布完成亿元级Pre-A+轮融资,由中美绿色基金领投、南曦创投联合领投,资金拟用于广州产线、服务场景部署和世界模型研发。“智子世界”仍属技术预览,商业化效果待更多应用数据检验。

范式智能介绍Phai-A1与Phai-M1,强调国产算力后训练优化 (opens in a new tab)
范式智能介绍面向代码与Agent场景的Phai-A1,以及面向真人影视的音画同步模型Phai-M1。公司展示了单卡运行和视频生成能力,并称模型在昇腾平台完成专项后训练优化。

腾讯Q3资本开支814亿元,称WorkBuddy日Token用量居国内首位 (opens in a new tab)
腾讯三季报显示营收2073.36亿元、资本开支814.33亿元。公司称WorkBuddy日活超1000万,按用户每日大语言模型Token消耗总量居国内首位;报道还讨论云业务增收与AI投入对盈利、现金流的影响。