腾讯混元发布科研智能体Hyra(Hunyuan Research Agent),刷新多项纪录,参与下一代Hy模型迭代 (opens in a new tab)
今天,腾讯正式发布了其首个研究智能体(Research Agent)——Hyra(Hunyuan Research Agent)。Hyra能够像科研人员一样,提出假设、完成实验、总结经验,再基于经验不断提出新的方案,最终实现递归自我改进(Recursive Self-Improvement,RSI)。
Total 48 articles
今天,腾讯正式发布了其首个研究智能体(Research Agent)——Hyra(Hunyuan Research Agent)。Hyra能够像科研人员一样,提出假设、完成实验、总结经验,再基于经验不断提出新的方案,最终实现递归自我改进(Recursive Self-Improvement,RSI)。
在 AGI-Next 前沿峰会上,腾讯姚顺雨举了一个很生活化的例子:当你问 AI “今天吃什么” 时,真正限制答案质量的,可能不是模型不够大,也不是推理不够强,而是它不知道你今天冷不冷、想不想吃热的、最近和朋友聊过什么、家人又有什么偏好需要纳入考虑。
2023年启动大模型研发以来,腾讯第一次把大语言模型变成一把手工程,负责人是个27岁的年轻人;
腾讯混元大模型团队正式发布并开源HunyuanVideo 1.5。
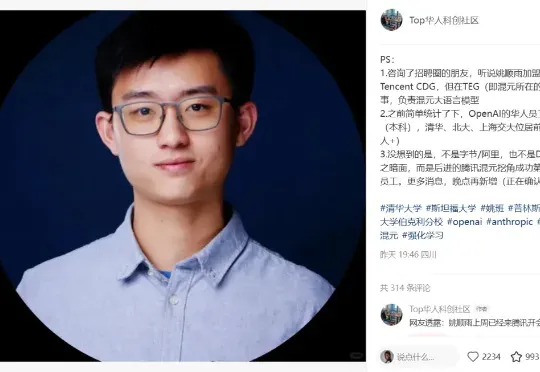
昨天,有消息称,OpenAI 著名研究者、清华校友、著名博客《AI 下半场》的作者姚顺雨已经加入了腾讯混元大模型团队,并且还传言说他将在这里组建一支自己领导的研究团队。
说实话,最近我们都已经看腻了美国AI公司Agent「失控」的新闻了。
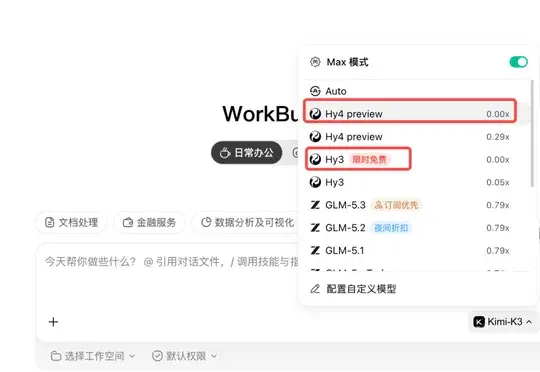
AI博主在WorkBuddy中实测腾讯混元Hy4 preview,通过研究检索、Excel+PPT交付、播客报价系统和3D小游戏四个办公场景验证其能力,认为该模型在长程任务中对信息冲突与规则歧义的审慎处理是其核心亮点,适合作为办公搭子。
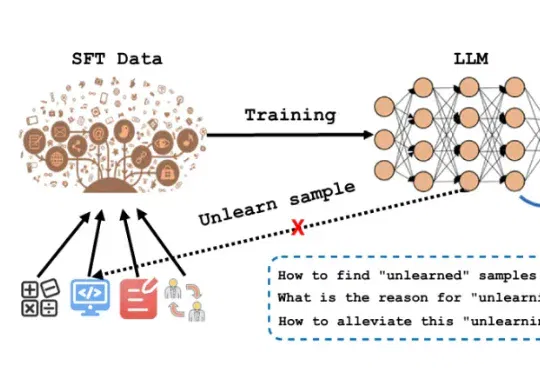
SFT是LLM从“通才”变成“专才”的关键步骤。业界默认做法是:准备标注数据(QA对、指令-回复对等)在基座模型上跑SFT训练。看loss曲线收敛了→认为训练完成。但问题在于:loss是全局平均,掩盖了样本间的差异。loss收敛只代表“大部分样本学会了”——那些始终学不会的样本被淹没了。
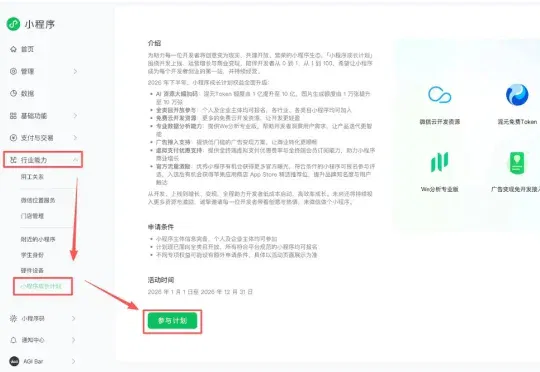
昨天,腾讯混元 Hy3 正式版上线,小程序更新了「成长计划」:小程序开发者的可以获得 10 亿的文本 Token,和 10 万张生图额度→ 10 亿 token 按官方 API 价折算,约 1000~4000 块
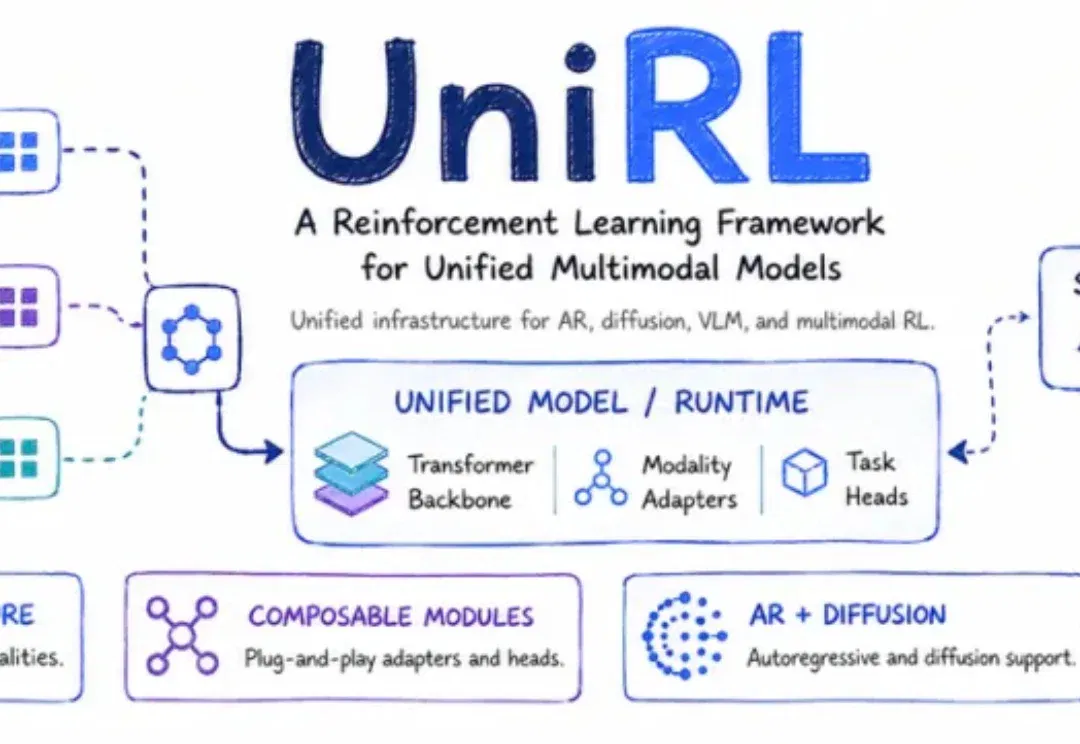
大语言模型的RL技术已日趋成熟,多模态生成模型的强化学习训练却仍在“各自为战”——图像扩散模型一套流程、视频生成另一套标准、VLM和LLM又有不同的技术栈。