Search

Results for “后训练”

Total 126 articles

AI人才3次大迁徙:百度被疯抢、六小虎分化、腾讯「腾笼换鸟」

AI人才3次大迁徙:百度被疯抢、六小虎分化、腾讯「腾笼换鸟」 (opens in a new tab)

“这些人在往哪跑?为什么跑” “大模型浪潮狂飙三年半,国内AI人才也经历了三波大迁移。”资深科技猎头赵捷告诉雷峰网。 前两年,大家抢的是预训练人才,先是百度文心团队被疯抢,然后是AI六小虎人才遭遇瓜分,紧接着又是阿里、DeepSeek、字节、腾讯之间的人才大混战。 而现在,大家又开始抢推理、Agent等后训练人才;最近一年不少预训练人才,如Qwen Code负责人惠彬原、混元大语言模型预训练负责人姚星丞、混元多模态理解预训练负责人彭厚文,字节Seed核心专家顾全全等陆续离职,要么创业,要么流向更纯粹的AI研究团队。 是什么促成了这一轮轮AI人才大迁徙?这背后又藏着哪些AI行业更深层的逻辑转变?
AI news
0
22.9倍加速!FlashAR:仅用0.05%数据,让预训练好的自回归图像模型飞起来

22.9倍加速!FlashAR:仅用0.05%数据,让预训练好的自回归图像模型飞起来 (opens in a new tab)

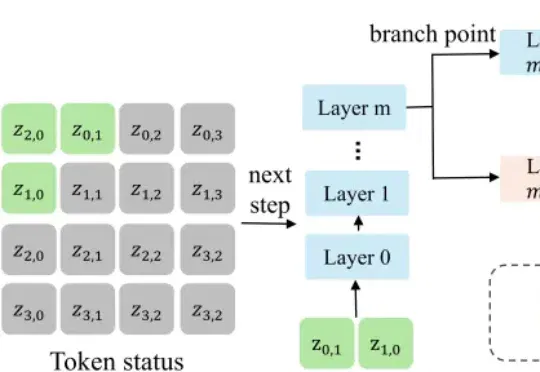
来自浙江大学和阿德莱德大学的研究团队提出了 FlashAR—— 一个轻量级的后训练加速框架。不需要从头训练,在 Emu3.5-Image-34B 模型上,仅用原始训练数据的 0.05%(约 8 万张图片),就能将预训练好的自回归模型改造成高度并行的生成器 Emu3.5-34B-Flash,实现最高 22.9 倍的端到端加速。

AI guides
0
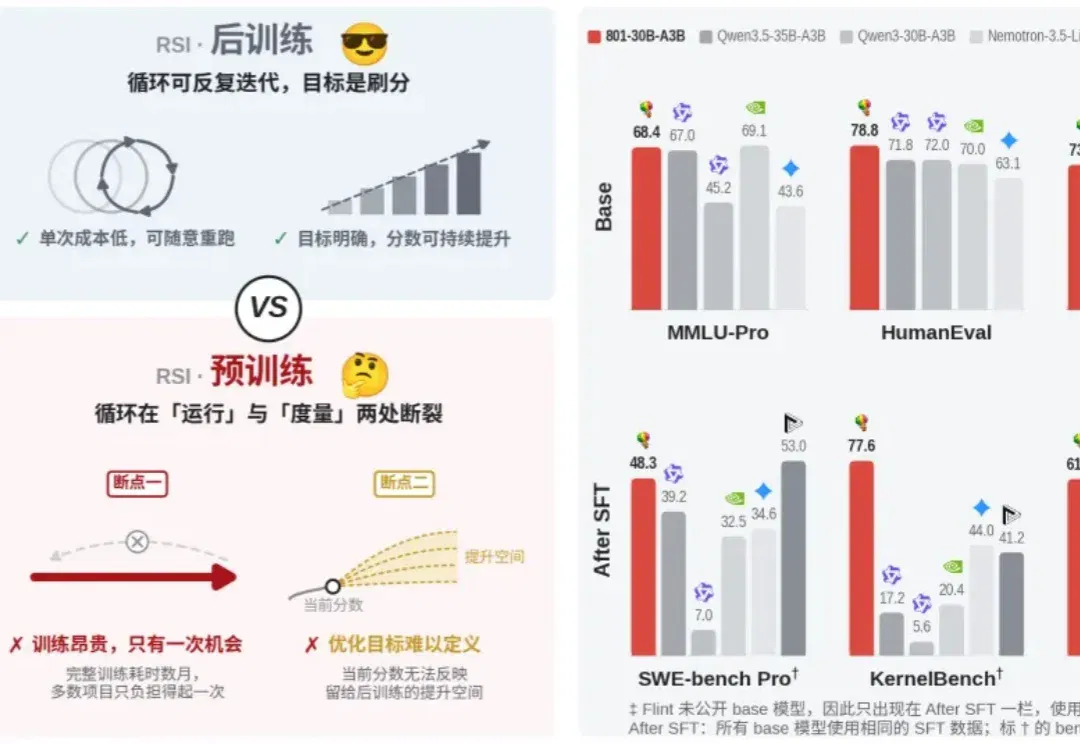
国产RSI模型交卷!Flash模型靠它反打旗舰

国产RSI模型交卷!Flash模型靠它反打旗舰 (opens in a new tab)

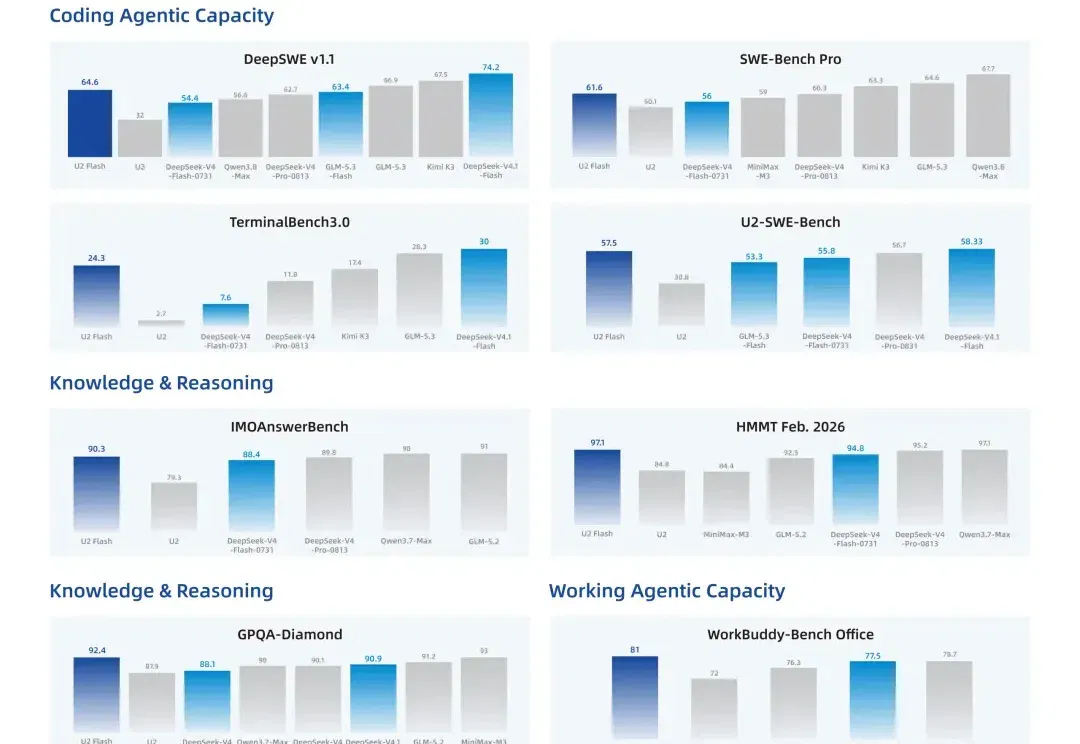
RSI,彻底火了。 从硅谷一路烧到国内,「让模型参与训练下一版自己」几乎一夜之间成了AI圈最热的叙事。 不过热闹归热闹,目前真正拿模型交卷的还屈指可数。 而就在这一当口,「港股AGI第一股」云知声正式发布U2-Flash,率先交出一份国产RSI早期答卷。 △图源:云知声 在U2-Flash的后训练闭环里,模型已经开始深度参与自身演进: 从生成训练数据、分析执行轨迹,到巡检和修复训练系统。 然后,反常识的部分来了。 按行业惯例,Flash一般默认是「旗舰平替」,通常更快、更便宜,但能力相对打折。 结果U2-Flash呢? 速度和省钱能力的提升确实没含糊。相比U2,其生成速度提升2.1倍,Agen

AI guides
0
ICML 2026 | 华为GTS提出AI训练数据新方法,Amazon/Google作者团队「光速跟进」:难度自适应训练正在成为新范式

ICML 2026 | 华为GTS提出AI训练数据新方法,Amazon/Google作者团队「光速跟进」:难度自适应训练正在成为新范式 (opens in a new tab)

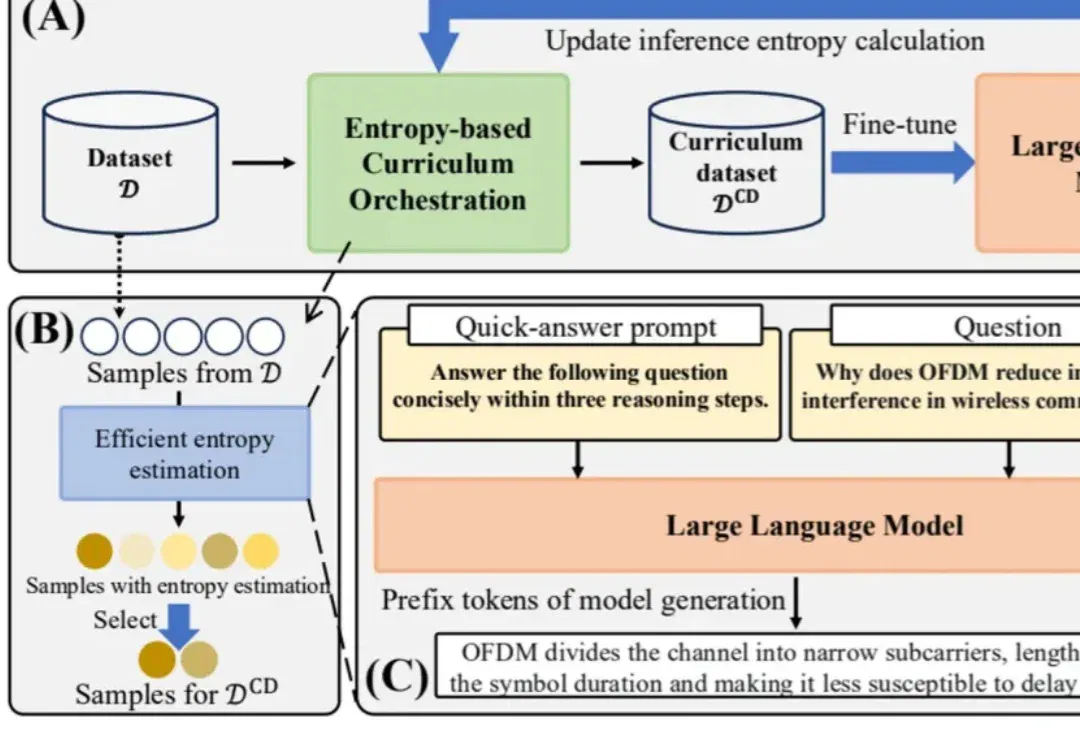
在大模型后训练中,数据不再只是 “越多越好”,而是要像人类学习一样,动态选择最合适难度的样本。华为提出的 EDCO 方法,将样本难度估计与动态课程编排引入领域大模型微调;数月后,由 Rutgers、Amazon、Google 等作者参与的 DARE 论文即引用 EDCO,并将其作为难度感知强化学习训练的重要对比基线。

AI guides
0