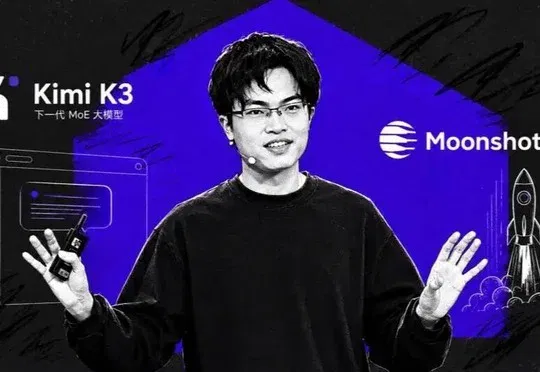
Kimi商业和模型都想要,但卡是有限的 (opens in a new tab)
月之暗面发布2.8万亿参数后训练模型Kimi K3.1 Pro,其综合智能指数领先DeepSeek V4.1 Flash-1017和MiniMax M3.1 Flash,但API费用最高,并正研发Flash版本以平衡能力、成本与商业化。
Total 530 articles
月之暗面发布2.8万亿参数后训练模型Kimi K3.1 Pro,其综合智能指数领先DeepSeek V4.1 Flash-1017和MiniMax M3.1 Flash,但API费用最高,并正研发Flash版本以平衡能力、成本与商业化。
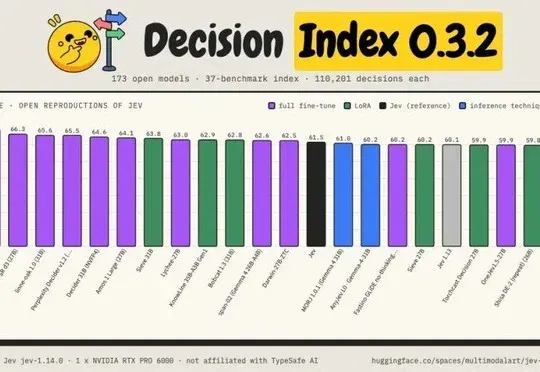
StartLux(原点星辉)开源首款面向决策模型的推理引擎Prism,实测同一材料连续处理三道问题最高提速5.3倍,单题平均延迟为41毫秒。
据路透社、彭博社和《华尔街日报》报道,DeepSeek约1000亿元第二轮融资涉及超过15家投资方,宁德时代和腾讯为最大投资方,兆易创新、美团、吉利、美的等亦参与。
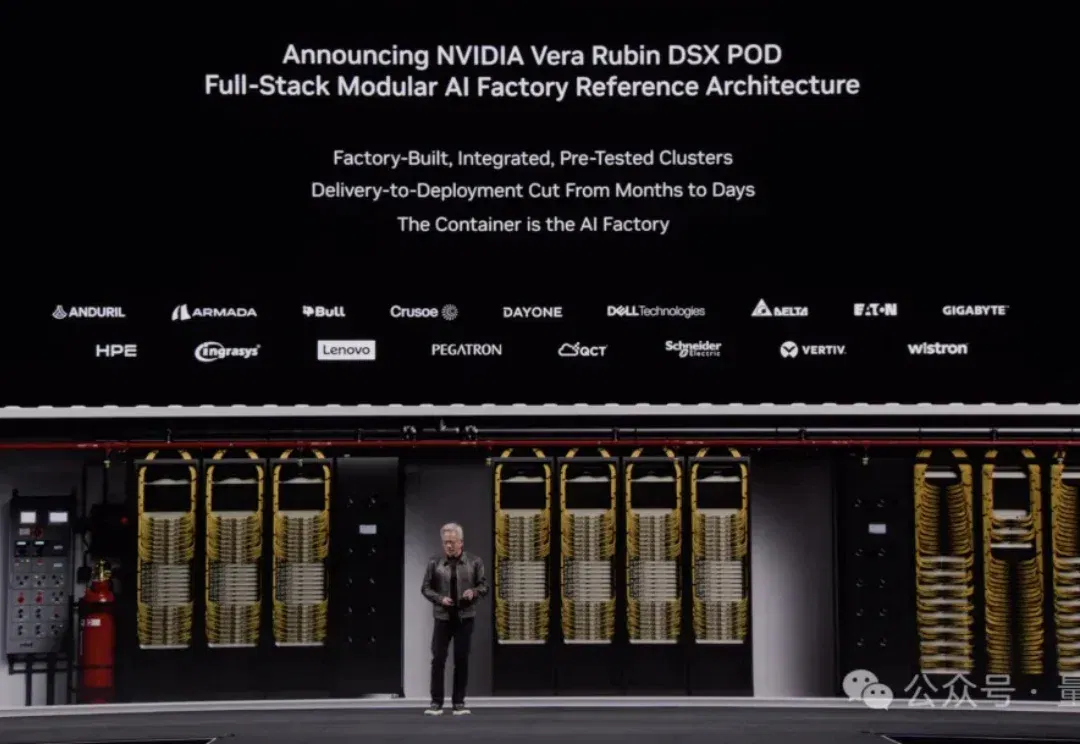
好了好了这下坏了,黄仁勋接住梁文锋的招了。
价格卷过DeepSeek Flash。 最近新模型扎堆上线,都挑不过来先测哪一个了。 昨晚还在折腾参加云栖大会时领的10块钱MIMO免费额度,选的是一个网站复刻任务,给它参考站,让它自己研究页面结构和效果,再在本地做出一个能运行的版本。 首轮输出的整体表现不算理想,原本计划在今天继续补这个案例,结果GPT-6 Sol和Luna来了,于是干脆换模型继续测。 而且这次OpenAI自己给出的重点也很明确。GPT-6 Sol的API输入价格是每百万token 2美元,输出10美元。 GPT-6 Luna更低,输入只要0.1美元,输出0.5美元。两者都比对应的GPT-5.6价格低了一半。 Luna也因此
DeepSeek正训练约2万亿参数的新模型,并计划将后续模型参数规模进一步推至8万亿,加入新一轮超大参数模型竞赛。
大模型训练拼的是算力,Agent训练拼的是环境。
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。
开源智能体项目Orbital主张"Context is yours",通过将散乱会话和记忆总结为可迁移的项目记忆,帮助用户拿回被大厂Agent锁死的上下文资产,并配合观猹推出的Tokendance模型钱包,实现DeepSeek、GLM、Kimi等70多个模型用量的透明化管理。
Anthropic的Opus 5.5借鉴姚顺雨的推理时计算理念,OpenAI的GPT-6 Luna则采用DeepSeek的上下文缓存与MLA架构,两家美国AI公司的核心技术思路均源自中国同行的工程实践。