华为大模型双子星联手创业,息壤开物要找物理世界的Scaling Law (opens in a new tab)
前华为云盘古大模型CTO李寅与多模态首席科学家张含望联合创立的息壤开物宣布完成数亿元种子轮及天使轮融资(估值5亿美金),旨在训练面向物理世界的大物理模型(LPM),寻找物理世界的Scaling Law。
Total 111 articles
前华为云盘古大模型CTO李寅与多模态首席科学家张含望联合创立的息壤开物宣布完成数亿元种子轮及天使轮融资(估值5亿美金),旨在训练面向物理世界的大物理模型(LPM),寻找物理世界的Scaling Law。
Scaling Law还在,但今天的大模型,已经不能只靠“参数量”来理解Scaling了。
今天,小米刚刚扔出一颗“深水炸弹”——Xiaomi-Robotics-1具身基座模型,试图改变这一局面。Xiaomi-Robotics-1基于10万小时真实世界操作轨迹进行预训练,再用约1.1万小时跨本体数据完成后训练。据悉,这是国内首次在机器人策略模型中,对Scaling Law进行较为完整的系统验证。
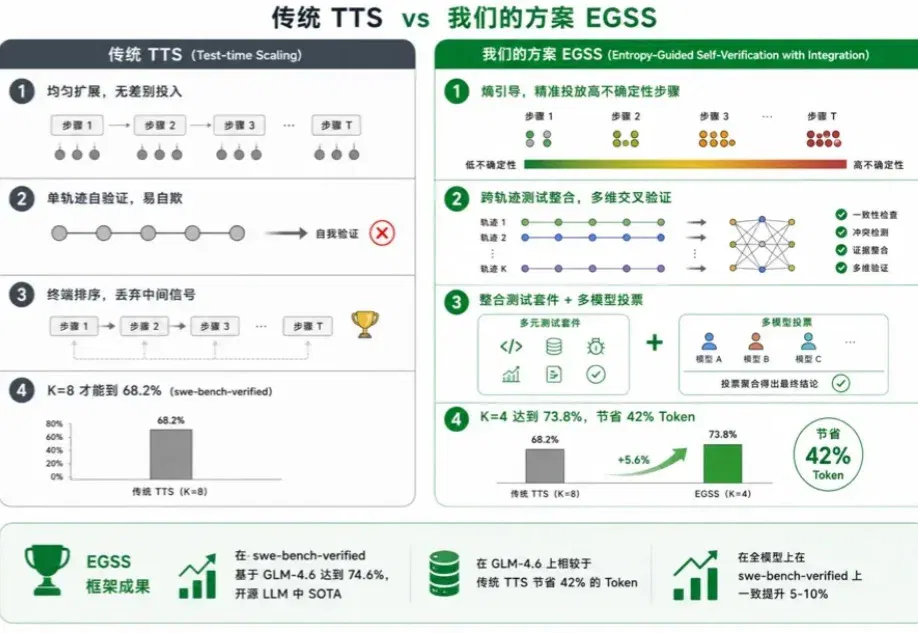
更聪明的计算远比更多的计算更有效。 这正是蚂蚁集团CodeFuse团队,用一篇ACL 2026主会论文验证的核心结论。 Test-Time Scaling(TTS)是通过在推理阶段投入更多计算资源,让Agent多次尝试、探索不同推理路径再选最优的关键范式,是当前LLM在复杂任务上取得SOTA的核心方法。 然而业界主流TTS方法对所有推理步骤一视同仁地投入计算,大量Token浪费在确定性操作上,且多轨迹选择仅靠“谁得票多”,Agent自我验证通过率88%中却有35.7%是错的—— 投入翻倍,收益边际递减。 针对这一现状,蚂蚁集团CodeFuse团队提出EGSS: 通过“工具熵”指标精准识别高不确
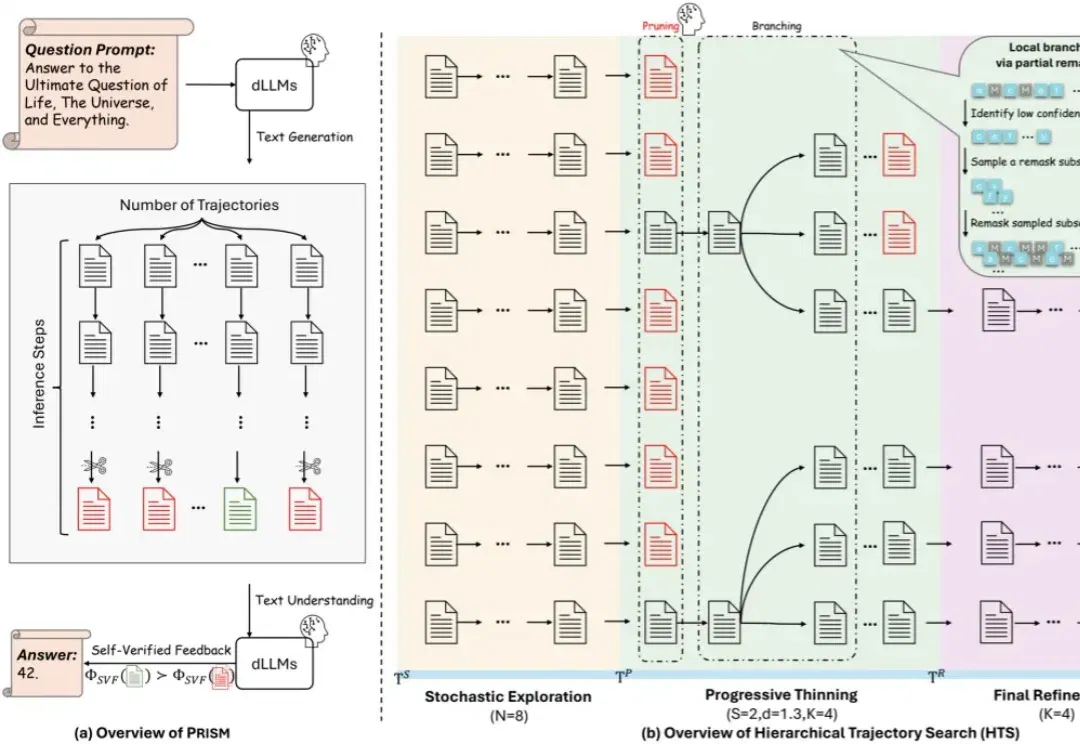
近年来,大模型能力提升的焦点正在从「训练时扩展」转向「推理时扩展」。从 Best-of-N、Self-Consistency 到更复杂的搜索与验证框架,Test-Time Scaling 已经成为提升大模型复杂推理能力的重要范式。
就在这一背景下,银河通用联合清华北大英伟达等众多机构联合发布了跨本体「隐式世界-动作基础模型」LDA-1B,将目光投向了具身智能 Scaling Law 的这个终极命题:如何让模型有效利用互联网规模的异构数据。
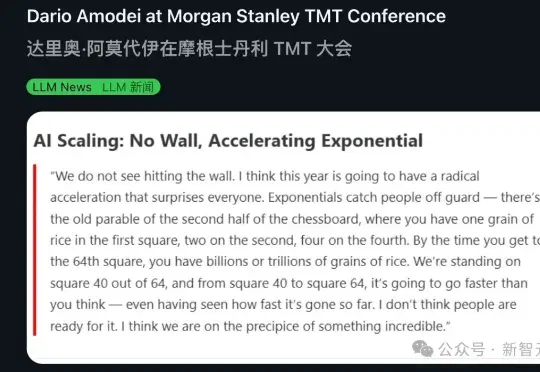
Anthropic CEO Dario Amodei在摩根士丹利会议上扔出一颗深水炸弹:Scaling Law根本没撞墙,2026年将迎来激进加速。他用棋盘稻米寓言做了个精准比喻——我们正站在第40格,前39格的所有震撼加在一起,不过是后24格的零头。这场指数级狂飙,没人准备好。
Ilya重磅访谈放出!1个半小时,全程2万字,他爆出惊人观点:Scaling时代已终结,我们正走向研究时代。
很多人认为,Scaling Law 正在面临收益递减,因此继续扩大计算规模训练模型的做法正在被质疑。最近的观察给出了不一样的结论。研究发现,哪怕模型在「单步任务」上的准确率提升越来越慢,这些小小的进步叠加起来,也能让模型完成的任务长度实现「指数级增长」,而这一点可能在现实中更有经济价值。
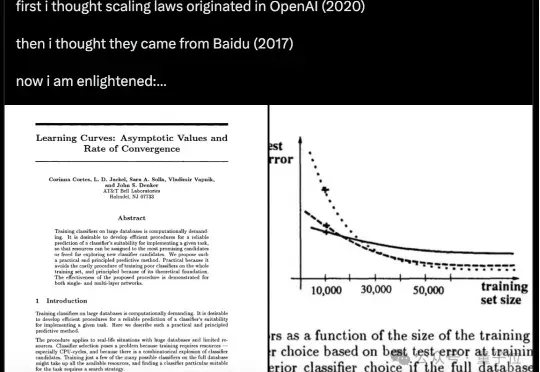
原来,Scaling Law在32年前就被提出了! 不是2020年的OpenAI、不是2017年的百度,而是1993年的贝尔实验室。