智谱唐杰:大模型只看参数的时代,结束了
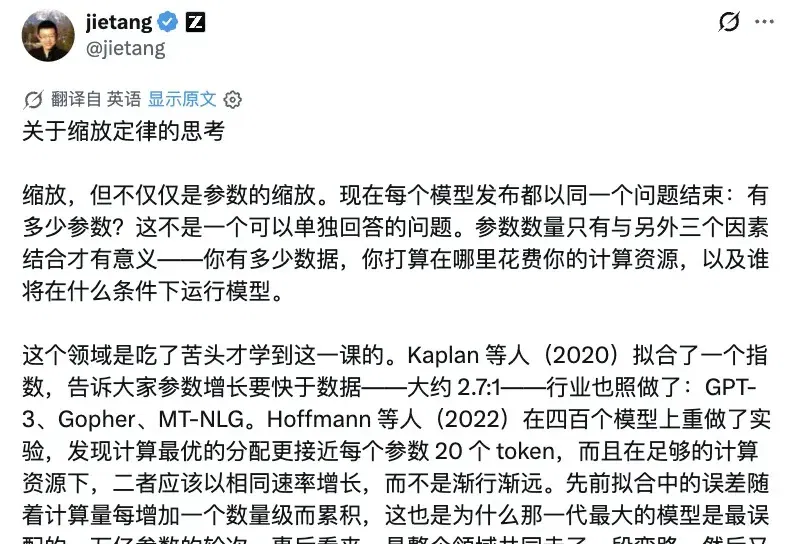
Scaling Law还在,但今天的大模型,已经不能只靠“参数量”来理解Scaling了。
Scaling Law还在,但今天的大模型,已经不能只靠“参数量”来理解Scaling了。
这是智谱创始人、清华大学教授唐杰对于Scaling Law的最新判断。
他在X上发表的一则有关Thoughts About Scaling Law的帖子,开头便把大模型发布会上最常见的那个问题拆了——
Scaling,但Scaling的不只是参数。
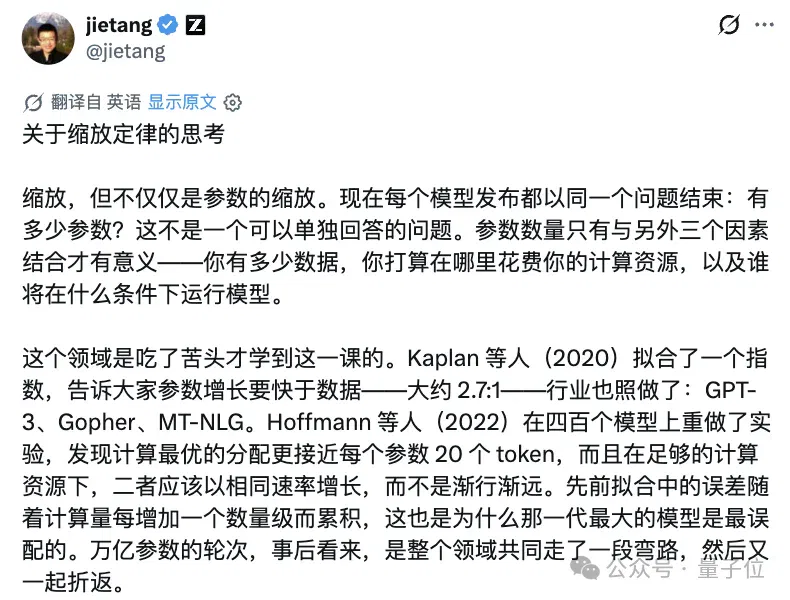
在唐杰看来,单独报出参数量,已经很难说明一个模型究竟处在什么规模水平。
至少还要一起看三件事——
用了多少数据、准备把算力花在哪里,以及模型最终由谁、在什么条件下运行。
过去几年,大模型的Scaling路线已经发生过几次集体转向。
从一味扩大参数,到增加训练数据,再到把推理成本和后训练纳入计算,每次转弯都在改写同一个答案:
所谓的“最优Scaling”,其实会随着任务、架构和使用方式不断变化。
唐杰复盘Scaling Law:参数从来无法单独决定能力
唐杰先翻出了大模型Scaling史上一段相当经典的“集体转弯”。
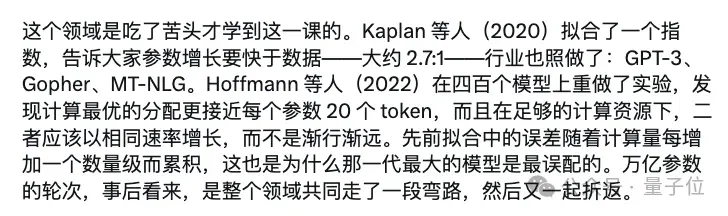
2020年,Kaplan等研究者通过不同规模的语言模型拟合Scaling Law,得出一个影响深远的结论——
计算预算增加时,模型参数应该比训练数据增长得更快。
唐杰在帖文中,将两者的增长关系概括为约2.7∶1。
这套结论很快为大模型竞赛定下方向,GPT-3、Gopher和MT-NLG相继登场,参数量从1750亿一路涨到5300亿,万亿参数也逐渐成为前沿模型的代表性目标。
模型越做越大,参数表越来越吓人。
然而两年后,DeepMind重新做了一遍实验,问题随即暴露出来。
团队训练了超过400个模型,覆盖7000万到160亿参数、50亿到5000亿训练Token。
结果显示,当时的大模型普遍塞入了太多参数,吃进去的数据却远远不够。
找到问题后,DeepMind又训练了一个更小的模型:Chinchilla。
它只有700亿参数,比2800亿参数的Gopher小了四倍;训练数据达到1.4万亿Token,又多了四倍。
同样的训练计算量下,小一圈、吃得更饱的Chinchilla全面超过Gopher,还压过GPT-3、Jurassic-1和MT-NLG。
由此诞生的Chinchilla Scaling Law,将计算最优配比推向约20个Token对应一个参数,随着计算预算增长,参数与训练数据也应该近似同步扩大。
这次转向,也让唐杰重新评价此前的参数竞赛——
在他看来,早期Scaling Law中的拟合误差,会随着计算规模不断累积。模型越大,参数与数据之间的资源错配也可能越严重。
回头再看,那轮万亿参数竞赛,成了全行业共同走过、随后又折返的一段岔路。
但在唐杰的复盘里,Chinchilla也没有给出一劳永逸的答案。
因为Chinchilla解决的是训练阶段的资源分配:一个模型只训练一次,在固定计算预算下,参数和数据该怎么搭配。
可模型训练完成后,还要被一次次调用,今天的头部模型每天可能处理数十亿次请求,模型越大,每次运行需要的计算量和部署成本也越高。
推理成本由此进入Scaling的账本,最优方案也跟着再次移动。
此外相关研究也发现,如果一款模型预计要处理约10亿次请求,更小的模型配合更长时间训练,可能拥有更低的全生命周期成本,研究者把训练强度一路提高到每参数1万个Token,模型质量仍在继续改善。
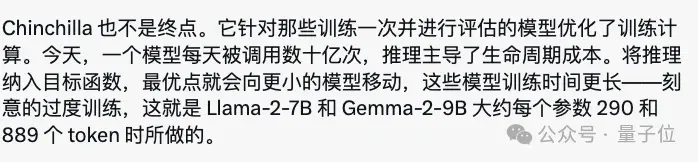
唐杰在帖文中举了两个已经“超额训练”的例子——
Llama 2 7B每个参数约对应290个训练Token,Gemma 2 9B更达到约889个,远远超过Chinchilla时期的20。
从扩大参数,到补足数据,再到计算整个生命周期的推理成本,Scaling的重点一路移动。背后的问题却始终没变:
那就是有限的计算资源,究竟该花在哪里。
总参数管容量,激活量影响推理
到了MoE模型,这道资源分配题又多了一层。
唐杰将参数拆成两个维度——
总参数量更像模型的仓库,决定它能装下多少知识、事实和长尾信息。
激活参数量与有效深度,则更接近模型一次能够调动多少能力,把推理链走多远。
这两种能力,在漏洞发现中很容易区分。
模型记住更多CVE,意味着它见过更多案例,可真正遇到一个新漏洞,它还要从异常代码追到触发条件,再设计验证方法和利用路径,连续走完二十步推理,途中不能丢掉线索。
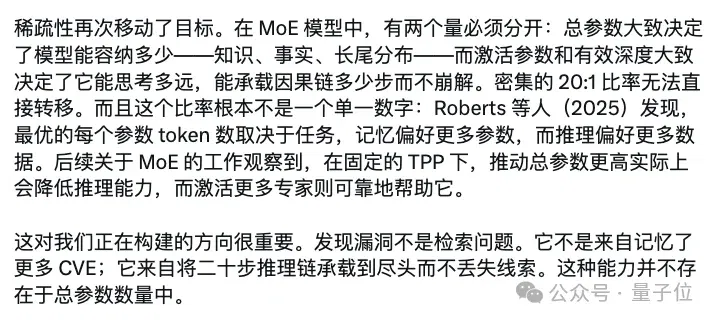
因此在唐杰看来,发现漏洞依赖长链推理能力,很难用总参数量直接衡量。
这套判断,也给GLM-5.3的训练方向提供了解释。
智谱保留了GLM-5.2的基座和架构,总参数量与激活参数量同样保持不变,过去一个月,团队把新增计算集中投入长程任务环境与强化学习。
参数表原地没动,提升来自后训练。
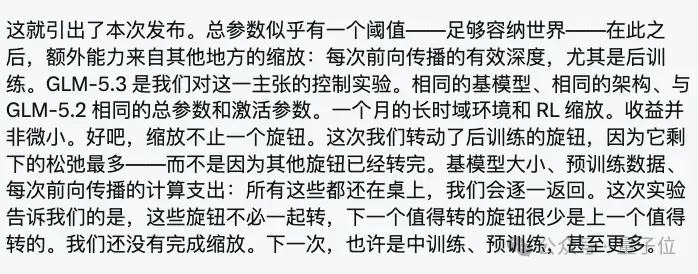
智谱官方发布页显示,GLM-5.3在Terminal-Bench 3.0上从4.6升至28.3,DeepSWE从46.2涨到66.9,Agents’ Last Exam也从23.8升至28.5。
这些成绩目前主要来自智谱官方测试,外部复现还要等待模型权重开放,但对唐杰来说,这次实验已经验证了一个阶段性判断——
Scaling有很多旋钮。
GLM-5.3这次拧动后训练,因为这里当时拥有最大的剩余空间。
参数规模、预训练数据和单次前向计算量依然留在牌桌上,智谱之后也可能重新转向中训练、预训练,继续扩大其他方向。
多个旋钮无需同时转动。上一次最值得投入的方向,到了下一轮,可能已经让位给新的瓶颈。
当前大模型的竞赛单位,正在从谁的知识库更大,转向谁能让模型在真实环境里把复杂任务做完。
如果模型只是回答问题,参数规模依然很好讲。
但如果它要连续工作几小时、几天,甚至像一个数字员工那样接手完整项目,那么决定胜负的就不只是它记住了多少,而是它能不能一直不掉线、不跑偏,并且对结果负责。
万亿参数没有消失。
只是从现在开始,它可能不再是唯一值得被写进标题的那个数字。
参考链接:
[1]https://x.com/jietang/status/2089941544581403107
文章来自于"量子位",作者 "梦瑶"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
智谱唐杰突发长文曝RSI进展:Agent优化10万卡集群吞吐暴涨200%,AI造AI还远吗? (opens in a new tab)
智谱创始人唐杰发文披露RSI最新进展,称由GLM-5.3驱动的Infra Agent在超过10万卡国产芯片集群上不到两周内完成GLM-5.3 Flash生产级推理服务搭建,将端到端吞吐提升至初始基线的3倍,表明RSI最小闭环已经形成但距离递归自我改进仍很遥远。
硅谷发现:中国AI惊人飞跃背后,是清华实验室的一对师生丨T Insights (opens in a new tab)
一对清华师生,两家AI公司。十多年前,唐杰和杨植麟还只是清华实验室里的一对师生。如今,唐杰联合创办了智谱AI,杨植麟带领月之暗面(Moonshot AI)。智谱港股上市后市值一度突破1万亿港元,月之暗面则在2026年完成F轮融资后估值达到350亿美元。
GLM-5.5最新曝光!「降智」问题3张重置卡已到位 (opens in a new tab)
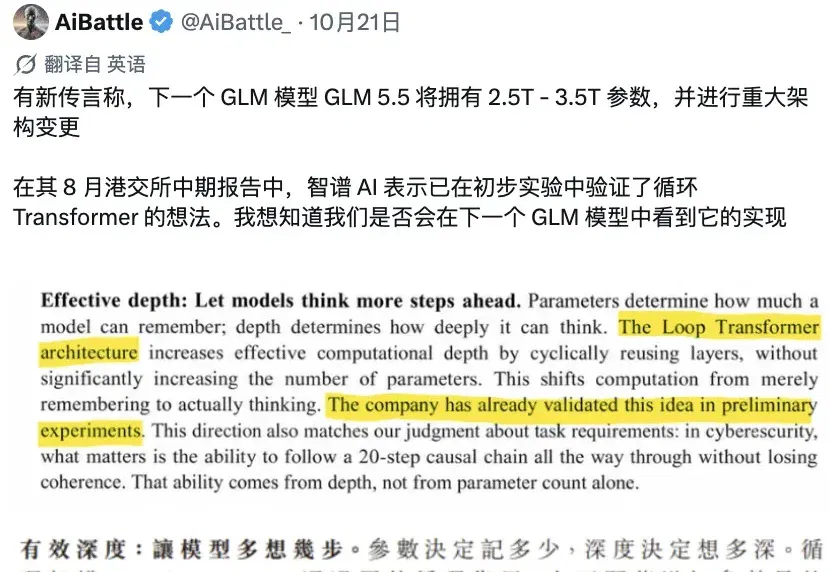
GLM-5.5,真的马上就来了?! 这不嘛,网上有GLM Coding Plan用户收到官方补偿通知,原因是此前部分用户遭遇了模型「降智」问题。 但比补偿本身更有看头的,是智谱在公告里留下的一句话—— 新模型发布后,还会额外赠送一次额度重置机会哈! 好啊好啊,一份补偿通知,竟然顺手把下一代模型给剧透了。(doge) 而且巧了,最近关于GLM-5.5的爆料,也开始一波接一波冒出来了。 有小道消息称,GLM-5.5的参数规模可能达到2.5万亿—3.5万亿,比此前传闻的1.6万亿还要大上一截! 还有友友猜测,智谱此前初步验证的循环Transformer架构,会不会也用在下一代GLM上??? 这...
智谱新模型,懂法方面全球第一了 (opens in a new tab)
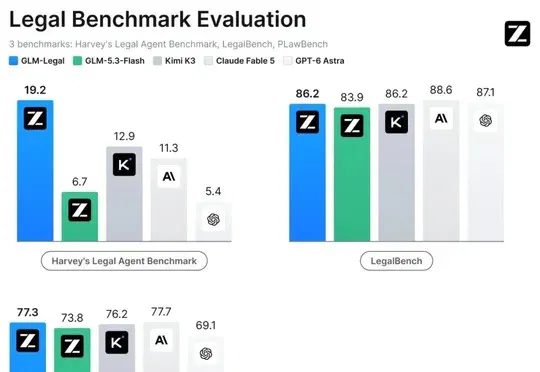
智谱推出法律专用开源模型GLM-Legal,可处理合同审查、证据分析和跨境合规,并在Vals AI法律测评中以19.2%的任务全通过率和86.23%的准确率位居Harvey LAB与LegalBench双榜开放权重模型榜首。
智谱发布 GLM-Legal:专攻法律的大模型,合同审查、证据梳理都能干 (opens in a new tab)
智谱旗下Z.ai发布基于GLM-5.3-Flash的法律专用模型GLM-Legal,面向合同审查、证据分析和合规研究,官方评测显示其在Harvey LAB明显领先、其余两项接近一线,目前需申请API权限且未开源。