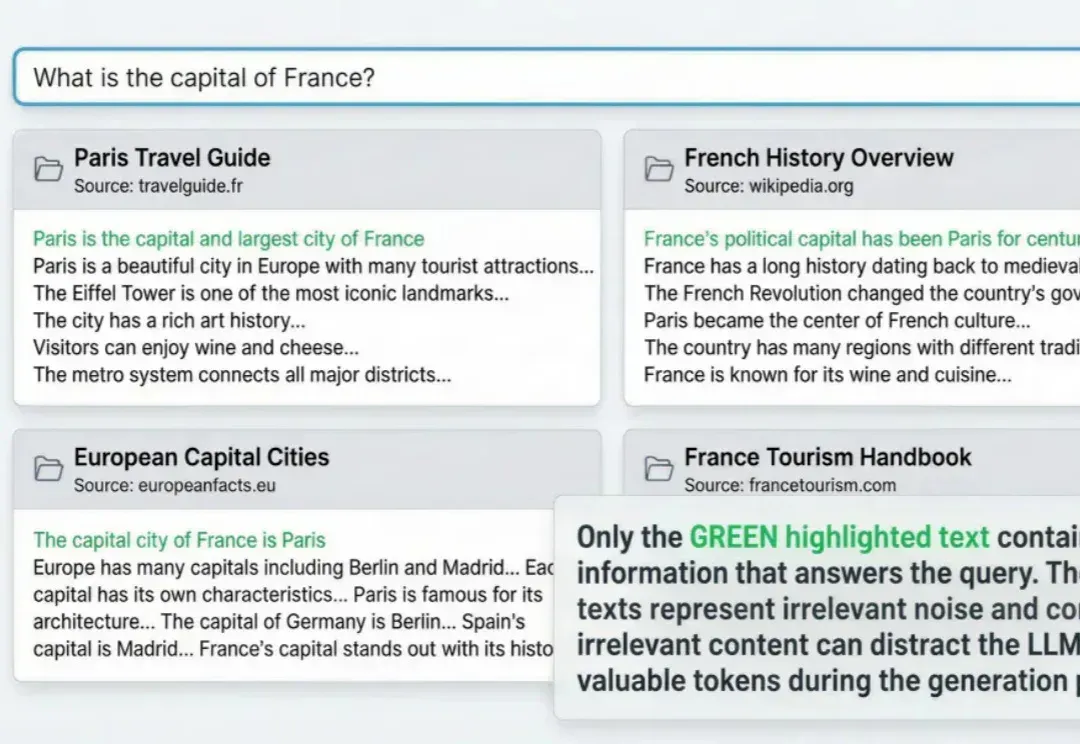
官宣,Milvus开源语义高亮模型:告别饱和检索,帮RAG、agent剪枝80%上下文 (opens in a new tab)
RAG与agent用到深水区,一定会遇到这个问题: 明明架构很完美,私有数据也做了接入,但项目上线三天,不但token账单爆了,模型输出结果也似乎总差点意思。
Total 85 articles
RAG与agent用到深水区,一定会遇到这个问题: 明明架构很完美,私有数据也做了接入,但项目上线三天,不但token账单爆了,模型输出结果也似乎总差点意思。
企业级场景中,无论是做RAG还是agent,我们都会面临一个问题:出于数据隐私以及合规要求,数据必须保留在本地。但传统的本地存储方案往往存在数据隔离性差、崩溃易丢数据、配置管理混乱、操作不可撤销等问题。
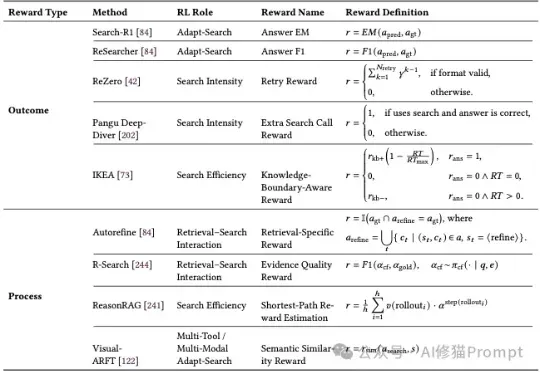
大型语言模型(LLM)本身很强大,但知识是静态的,有时会“胡说八道”。为了解决这个问题,我们可以让它去外部知识库(比如维基百科、搜索引擎)里“检索”信息,这就是所谓的“检索增强生成”(RAG)。
Mirage(原 Captions)宣布获得 7500 万美元 融资,由 General Catalyst 旗下 Customer Value Fund(CVF)提供。这类资金的逻辑,与传统 VC 明显不同,它更关注已经被验证的增长模型与单位经济,而不是单纯押注未来。
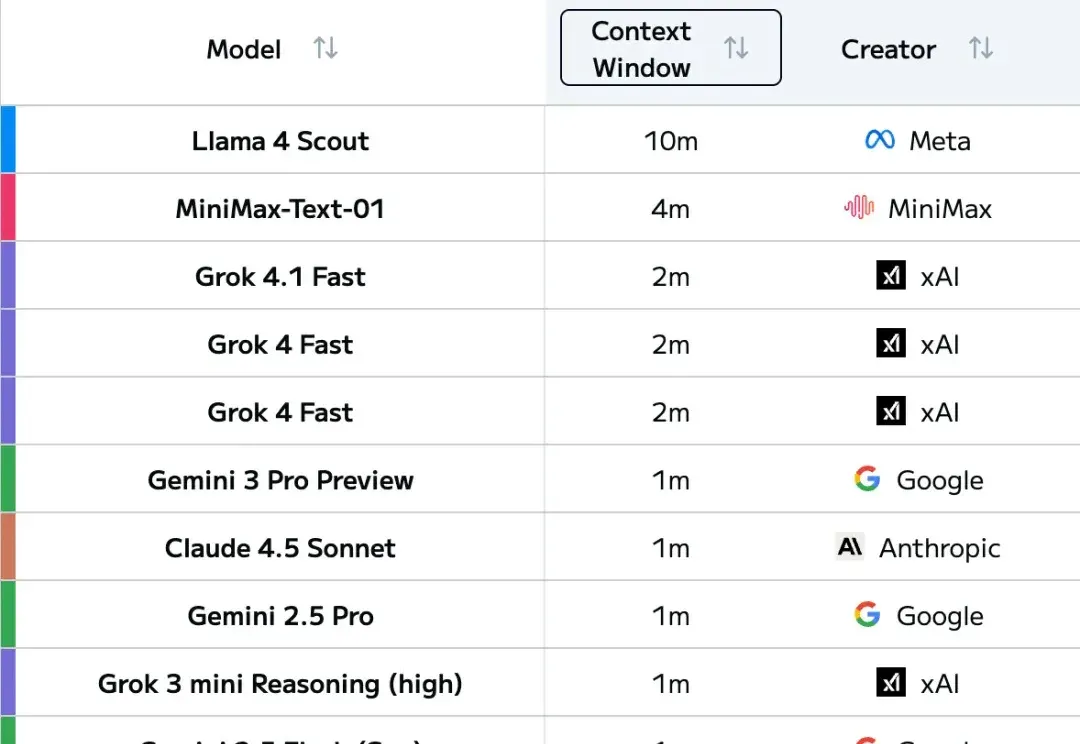
Context Pruning如何结合rerank,优化RAG上下文?
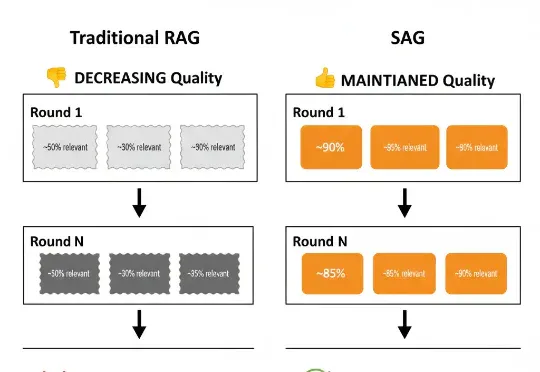
大家好,我是Jomy,是智跃Zleap的CEO,也是Zleap产品和技术的主要设计者。此前在报道中,我曾粗略介绍过Zleap产品背后的技术:一个能帮助CEO自动整理、总结海量企业内部信息的智能Agent。今天,我要正式为大家介绍驱动这个Agent的底层技术:SAG。
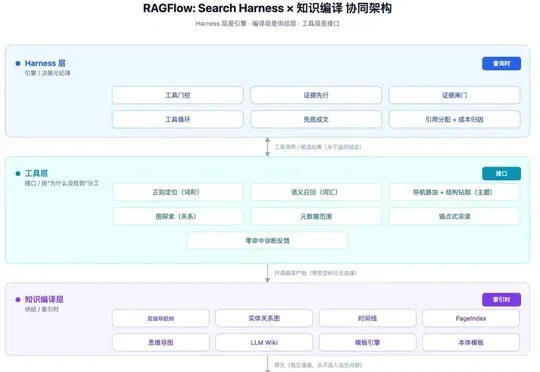
文章拆解 RAGFlow 的证据链、导航、引用和有状态检索流程,说明哪些证据可以预先加工、哪些仍需查询原文。相关 Token 节省来自报告所用测试。
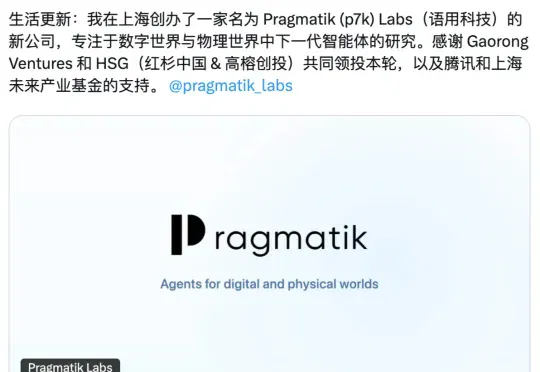
就在刚刚,原阿里千问技术负责人林俊旸官宣创业新动向:在上海创办了一家新的 AI 公司 Pragmatik Labs(语用科技),简称 p7k。方向也第一次正式公开:研究横跨数字世界和物理世界的下一代 Agent。
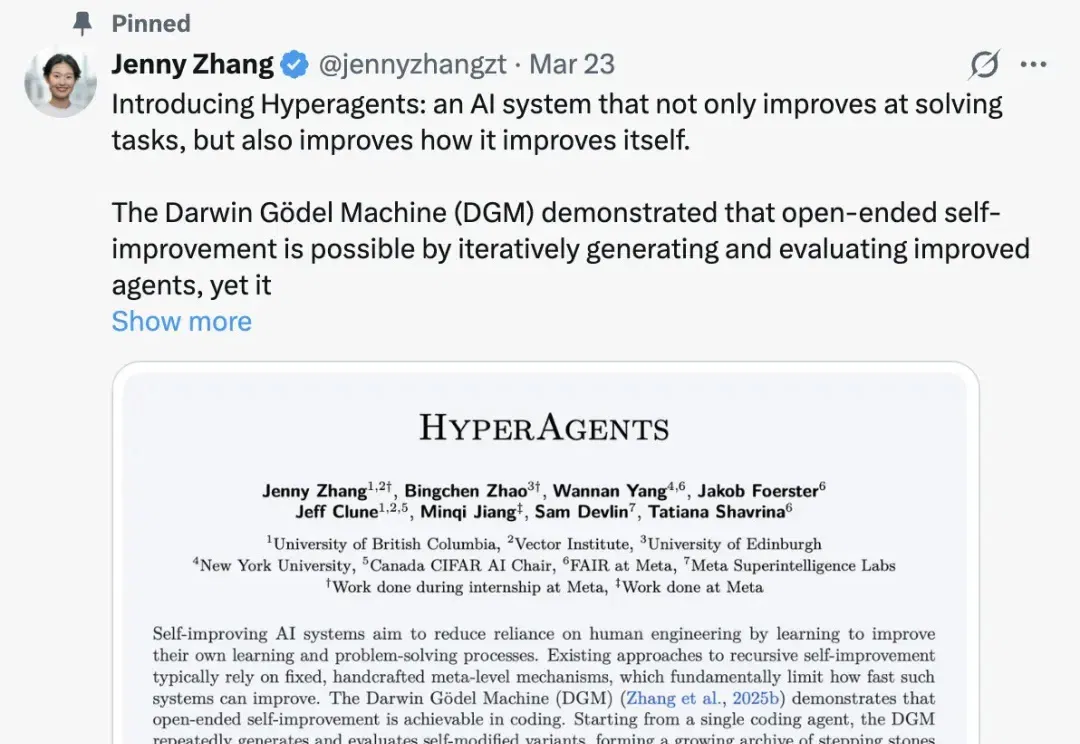
能无限进步的「超级智能体」来了! 最近,Meta研究团队的一篇题为HYPERAGENTS(超级智能体)的论文迅速刷屏。 这篇论文将LSTM之父Jürgen Schmidhuber二十年前提出的哥德尔机(Gödel Machine)思想,与达尔文开放算法相结合,提出了能持续自我迭代的达尔文哥德尔机。 基于此这一思想,Agent不仅能更好地完成具体任务、持续提高自身表现。 更关键的是,它可以不断优化“改进自身”的底层逻辑,实现“元学习(Meta-learning)” 这,便是论文定义的新一代超级智能体——Hyperagents。 论文更进一步提出:未来AI有望通过持续自我迭代,最终突破人类预设的初
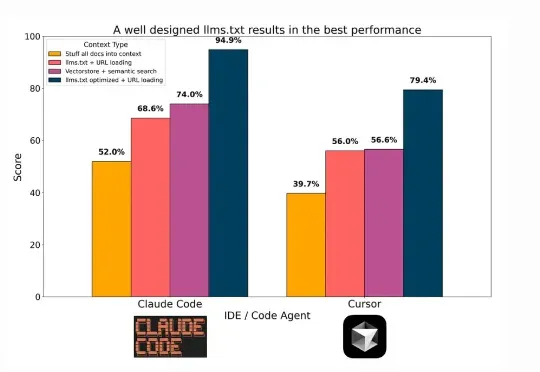
在技术飞速更新迭代的今天,每隔一段时间就会出现「XX 已死」的论调。「搜索已死」、「Prompt 已死」的余音未散,如今矛头又直指 RAG。