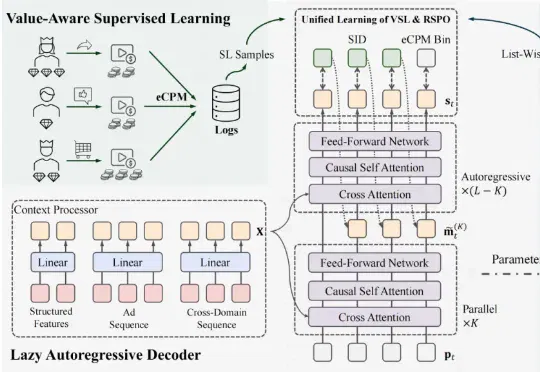
快手广告系统全面迈入生成式推荐时代!GR4AD:从Token到Revenue的全链路重构 (opens in a new tab)
快手的这篇论文,正是对这一问题交出的一份沉甸甸的工业级答卷。他们提出了 GR4AD(Generative Recommendation for ADvertising),一个横跨表征、学习、服务三大层面协同设计的生成式广告推荐系统,并已全量部署于快手广告平台,服务超过 4 亿用户。
Total 619 articles
快手的这篇论文,正是对这一问题交出的一份沉甸甸的工业级答卷。他们提出了 GR4AD(Generative Recommendation for ADvertising),一个横跨表征、学习、服务三大层面协同设计的生成式广告推荐系统,并已全量部署于快手广告平台,服务超过 4 亿用户。
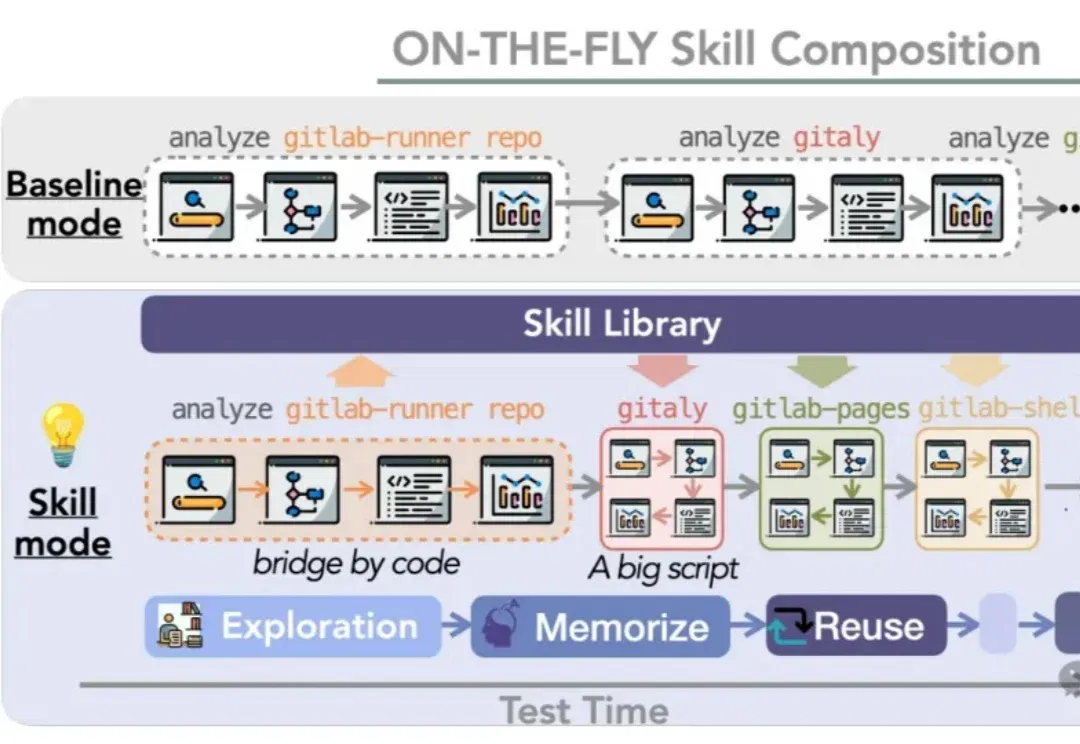
AI会用工具了,问题才真正开始… 这两年,大模型Agent在“用工具”这件事上进步很快。搜索、查信息、调API,很多模型已经能把一串操作接起来,完成相当复杂的多步任务。 但一旦把场景拉近到真实工作流,问题很快就会显现出来。很多任务表面上不同,底层流程其实高度相似:先搜,再筛,再整理,最后再做一点汇总分析。换一个对象,这套流程往往又要完整走一遍。 麻烦在于,现有Agent虽然会做这些事,却不太会把已经做成功过的流程留下来。 圆满完成任务后,再遇到同样任务它还是会重新规划、重新传参、重新走一遍工具链。结果就是:任务也许做成了,但token越跑越多,上下文越来越长,成本和不稳定性也一起上来了。 为解
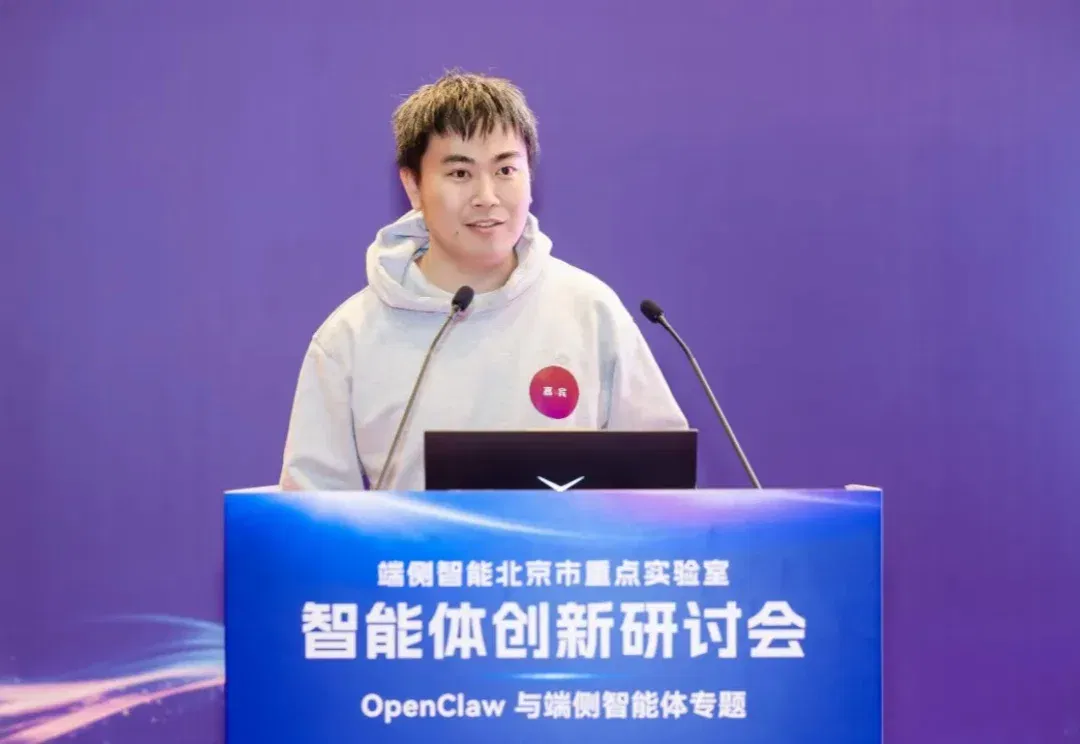
过去数月,AI 领域很难绕开一个名字 ——OpenClaw。这个项目在极短时间内获得了爆发式关注:数十万星标、惊人的 Token 消耗,以及几乎所有大厂的快速跟进。从表面上看,它像是又一个现象级 AI 产品;但如果进一步审视,一个更值得思考的问题随之浮现 ——OpenClaw 的出现,究竟意味着什么?它真的是一次技术突破,还是某种更深层变化的信号?
作为2月刷屏的现象级开源产品,OpenClaw不仅自身掀起了AI工具的使用热潮,成为全球最大API聚合平台OpenRouter上的Tokens消耗最多的应用,更成为了国产大模型出海的关键推手。
随着OpenClaw的爆火,全球用户在AI Agent上消耗的Token量整整暴涨了1000倍!这不是一次普通的开源项目走红,这是一个信号——一个比编程奇点更加剧烈的奇点,正在撕裂我们习以为常的世界。
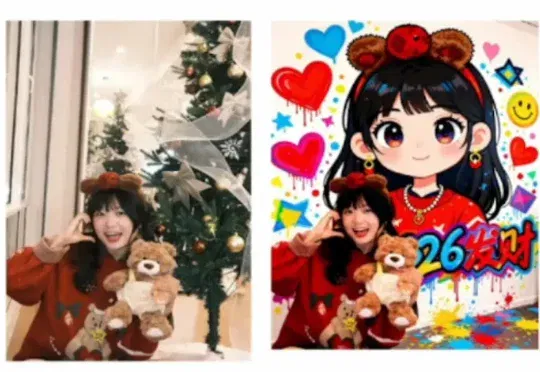
今天,阿里巴巴发布了新一代图像生成基础模型Qwen-Image 2.0,这一模型支持长达一千个token的超长指令、2k分辨率,并采用了更轻量的模型架构,模型尺寸远小于Qwen-Image 2.0的20B,带来更快的推理速度。
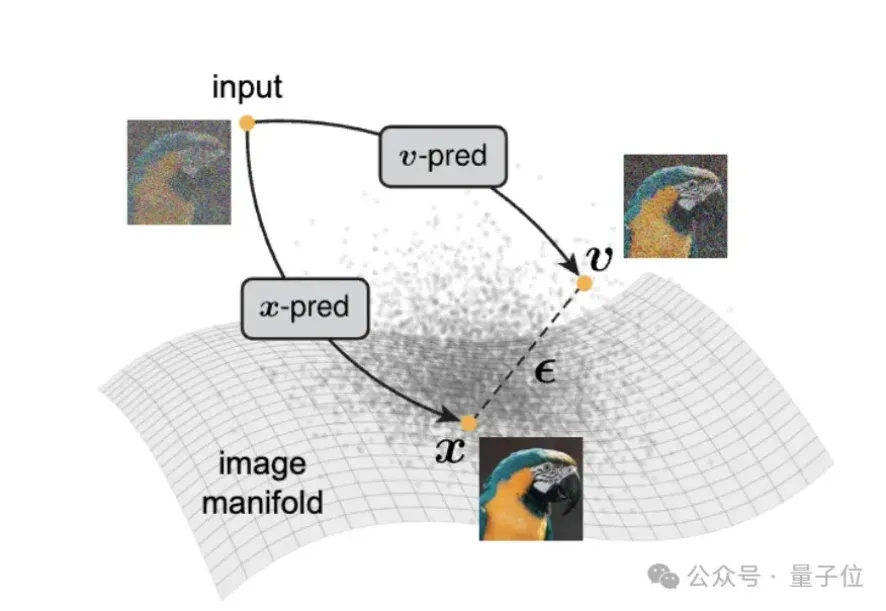
何恺明又一次返璞归真。 最新论文直接推翻扩散模型的主流玩法——不让模型预测噪声,而是直接画干净图。 如果你熟悉何恺明的作品,会发现这正是他创新的典型路径,不提出更复杂的架构,而是把问题拆回最初的样子,让模型做它最擅长的那件事。 实际上,扩散模型火了这么多年,架构越做越复杂,比如预测噪声、预测速度、对齐latent、堆tokenizer、加VAE、加perceptual loss…… 但大家似乎忘了,扩散模型原本就是去噪模型。 现在这篇新论文把这件事重新摆上桌,既然叫denoising模型,那为什么不直接denoise? 于是,在ResNet、MAE等之后,何恺明团队又给出了一个“大道至简”的结
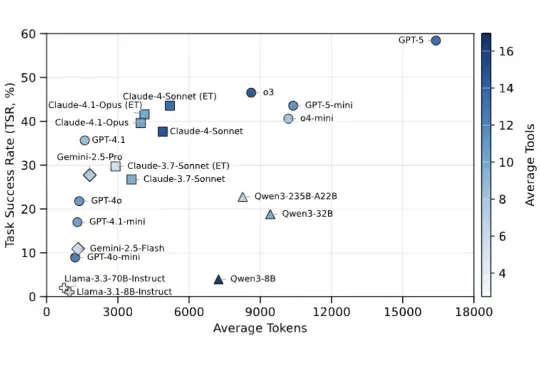
杜克大学与 Zoom 的研究者们推出了 LiveMCP-101,这是首个专门针对真实动态环境设计的 MCP-enabled Agent 评测基准。该基准包含 101 个精心设计的任务,涵盖旅行规划,体育娱乐,软件工程等多种不同场景,要求 Agent 在多步骤、多工具协同的场景下完成任务。
The report covers Qwen4-Max's architecture, million-token context and long-horizon delivery examples. Work360 and AII show different cost reductions; complex open-ended tasks remain a weakness, while smaller models are planned for later open release.
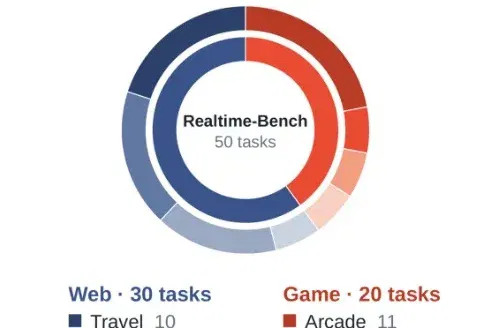
Realtime-Bench 用30项网页任务和20项游戏任务,对比真实时间、推理时暂停及按Token推进三种时钟。受测模型在时限下明显失分;GPT-6 Astra最高单次任务成功率44%,三次重复均成功的Pass³为36%,两者不能混用。