独家首发丨首个「Soulful Agent」ColaOS 上线:你会感受到Agent的灵魂,然后离不开它 (opens in a new tab)
大概一周前,我拿到了ColaOS(以下简称Cola)的内测。当时我手里有Claude、Gemini和GPT最新的模型。在Cola出现之前,这几个工具已经足够覆盖我所有的工作场景了。还有什么能比Claude好用?
Total 438 articles
大概一周前,我拿到了ColaOS(以下简称Cola)的内测。当时我手里有Claude、Gemini和GPT最新的模型。在Cola出现之前,这几个工具已经足够覆盖我所有的工作场景了。还有什么能比Claude好用?
文本领域的大模型满分选手,换成语音就集体挂科?大模型引以为傲的多轮对话逻辑,在真实人声面前竟然如此脆弱。Scale AI正式发布首个原生音频多轮对话基准Audio MultiChallenge,直接撕开了大模型靠合成语音评测维持的优等生假象。实验显示,强如Gemini 3 Pro在真实场景下的通过率也仅过半数,而GPT-4o Audio的表现更是令人大跌眼镜。
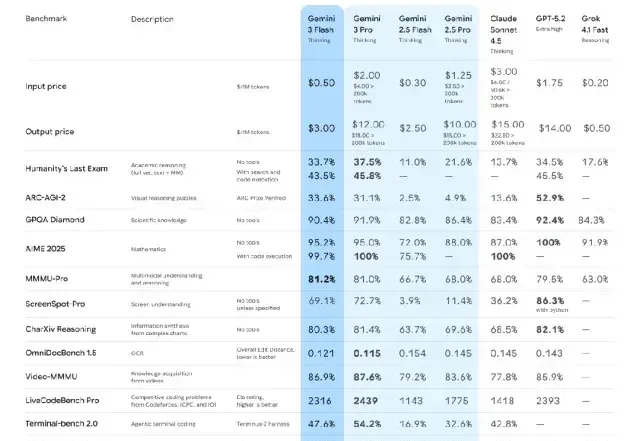
如何回顾2025年的AI进展? 今年王者归来的谷歌,刚刚由Jeff Dean和哈萨比斯牵头,完成了年度总结和趋势展望报告—— 这是AI Agent、推理和科学发现的一年。 报告最后梳理出了八大研究方向,系统性地回答了一个更重要的问题: 当大模型进入推理时代,AI 正在变成什么? 从Gemini的推理能力、多模态理解,到Agent、机器人、科学研究和物理世界建模,谷歌正在描绘一个可以协作、可以行动、甚至开始参与科学发现的智能系统。 模型的推理、多模态理解、生成能力及效率得到显著提升。 AI已广泛融入谷歌的主要产品中。 2025年创造性AI工具全面提升。 AI在科学和数学领域实现多项成果,尤其是数
在图像生成上,Google 其实已经有 Imagen 4 这样的文生图模型,为什么 nano banana 最后还是由 Google 带来的?但这确实不是偶然或者瞎猜的,nano banana 是结合了 Google 多个团队的项目成果。首先就是 Gemini 强大的世界知识与指令遵循能力,其次就是 Google 内部顶尖文生图模型 Imagen,所提供的极致图像美学与自然度追求。
硅谷「御三家」AI决战,十月彻底引爆! 就在今天,X上有人爆料称,Anthropic的终极王牌Fable 5.5,很可能明天就要突袭上线! 几乎同一时间,The Information曝出猛料,Anthropic的新模型已经在测试者手里跑起来了。 用过它的人透露,下一代神话级Claude的跃升,集中在「推理深度、直觉判断、读懂人类意图」三大能力上。 最可怕的是,它炼出了强大的「读心术」,即便你没说出明确需求,它也能get到你真正想要什么。 你只让它修1个Bug,它能把背后一整类问题全揪出来! Anthropic这张牌还没正式亮出来,OpenAI和谷歌也坐不住了。谷歌Gemini 4 Carbo
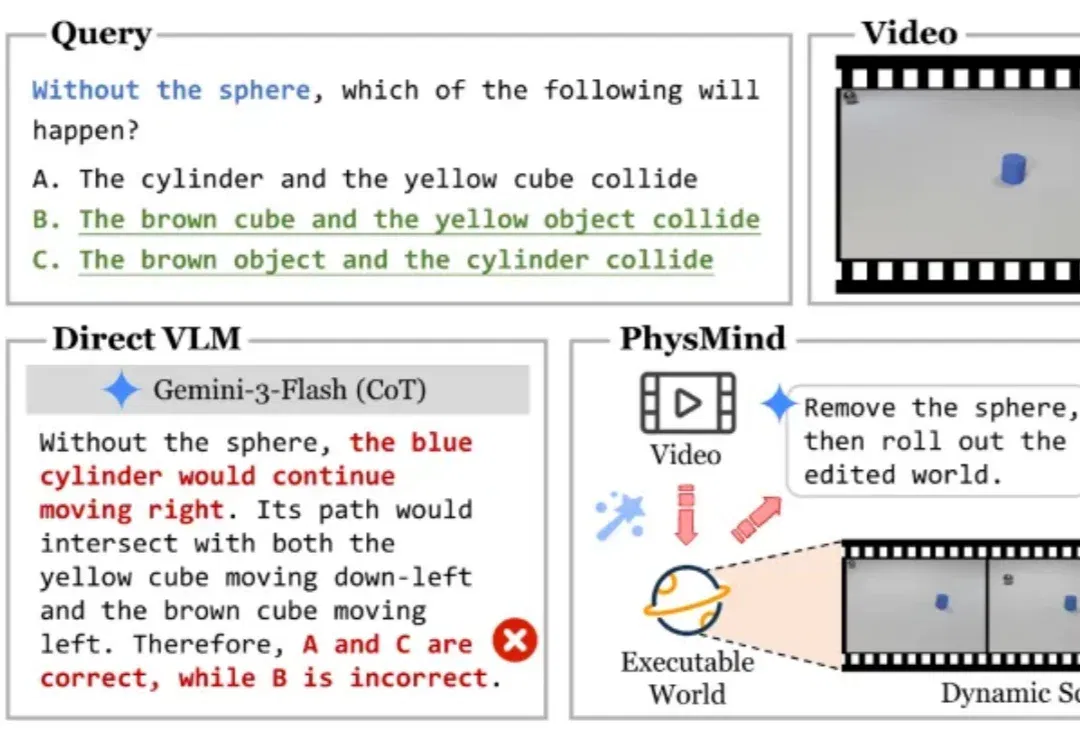
Asking the World 让模型从视频重建可运行场景,通过查询、模拟和干预获取证据。以 Gemini-3-Flash 为基础,在 CLEVRER 和 ContPhy 上分别达到 80.82% 和 70.56%。
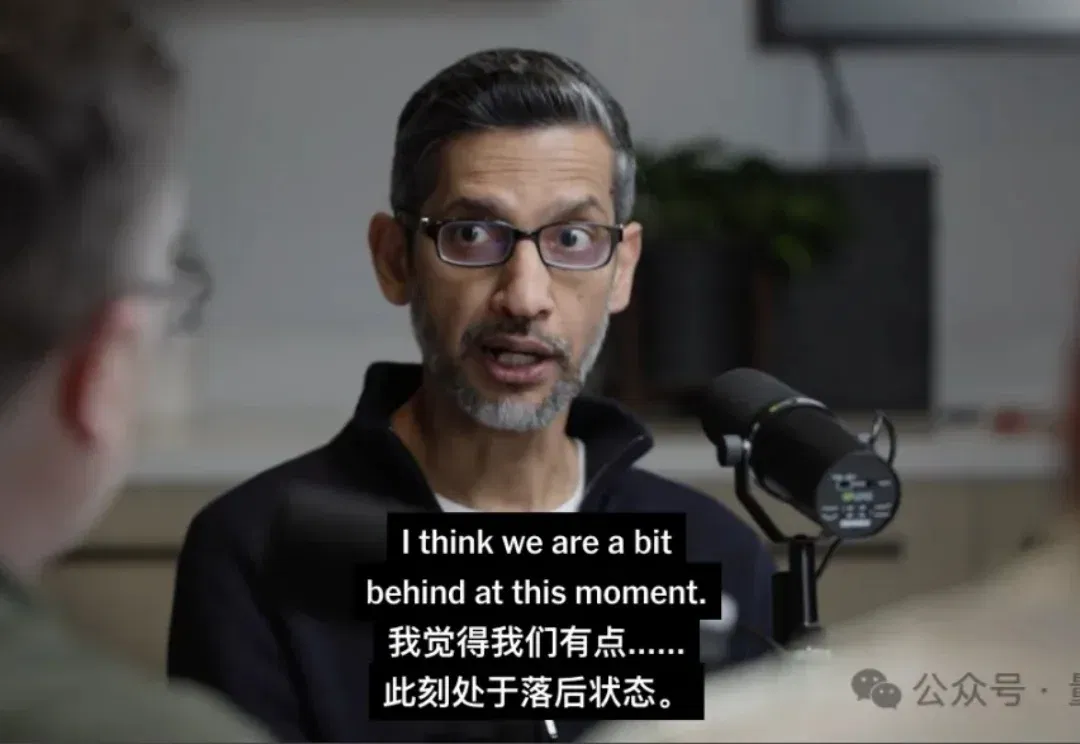
谷歌CEO皮查伊这次真没藏着掖着,直接一个真心话大放送了: 在Coding这事儿上,我们家Gemini确实有点了落后哈…..
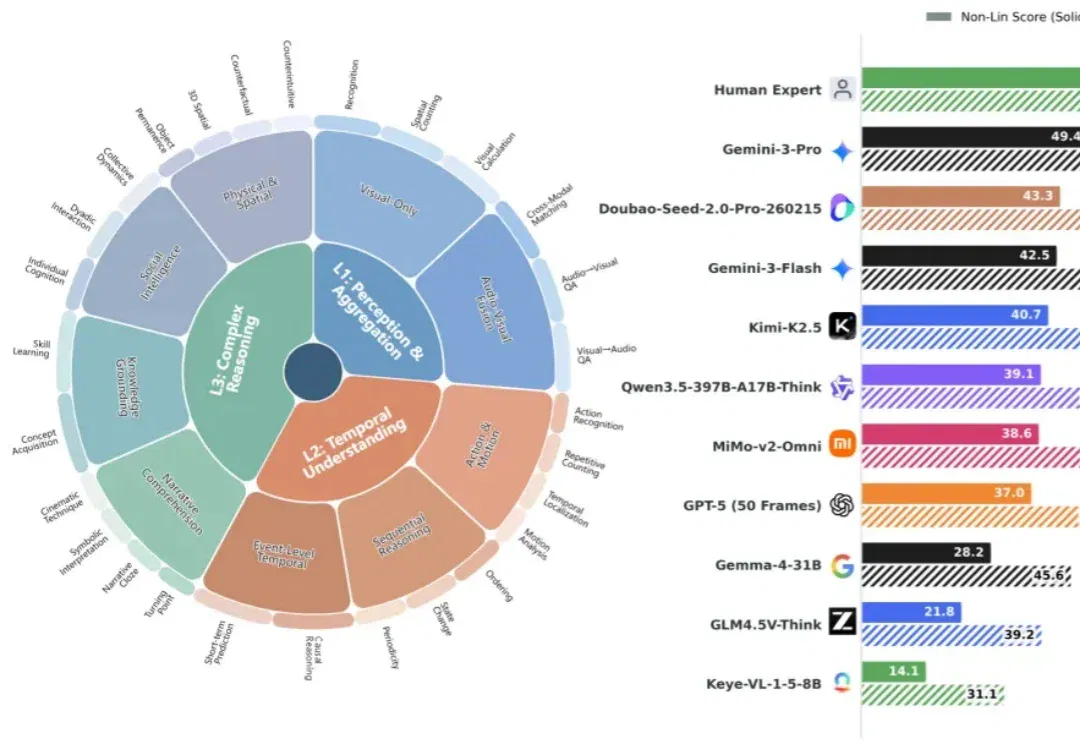
现有大模型评测分数日趋饱和,但与真实体验差距显著。南京大学傅朝友团队牵头,在 Google Gemini 评测团队邀约下推出视频理解新基准 Video-MME-v2。凭借创新的分层能力体系与组级非线性评分,以及 3300 + 人工时高质量标注,揭示模型与人类的巨大鸿沟(49 vs 90)、传统 Acc 指标虚高、以及 “Thinking” 并非总是增益等现象。
现有大模型评测分数日趋饱和,但与真实体验差距显著。南京大学傅朝友团队牵头,在Google Gemini评测团队邀约下推出视频理解新基准Video-MME-v2。凭借创新的分层能力体系与组级非线性评分,以及3300+人工时高质量标注,揭示模型与人类的巨大鸿沟(49vs90)、传统Acc指标虚高、以及「Thinking」并非总是增益等现象。
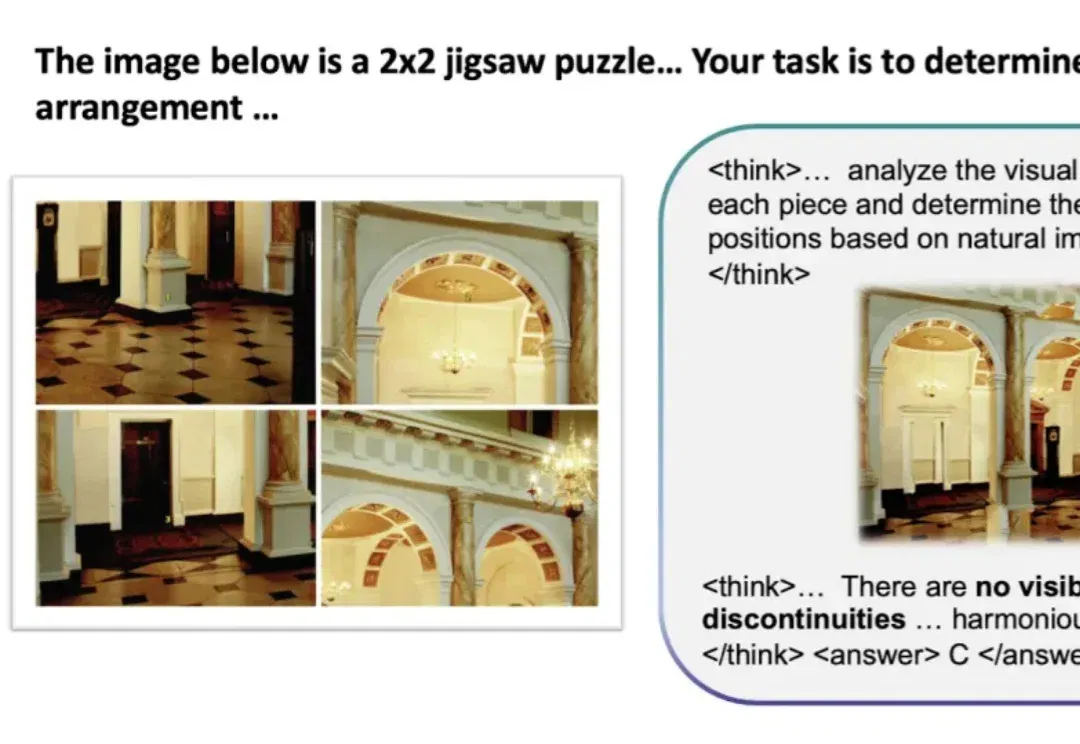
NUS、ZJU、UW、Stanford、CUHK 联合提出 「ThinkMorph」,主张让文字与图像在统一架构里「原生协作」、「共同演化」,而不是像当下大多数多模态模型那样,看完图像就闭上眼睛,后续完全靠文字链条推进。仅用 2.4 万条数据微调 7B 统一模型,视觉推理平均提升 34.74%,多项任务比肩甚至超越 GPT-4o 和 Gemini 2.5 Flash。