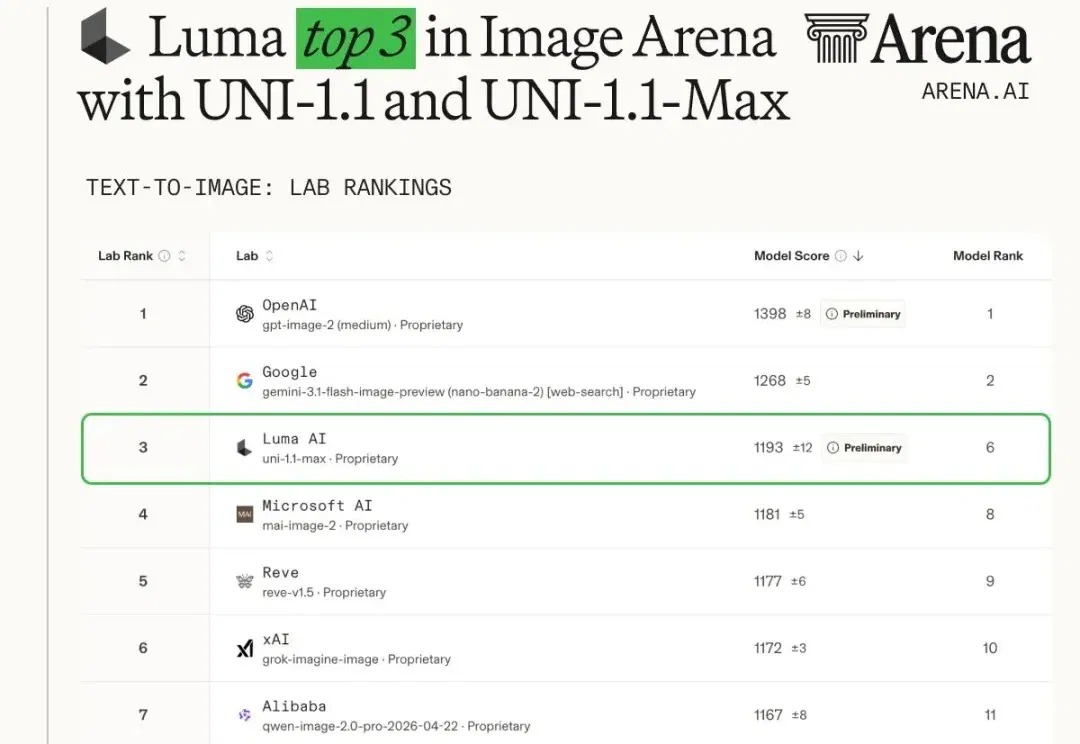
Luma Uni-1.1 API开放,图像模型榜单第三,文字渲染直逼GPT image 2 (opens in a new tab)
今年以来,图像生成模型的迭代节奏明显加快。
Total 354 articles
今年以来,图像生成模型的迭代节奏明显加快。
4 月初,LM Arena 评测平台上出现了三个匿名图像模型,代号分别是 maskingtape-alpha、packingtape-alpha、gaffertape-alpha。几小时后它们消失了。OpenAI 官方还没有正式宣布这个模型,但根据 API 返回的元数据和用户侧的测试记录,它已经有了一个被广泛接受的名字:GPT Image 2。
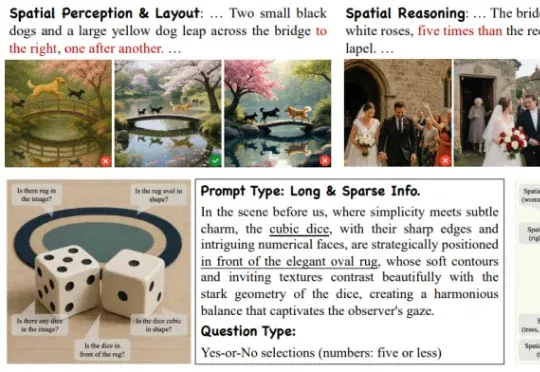
来自阿里高德的一篇最新 ICLR 2026 中稿论文《Everything in Its Place: Benchmarking Spatial Intelligence of Text-to-Image Models》提出了面向文生图空间智能的系统性评估基准 SpatialGenEval,旨在通过长文本、高信息密度的 T2I prompt 设计,以及围绕空间感知
五个真实物理任务实测,PhysMaster 可推导、写码、数值验证。
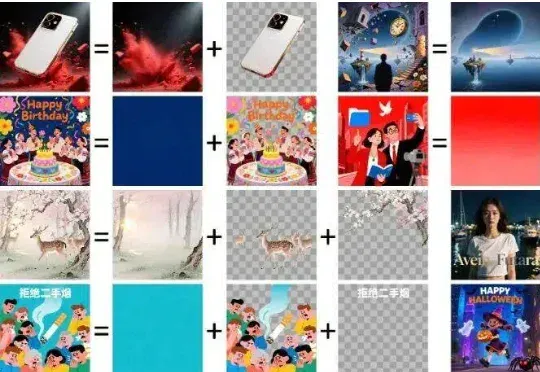
抽奖式的生图体验,确实让很多设计师在尝鲜之后又默默打开了 Photoshop。于是乎,阿里千问团队再次出手,开源了一个叫 Qwen-Image-Layered 的模型,试图从底层逻辑上解决这个问题。
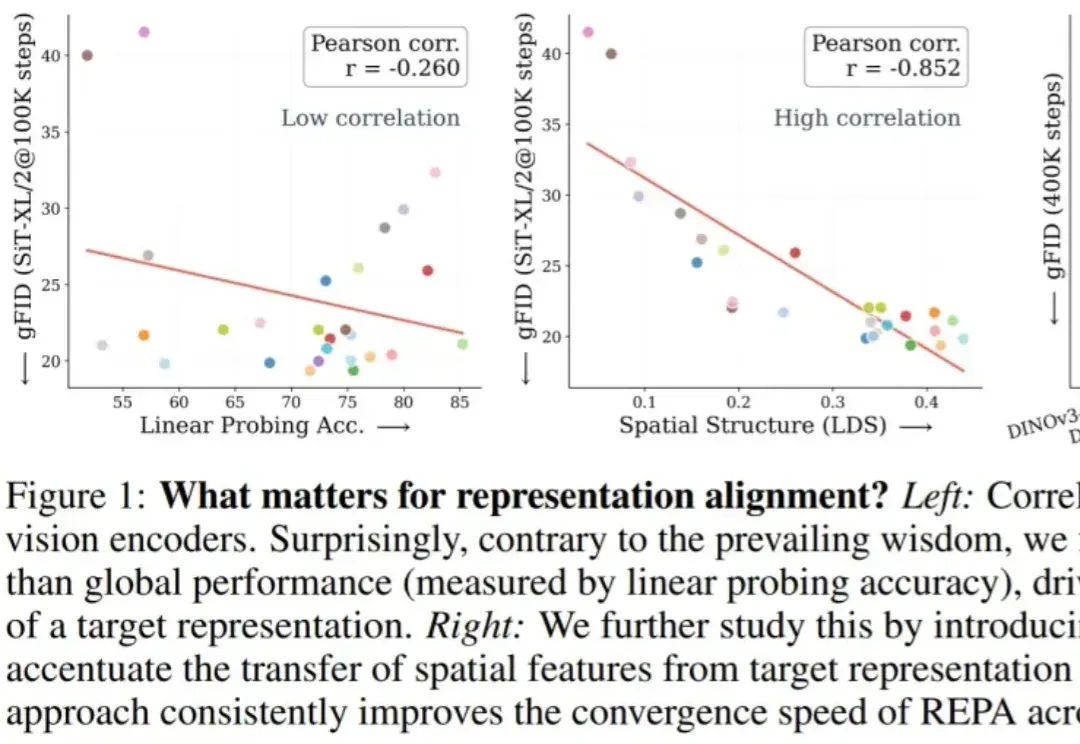
邹忌曾经有一个问题:吾与徐公孰美? 而对于 REPA,也有一个类似的问题:全局信息与空间结构,哪个对表征对齐更重要? 表征对齐(REPA)可通过将强大的预训练视觉编码器的表征蒸馏为中间扩散特征,来指导生成式训练。该方法于去年十月份问世,一直以来都备受关注,已成为加速扩散 Transformer(Diffusion Transformers)训练的一项有力技术。参阅报道《扩散模型训练方法一直错了!谢赛宁:Representation matters》。 但是,其还有一个很基本的问题悬而未决:对生成而言,目标表征的哪个方面更重要?是其「全局」语义信息(例如,以 ImageNet-1K 准确率衡量)
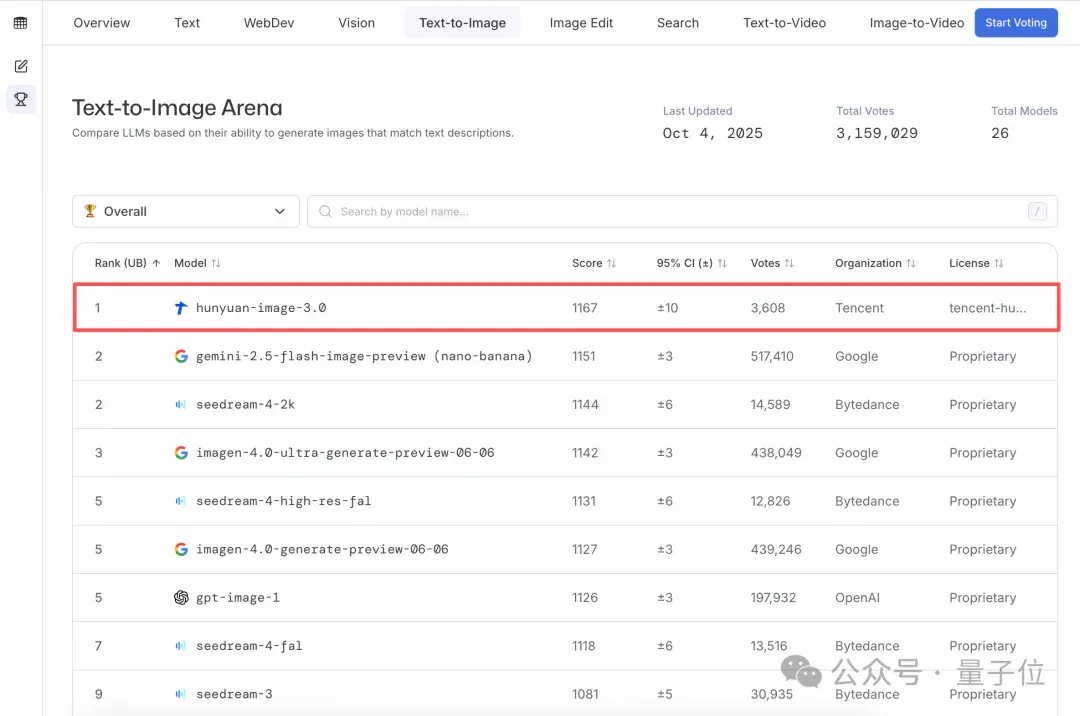
全球文生图大模型王座,易主了。就在刚刚,LMArena竞技场发布了最新的文生图榜单,第一名来自中国,属于腾讯混元图像3.0!不仅超越了谷歌的Nano Banana,也超越了字节的Seedream和OpenAI的gpt-Image,在全球26个大模型中稳居第一。
答案或许渐渐清晰。李飞飞团队与斯坦福 AI 实验室正式官宣:首届 BEHAVIOR 挑战赛将登陆 NeurIPS 2025。这是一个为具身智能量身定制的 “超级 benchmark”,涵盖真实家庭场景下最关键的 1000 个日常任务(烹饪、清洁、整理……),并首次以 50 个完整长时段任务作为核心赛题,考验机器人能否在逼真的虚拟环境中完成真正贴近人类生活的操作。
Zhidx tests Kling's image model on portraits, posters, text edits and sets of up to ten images. The report also records errors in dense text, excessive detail changes and some plastic-looking results. Output quality depends on the task and the individual generation.
闫俊杰在 Scottish Mortgage 播客解释低推理成本如何支持后训练,并讨论 H3 开放权重和 M3 Pro 的开发进度。访谈亦区分年化收入运行率与财报收入。