Scaling Law的焦虑差距可以由「交互深度」解决,MiroMind用Qwen3-72B在GAIA中超越GPT5 (opens in a new tab)
在过去五年,AI领域一直被一条“铁律”所支配,Scaling Law(扩展定律)。它如同计算领域的摩尔定律一般,简单、粗暴、却魔力无穷:投入更多的数据、更多的参数、更多的算力,模型的性能就会线性且可预测地增长。无数的团队,无论是开源巨头还是商业实验室,都将希望孤注一掷地押在了这条唯一的救命稻草上。
Total 67 articles
在过去五年,AI领域一直被一条“铁律”所支配,Scaling Law(扩展定律)。它如同计算领域的摩尔定律一般,简单、粗暴、却魔力无穷:投入更多的数据、更多的参数、更多的算力,模型的性能就会线性且可预测地增长。无数的团队,无论是开源巨头还是商业实验室,都将希望孤注一掷地押在了这条唯一的救命稻草上。
具身数据层的全球竞赛正在迅速升温。NVIDIA Research在2026年发布EgoScale数据与训练框架,在Ego-centric人类操作视频上训练VLA模型,用 20,854小时带动作标注的第一人称人类视频,观察到数据规模和验证损失之间接近对数线性的scaling law。1X收集人类第一视角及家庭行为数据,通过 Sunday项目采集百万小时级家庭场景视频。
这两年大模型圈有一条几乎没人怀疑的信条,Scaling Law。
前华为云盘古大模型CTO李寅与多模态首席科学家张含望联合创立的息壤开物宣布完成数亿元种子轮及天使轮融资(估值5亿美金),旨在训练面向物理世界的大物理模型(LPM),寻找物理世界的Scaling Law。
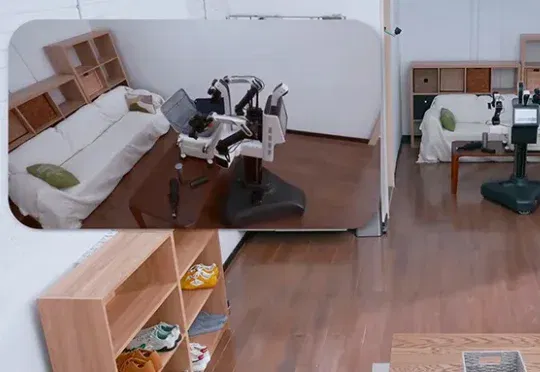
今天,小米刚刚扔出一颗“深水炸弹”——Xiaomi-Robotics-1具身基座模型,试图改变这一局面。Xiaomi-Robotics-1基于10万小时真实世界操作轨迹进行预训练,再用约1.1万小时跨本体数据完成后训练。据悉,这是国内首次在机器人策略模型中,对Scaling Law进行较为完整的系统验证。
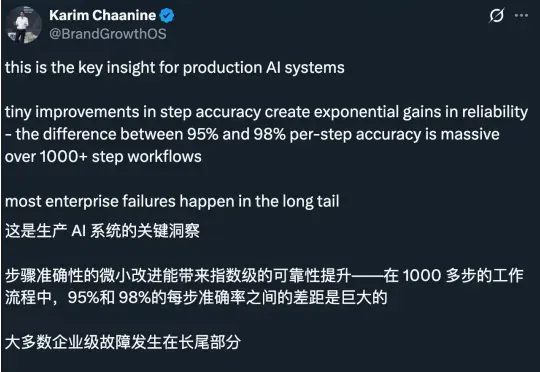
很多人认为,Scaling Law 正在面临收益递减,因此继续扩大计算规模训练模型的做法正在被质疑。最近的观察给出了不一样的结论。研究发现,哪怕模型在「单步任务」上的准确率提升越来越慢,这些小小的进步叠加起来,也能让模型完成的任务长度实现「指数级增长」,而这一点可能在现实中更有经济价值。
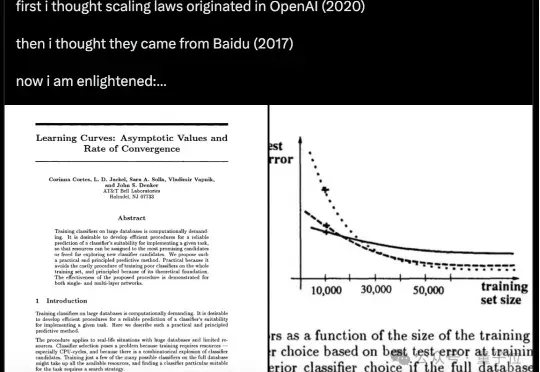
原来,Scaling Law在32年前就被提出了! 不是2020年的OpenAI、不是2017年的百度,而是1993年的贝尔实验室。
机器人领域已经轰轰烈烈地 Scaling 了好几年。
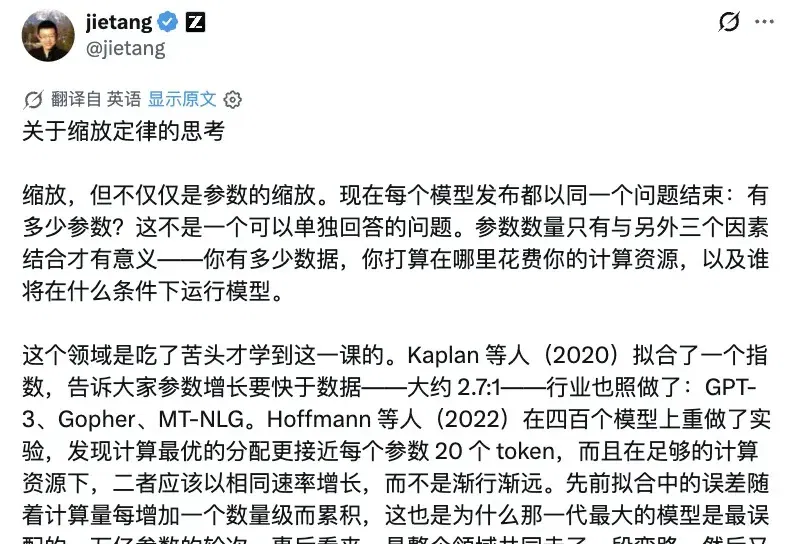
Scaling Law还在,但今天的大模型,已经不能只靠“参数量”来理解Scaling了。
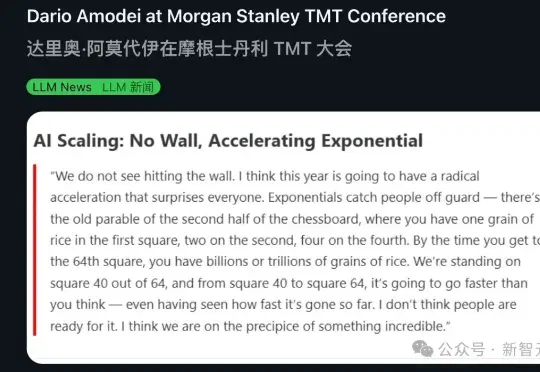
Anthropic CEO Dario Amodei在摩根士丹利会议上扔出一颗深水炸弹:Scaling Law根本没撞墙,2026年将迎来激进加速。他用棋盘稻米寓言做了个精准比喻——我们正站在第40格,前39格的所有震撼加在一起,不过是后24格的零头。这场指数级狂飙,没人准备好。